

26. februar hadde vi meet-up om Apache Ignite GreenSource, hvor bidragsytere fra open source-prosjektet talte. . Et viktig arrangement for dette fellesskapet var ombyggingen av komponenten , som lar deg rulle ut brukertilpassede mikrotjenester direkte i Ignite-klyngen. Om denne krevende prosessen snakket , programvareingeniør og bidragsyter til Apache Ignite i over to år.
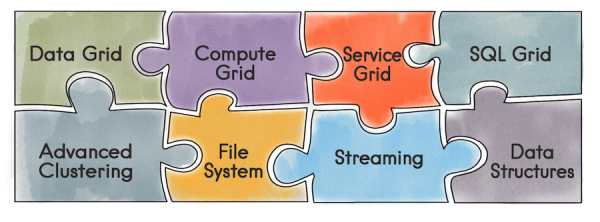
La oss begynne med hva Apache Ignite egentlig er. Dette er en database som fungerer som et distribuert nøkkel/verdi-lager med støtte for SQL, transaksjoner og caching. I tillegg lar Ignite deg rulle ut tilpassede tjenester direkte i Ignite-klyngen. Utviklere får tilgang til alle verktøyene som Ignite tilbyr — distribuerte datastrukturer, Messaging, Streaming, Compute og Data Grid. For eksempel, ved bruk av Data Grid forsvinner problemet med administrering av en separat infrastruktur for datalagring og de påfølgende kostnadene som følger med det.
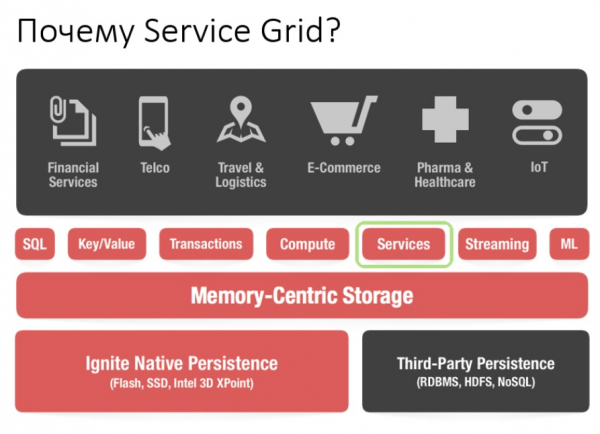
Ved å bruke API Service Grid kan du distribuere en tjeneste ved enkelt å spesifisere distribusjonsskjemaet i konfigurasjonen samt selve tjenesten.
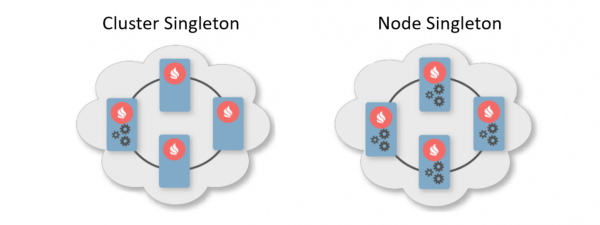
Normalt er distribusjonsskjemaet en indikasjon på hvor mange instanser som skal distribueres på klyngeknutene. Det finnes to typiske distribusjonsskjemaer. Den første er Cluster Singleton: til enhver tid vil det garantert være én instans av brukertjenesten tilgjengelig i klyngen. Den andre er Node Singleton: på hver knute i klyngen er det rullet ut én instans av tjenesten.
Brukeren kan også spesifisere antallet instanser av tjenesten i hele klyngen og definere et predikat for å filtrere relevante noder. I et slikt scenario vil Service Grid selv beregne optimal distribusjon for distribusjon av tjenester.
I tillegg finnes det en funksjon som heter Affinity Service. Affinity er en funksjon som definerer forholdet mellom nøkler og partisjoner, samt forholdet mellom partisjoner og noder i topologien. Gjennom nøkkelen kan man bestemme primary-node der dataene lagres. På denne måten kan du assosiere din egen tjeneste med nøkkelen og cache-funksjonen. Ved endring av cache-funksjonen vil det skje en automatisk redesployering. Slik vil tjenesten alltid bli plassert nær dataene den skal manipulere, og dermed redusere kostnadene ved tilgang til informasjon. Dette kan kalles en form for kolokalisert databehandling.
Nå som vi har gått gjennom hva som er flott med Service Grid, vil vi fortelle om dens utviklingshistorie.
Hva var tidligere
Den forrige implementeringen av Service Grid var basert på et transaksjonsreplikerende systemcache kalt Ignite. Med ordet "cache" i Ignite refereres det til et lagringsystem. Det er altså ikke noe midlertidig, som man kanskje ville tro. Selv om cachen er replikert og hver node inneholder hele datasettet, har cachen en partisjonert fremstilling. Dette er relatert til optimalisering av lagring.
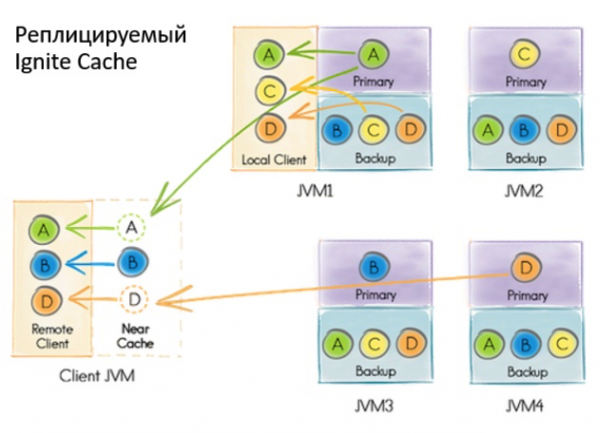
Hva skjedde når en bruker ønsket å deployere en tjeneste?
- Alle nodene i klyngen abonnerte på dataoppdateringer i lagringen gjennom den innebygde mekanismen Continuous Query.
- Initieringsnoden lagde en inngang i databasen under en read-committed transaksjon, som inneholdt konfigurasjonen av tjenesten, inkludert den serialiserte instansen.
- Når koordinatoren mottok varselet om den nye posten, beregnet han distribusjonen basert på konfigurasjonen. Den mottatte objektet ble lagret tilbake i databasen.
- Hvis noden var med i distribusjonen, måtte koordinatoren deployere den.
Hva var vi misfornøyde med
På et tidspunkt kom vi til den konklusjon at man ikke kan jobbe med tjenester på denne måten. Det var flere grunner til dette.
Hvis det oppsto en feil under deployeringen, kunne man bare få vite om den fra loggene til den noden der alt skjedde. Det eksisterte bare asynkron deployering, så etter at brukeren fikk tilbake kontrollen fra deploy-metoden, var det nødvendig med ekstra tid for å starte tjenesten – og i løpet av denne tiden kunne ikke brukeren administrere noe. For å utvikle Service Grid videre, implementere nye funksjoner, tiltrekke nye brukere og gjøre livet enklere for alle, måtte vi endre på noe.
Når vi designet det nye Service Grid, ønsket vi først og fremst å gi en garanti for synkron distribusjon: så snart brukeren får kontroll tilbake fra API, kan de umiddelbart bruke tjenestene. Vi ønsket også å gi initiatoren muligheten til å håndtere distribusjonsfeil.
Videre ønsket vi å lette implementeringen, spesielt å unngå transaksjoner og rebalansering. Selv om cache er replikert og det ikke er rebalansering, oppstod det problemer under større distribusjoner med flere noder. Når topologien endres, må nodene utveksle informasjon, og under en stor distribusjon kan disse dataene veie mye.
Når topologien var ustabil, måtte koordinatoren beregne distribusjonen av tjenester på nytt. Generelt kan arbeidet med transaksjoner på en ustabil topologi føre til vanskeligforutsigbare feil.
Problemer
Hvilke globale endringer kommer uten samtidige problemer? Det første av dem var endringen av topologi. Man må forstå at når som helst, selv i løpet av distribusjonen av tjenesten, kan en node bli med i eller forlate klyngen. Mer enn det, hvis en node blir med i klyngen under distribusjonen, må all informasjon om tjenestene overføres konsekvent til den nye noden. Og dette gjelder ikke bare det som allerede er distribuert, men også nåværende og fremtidige distribusjoner.
Dette er bare ett av problemene som kan samles i en egen liste:
- Hvordan distribuere statisk konfigurerte tjenester ved oppstart av noden?
- Hva skal man gjøre når noden forlater klyngen – hvis noden hadde vert tjenester?
- Hva skal man gjøre hvis koordinatoren har endret seg?
- Hva skal man gjøre hvis klienten er reconnected til klyngen?
- Må vi håndtere forespørslene for aktivering/deaktivering, og hvordan?
- Hva hvis cache destruksjonen ble kalt, men vi har tjenester som er avhengige av den?
Og dette er langt ifra alt.
Solution
Som mål valgte vi en Event Driven tilnærming med implementering av prosesskommunikasjon ved hjelp av meldinger. I Ignite er allerede to komponenter implementert, som lar noder sende meldinger til hverandre – communication-spi og discovery-spi.
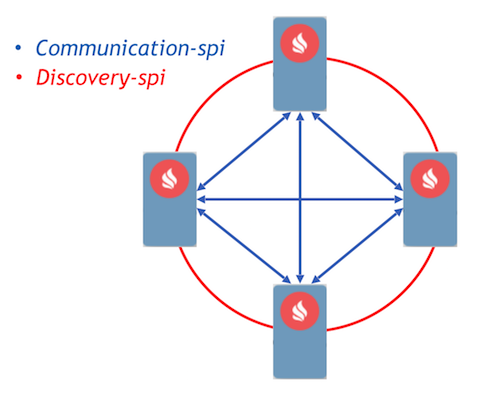
Communication-spi gjør det mulig for noder å kommunisere direkte og sende meldinger. Det er godt egnet for å overføre store datamengder. Discovery-spi gjør det mulig å sende en melding til alle noder i klyngen. I den standard implementeringen gjøres dette ved hjelp av en "ring"-topologi. Det finnes også integrasjon med Zookeeper; i så fall brukes en "stjerne"-topologi. Det er også viktig å merke seg at discovery-spi gir garantier for at meldingen nøyaktig vil bli levert i riktig rekkefølge til alle noder.
La oss se på deploy-protokollen. Alle brukerforespørselene om deploy og undeploy sendes via discovery-spi. Dette gir følgende garantier:
- Forespørselen vil bli mottatt av alle nodene i klyngen. Dette vil tillate videre behandling av forespørselen ved endring av koordinator. Det betyr også at hver node vil ha alle nødvendige metadata for én melding, som tjenestekonfigurasjon og dens serialiserte instans.
- Den strenge rekkefølgen på leveringen av meldinger gjør det mulig å løse konflikter mellom konfigurasjoner og konkurrerende forespørsel.
- Siden en nodes inntreden i topologien også behandles via discovery-spi, vil den nye noden motta all nødvendig informasjon for å arbeide med tjenestene.
Når en forespørsel mottas, validerer nodene i klyngen den og danner oppgaver for behandling. Disse oppgavene legges i en kø og prosesseres deretter i en annen tråd av en egen worker. Dette er implementert på denne måten fordi deploy kan ta betydelig tid, og det er uakseptabelt å forsinke den dyre discovery-strømmen.
Alle forespørslene fra køen behandles av deployement-manageren. Den har en spesifikk worker som henter oppgaven fra denne køen og initialiserer den for å starte distribusjonen. Etter dette skjer følgende:
- Hver node beregner selv fordelingen takket være den nye deterministiske tildelingsfunksjonen.
- Nodene danner en melding med resultatene av deployen og sender den til koordinatoren.
- Koordinatoren aggregerer alle meldingene og danner resultatet av hele deploy-prosessen, som sendes via discovery-spi til alle nodene i klyngen.
- Når resultatet mottas, avsluttes deploy-prosessen, hvoretter oppgaven fjernes fra køen.
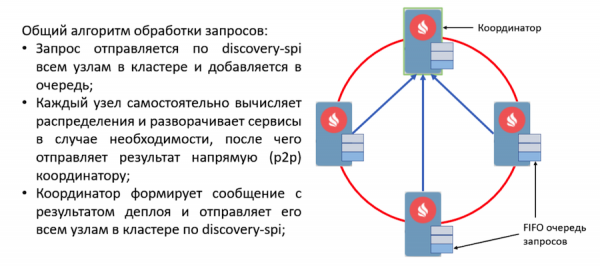
Ny hendelsesdrevet design: org.apache.ignite.internal.processors.service.IgniteServiceProcessor.java
Hvis det oppstod en feil under distribusjonen, vil noden straks inkludere denne feilen i meldingen som sendes til koordinatoren. Etter aggregasjonen av meldingene vil koordinatoren ha informasjon om alle feilene under distribusjonen og sende denne meldingen via discovery-spi. Feilinformasjonen vil være tilgjengelig på hvilken som helst node i klyngen.
Alle viktige hendelser i Service Grid behandles i henhold til denne arbeidsalgoritmen. For eksempel er endring av topologi også en melding via discovery-spi. Generelt, sammenlignet med hva som var, har protokollen blitt ganske lettvektig og pålitelig. Så mye at den kan håndtere enhver situasjon under distribusjonen.
Hva skjer videre
Nå om planene. Enhver større oppdatering i Ignite-prosjektet utføres som en initiativ for forbedring av Ignite, kjent som IEP. Redesignen av Service Grid har også et IEP — med det morsomme navnet «Bytte av olje i Service Grid». Men i realiteten byttet vi ikke olje i motoren, men hele motoren.
Oppgavene i IEP er delt opp i 2 faser. Den første fasen er en stor fase som innebærer omarbeiding av distribusjonsprotokollen. Den er allerede integrert i masteren, og du kan prøve det nye Service Grid som vil være tilgjengelig i versjon 2.8. Den andre fasen inkluderer mange andre oppgaver:
- Hot redeploy
- Versjonering av tjenester
- Økt feilresistens
- Tynn klient
- Verktøy for overvåkning og måling av ulike metrikker
Til slutt kan vi anbefale Service Grid for bygging av feiltolerante systemer med høy tilgjengelighet. Vi inviterer deg også til å bli med oss i og for å dele erfaringene dine. Din erfaring er virkelig viktig for fellesskapet; den vil hjelpe med å forstå hva vi skal gjøre videre og hvordan vi skal utvikle komponenten i fremtiden.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish