

I dette innlegget ønsker vi å dele en interessant metode for å håndtere konfigurasjonen av et distribuerte systemer.
Konfigurasjonen er direkte representert i Scala-språket på en typesikker måte. Et eksempel på implementasjon er beskrevet i detalj. Mange aspekter av forslaget diskuteres, inkludert innflytelse på den samlede utviklingsprosessen.
()
Introduction
Å bygge robuste distribuerte systemer krever bruk av korrekt og sammenhengende konfigurasjon på alle noder. En vanlig løsning er å bruke en tekstlig distribusjonsbeskrivelse (terraform, ansible eller noe lignende) og automatisk genererte konfigurasjonsfiler (ofte - dedikert for hver node/rolle). Vi vil også bruke de samme protokollene i de samme versjonene på hver kommuniserende node (ellers vil vi oppleve inkompatibilitetsproblemer). I JVM-verdenen betyr dette at i det minste meldingsbiblioteket bør være av den samme versjonen på alle kommuniserende noder.
Hva med testing av systemet? Selvfølgelig bør vi ha enhetstester for alle komponenter før vi går til integrasjonstester. For å kunne ekstrapolere testresultater på kjøretid, bør vi sørge for at versjonene av alle biblioteker er identiske i både kjøretids- og testmiljøene.
Når man kjører integrasjonstester, er det ofte mye lettere å ha den samme classpathen på alle noder. Vi må bare sørge for at den samme classpathen brukes ved distribusjon. (Det er mulig å bruke forskjellige classpaths på forskjellige noder, men det er vanskeligere å representere denne konfigurasjonen og korrekt distribuere den.) Så for å holde ting enkelt, vil vi bare vurdere identiske classpaths på alle noder.
Konfigurasjon har en tendens til å utvikle seg sammen med programvaren. Vi bruker vanligvis versjoner for å identifisere forskjellige
faser av programvareutviklingen. Det virker rimelig å dekke konfigurasjonen under versjonskontroll og identifisere forskjellige konfigurasjoner med noen etiketter. Hvis det bare er én konfigurasjon i produksjon, kan vi bruke en enkelt versjon som identifikator. Noen ganger kan vi ha flere produksjonsmiljøer. Og for hvert miljø kan vi trenge en egen gren av konfigurasjonen. Så konfigurasjoner kan merkes med gren og versjon for å entydig identifisere forskjellige konfigurasjoner. Hver grennetiket og versjon tilsvarer en enkelt kombinasjon av distribuerte noder, porter, eksterne ressurser, classpath-bibliotekversjoner på hver node. Her vil vi bare dekke den enkle grenen og identifisere konfigurasjoner med en trekomponents desimalversjon (1.2.3), på samme måte som andre artefakter.
I moderne miljøer endres ikke konfigurasjonsfiler manuelt lenger. Typisk genererer vi
konfigfilene ved distribusjonstidspunktet og etterpå. Så man kan spørre hvorfor vi fortsatt bruker tekstformat for konfigurasjonsfiler? Et levedyktig alternativ er å plassere konfigurasjonen inne i en kompilert enhet og dra nytte av validering av konfigurasjonen ved kompilering.
I dette innlegget vil vi undersøke ideen om å holde konfigurasjonen i den kompilerte artefakten.
Kompilerbar konfigurasjon
I dette avsnittet vil vi diskutere et eksempel på statisk konfigurasjon. To enkle tjenester - echo-tjeneste og klienten til echo-tjenesten blir konfigurert og implementert. Deretter blir to forskjellige distribuerte systemer med begge tjenester instansiert. Den ene er for en konfigurasjon med én node, og den andre for en konfigurasjon med to noder.
Et typisk distribuert system består av noen noder. Nodene kan identifiseres ved hjelp av en type:
sealed trait NodeId
case object Backend extends NodeId
case object Frontend extends NodeId
eller bare
case class NodeId(hostName: String)eller til og med
object Singleton
type NodeId = Singleton.type
Disse nodene utfører forskjellige roller, kjører noen tjenester og bør kunne kommunisere med de andre nodene ved hjelp av TCP/HTTP-forbindelser.
For TCP-forbindelse kreves det minst et portnummer. Vi vil også forsikre oss om at klienten og serveren bruker samme protokoll. For å modellere en forbindelse mellom noder, la oss erklære følgende klasse:
case class TcpEndPoint[Protocol](node: NodeId, port: Port[Protocol])where Port er bare en Int innenfor det tillatte området:
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]Finere typer
Se bibliotek. Kort sagt tillater det å legge til kompileringstidbegrensninger til andre typer. I dette tilfellet Int kan bare ha 16-bit verdier som kan representere portnummer. Det er ingen krav om å bruke dette biblioteket for denne konfigurasjonsmetoden. Det ser bare ut til å passe veldig godt.
For HTTP (REST) kan vi også trenge en sti til tjenesten:
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9\/]*"`.T]]
case class PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
Phantom type
For å identifisere protokollen under kompilering bruker vi Scala-funksjonen for å deklarere typeargument Protokoll som ikke brukes i klassen. Det kalles en phantom type. Ved kjøring trenger vi sjelden en instans av protokollidentifikatoren, derfor lagrer vi den ikke. Under kompilering gir denne phantom-typen ekstra typesikkerhet. Vi kan ikke sende port med feil protokoll.
En av de mest brukte protokollene er REST API med Json-serialisering:
sealed trait JsonHttpRestProtocol[RequestMessage, ResponseMessage]where RequestMessage er basistypen av meldinger som klienten kan sende til serveren og ResponseMessage er responsmeldingen fra serveren. Selvfølgelig kan vi lage andre protokollbeskrivelser som spesifiserer kommunikasjonprotokollen med ønsket presisjon.
For formålene til dette innlegget vil vi bruke en enklere versjon av protokollen:
sealed trait SimpleHttpGetRest[RequestMessage, ResponseMessage]I denne protokollen appendes forespørselmeldingen til URL-en, og responsmeldingen returneres som en ren streng.
En tjenestekonfigurasjon kan beskrives av tjenestens navn, en samling av porter og noen avhengigheter. Det finnes flere mulige måter å representere alle disse elementene i Scala (for eksempel, HList, algebraiske datatyper). For formålene til dette innlegget vil vi bruke Cake Pattern og representere kombinerbare biter (moduler) som traits. (Cake Pattern er ikke et krav for denne kompilérbare konfigurasjonsmetoden. Det er bare en mulig implementering av ideen.)
Avhengigheter kan representeres ved å bruke Cake Pattern som endepunkter for andre noder:
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
Echo-tjenesten trenger bare en konfigurert port. Og vi erklærer at denne porten støtter echo-protokollen. Merk at vi ikke trenger å spesifisere en bestemt port på dette tidspunktet, fordi traiten tillater erklæringer av abstrakte metoder. Hvis vi bruker abstrakte metoder, vil kompilatoren kreve en implementering i en konfigurasjonsinstans. Her har vi gitt implementeringen (8081) og den vil bli brukt som standardverdi hvis vi hopper over den i en konkret konfigurasjon.
Vi kan erklære en avhengighet i konfigurasjonen av echo-tjenesteklienten:
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
Avhengigheten har samme type som echoService. Spesielt krever den samme protokollen. Dermed kan vi være sikre på at hvis vi kobler disse to avhengighetene, vil de fungere riktig.
Tjenesteimplementasjon
En tjeneste trenger en funksjon for å starte og avslutte på en kontrollert måte. (Evnen til å stenge en tjeneste er kritisk for testing.) Igjen finnes det flere alternativer for å spesifisere en slik funksjon for en gitt konfigurasjon (for eksempel, vi kan bruke typeklasser). For dette innlegget vil vi igjen bruke Cake Pattern. Vi kan representere en tjeneste med cats.Resource som allerede gir innramming og ressursfrigjøring. For å skaffe en ressurs må vi gi en konfigurasjon og noen kjørecontext. Så tjenestestartfunksjonen kan se slik ut:
  type ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
where
Konfigurasjon— type konfigurasjon som kreves av denne tjenestestarterenAddressResolver— et kjørekontekstobjekt som har evnen til å hente reelle adresser til andre noder (fortsett å lese for detaljer).
de andre typene kommer fra cats:
F[_]— effekt type (I den enkleste sakenF[A]kan bare være() => A. I dette innlegget vil vi brukecats.IO.)Reader[A,B]— er mer eller mindre et synomym for en funksjonA => Bcats.Resource— har måter å skaffe og frigjøreTimer— tillater å sove/måle tidContextShift— analog tilExecutionContextApplicative— wrapper av funksjoner i effekt (nesten et monad) (vi kan til slutt erstatte det med noe annet)
Ved å bruke dette grensesnittet kan vi implementere noen tjenester. For eksempel, en tjeneste som ikke gjør noe:
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit](()))
  }
(Se for andre tjenesteimplementeringer — ,
og .)
En node er et enkelt objekt som kjører noen tjenester (å starte en ressurskjede er mulig gjennom Cake Pattern):
object SingleNodeImpl extends ZeroServiceImpl[IO]
  with EchoServiceService
  with EchoClientService
  with FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] with EchoClientConfig[String] with FiniteDurationLifecycleConfig
}
Merk at vi i noden spesifiserer den nøyaktige typen konfigurasjon som trengs av denne noden. Kompilatoren lar oss ikke bygge objektet (Cake) med utilstrekkelig type, fordi hver tjenestetraitt erklærer en begrensning på Konfigurasjon type. Vi vil heller ikke kunne starte noden uten å gi fullstendig konfigurasjon.
Node-adresseoppløsning
For å etablere en tilkobling trenger vi en virkelig vertsadresse for hver node. Den kan kjenne til senere enn andre deler av konfigurasjonen. Derfor trenger vi en måte å levere en mapping mellom node-id og dens faktiske adresse. Denne mappingen er en funksjon:
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Det finnes noen mulige måter å implementere en slik funksjon.
- Hvis vi vet de faktiske adressene før distribusjon, under opprettelse av noden, kan vi generere Scala-kode med de faktiske adressene og kjøre byggingen etterpå (som utfører kompileringstidssjekker og deretter kjører integrasjonstestsettet). I dette tilfellet er vår mappingfunksjon kjent statisk og kan forenkles til noe som en
Map[NodeId, NodeAddress]. - Noen ganger får vi de faktiske adressene først senere når noden faktisk startes, eller vi har ikke adresser til noder som ikke har blitt startet ennå. I dette tilfellet kan vi ha en oppdagelsestjeneste som startes før alle andre noder, og hver node kan annonsere sin adresse i den tjenesten og abonnere på avhengigheter.
- Hvis vi kan endre
/etc/hosts, kan vi bruke forhåndsdefinerte vertsnavn (sommy-project-main-nodeogecho-backend) og bare knytte dette navnet til IP-adressen ved distribusjonstid.
I dette innlegget dekker vi ikke disse tilfellene i mer detalj. Faktisk vil alle noder i vårt leketøy eksempel ha den samme IP-adressen — 127.0.0.1.
I dette innlegget vil vi vurdere to distribuerte systemoppsett:
- Enkelt nodeoppsett, der alle tjenester plasseres på den enkelt noden.
- To nodeoppsett, der tjeneste og klient er på forskjellige noder.
Konfigurasjonen for en oppsett er som følger:
Konfigurasjon for en enkelt node
object SingleNodeConfig extends EchoConfig[String]
  with EchoClientConfig[String] with FiniteDurationLifecycleConfig
{
  case object Singleton \/\/ identifikator for den enkelte noden
  \/\/ serverkonfigurasjon
  type NodeId = Singleton.type
  def nodeId = Singleton

  \/** Type-sikker spesifikasjon av tjenesteport. *\/
  override def portNumber: PortNumber = 8088

  \/\/ klientkonfigurasjon

  \/** Vi bruker tjenesten levert av samme vert. *\/
  def echoServiceDependency = echoService

  override def testMessage: UrlPathElement = "hello"

  def pollInterval: FiniteDuration = 1.second

  \/\/ livssykluskontrollerkonfigurasjon
  def lifetime: FiniteDuration = 10500.milliseconds \/\/ ekstra 0.5 sekunder slik at det er 10 forespørselen, ikke 9.
}
Her lager vi en enkelt konfigurasjon som utvider både server- og klientkonfigurasjon. Vi konfigurerer også en livssykluskontroller som normalt vil avslutte klient og server etter lifetime intervallet går.
Den samme settet med tjenesteimplementeringer og konfigurasjoner kan brukes til å lage et systems oppsett med to separate noder. Vi trenger bare å lage med de riktige tjenestene:
To noder konfigurasjon
  object NodeServerConfig extends EchoConfig[String] with SigTermLifecycleConfig
  {
    type NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  object NodeClientConfig extends EchoClientConfig[String] with FiniteDurationLifecycleConfig
  {
    \/\/ NB! avhengighetsspesifikasjon
    def echoServiceDependency = NodeServerConfig.echoService

    def pollInterval: FiniteDuration = 1.second

    def lifetime: FiniteDuration = 10500.milliseconds \/\/ ekstra 0.5 sekunder slik at det er 10 forespørselen, ikke 9.

    def testMessage: String = "dolly"
  }
Se hvordan vi spesifiserer avhengigheten. Vi nevner den andre nodens tjeneste som en avhengighet for den nåværende noden. Avhengighetstypen sjekkes fordi den inneholder en spøkelses type som beskriver protokollen. Og ved kjøretid vil vi ha den riktige node-id. Dette er et av de viktige aspektene ved den foreslåtte konfigurasjonsmetoden. Det gir oss muligheten til å sette porten bare én gang og sørge for at vi refererer til den riktige porten.
To noder implementering
For denne konfigurasjonen bruker vi nøyaktig de samme tjenesteimplementeringene. Ingen endringer i det hele tatt. Imidlertid oppretter vi to forskjellige nodeimplementeringer som inneholder forskjellige sett med tjenester:
  object TwoJvmNodeServerImpl extends ZeroServiceImpl[IO] with EchoServiceService with SigIntLifecycleServiceImpl {
    type Config = EchoConfig[String] with SigTermLifecycleConfig
  }

  object TwoJvmNodeClientImpl extends ZeroServiceImpl[IO] with EchoClientService with FiniteDurationLifecycleServiceImpl {
    type Config = EchoClientConfig[String] with FiniteDurationLifecycleConfig
  }
Den første noden implementerer serveren og trenger bare server-side konfigurasjon. Den andre noden implementerer klienten og trenger en annen del av konfigurasjonen. Begge nodene krever en spesifikasjon for livssyklus. For formålet med dette innlegget vil tjenestenoden ha ubegrenset levetid som kan avsluttes ved hjelp av SIGTERM, mens eko-klienten vil avslutte etter den konfigurerte begrensede varigheten. Se for detaljer.
Den totale utviklingsprosessen
La oss se hvordan denne metoden endrer måten vi arbeider med konfigurasjon.
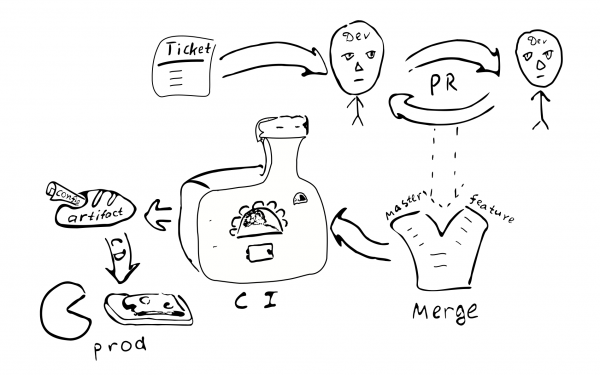
Konfigurasjonen som kode vil bli kompilert og produsere et artefakt. Det virker rimelig å skille konfigurasjonsartefakten fra andre kodeartefakter. Ofte kan vi ha mange konfigurasjoner på samme kodebase. Og selvsagt kan vi ha flere versjoner av ulike konfigurasjonsgrener. I en konfigurasjon kan vi velge spesifikke versjoner av biblioteker, og dette vil forbli konstant hver gang vi distribuerer denne konfigurasjonen.
En endring av konfigurasjon blir en endring av koden. Så det bør dekkes av den samme kvalitetssikringsprosessen:
Billet -> PR -> gjennomgang -> sammenslåing -> kontinuerlig integrasjon -> kontinuerlig distribusjon
Det er følgende konsekvenser av tilnærmingen:
- Konfigurasjonen er sammenhengende for en bestemt systems instans. Det ser ikke ut til å være noen måte å ha en feilaktig tilkobling mellom noder på.
- Det er ikke enkelt å endre konfigurasjonen bare i én node. Det virker urimelig å logge inn og endre noen tekstfiler. Så konfigurasjonsdrift blir mindre mulig.
- Små konfigurasjonsendringer er ikke enkle å gjøre.
- De fleste av konfigurasjonsendringene vil følge den samme utviklingsprosessen, og de vil måtte passere en eller annen gjennomgang.
Trenger vi et eget repository for produksjonskonfigurasjon? Produksjonskonfigurasjonen kan inneholde sensitiv informasjon som vi ønsker å holde utenfor rekkevidde av mange mennesker. Så det kan være verdt å oppbevare et eget repository med begrenset tilgang som vil inneholde produksjonskonfigurasjonen. Vi kan dele konfigurasjonen i to deler — én som inneholder de fleste åpne parameterne i produksjon og én som inneholder den hemmelige delen av konfigurasjonen. Dette vil muliggjøre tilgang for de fleste utviklerne til det store flertallet av parametrene samtidig som tilgangen til virkelig sensitive ting begrenses. Det er enkelt å oppnå dette ved å bruke mellomliggende egenskaper med standardparameterverdier.
Variasjoner
La oss se på fordeler og ulemper med den foreslåtte metoden sammenlignet med andre konfigurasjonsstyringsteknikker.
Først av alt, vi vil liste opp noen alternativer til de forskjellige aspektene av den foreslåtte måten å håndtere konfigurasjon på:
- Tekstfil på målmaskinen.
- Sentralisert nøkkel-verdi lagring (som
etcd/zookeeper). - Undervise komponenter som kan重新配置/重新启动 uten at prosessen må startes på nytt.
- Konfigurasjon utenfor artefakt og versjonskontroll.
En tekstfil gir en viss fleksibilitet når det gjelder ad-hoc-oppdateringer. En systemadministrator kan logge inn på mål-noden, gjøre en endring og ganske enkelt starte tjenesten på nytt. Dette er kanskje ikke så bra for større systemer. Ingen spor blir etterlatt etter endringen. Endringen blir ikke gjennomgått av en annen. Det kan være vanskelig å finne ut hva som forårsaket endringen. Den har ikke blitt testet. Fra utsikten til et distribuert system kan en administrator ganske enkelt glemme å oppdatere konfigurasjonen i en av de andre nodene.
(Forresten, hvis det til slutt blir behov for å begynne å bruke tekst konfigurasjonsfiler, må vi bare legge til en parser + validator som kan produsere den samme Konfigurasjon typen og det ville være nok til å begynne å bruke tekstkonfigurasjoner. Dette viser også at kompleksiteten i kompileringstidens konfigurasjon er litt mindre enn kompleksiteten i tekstbaserte konfigurasjoner, fordi i tekstbasert versjon trenger vi noe ekstra kode.)
Sentralisert nøkkel-verdi lagring er en god mekanisme for distribusjon av applikasjonsmetaparametere. Her må vi tenke på hva vi anser for å være konfigurasjonsverdier og hva som bare er data. Gitt en funksjon C => A => B kaller vi vanligvis sjelden endrede verdier C «konfigurasjon», mens ofte endrede data A bare inndata. Konfigurasjonen bør gis til funksjonen tidligere enn dataene. A. Gitt denne ideen kan vi si at det forventede endringsfrekvensen kan brukes til å skille konfigurasjonsdata fra bare data. Også data kommer vanligvis fra en kilde (bruker) og konfigurasjonen kommer fra en annen kilde (administrator). Å håndtere parametere som kan endres etter prosessinitiering fører til økt kompleksitet i applikasjonen. For slike parametere må vi håndtere leveringsmekanismen, parsing og validering, håndtering av feilverdier. Derfor, for å redusere programkompleksiteten, er det best å redusere antall parametere som kan endres i kjøretid (eller til og med eliminere dem helt).
Fra perspektivet til dette innlegget bør vi skille mellom statiske og dynamiske parametere. Hvis tjenestelogikken krever sjeldne endringer av noen parametere i kjøring, kan vi kalle dem dynamiske parametere. Ellers er de statiske og kan konfigureres ved hjelp av den foreslåtte tilnærmingen. For dynamisk omkonfigurering kan andre tilnærminger være nødvendige. For eksempel kan deler av systemet bli startet på nytt med de nye konfigurasjonsparameterne på en lignende måte som å starte separate prosesser av et distribuert system.
(Min ydmyke mening er å unngå omkonfigurering i kjøring fordi det øker kompleksiteten i systemet.
Det kan være mer direkte å bare stole på operativsystemets støtte for å starte prosesser på nytt. Selv om det kanskje ikke alltid er mulig.)
En viktig aspekt ved bruk av statisk konfigurasjon som noen ganger får folk til å vurdere dynamisk konfigurasjon (uten andre grunner) er tjenestenedetid under konfigurasjonsoppdatering. Faktisk, hvis vi må gjøre endringer i statisk konfigurasjon, må vi starte systemet på nytt så de nye verdiene blir effektive. Kravene til nedetid varierer for forskjellige systemer, så det kan hende at det ikke er så kritisk. Hvis det er kritisk, må vi planlegge på forhånd for eventuelle systemstarter. For eksempel kan vi implementere . I dette scenariet, når vi må starte systemet på nytt, starter vi en ny instans av systemet parallelt, deretter bytter vi ELB til det, mens vi lar det gamle systemet fullføre betjeningen av eksisterende tilkoblinger.
Hva med å oppbevare konfigurasjonen inne i versjonerte artefakter eller utenfor? Å oppbevare konfigurasjonen inne i et artefakt betyr i de fleste tilfeller at denne konfigurasjonen har gjennomgått den samme kvalitetssikringsprosessen som andre artefakter. Så man kan være sikker på at konfigurasjonen er av god kvalitet og pålitelig. Motsatt betyr konfigurasjon i en separat fil at det ikke er noen spor av hvem og hvorfor som gjorde endringer i den filen. Er dette viktig? Vi mener at for de fleste produksjonssystemer er det bedre å ha en stabil og høy kvalitet konfigurasjon.
Versjonen av artefaktet lar deg finne ut når det ble opprettet, hvilke verdier det inneholder, hvilke funksjoner som er aktivert/deaktivert, hvem som var ansvarlig for å foreta hver endring i konfigurasjonen. Det kan kreve noe innsats å oppbevare konfigurasjonen inne i et artefakt, og det er et designvalg å ta.
Fordeler & ulemper
Her vil vi fremheve noen fordeler og diskutere noen ulemper ved den foreslåtte tilnærmingen.
Fordeler
Funksjoner ved den kompilérbare konfigurasjonen av et komplett distribuert system:
- Statisk sjekk av konfigurasjon. Dette gir et høyt nivå av tillit til at konfigurasjonen er korrekt gitt typebegrensningene.
- Rik språk av konfigurasjon. Vanligvis er andre konfigurasjonsmetoder begrenset til maks variabel substitusjon.
Ved å bruke Scala kan man bruke et bredt spekter av språkfunksjoner for å forbedre konfigurasjonen. For eksempel kan vi bruke traits for å gi standardverdier, objekter for å sette forskjellige omfang, vi kan referere tilvals definert bare én gang i det ytre omfanget (DRY). Det er mulig å bruke bokstavelige sekvenser eller instanser av bestemte klasser (Seq,Map, osv.). - DSL. Scala har anstendig støtte for DSL-skrivere. Man kan bruke disse funksjonene til å etablere et konfigurasjonsspråk som er mer praktisk og bruker-vennlig, slik at den endelige konfigurasjonen i det minste er lesbar for domenebrukere.
- Integritet og koherens på tvers av noder. En av fordelene ved å ha konfigurasjon for hele det distribuerte systemet på ett sted er at alle verdier er definert strengt én gang og deretter gjenbrukt i alle steder hvor vi trenger dem. Også type-sikre portdeklæringer sikrer at i alle mulige korrekte konfigurasjoner vil systemnoder snakke samme språk. Det er eksplisitte avhengigheter mellom noder som gjør det vanskelig å glemme å gi noen tjenester.
- Høy kvalitet på endringer. Den overordnede tilnærmingen med å sende konfigurasjonsendringer gjennom normal PR-prosess etablerer høye standarder for kvalitet også i konfigurasjonen.
- Samtidig konfigurasjonsendringer. Når vi gjør endringer i konfigurasjonen, sikrer automatisk distribusjon at alle noder oppdateres.
- Forenkling av applikasjonen. Applikasjonen trenger ikke å analysere og validere konfigurasjonen og håndtere feilaktige konfigurasjonsverdier. Dette forenkler den totale applikasjonen. (Noe økning i kompleksitet skjer i selve konfigurasjonen, men det er et bevisst valg for sikkerhet.) Det er ganske enkelt å gå tilbake til vanlig konfigurasjon – bare legg til de manglende delene. Det er lettere å begynne med kompilert konfigurasjon og utsette implementering av ytterligere deler til senere.
- Versjonskontrollert konfigurasjon. Siden konfigurasjonsendringer følger den samme utviklingsprosessen, får vi et artefakt med en unik versjon. Dette lar oss bytte tilbake til en konfigurasjon om nødvendig. Vi kan til og med distribuere en konfigurasjon som ble brukt for et år siden, og den vil fungere nøyaktig på samme måte. Stabil konfigurasjon forbedrer forutsigbarheten og påliteligheten til det distribuerte systemet. Konfigurasjonen fastsettes på kompileringstidspunktet og kan ikke lett manipuleres i et produksjonssystem.
- Modularitet. Det foreslåtte rammeverket er modulært, og moduler kan kombineres på forskjellige måter for
å støtte ulike konfigurasjoner (oppsett/layouts). Spesielt er det mulig å ha et lite, enkelt nodeoppsett og et stort, multinodeoppsett. Det er rimelig å ha flere produksjonsoppsett. - Testing. For testformål kan man implementere en mock-tjeneste og bruke den som en avhengighet på en typesikker måte. Ulike testoppsett med forskjellige deler erstattet av mocks kan vedlikeholdes samtidig.
- Integrasjonstesting. Noen ganger er det vanskelig å kjøre integrasjonstester i distribuerte systemer. Ved å bruke den beskrevne tilnærmingen til typesikker konfigurasjon av det komplette fordelte systemet, kan vi kjøre alle distribuerte deler på en enkelt server på en kontrollert måte. Det er lett å etterligne situasjonen
når en av tjenestene blir utilgjengelig.
Ulemper
Den kompilte konfigurasjonstilnærmingen er forskjellig fra «normal» konfigurasjon og den passer kanskje ikke for alle behov. Her er noen av ulempene med den kompilte konfigurasjonen:
- Statisk konfigurasjon. Det er kanskje ikke egnet for alle applikasjoner. I noen tilfeller er det behov for raskt å fikse konfigurasjonen i produksjon ved å omgå alle sikkerhetstiltak. Denne tilnærmingen gjør det mer vanskelig. Kompilering og ny distribusjon er nødvendig etter å ha gjort en endring i konfigurasjonen. Dette er både en fordel og en byrde.
- Generering av konfigurasjon. Når konfigurasjonen genereres av et automasjonsverktøy, krever denne tilnærmingen påfølgende kompilering (som i sin tur kan feile). Det kan kreve ytterligere innsats for å integrere dette ekstra trinnet i byggetsystemet.
- Verktøy. Det finnes mange verktøy i bruk i dag som er avhengige av tekstbaserte konfigurasjoner. Noen av dem
vil ikke være anvendelige når konfigurasjonen er kompilert. - Det trengs et skifte i tankegangen. Utviklere og DevOps er kjent med tekstkonfigurasjonsfiler. Ideen om å kompilere konfigurasjon kan virke fremmed for dem.
- Før implentering av kompilérbar konfigurasjon er det nødvendig med en høykvalitets programvareutviklingsprosess.
Det er noen begrensninger ved det implementerte eksemplet:
- Hvis vi gir ekstra konfigurasjon som ikke kreves av nodeimplementeringen, vil ikke kompilatoren hjelpe oss med å oppdage den manglende implementeringen. Dette kan adresseres ved å bruke
HListeller ADT-er (case classes) for nodekonfigurasjon i stedet for traits og Cake Pattern. - Vi må gi noe boilerplate i konfigurasjonsfilen: (
pakke,import,objecterklæringer;
override def‘s for parametere som har standardverdier). Dette kan delvis adresseres ved å bruke en DSL. - I dette innlegget dekker vi ikke dynamisk omkonfigurering av klynger av lignende noder.
Konklusjon
I dette innlegget har vi diskutert ideen om å representere konfigurasjonen direkte i kildekoden på en typet sikker måte. Tilnærmingen kan brukes i mange applikasjoner som en erstatning for xml- og andre tekstbaserte konfigurasjoner. Til tross for at vårt eksempel er implementert i Scala, kan det også oversettes til andre kompilérbare språk (som Kotlin, C#, Swift, osv.). Man kan prøve denne tilnærmingen i et nytt prosjekt, og hvis det ikke passer godt, kan man gå tilbake til den gamle metoden.
Selvfølgelig krever kompilérbar konfigurasjon en høy kvalitet på utviklingsprosessen. Til gjengjeld lover den å gi en like høy kvalitet på robust konfigurasjon.
Denne tilnærmingen kan utvides på ulike måter:
- Man kan bruke makroer for å utføre konfigurasjonsvalidering og feile på kompileringstidspunktet i tilfelle noen forretningslogiske begrensninger mislykkes.
- En DSL kan implementeres for å representere konfigurasjonen på en domenebrukervennlig måte.
- Dynamisk ressursstyring med automatiske justeringer av konfigurasjonen. For eksempel, når vi justerer antallet klusterknuter, ønsker vi kanskje (1) at nodene skal få en litt modifisert konfigurasjon; (2) at klusterlederen mottar informasjon om de nye nodene.
Takk
Jeg vil gjerne takke Andrey Saksonov, Pavel Popov, Anton Nehaev for inspirerende tilbakemeldinger på utkastet til dette innlegget, som hjalp meg med å gjøre det klarere.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish