

God fredag til alle! Det er mindre tid igjen til kursoppstart. , så i dag deler vi oversettelsen av enda et nyttig materiale om emnet.
Under utviklingen har det blitt utført imponerende arbeid for å forbedre tabellseksjonering. Tabellseksjonering er en funksjon som har eksistert i PostgreSQL lenge, men som, om man kan si det sånn, i bunn og grunn ikke eksisterte før versjon 10, hvor den ble en svært nyttig funksjon. Tidligere har vi hevdet at arv av tabeller er vår implementering av seksjonering, og det er sant. Men denne metoden tvang deg til å gjøre det meste av arbeidet manuelt. For eksempel, hvis du ønsket at tupler skulle settes inn i seksjoner under INSERT, måtte du sette opp triggere for å gjøre det for deg. Seksjonering med arv var svært tregt og vanskelig å utvikle ytterligere funksjoner på toppen av.
I PostgreSQL 10 så vi fødselen av «deklarativ seksjonering» — en funksjon designet for å løse mange problemer som var uløselige med den gamle metoden med arv. Dette førte til fremveksten av et betydelig kraftigere verktøy som lar oss dele data horisontalt!
Sammenligning av funksjoner
I PostgreSQL 11 kom det et imponerende sett med nye funksjoner som bidrar til å øke ytelsen og gjøre seksjonerte tabeller mer gjennomsiktige for applikasjoner.
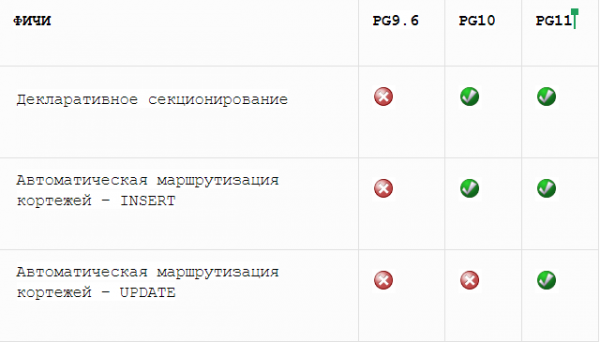
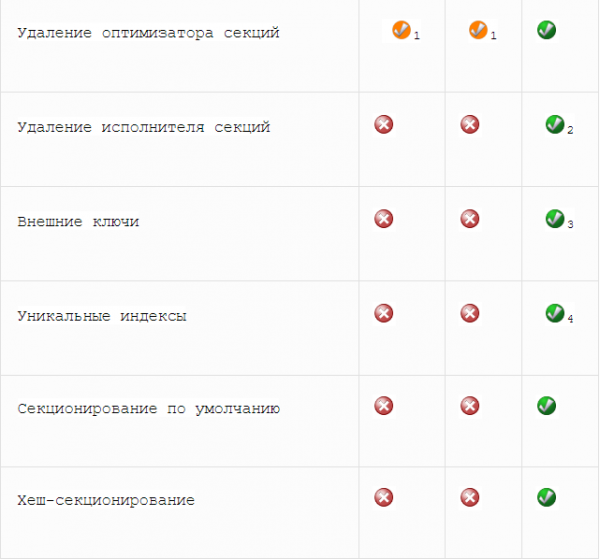
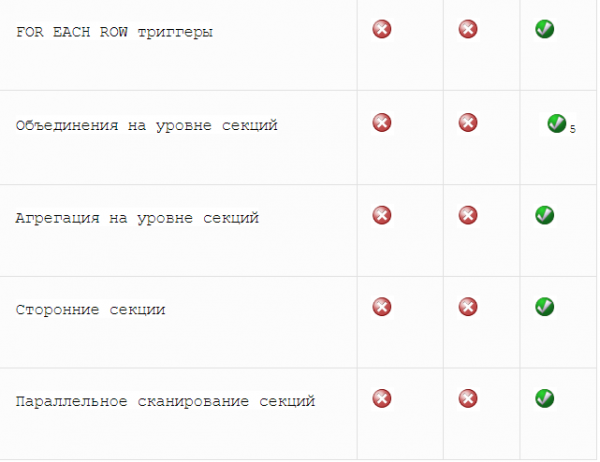
1. Bruk av begrensende unntak
2. Legger til kun noder
3. Bare for seksjonerte tabeller, som refererer til ikke-seksjonerte
4. Indekser må inneholde alle nøkkelsøile i seksjonen
5. Begrensningen på seksjoner på begge sider må matche
Ytelse
Her har vi også gode nyheter! En ny metode for . Denne nye algoritmen kan bestemme passende seksjoner ved å se på forespørselens betingelse Den maksimale/minimale hurtig oppfriskningen etter sletting eller blandede DML har ikke samme oppførsel som innsetting-tilfelle. Den sletter og beregner på nytt maks/min verdiene for de berørte gruppene. Du må være oppmerksom på dens ytelseseffekt.. Den forrige algoritmen, derimot, sjekket hver seksjon for å avgjøre om den kunne oppfylle betingelsen Den maksimale/minimale hurtig oppfriskningen etter sletting eller blandede DML har ikke samme oppførsel som innsetting-tilfelle. Den sletter og beregner på nytt maks/min verdiene for de berørte gruppene. Du må være oppmerksom på dens ytelseseffekt.. Dette førte til en ytterligere økning av planleggingstiden etter hvert som antallet seksjoner vokste.
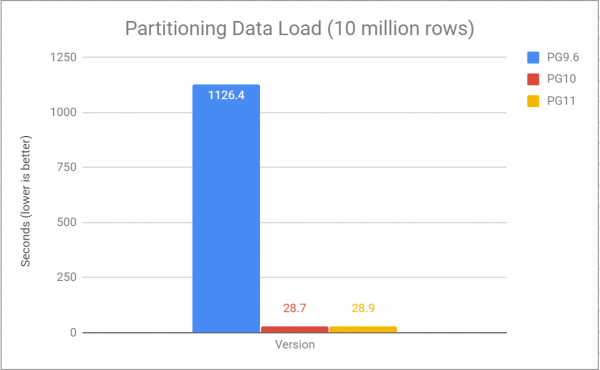
I versjon 9.6, med seksjonering ved hjelp av arv, ble ruting av tupler i en seksjon vanligvis utført ved å skrive en triggerfunksjon som inneholdt en serie IF-setninger for å sette tuple i riktig seksjon. Disse funksjonene kunne være veldig trege i utførelsen. Med deklarativ seksjonering, lagt til i versjon 10, ble dette mye raskere.
Ved å bruke en seksjonert tabell med 100 seksjoner, kan vi vurdere ytelsen ved innlasting av 10 millioner rader i en tabell med 1 BIGINT-kolonne og 5 INT-kolonner.
Ytelsen til en spørring mot denne tabellen for å finne en indeksert post og utføre DML for å manipulere én post (ved å bruke kun 1 prosessor):
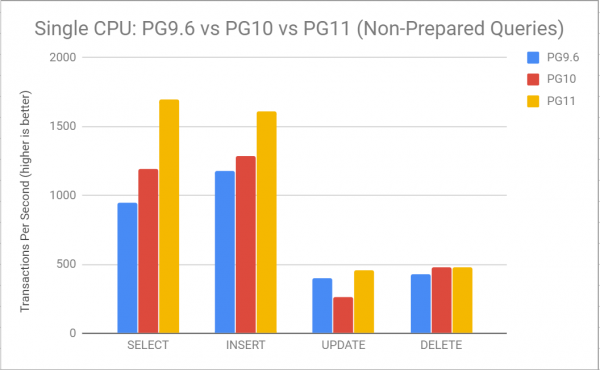
Her ser vi at ytelsen til hver operasjon har økt betydelig etter PG 9.6. Spørringer SELECT ser mye bedre ut, spesielt de som kan ekskludere flere seksjoner under spørringsplanlegging. Dette betyr at planleggeren kan hoppe over mye av arbeidet som tidligere måtte gjøres. For eksempel bygges det ikke lenger stier for unødvendige seksjoner.
Konklusjon
Seksjonering av tabeller begynner å bli en svært kraftig funksjon i PostgreSQL. Den lar oss raskt hente data online og flytte dem offline, uten å måtte vente på at langsomme, massive DML-operasjoner skal fullføres.Det betyr også at relaterte data kan lagres sammen, noe som gjør at vi kan få tilgang til nødvendige data mye mer effektivt. Forbedringene som er gjort i denne versjonen ville vært umulige uten utviklerne, anmelderne og kommittémedlemmene som har jobbet utrettelig med alle disse funksjonene.
Takk til dem alle! PostgreSQL 11 ser rett og slett fantastisk ut!
Her er en kort, men ganske interessant artikkel. Del gjerne kommentarer, og glem ikke å registrere deg for , der programmet for kurset vil bli beskrevet i detalj.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish