

Den første API-en til MinLager ble lansert for 10 år siden. Siden den gang har vi arbeidet med eksisterende versjoner av API-en og utviklet nye. Noen versjoner av API-en har allerede blitt lagt bort.
I denne artikkelen vil det være mye innhold: hvordan API-en ble utviklet, hvorfor den er nødvendig for en skybasert tjeneste, hva den gir brukerne, hvilke feil vi har gjort, og hva vi ønsker å gjøre videre.
Jeg heter Oleg Alexeev , jeg er teknisk direktør og medstifter av MinLager.
Hvorfor lage API for tjenesten
Kundene våre, som omfatter titusenvis av entreprenører, bruker aktivt skybaserte løsninger: banktjenester, nettbutikker, varebeholdningssystemer, CRM. Når du kobler til én, blir det vanskelig å stoppe. Og nå har den femte, åttende, tiende tjenesten gjort entreprenørens arbeid lettere, men dataene mellom disse skybaserte tjenestene må brukerne fremdeles overføre manuelt. Arbeidet blir et mareritt.
Det åpenbare løsningen er å gi brukerne mulighet til å overføre data mellom skybaserte tjenester. For eksempel å importere og eksportere data som filer som deretter kan lastes opp til den aktuelle tjenesten. Filer tilpasses vanligvis formatet til hver tjeneste. Dette er mer eller mindre enkel manuell arbeid, men med økningen i antall disse tjenestene blir det mer komplisert å håndtere.
Derfor er neste steg – API. Med det får den skybaserte tjenesten fordelene av å knytte flere tjenester på ett sted. Fremveksten av et slikt økosystem tiltrekker nye kunder takket være tilleggsmuligheter. Et produkt med ny funksjonalitet blir mer kostnadseffektivt og nyttig.
Å lage egne programmeringsgrensesnitt tiltrekker eksterne selgere i form av programmerere som kjenner produktet ditt takket være API. De begynner å bygge løsninger basert på det foreslåtte API og tjener penger på å automatisere oppgaver for kundene sine.
Bokføringssystemet til MinLager er bygget på enkle prosesser. Hovedsakelig dreier det seg om å håndtere primær dokumentasjon, muligheten til å gjennomføre mottak og utsendelse av varer, og å generere rapporter for bedriften basert på primærdata. Det er også dataoverføring, for eksempel til skybasert regnskap, samt mottak av data fra banksystemer eller detaljutsalg. I tillegg arbeider vi med nettbutikker: vi får informasjon om produkter og sender data om beholdningen.
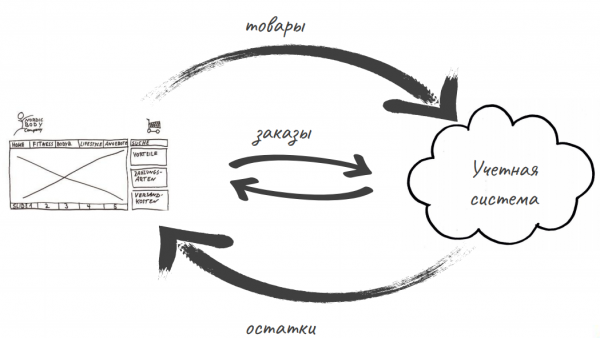
Første API til MinLager
I løpet av de 10 årene MinLager har jobbet med API, har vi samlet mange integrasjoner som gjør det mulig å utveksle data, arbeide med banker, gjennomføre betalinger og bruke ekstern telefoni.
I det første året lagde vi muligheten til å eksporterer alle data i XML-format. Den gangen var det mye mer vanlig og kjent for brukerne å holde dataene offline, snarere enn i noen sky, og vi ga dem det. Eksportprosessen ble initiert via manuell eksport fra grensesnittet. Det var dermed ikke noe man kunne kalle et API.
Samtidig begynte vi samarbeidet med selskapet Rusagro – de brukte allerede et 'modent' ERP-system for produksjons- og distribusjonsplanlegging, men automatiseringen av lasting av vognene på fabrikkene ble gjort i MinLager. Så fikk vi våre første frø til et ekte API: utvekslingen mellom tjenesten vår og ERP-systemet skjedde ved å sende en stor fil med data for alle dokumenttyper.
Dette var en grei løsning for batch-utveksling av data, men sammen med dokumentene måtte man også sende avhengighetene deres: informasjon om varer, kontraktsparter og lagre. Å generere en slik blanding er ikke så vanskelig ved eksport, men det er ganske vanskelig å sortere den ved import, ettersom all informasjon kommer i én pakke: både om nye dokumenter og om eksisterende.
Det første XML APIet levde ikke lenge – etter to år begynte vi å omstrukturere det. Allerede tidlig i driftsfasen gjorde vi flere feil i oppbyggingen av grensesnittet.
Slik ble XML API laget: illustrasjonen er laget av en av våre arkitekter. Forresten, se frem til hans artikler.
Her er våre hovedfeil:
- JAXB-merking ble gjort direkte på entity beans. For kommunikasjon med databasen bruker vi Hibernate, og JAXB-merking ble gjort på de samme bønnene. Denne feilen dukket opp nesten umiddelbart: hver oppdatering av datakonstruksjonen førte til at alle som brukte API måtte varsles omgående, eller man måtte lage 'klosser' som sikret kompatibilitet med den tidligere datakonstruksjonen.
- API utviklet seg som et supplement, og i starten definerte vi ikke hvilken del av produktet det utgjorde. Vi tenkte ikke over om API var viktig, eller om vi måtte opprettholde bakoverkompatibilitet for de første kundene. På et tidspunkt utgjorde antallet API-brukere omtrent 5% av det totale lille antallet, og vi ga dem ikke noe oppmerksomhet. Den universelle filtreringen som ble gjort tidligere førte til at vi ble brukt som backend. Denne filtreringen var ikke helt GraphQL, men noe lignende — det fungerte gjennom en mengde parametere i forespørselen. Med et så kraftig verktøy var det vanskelig for brukerne å motstå, og forespørslene ble sendt direkte fra UI-en til nettbutikkene deres. Situasjonen ble et ubehagelig overraskelse, fordi å tilby en slik tjeneste burde kreve en annen prising og en helt annen forståelse av API som produkt.
- Fordi API utviklet seg ikke som et hovedprodukt, ble dokumentasjonen for API produsert og publisert på et etterløpende grunnlag — gjennom reversering av ingeniørarbeid. Denne tilnærmingen virker ganske enkel og praktisk, men er i strid med kontraktsarbeid. Det er når det er en komponent med en forhåndsbestemt arbeidsordning. Utvikleren implementerer den i henhold til denne ordningen og oppgaven, komponenten gjennomgår testing, og kunden mottar produktet som samsvarer med analytikerenes visjon. Reversering av ingeniørarbeid kaster imidlertid et produkt på markedet som bare eksisterer: med lappeløsninger, merkelige beslutninger og
- Hele strømmen av forespørselene som kom gjennom API-en kunne ikke analyseres mer enn som en logg fra Nginx eller applikasjonsserveren. Dette tillot ikke å fremheve temaområder, bortsett fra å dele opp etter brukere og abonnenter. Hvis det ikke er mulighet til å regulere registreringen av applikasjonen eller kundene, blir det umulig å analysere situasjonen. Dette problemet påvirket på en minimal måte utviklingen av API-en; det handler mer om forståelsen av etterspørselen og funksjonaliteten.
Forsøk nummer to: REST API
I 2010 prøvde vi å bygge et system for utveksling med online-regnskapet – BukhSoft. Det ble ikke vellykket. Men i prosessen med integrasjonen oppstod det et fullt API: et REST-tjeneste for utveksling, hvor det ikke var rom for unntak som RPC-kall. All kommunikasjon med API-et ble ført over i den standardiserte REST-modusen: i forespørselen er navnet på enheten og operasjonen som utføres, bestemmes ved hjelp av HTTP-metoden. Vi la til filtrering etter oppdateringspunktene for enhetene, og brukerne fikk mulighet til å bygge replikering med sine egne systemer.
Samme år ble det laget et API for å eksportere lager- og varebeholdning. Gjennom API-et ble de mest verdifulle delene av systemet tilgjengelige for brukerne – utveksling av primær dokumentasjon og beregningsdata for beholdningene og kostnadene av varene.
I desember 2015 publiserte RetailCRM det første tredjepartsbiblioteket for tilgang til vårt API. Det ble ganske aktivt brukt, samtidig som populariteten til tjenesten generelt vokste, og belastningen på API-et økte raskere enn belastningen på webgrensesnittet. En gang ble veksten til et sjokk.
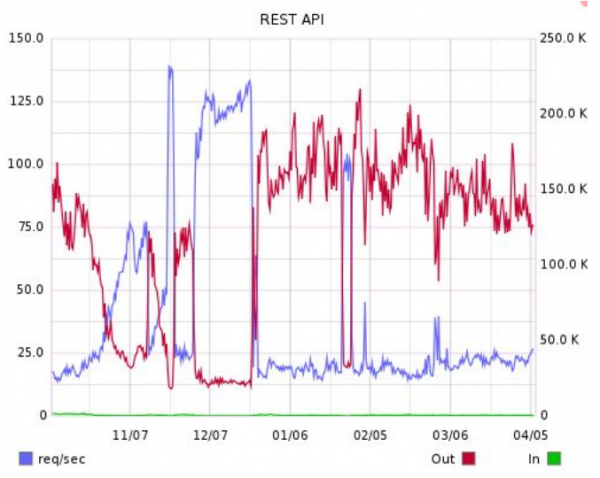
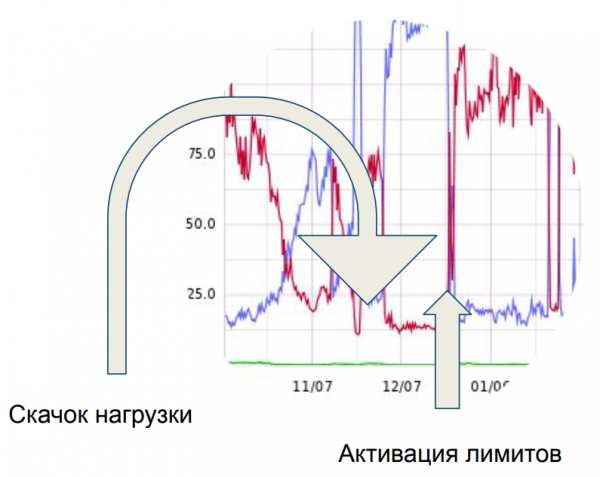
Og dette sjokket, som pilen til venstre viser, førte til fullstendig forbløffelse av serveren som betjente vårt API. I en uke jobbet vi med å finne ut hva som forårsaket denne belastningen. Det viste seg at det var nettopp de forespørslene som ble sendt til vårt API fra klientenes fronter. Rundt 50 klienter skapte belastningen. Her innså vi en av våre feil – den totale mangelen på grenser.
Som et resultat innførte vi en grense for antall samtidige forespørsel. Fra en konto ble det nå tillatt å åpne maksimalt to forespørsel samtidig. Dette er tilstrekkelig for å jobbe i replikasjonsmodus for datautveksling i batchmodus. De som ville bruke oss som backend, måtte fra dette punktet mer tilpasse seg prisplanene, ettersom de innførte arbeid med flere kontoer i programvaren sin.
Orden i rekken
Allerede fra 2014 ble etterspørselen etter det eksisterende API-et en viktig del av virksomheten, og API-et genererte den største datamengden i datautveksling med kundene. I 2015 startet vi et prosjekt for å rydde opp i API-et. Vi valgte JSON som format i stedet for XML og begynte å bygge det på grunnlag av de egenskapene vi avdekket under implementeringen av den forrige versjonen:
- Muligheten til å administrere versjoner. Versjonering gjør det mulig å utvikle en ny versjon uten å berøre eksisterende applikasjoner og uten å forstyrre brukerne.
- Muligheten for brukeren å se metadata i svaret han får.
- Muligheten til å utveksle store dokumenter. Når vi behandler et dokument med flere enn 4-5 tusen poster, blir det et problem for serveren: lange transaksjoner, lange http-forespørsel. Vi har bygget en spesialmekanisme som lar oss oppdatere dokumentet del for del og håndtere individuelle poster i dette dokumentet ved å sende dem til serveren.
- Verktøy for replikasjon – var også i forrige versjon.
- Belastningsgrenser – som et resultat av problemene vi støtte på i forrige versjon. Vi innførte grenser for antall forespørsel innen en tidsramme, antall parallelle forespørsel og forespørsel fra én ip-adresse.
Siden da har vi utgitt to mindre versjoner av API-et og lansert flere spesialiserte API-er, men generelt har tilnærmingen forblitt uendret. Den oppdaterte utvekslingsformatet og den nye arkitekturen har gjort det mulig å rette opp mangler i API-et mye raskere.
API-en til MinLager i dag
I dag løser API-en til MinLager mange oppgaver:
- datautveksling med nettbutikker, regnskapssystemer, banker;
- innhenting av beregningsdata, rapporter;
- bruk som backend for klientapplikasjoner – våre mobile applikasjoner og stasjonære kasser arbeider gjennom API-et.
- sending av varsler om endringer i dataene i MinLager – webhooks;
- telefoni;
- lojalitetssystemer.
Basert på API-et skrev vår administrerende direktør Askar Rakhimberdiev på fire timer en telegram-bot som henter lagerbeholdningene via API-et:
Nå tørre tall.
Her er vår statistikk for det gamle REST API-et:
- 400 selskaper;
- 600 brukere;
- 2 millioner forespørsel per dag;
- 200 GB/dag utgående trafikk.
Og her er hva vi har oppnådd med alle API-ene til MinLager:
- over 70 integrasjoner (noen av dem kan sees her );
- 8500 selskaper;
- 12 000 brukere;
- 46 millioner forespørsel per dag;
- 2 TB/dag utgående trafikk.
Hva nå
API-utviklingsplanene er i aktiv diskusjon. Vi prøver å ta hensyn til driftsopplevelsen som brukerne gir oss. Ikke alt kan alltid gjøres med en gang, men en ny versjon av API-et med mer brukervennlige metadata og mindre komplisert struktur, OAuth for autentisering, og API for applikasjonsintegrasjoner er like rundt hjørnet.
Du kan følge med på nyhetene på en spesialside for utviklere som integrerer med MinLager: .
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish