

Ærlig talt lo Ivan ofte av kollegenes forgjeves anstrengelser fra overvåkingsavdelingen. De la ned store krefter for å implementere metrikker bestilt av ledelsen i selskapet. De var så opptatt at de ikke ville gjøre noe annet.
Og ledelsen var aldri fornøyd – de bestilte stadig flere og flere metrikker og sluttet raskt å bruke det som allerede var gjort.
Nå om dagen var det bare snakk om LeadTime – tiden det tok å levere forretningsfunksjoner. Metrikken viste et vanvittig tallet – 200 dager for å levere én oppgave. Hvordan folk sukka, gispte og løftet hendene mot himmelen!
Etter en stund stilnet støyen, og ledelsen ba om å lage enda en metrik.
Ivan forsto godt at den nye metrikken også ville dø stille i et mørkt hjørne.
Virkelig, tenkte Ivan, tallet forteller ingen noe som helst. 200 dager eller 2 dager – det er ingen forskjell, fordi man kan ikke utlede årsaken eller avgjøre om det er bra eller dårlig ut fra tallet.
Dette er den typiske fellene med metrikker: det virker som om den nye metrikken vil avsløre livets essens og forklare en skjult hemmelighet. Alle håper så mye på dette, men ingenting skjer av en eller annen grunn. Fordi hemmeligheten ikke skal søkes i metrikker!
For Ivan var dette et tema han allerede hadde vært igjennom. Han visste at for målinger, og alle hemmelighetene må søkes i , det vil si det som former denne metrikken.
For en nettbutikk vil påvirkningsobjektet være kundene som bringer inn penger, mens for DevOps vil det være teamene som lager og distribuerer pakker ved hjelp av rørledningen.
En dag, mens han slappet av i en komfortabel stol i hallen, bestemte Ivan seg for å tenke grundig gjennom hvordan han ønsket å se DevOps-metrikker med tanke på at påvirkningsobjektet er teamene.
Målene med DevOps-metrikker
Det er klart at alle ønsker å redusere leveringstiden. 200 dager – det er jo helt uholdbart.
Men hvordan, det er spørsmålet?
I selskapet jobber hundrevis av team, og tusenvis av pakker passerer gjennom DevOps-rørledningen hver dag. Den reelle leveringstiden vil fremstå som en fordeling. Hvert team vil ha sin egen tid og sine egne særegenheter. Hvordan kan man finne noe som helst blant dette kaoset?
Svaret kom av seg selv – man må finne de problematiske teamene og finne ut hva som skjer med dem og hvorfor det tar så lang tid, og av «gode» team lære hvordan alt gjøres raskt. For dette er det nødvendig å måle tiden teamene bruker på hver av DevOps-standene:
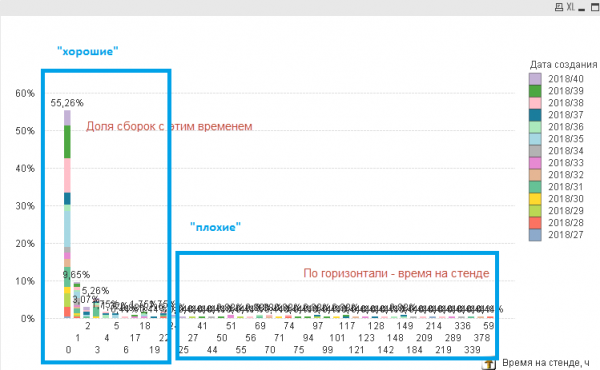
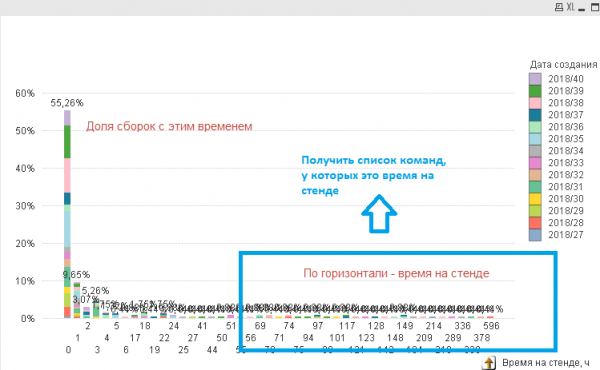
«Målet med systemet vil være å velge team basert på tiden det tar å gjennomføre standene, det vil si at vi til slutt må få en liste over team med den valgte tiden, og ikke bare et tall.
Hvis vi finner ut hvor mye tid som totalt er brukt på standen og hvor mye tid som er brukt på venting mellom standene, kan vi kontakte teamene, snakke med dem og få en mer detaljert forståelse av årsakene og fjerne dem», tenkte Ivan.
Hvordan beregne leveringstid for DevOps
For å kunne beregne dette måtte vi gå dypere inn i DevOps-prosessen og dens essens.
I selskapet brukes et begrenset antall systemer, og informasjon kan bare hentes fra dem, ingen andre steder.
Alle oppgaver i selskapet ble registrert i Jira. Når en oppgave ble tatt til behandling, ble det opprettet en branch for den, og etter implementering ble det gjort et commit i BitBucket og en Pull Request. Når PR (Pull Request) ble akseptert, ble det automatisk opprettet et distribusjonsregnskap og lagret i Nexus-lageret.

Deretter ble distribusjonen rullet ut på flere stander med hjelp av Jenkins for å sjekke korrektheten av utrullingen, automatisk og manuell testing:
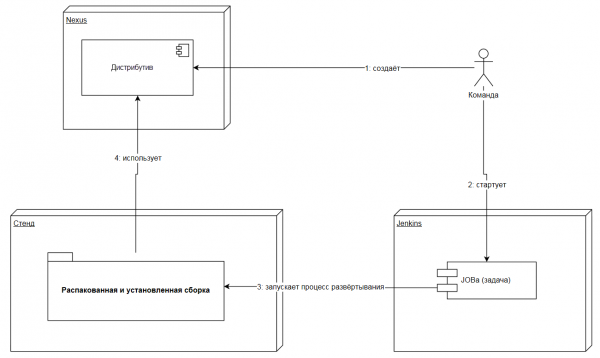
Ivan beskrev fra hvilke systemer hvilken informasjon som kan hentes for å beregne tiden på standene:
- Fra Nexus – Tidspunkt for opprettelse av distribusjonen og navnet på mappen der koden til teamet ble lagret
- Fra Jenkins – Starttid, varighet og resultat av hver jobb, navnet på standen (i jobbparametrene), stadiene (steg av jobben), lenke til distribusjonen i Nexus.
- Jira og BitBucket bestemte Ivan seg for å ikke inkludere i kjeden, siden de mer hørte til utviklingsfasen, og ikke til utrullingen av den ferdige distribusjonen gjennom standene.
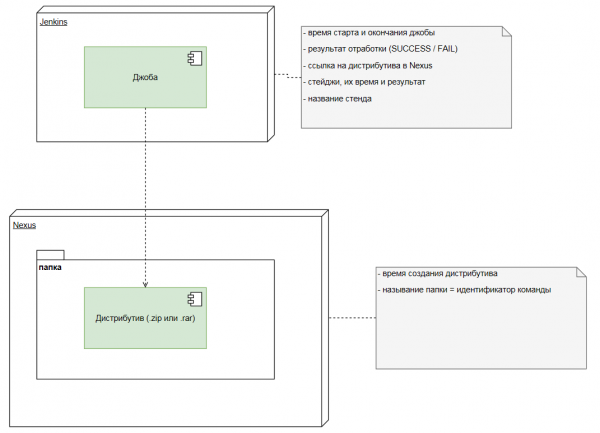
Basert på den tilgjengelige informasjonen ble det utarbeidet et slikt skjema:
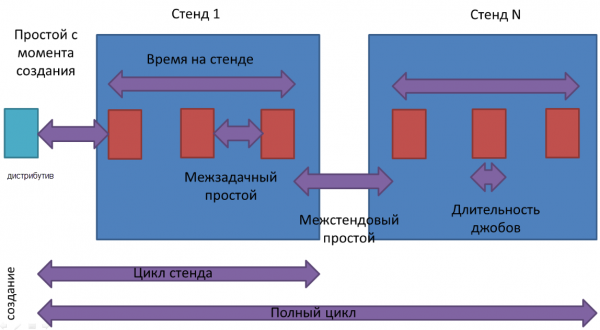
Ved å vite hvor mye tid det tar å opprette distribusjoner og hvor mye tid som brukes på hver av dem, kan man lett beregne de totale kostnadene for å gjennomføre hele DevOps-kjeden (full syklus).
Slik ble DevOps-metrikker til Ivan til slutt:
- Antall opprettede distribusjoner
- Andel distribusjoner som "kom inn" på standen og "bestand" standen
- Tiden brukt på standen (syklus av standen)
- Full cycle (total time for all stands)
- Job duration
- Downtime between stands
- Downtime between job launches on the same stand
On one hand, the metrics very well characterized the DevOps pipeline in terms of time, but on the other, they were considered too simplistic.
Satisfied with his work, Ivan prepared a presentation and went to present it to the management.
On the way back, he looked gloomy and with his hands down.
— This is a fiasco, buddy — smiled the ironic colleague…
Read the continuation in the article "».
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish