

Om sommeren synker tradisjonelt både kjøpsaktiviteten og intensiteten av endringer i infrastrukturen for webprosjekter, forteller oss Kaptein Åpenbaring. Bare fordi selv IT-folk, som det hender, går på ferie. Og CTO-er også. Det er tyngre for dem som blir igjen på posten, men det er ikke det vi snakker om nå: kanskje er det derfor sommeren er den beste perioden for å i ro og mak overveie den eksisterende reserveløsningen og lage en plan for å forbedre den. Og erfaringen til Egor Andreev fra , som han delte på konferansen .
Når vi bygger reservedatasteder, er det flere feller som man kan falle i. Og det er helt uakseptabelt å gjøre det. Det som ødelegger oss i dette, som i mye annet, er perfeksjonisme og… latskap. Vi prøver å gjøre alt helt perfekt, men det er ikke nødvendig å gjøre alt perfekt! Det er bare nødvendig å gjøre visse ting, men gjøre dem riktig, fullføre dem slik at de fungerer som de skal.
Failover er ikke bare en morsom ting «bare for moro skyld»; det er noe som skal gjøre én ting — redusere nedetid, slik at tjenesten og selskapet taper mindre penger. Og i alle metoder for reservasjoner foreslår jeg å tenke i følgende kontekst: hvor er pengene?
Den første fellen: Når vi bygger store, pålitelige systemer og jobber med reservasjon — reduserer vi antallet uhell. Dette er en skremmende misforståelse. Når vi jobber med reservasjoner, øker vi sannsynligvis antallet uhell. Og hvis vi gjør alt riktig, vil vi totalt redusere nedetiden. Det vil bli flere uhell, men de vil skje med mindre kostnader. For hva er reservasjon? — det er en komplisering av systemet. Enhver komplisering er dårlig: vi får flere skruer, flere tannhjul, med andre ord, flere elementer — og dermed høyere sjanse for feil. Og de vil faktisk gå i stykker. Og de vil gå i stykker oftere. Et enkelt eksempel: si at vi har et nettsted, med PHP, MySQL. Og det må haste reserveres.
Vel, vi tar den andre plattformen og bygger et identisk system... Kompleksiteten dobles — vi har to enheter. Og i tillegg implementerer vi en viss logikk for dataoverføring fra den ene plattformen til den andre — det vil si databasering, kopiering av statiske ressurser, og så videre. Så, logikken for replikering — den er vanligvis veldig kompleks, og dermed kan den samlede kompleksiteten i systemet være ikke bare 2, men 3, 5, 10 ganger mer.
Den andre fella: når vi bygger virkelig store, komplekse systemer, liker vi å fantasere om hva vi ønsker å oppnå til slutt. Voilà: vi ønsker å skape et superpålitelig system som fungerer uten nedetid, som kan veksle over på et halvt sekund (eller enda bedre, helt umiddelbart), og vi begynner å realisere drømmer. Men her er det også en nyanse: jo kortere ønsket vekselverdi er, desto mer kompleks blir logikken i systemet. Jo mer komplisert logikken må være, jo oftere vil systemet bryte sammen. Og man kan havne i en veldig uheldig situasjon: vi prøver med alle midler å redusere nedetiden, men vi gjør det bare mer komplisert, og når noe går galt, blir nedetiden i stedet lengre. Her fanger man seg selv med tanken: det ville vært bedre om vi ikke hadde reservert. Det ville vært bedre om det leverte én gang og med forståelig nedetid.
Hvordan kan vi kjempe mot dette? Vi må slutte å lyve for oss selv, slutte å skryte av at vi nå skal bygge romskip, men i stedet realistisk forstå hvor lenge prosjektet kan vare. Og i henhold til denne maksimale tiden, vil vi velge hvilke metoder vi vil bruke for å øke påliteligheten til systemet vårt.
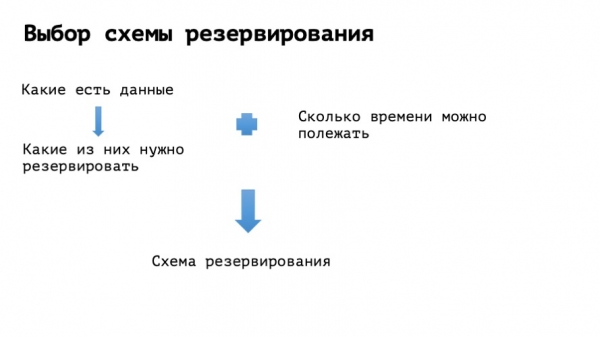
Det er på høy tid for 'historier fra livet'... fra virkeligheten, selvsagt.
Eksempel nummer én
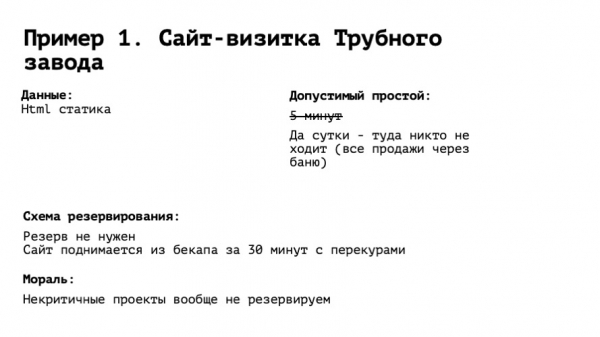
Tenk på et digitalt visittkort for rørfabrikk nr. 1 i byen N. Det står med store bokstaver — RØRFABRIKK NR. 1. Litt lenger ned er slagordet: «Rørene våre er de mest runde rørene i N». Og nederst står telefonnummeret til direktøren og navnet hans. Vi forstår at det er viktig å reservere — det er jo en veldig viktig ting! La oss begynne å finne ut av hva det består av. Html-statiske filer — det vil si et par bilder der direktøren sitter ved bordet i badstuen med sin partner og diskuterer en ny avtale. Vi begynner å tenke på nedetid. Det kommer til hodet vårt: vi må være der i fem minutter, ikke mer. Og så spørsmålet: hvor mange salg har vi gjort fra denne nettsiden? Hvor mange? Hva mener du med «null»? Vel, det betyr at alle fire avtalene fra i fjor ble gjort ved samme bord med de samme folkene som de går i badstuen med. Vi forstår at selv om nettsiden ligger nede en dag, vil det ikke være så farlig.
Basert på informasjonen, har vi en dag til å få dette på plass. Vi begynner å tenke på reservasjonsordningen. Og vi velger den ideelle reservasjonsløsningen for dette eksempelet: vi bruker ikke reservasjon. Hele denne greia kan settes opp av hvilken som helst administrator på en halvtime, med pauser. Installere webserveren, legge inn filene — ferdig. Det vil fungere. Ingenting må overvåkes, ingenting trenger spesiell oppmerksomhet. Altså er konklusjonen fra eksempel nummer én ganske åpenbar: tjenester som ikke trenger å reserveres — trenger ikke å reserveres.
Eksempel nummer to
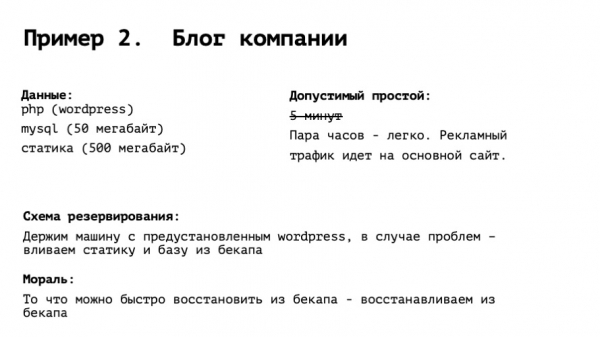
Firmaens blogg: spesialiserte personer skriver nyheter der, for eksempel deltok vi på en viss utstilling, eller vi har lansert et nytt produkt og så videre. La oss si at dette er standard PHP med WordPress, en liten database og litt statisk innhold. Man tenker selvsagt at man ikke bør være inaktiv — "ikke mer enn fem minutter!", alt det der. Men la oss tenke mer på det. Hva gjør denne bloggen? Den får besøk fra Yandex, fra Google etter bestemte søk, fra organisk trafikk. Flott. Men er salgene i det hele tatt knyttet til den? Erkjennelse: ikke spesielt. Annonsetrafikk går til hovedsiden, som er på en annen server. Vi begynner å tenke på en reserveordning for bloggen. Ideelt sett bør vi kunne gjenopprette den på et par timer, så det ville vært bra å forberede seg på det. Det ville være fornuftig å ta en maskin i et annet datasenter, installere miljøet der, altså webserver, PHP, WordPress, MySQL, og la det ligge inaktivt. I det øyeblikket vi innser at noe har gått galt, må vi gjøre to ting — gjenopprette en MySQL-dump på 50 MB, som går raskt, og gjenopprette et visst antall bilder fra sikkerhetskopien. Dette tar heller ikke lang tid. På denne måten kan vi få alt oppe igjen på en halvtime. Ingen replikasjoner, eller, for guds skyld, automatisk failover. Konklusjon: det vi raskt kan gjenopprette fra sikkerhetskopi, trenger ikke å reservert.
Eksempel nummer tre, litt mer komplisert
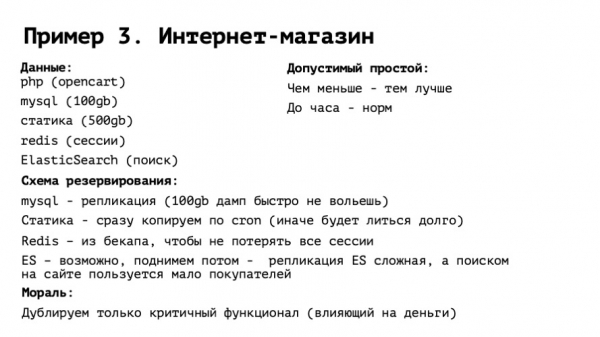
Nettbutikk. PHP med litt modifisert open heart, MySQL med en solid database. Ganske mye statisk innhold (for en nettbutikk har vi jo fine HD-bilder og alt det der), Redis for sesjoner og Elasticsearch for søk. Vi begynner å tenke på nedetid. Og her er det åpenbart at nettbutikken ikke kan være ute av drift en hel dag uten alvorlige konsekvenser. Jo lenger den er nede, desto mer penger taper vi. Det er på tide å handle. Men hvor mye? Jeg tror at hvis vi er nede i en time, vil ingen gå fra forstanden. Ja, vi mister noe, men hvis vi begynner å stresse — vil det bare bli verre. Vi definerer tolerant nedetid, tillatt pr. time.
Hvordan kan alt dette reserveres? En maskin er nødvendig uansett: en time er ganske lite. Mysql: her trenger vi replikasjon, levende replikasjon, fordi 100 GB i dump mest sannsynlig ikke vil være mulig å overføre på en time. Statikk, bilder: igjen, på en time kan 500 GB ikke rekke å lastes opp. Derfor er det best å begynne å kopiere bildene med en gang. Redis: her blir det mer interessant. I Redis ligger sesjoner — vi kan ikke bare ta det og begrave det. For det vil ikke være bra: alle brukere vil bli logget ut, handlekurvene vil bli tømt, og så videre. Folk må tvinges til å skrive inn brukernavn og passord på nytt, og mange kan bli borte og ikke fullføre kjøpet. Igjen, konverteringen vil falle. På den annen side, Redis er helt aktuell, med de sist påloggede brukerne, kanskje det heller ikke er nødvendig. En god kompromiss er å ta Redis og gjenopprette det fra en backup, fra i går, eller, hvis det blir gjort hver time, fra en time siden. Heldigvis er gjenopprettingen fra backup ganske enkelt en kopiering av én fil. Den mest interessante historien er Elasticsearch. Hvem har noen gang satt opp MySQL-replikasjon? Hvem har noen gang satt opp Elasticsearch-replikasjon? Og hvem har hatt den til å fungere ordentlig etterpå? Jeg mener: vi ser en viss enhet i systemet vårt. Den virker nyttig — men den er komplisert.
Vanskelig i den forstand at våre ingeniørkolleger har ingen erfaring med det. Enten har de negativ erfaring. Eller vi forstår at dette fortsatt er en ganske ny teknologi med særtrekk eller umodenhet. Vi tenker... Pokker, elastic er også stort, det tar lang tid å gjenopprette fra backup, hva gjør vi? Vi forstår at elastic brukes til søk i vårt tilfelle. Men hvordan selger nettbutikken vår? Vi går til markedsførerne og spør hvor folk kommer fra. De svarer: "90 % kommer direkte fra Yandex-markedet til produktsiden." Og enten kjøper de, eller så gjør de det ikke. Følgelig trenger 10 % av brukerne søk. Og å ha replikasjon av elastic, spesielt mellom forskjellige datasentre i ulike soner, har virkelig mange nyanser. Hva er løsningen? Vi tar elastic på et reservert sted og gjør ingenting med det. Hvis saken drar ut, kan vi muligens heve det senere, men det er ikke sikkert. Egentlig er konklusjonen pluss-minus den samme: Tjenester som ikke påvirker inntektene, reserverer vi ikke igjen. For å holde ordningen enklere.
Eksempel nummer fire, enda vanskeligere.
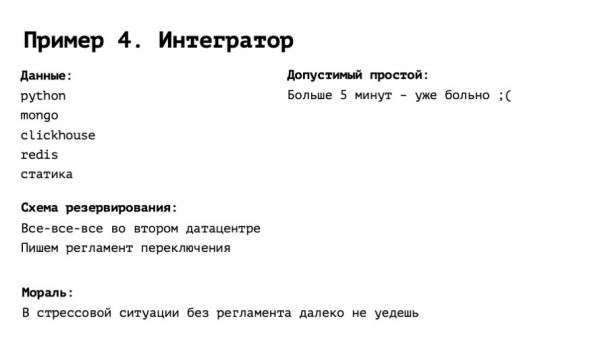
Integrator: salg av blomster, bestilling av taxi, salg av varer, kort sagt, hva som helst. En seriøs greie som fungerer 24/7 for et stort antall brukere. Med en fullverdig interessant teknologistack, hvor det er spennende databaser, løsninger, høy belastning, og viktigst av alt, den bør ikke være nede i mer enn 5 minutter. Ikke bare fordi folk ikke kjøper, men fordi de vil se at denne tingen ikke fungerer, bli frustrert og kanskje ikke komme tilbake igjen.
Greit. Fem minutter. Hva skal vi gjøre med dette? I dette tilfellet bygger vi seriøst, for alle penger, en ekte reserveplass, med replikasjon av alt og alle, og muligens automatiserer vi også overgangen til denne plassen. Og i tillegg til dette er det viktig å huske på én ting: å faktisk skrive en bytteprosess. Prosedyren, selv om alt er automatisert, kan være veldig enkel. Av typen "kjør dette ansible-scenarioet", "trykk på den aktuelle avmerkingsboksen i route 53", osv.— men det må være en presis liste over handlingene.
Og det virker som om alt er klart. Å bytte replikasjon er en triviel oppgave, eller så kan den bytte seg selv. Å skrive domene navnet inn i DNS er av samme sjanger. Problemet er at når et slikt prosjekt faller, begynner panikken, og selv de sterkeste, erfarne administratorene kan bli rammet av den. Uten en klar instruksjon "åpne terminalen, går hit, adressen til serveren vår er fortsatt slik" er det vanskelig å holde tidsrammen på 5 minutter for gjenoppretting. Og i tillegg, når vi bruker denne reguleringen, er det lett å fikse endringer i infrastrukturen, for eksempel, og endre reguleringen deretter.
Men, hvis reservasjons-systemet er veldig komplisert og vi på et tidspunkt gjorde en feil, kan vi også legge ned vårt backup-sted, og i tillegg kan dataene bli til gresskar på begge steder — det ville vært ganske trist.
Eksempel nummer fem, hardcore.
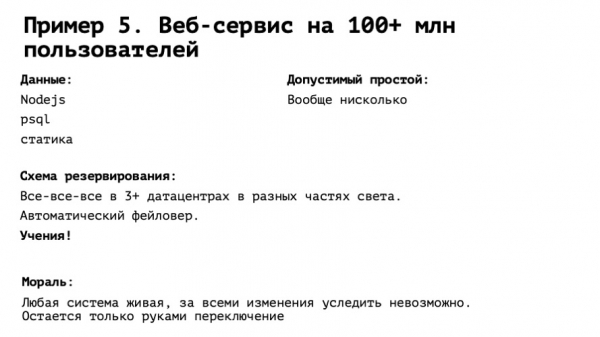
Internasjonal tjeneste med hundre millioner brukere over hele verden. Alle tidssoner, som finnes, highload på maks, kan ikke være nede i det hele tatt. Ett minutt — og det blir trist. Hva gjør vi? Vi reserverer, igjen, fullt ut. Vi gjorde alt jeg snakket om i forrige eksempel, og litt mer. Den ideelle verden, og vår infrastruktur — den er i henhold til alle definisjoner av devops IaaC. Det vil si at alt er i git, og du må bare trykke på knappen.
Hva mangler? En ting — øvelser. Uten dem kan vi ikke. Det ser ut til at alt er perfekt, vi har alt under kontroll. Vi trykker på knappen, alt skjer. Selv om det er slik — og vi forstår at det ikke alltid er slik — vårt system interagerer med andre systemer. For eksempel, dette er DNS fra route 53, s3-lagring, integrasjon med noen API-er. Vi kan ikke forutse alt i dette hypotetiske eksperimentet. Og før vi faktisk drar i strømbryteren — vil vi ikke vite om det fungerer eller ikke.
Det er vel alt. Ikke vær lat, og ikke overdriv. Og måtte uptime være med dere!
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish