

I 2017 vant vi konkurransen om utviklingen av det transaksjonelle kjernen til investeringstjenestene i Alfa-Bank og begynte arbeidet (på HighLoad++ 2018 med en presentasjon om kjernen til investeringstjenestene Vladimir Drynkin, leder for retningen til det transaksjonelle kjernen for investeringstjenester i Alfa-Bank). Dette systemet skulle aggregere data om transaksjoner fra ulike kilder i forskjellige formater, standardisere dataene, lagre dem og gi tilgang til dem.
I løpet av utviklingen utviklet systemet seg og fikk flere funksjoner, og på et tidspunkt innså vi at vi sementerte noe mye mer enn bare applikasjonsprogramvare laget for å løse en bestemt gruppe oppgaver: vi utviklet et system for å bygge distribuerte applikasjoner med vedvarende lagring. Erfaringen vi fikk, la grunnlaget for et nytt produkt — (TDG).
Jeg ønsker å fortelle om arkitekturen til TDG og om de løsningene vi kom frem til under utviklingen, introdusere deg for hovedfunksjonaliteten og vise hvordan produktet vårt kan bli grunnlaget for å bygge komplette løsninger.
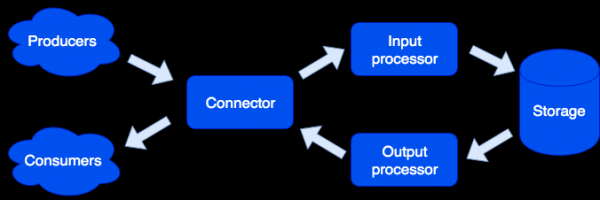
Arkitektonisk har vi delt systemet i separate roller, hver av dem ansvarlig for å løse et bestemt sett med oppgaver. En kjørende instans av applikasjonen implementerer en eller flere typer roller. Det kan være flere roller av samme type i klyngen:
Connector
Connectoren er ansvarlig for forbindelsen til den ytre verden; dens oppgave er å motta forespørselen, analysere den, og hvis det lykkes, sende dataene til behandling i input-prosessoren. Vi støtter formatene HTTP, SOAP, Kafka, FIX. Arkitekturen tillater enkelt å legge til støtte for nye formater, og snart vil vi ha støtte for IBM MQ. Hvis analysen av forespørselen mislykkes, vil connectoren returnere en feil; i motsatt fall vil den svare med at forespørselen ble behandlet, selv om det oppstod en feil i den videre behandlingen. Dette er gjort spesielt for å kunne jobbe med systemer som ikke kan gjenta forespørslene - eller tvert imot, gjør det for mye. For å unngå datatap brukes en reparasjonskø: objektet går først inn i den, og først etter vellykket behandling fjernes det derfra. Administratoren kan motta varsler om objekter som blir igjen i reparasjonskøen, og etter å ha løst programfeilen eller maskinvarefeilen, kan en ny forsøk bli gjort.
Input prosessor
Input prosessoren klassifiserer de mottatte dataene etter karakteristiske trekk og kaller passende behandlere. Behandlerne er kode skrevet i Lua, kjørt i en sandkasse, og kan derfor ikke påvirke systemets funksjonalitet. På dette stadiet kan dataene formes til et nødvendig format, og om nødvendig kan et valgfritt antall oppgaver startes som kan implementere den nødvendige logikken. For eksempel, i produktet MDM (Master Data Management), bygget på Tarantool Data Grid, når vi legger til en ny bruker, for å ikke bremse forespørselbehandlingen, starter vi opprettelsen av den gyldne posten som en separat oppgave. Sandkassen støtter forespørselene for lesing, endring og tillegg av data, og tillater å utføre en funksjon for alle roller som lagring og aggregere resultatet (map/reduce).
Behandlere kan beskrives i filer:
sum.lua

local x, y = unpack(...)
return x + y
Og deretter, erklært i konfigurasjonen:
functions:
  sum: { __file: sum.lua }
Hvorfor Lua? Lua er et veldig enkelt språk. Basert på vår erfaring, etter et par timer med å bli kjent med det, begynner folk å skrive kode som løser deres oppgaver. Og dette er ikke bare profesjonelle utviklere, men for eksempel analytikere. I tillegg, takket være jit-kompilatoren, fungerer Lua veldig raskt.
Lagring
Lagring lagrer permanente data. Før lagring valideres dataene mot dataskjemaet. Vi bruker et utvidet format for å beskrive skjemaet. . Eksempel:
{
    "name": "Bruker",
    "type": "record",
    "logicalType": "Aggregat",
    "fields": [
        { "name": "id", "type": "string"},
        {"name": "fornavn", "type": "string"},
        {"name": "etternavn", "type": "string"}
    ],
    "indexes": ["id"]
}
Basert på denne beskrivelsen genereres det automatisk DDL (Data Definition Language) for Tarantool DB og skjemaet for tilgang til data.
Asynkron datagjengivelse støttes (det er planer om å legge til synkronisering).
Utdata prosessor
Noen ganger er det nødvendig å varsle eksterne forbrukere om innkommende nye data, og for dette er det en rolle kalt Utdata prosessor. Etter lagringen kan dataene overføres til den aktuelle behandleren (for eksempel for å tilpasse dem til hva forbrukeren krever) — og deretter sendes videre til connector for utsendelse. Her brukes det også en reparasjonskø: hvis ingen har tatt imot objektet, kan administrator gjenta forsøket senere.
Skalering
Rollene connector, input prosessor og utdata prosessor er tilstandsfrie, noe som lar oss skalere systemet horisontalt ved bare å legge til nye instanser av applikasjonen med den nødvendige rolletypen aktivert. For horisontal skalering brukes til organisering av klynger med virtuelle beholdere. Etter at en ny server er lagt til, flytter deler av containerne fra de gamle serverne i bakgrunnen over til den nye serveren; dette skjer transparent for brukerne og påvirker ikke den totale driften av systemet.
Datakarakteristikker
Objekter kan være svært store og inneholde andre objekter. Vi sikrer atomisitet i tillegg og oppdatering av data ved å lagre objektet med alle avhengigheter i en enkelt virtuell beholder. Dermed unngår vi å «spre» objektet over flere fysiske servere.
Versjonshåndtering støttes: hver oppdatering av objektet oppretter en ny versjon, og vi kan alltid ta en midlertidig snapshot og se hvordan verden så ut da. For data som ikke trenger en lang historikk, kan vi begrense antallet versjoner eller til og med lagre bare én - den nyeste, det vil si at vi faktisk kan deaktivere versjonering for en viss type. Vi kan også begrense historikken etter tid: for eksempel ved å slette alle objekter av en viss type som er eldre enn ett år. Arkivering støttes også: vi kan eksportere objekter som er eldre enn angitt tid for å frigjøre plass i klyngen.
Oppgaver
Blant interessante funksjoner er muligheten til å kjøre oppgaver etter plan, på forespørsel fra brukeren, eller programmatisk fra sandkassen:
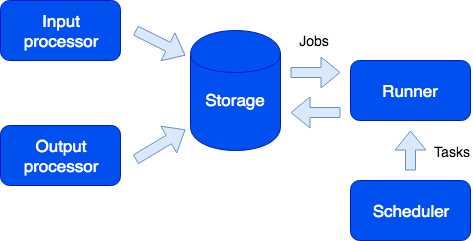
Her ser vi en annen rolle - runner. Denne rollen har ingen tilstand, og ved behov kan flere instanser av applikasjonen med denne rollen legges til i klyngen. Runnerens ansvar er å utføre oppgaver. Som nevnt kan nye oppgaver genereres fra sandkassen; de lagres i køen på lagring og utføres senere av runner. Denne typen oppgaver kalles Job. Vi har også en type oppgave kalt Task - dette er oppgaver definert av brukeren og kjøres etter plan (bruken av cron-syntaks) eller på forespørsel. For å starte og overvåke slike oppgaver har vi en praktisk oppgavebehandler. For at denne funksjonaliteten skal være tilgjengelig, må rollen scheduler aktiveres; denne rollen har tilstand, så den kan ikke skaleres, noe som ikke er nødvendig; samtidig kan den, som alle andre roller, ha en replika som begynner å fungere dersom master plutselig svikter.
Logger
En annen rolle kalles logger. Den samler logger fra alle medlemmene i klyngen og gir et grensesnitt for eksport og visning gjennom et webgrensesnitt.
Tjenester
Det er verdt å nevne at systemet gjør det enkelt å opprette tjenester. I konfigurasjonsfilen kan du spesifisere hvilke forespørsel som skal sendes til brukerdefinerte håndterere, utført i sandkassen. I denne håndtereren kan du for eksempel utføre en analytisk forespørsel og returnere resultatet.
Tjenesten beskrives i konfigurasjonsfilen:
services:
   sum:
      doc: "legger sammen to tall"
      function: sum
      return_type: int
      args:
         x: int
         y: int
GraphQL API genereres automatisk, og tjenesten blir tilgjengelig for anrop:
spørring {
   sum(x: 1, y: 2)
}
Dette vil føre til at håndtereren blir kalt sum, som vil returnere resultatet:
3
Profilering av forespørsel og metrikker
For å forstå systemets funksjon og profilering av forespørslene, har vi implementert støtte for OpenTracing-protokollen. Systemet kan på forespørsel sende informasjon til verktøy som støtter denne protokollen, for eksempel Zipkin, noe som gjør det lettere å se hvordan forespørselen ble behandlet:
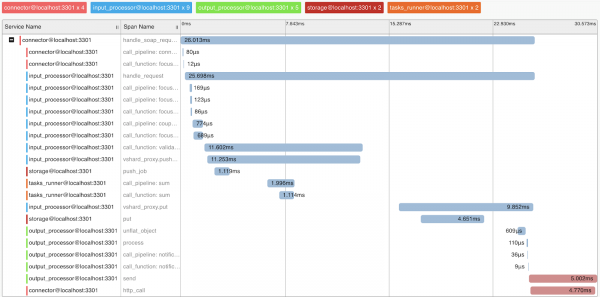
Selvfølgelig gir systemet interne metrikker som kan samles inn ved hjelp av Prometheus og visualiseres med Grafana.
UTPLASSERING
Tarantool Data Grid kan installeres fra RPM-pakker eller arkiver, ved hjelp av verktøy fra distribusjonen eller Ansible, og har også støtte for Kubernetes ().
Applikasjonen som implementerer forretningslogikk (konfigurasjon, håndterere) lastes opp i den distribuerte Tarantool Data Grid-klyngen i form av et arkiv via UI eller ved hjelp av et skript, gjennom vårt API.
Eksempler på applikasjoner
Hvilke applikasjoner kan opprettes med Tarantool Data Grid? Faktisk er de fleste forretningsoppgaver på en eller annen måte relatert til behandling av datastream, lagring og tilgang til dem. Så hvis du har store datastreams som må lagres pålitelig og være tilgjengelige, kan vårt produkt spare deg mye utviklingstid og la deg fokusere på din forretningslogikk.
For eksempel ønsker vi å samle informasjon om eiendomsmarkedet for senere å ha informasjon om de mest lønnsomme tilbudene. I så fall vil vi identifisere følgende oppgaver:
- Roboter som samler informasjon fra åpne kilder — dette vil være våre datakilder. Du kan løse denne oppgaven ved å bruke ferdige løsninger eller ved å skrive kode i hvilket som helst språk.
- Deretter vil Tarantool Data Grid motta og lagre data. Hvis datamaterialet fra ulike kilder er forskjellig, kan du skrive kode i Lua som vil konvertere til et enhetlig format. I den innledende behandlingen kan du også, for eksempel, filtrere ut dupliserte tilbud eller oppdatere informasjon om agenter som jobber i markedet i databasen.
- Nå har du allerede en skalerbar løsning i klyngen som kan fylles med data og gjøre datavalget. Deretter kan du implementere ny funksjonalitet, for eksempel skrive en tjeneste som gjør en forespørsel til dataene og gir det mest fordelaktige tilbudet på et døgn — dette vil kreve noen linjer i konfigurasjonsfilen og litt kode i Lua.
Hva skjer videre?
Vi prioriterer å øke utviklingsvennligheten gjennom . For eksempel, dette IDE-et med støtte for profiling og debugging av prosessorer som kjører i sandkassen.
Vi legger også stor vekt på sikkerhetsspørsmål. Akkurat nå er vi gjennom sertifisering fra FSTEK i Russland for å bekrefte høy sikkerhetsnivå og oppfylle kravene ved sertifiseringen av programvareprodukter som brukes i systemer for personlige data og statlige informasjonsystemer.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish