

Dette er en myte, som er ganske utbredt innen servermaskinvare. I praksis er imidlertid hyperkonvergerte løsninger (hvor alt er samlet) nødvendige for mange formål. Historisk sett ble de første arkitekturene utviklet av Amazon og Google for sine tjenester. Ideen den gang var å bygge en databehandlingsgård av identiske noder, der hver node har sine egne disker. Alt dette ble samlet av en slags systembyggende programvare (hypervisor) og delt opp i virtuelle maskiner. Hovedoppgaven er å minimere innsatsen for å vedlikeholde en node og minimere problemer ved skalering: man bare kjøper et par tusen av slike servere til og kobler de sammen. I praksis er dette unntaksvis, og oftere dreier det seg om et mindre antall noder og en litt annen arkitektur.
Men fordelen forblir den samme – utrolig enkel skalering og administrasjon. Ulempen er at forskjellige oppgaver bruker ressurser ulikt, hvor noen steder vil det være mange lokale disker, mens der det er lite RAM osv., det vil si at ved forskjellige typer oppgaver vil ressursutnyttelsen falle.
Det endte med at du betaler 10–15 % mer for enkeltheten ved oppsettet. Dette skapte myten fra overskriften. Vi lette lenge etter hvor teknologien ville bli optimalt anvendt, og vi fant det. Saken er at Cisco ikke hadde sine egne lagringssystemer, men de ønsket å ta hele servermarkedet. Og de laget Cisco Hyperflex – en løsning med lokale lagringssystemer på nodene.
Og plutselig ble dette en veldig god løsning for backup datasentre (Disaster Recovery). Hvorfor og hvordan – skal jeg nå fortelle. Og jeg vil vise testene av klyngen.
Hvor det trengs
Hyperkonvergens er:
- Overføring av disker til behandlingsnoder.
- Full integrasjon av datalagringssystemet med virtualiseringssystemet.
- Overføring/integrering med nettverksystemet.
Slik en kopling gjør det mulig å implementere mange funksjoner i lagringssystemer på virtualiseringsnivå og alt fra ett administrasjonsvindu.
I vårt selskap er prosjekter for design av backup datasentre veldig ettertraktet, og det velges ofte nettopp en hyperkonvergent løsning på grunn av mange alternativer for replikering (helt opp til metrokluster) fra boksen.
I tilfeller med backup datacenters handler det vanligvis om en fjernplassering på den andre siden av byen eller til og med i en annen by. Dette tillater gjenoppretting av kritiske systemer i tilfelle delvis eller fullstendig svikt av hoved datacentret. Dataene fra produksjonen replikeres kontinuerlig dit, og denne replikeringen kan skje på applikasjonsnivå eller på nivået med lagringsenheter (SAN).
Derfor vil jeg nå fortelle om systemets oppbygging og tester, og deretter om et par scenarier for virkelig bruk med data om besparelser.
Tester
Vår instans består av fire servere, hvor hver har 10 SSD-er på 960 GB. Det er en dedikert disk for hurtigbufring av skriveoperasjoner og lagring av en tjeneste virtuell maskin. Selve løsningen er den fjerde versjonen. Den første var åpenbart uferdig (ifølge tilbakemeldingene), den andre var også noe ustabil, den tredje var allerede ganske stabil, og denne kan kalles en utgivelse etter avslutningen av beta-testing for publikum. I løpet av testingen har jeg ikke sett noen problemer, alt fungerer som det skal.
Endringer i v4En haug med feil er rettet.
Opprinnelig kunne plattformen bare arbeide med hypervisoren VMware ESXi og støttet et begrenset antall noder. I tillegg ble ikke distribusjonsprosessen alltid vellykket, og noen trinn måtte startes på nytt, det var problemer med oppdatering fra eldre versjoner, og dataene i GUI ble ikke alltid vist korrekt (selv om jeg fortsatt ikke er begeistret for visningen av ytelsesgrafer), av og til oppstod det problemer med virtualisering.
Nå er alle barndomsfeil rettet, HyperFlex fungerer med både ESXi og Hyper-V, pluss at det er mulig:
- Opprettelse av et utvidet kluster.
- Opprettelse av et kluster for kontorer uten bruk av Fabric Interconnect, fra to til fire noder (vi kjøper bare serverne).
- Mulighet for å arbeide med eksterne SAN-er.
- Støtte for containere og Kubernetes.
- Oppretting av tilgjengelighetssoner.
- Integrasjon med VMware SRM, hvis den innebygde funksjonaliteten ikke er tilfredsstillende.
Arkitekturen avviker ikke mye fra løsningene til de viktigste konkurrentene, de har ikke laget et nytt konsept. Alt dette fungerer på virtualiseringsplattformer som VMware eller Hyper-V. Maskinvaren er plassert på servere utviklet av Cisco UCS. Det finnes de som hater plattformen på grunn av den relative kompleksiteten ved opprinnelig oppsett, mange knapper, en komplisert mal- og avhengighetssystem, men det er også de som har opplevd zen, har tatt ideen til seg og ikke ønsker å jobbe med andre servere lenger.
Vi vil spesifikt se på løsningen for VMware, da løsningen opprinnelig ble utviklet for denne plattformen og har større funksjonalitet. Hyper-V ble forbedret underveis, for ikke å komme bak konkurrentene og for å møte markedets forventninger.
Det finnes en klynge av servere fylt med disker. Det er disker for datalagring (SSD eller HDD — avhengig av din smak og behov), samt en SSD-disk for hurtigbuffer. Når data skrives til datalageret, lagres dataene i hurtigbufferlaget (den dedikerte SSD-disk og RAM av det tjeneste-VMer). Samtidig sendes en datablokk til nodene i klyngen (antallet noder avhenger av replikasjonsfaktoren i klyngen). Etter bekreftelse fra alle noder om vellykket skriving, sendes bekreftelsen tilbake til hypervisoren og videre til VM. De lagrede dataene dedupliseres, komprimeres og skrives til lagringsdiskene i bakgrunnen. Under dette skrives det alltid en stor blokk til lagringsdiskene og sekvensielt, noe som reduserer belastningen på lagringsdisken.
Deduplication og komprimering er alltid aktivert, og de kan ikke slås av. Data leses direkte fra lagringsdiskene eller fra RAM-cachen. Hvis en hybridkonfigurasjon brukes, caches lesing også på SSD-disk.
Dataene er ikke bundet til den nåværende plasseringen av den virtuelle maskinen og fordeles jevnt mellom nodene. Denne tilnærmingen gjør det mulig å belaste alle disker og nettverksgrensesnitt likt. Det åpenbare negative punktet er at vi ikke kan maksimalt redusere lesetiden, siden det ikke er noen garanti for at dataene er lokalt tilgjengelige. Men jeg mener at dette er en ubetydelig pris å betale i forhold til de oppnådde fordelene. I tillegg har nettverksforsinkelsene nådd nivåer som praktisk talt ikke påvirker det samlede resultatet.
Hele logikken i diskunder-systemet styres av en spesialtjeneste VM, Cisco HyperFlex Data Platform controller, som opprettes på hver lagringsnode. I vår konfigurasjon ble det tildelt åtte vCPU og 72 GB RAM til tjeneste-VM-en, noe som ikke er så lite. Husk at selve verten har 28 fysiske kjerner og 512 GB RAM.
Tjeneste-VM-en har direkte tilgang til de fysiske diskene ved hjelp av SAS-kontrolleren som videresendes til VM-en. Kommunikasjonen med hypervisoren skjer gjennom en spesialmodul, IOVisor, som fanger opp I/O-operasjoner, og ved hjelp av en agent som gjør det mulig å sende kommandoer til hypervisorens API. Agenten har ansvar for håndtering av HyperFlex-snapshots og kloner.
I hypervisoren monteres diskressursene som en NFS- eller SMB-deling (avhengig av typen hypervisor, gjett hvilken hvor). Og under panseret er det et distribuert filsystem som lar deg legge til funksjoner fra fullverdige SAN-er: tynn tildeling av volumer, komprimering og deduplisering, snapshots med Redirect-on-Write teknologi, synkron og asynkron replikering.
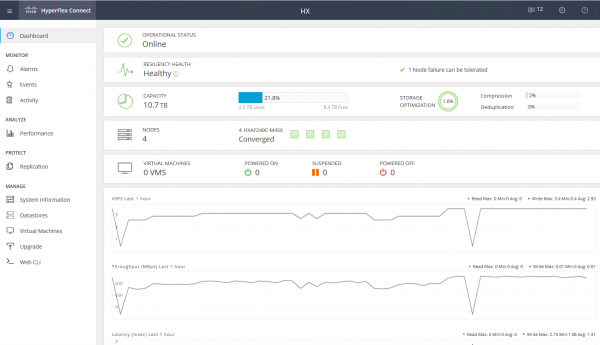
Tjeneste-VM-en gir tilgang til nettgrensesnittet for administrasjon av HyperFlex-systemet. Det finnes integrasjon med vCenter, og de fleste daglige oppgavene kan utføres fra dette, men datalagringsområder er for eksempel lettere å opprette fra et separat webgrensesnitt, spesielt hvis du allerede har gått over til det hurtige HTML5-grensesnittet, eller bruke en fullverdig Flash-klient med full integrasjon. I tjeneste-nettgrensesnittet kan du se ytelsen og detaljerte systemstatus.
Det finnes også en annen type noder i klyngen — beregningsnoder. Dette kan være rack- eller blade-servere uten innebygde disker. På disse serverne kan du kjøre VM-er hvis dataene lagres på servere med disker. I forhold til datatilgang er det ingen forskjell mellom nodetypene, siden arkitekturen forutsetter abstraksjon fra den fysiske plasseringen av dataene. Det maksimale forholdet mellom beregningsnoder og lagringsnoder er 2:1.
Bruken av beregningsnoder øker fleksibiliteten ved skalering av klusterressurser: vi trenger ikke nødvendigvis å kjøpe noder med disker hvis vi bare har behov for CPU/RAM. I tillegg kan vi legge til en blade-kasse og oppnå besparelse ved plassering av servere i rack.
Som et resultat har vi en hyperkonvergert plattform med følgende funksjoner:
- Inntil 64 noder i klyngen (inntil 32 lagringsnoder).
- Minste antall noder i klyngen er tre (to for Edge-klyngen).
- Data redundansmekanisme: speiling med replikasjonsfaktor 2 og 3.
- Metro-klynge.
- Asynkron replikering av VM til en annen HyperFlex-klynge.
- Orkestrering av VM-overføring til et fjerndatabasesenter.
- Native snapshots med Redirect-on-Write-teknologi.
- Opptil 1 PB nyttig plass med replikasjonsfaktor 3 og uten hensyn til deduplisering. Replikasjonsfaktor 2 vurderes ikke, da dette ikke er et alternativ for seriøs salg.
Enda en stor fordel er enkelheten i administrasjonen og distribusjonen. Alt av kompleksiteten ved konfigurasjonen av UCS-serverne tas av en spesialisert VM, utviklet av ingeniører fra Cisco.
Konfigurasjon av testbatteriet:
- 2 x Cisco UCS Fabric Interconnect 6248UP som administrerende klynge og nettverkskomponenter (48 porter, som opererer i Ethernet 10G/FC 16G-modus).
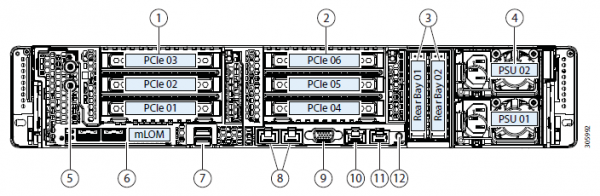
- Fire servere fra Cisco UCS HXAF240 M4.
Spesifikasjoner for serverne:
CPU
2 x Intel ® Xeon ® E5-2690 v4
RAM
16 x 32GB DDR4-2400-MHz RDIMM/PC4-19200/dual rank/x4/1.2v
Nettverk
UCSC-MLOM-CSC-02 (VIC 1227). 2 porter 10G Ethernet
Storage HBA
Cisco 12G Modular SAS Pass through Controller
Lagringsdisker
1 x SSD Intel S3520 120 GB, 1 x SSD Samsung MZ-IES800D, 10 x SSD Samsung PM863a 960 GB
Flere konfigurasjonsalternativerI tillegg til den valgte maskinvaren, er følgende alternativer tilgjengelige:
- HXAF240c M5.
- En eller to CPU-er fra Intel Silver 4110 til Intel Platinum I8260Y. Andre generasjon er tilgjengelig.
- 24 minneplasser, moduler fra 16 GB RDIMM 2600 til 128 GB LRDIMM 2933.
- Fra 6 til 23 disker for data, en hurtigcache-disk, én systemdisk og én oppstartsdisk.
Kapasitetsdisker
- HX-SD960G61X-EV 960GB 2.5 tommers Enterprise Value 6G SATA SSD (1X utholdenhet) SAS 960 GB.
- HX-SD38T61X-EV 3.8TB 2.5 tommers Enterprise Value 6G SATA SSD (1X utholdenhet) SAS 3.8 TB.
- Caching-disker
- HX-NVMEXPB-I375 375GB 2.5 tommers Intel Optane Drive, Extreme Perf & Endurance.
- HX-NVMEHW-H1600* 1.6TB 2.5 tommers Ent. Perf. NVMe SSD (3X utholdenhet) NVMe 1.6 TB.
- HX-SD400G12TX-EP 400GB 2.5 tommers Ent. Perf. 12G SAS SSD (10X utholdenhet) SAS 400 GB.
- HX-SD800GBENK9** 800GB 2.5 tommers Ent. Perf. 12G SAS SED SSD (10X utholdenhet) SAS 800 GB.
- HX-SD16T123X-EP 1.6TB 2.5 tommers Enterprise performance 12G SAS SSD (3X utholdenhet).
System / Log-disker
- HX-SD240GM1X-EV 240GB 2.5 tommers Enterprise Value 6G SATA SSD (krever oppgradering).
Oppstartsdisker
- HX-M2-240GB 240GB SATA M.2 SSD SATA 240 GB.
Tilgang til nettverket via 40G, 25G eller 10G Ethernet-porter.
Som FI kan HX-FI-6332 (40G), HX-FI-6332-16UP (40G), HX-FI-6454 (40G/100G) brukes.
Selve testen
For testing av diskunderystemet brukte jeg HCIBench 2.2.1. Dette er et gratis verktøy som automatiserer opprettingen av belastning fra flere virtuelle maskiner. Selve belastningen genereres av vanlig fio.
Klyngen vår består av fire noder, replikasjonsfaktor 3, alle disker Flash.
For testing, I created four datastores and eight virtual machines. The write test assumes a scenario where the caching disk does not overflow.
The test results are as follows:
100 % Read 100 % Random
0 % Read 100% Random
Block/queue depth
128
256
512
1024
2048
128
256
512
1024
2048
4K
0.59 ms 213804 IOPS
0.84 ms 303540 IOPS
1.36 ms 374348 IOPS
2.47 ms 414116 IOPS
4.86 ms 420180 IOPS
2.22 ms 57408 IOPS
3.09 ms 82744 IOPS
5.02 ms 101824 IOPS
8.75 ms 116912 IOPS
17.2 ms 118592 IOPS
8K
0.67 ms 188416 IOPS
0.93 ms 273280 IOPS
1.7 ms 299932 IOPS
2.72 ms 376484 IOPS
5.47 ms 373176 IOPS
3.1 ms 41148 IOPS
4.7 ms 54396 IOPS
7.09 ms 72192 IOPS
12.77 ms 80132 IOPS
16K
0.77 ms 164116 IOPS
1.12 ms 228328 IOPS
1.9 ms 268140 IOPS
3.96 ms 258480 IOPS
3.8 ms 33640 IOPS
6.97 ms 36696 IOPS
11.35 ms 45060 IOPS
32K
1.07 ms 119292 IOPS
1.79 ms 142888 IOPS
3.56 ms 143760 IOPS
7.17 ms 17810 IOPS
11.96 ms 21396 IOPS
64K
1.84 ms 69440 IOPS
3.6 ms 71008 IOPS
7.26 ms 70404 IOPS
11.37 ms 11248 IOPS
Bolded values indicate points where there is no further increase in performance, sometimes even showing degradation. This is due to reaching the performance limits of the network/controllers/disks.
- Sequential read 4432 MB/s.
- Sequential write 804 MB/s.
- In the event of a controller failure (either the VM or host), the performance drop is twofold.
- In the event of a storage disk failure, the drop is by 1/3. Rebuilding the disk takes up 5% of each controller's resources.
With a small block, we hit the performance limit of the controller (virtual machine), its CPU is 100% loaded; increasing the block hits the bandwidth of the ports. 10 Gbps is insufficient to unlock the potential of the AllFlash system. Unfortunately, the parameters of the provided demo stand do not allow testing at 40 Gbps.
From my impressions of the tests and studying the architecture, due to the algorithm distributing data across all hosts, we achieve scalable and predictable performance, but this is also a limitation for reading, as it would be possible to squeeze more from local disks; a more powerful network could help, for instance, FI available at 40 Gbps.
Also, a single disk for caching and deduplication can be a limitation; in fact, in this stand, we can write to four SSD disks. It would be great to have the ability to increase the number of caching disks and see the difference.
Actual usage
For organizing a backup data center, two approaches can be used (not considering placing the backup at a remote site):
- Active-Passive. Alle applikasjoner er plassert i hoveddatasenteret. Replikering kan være synkron eller asynkron. I tilfelle hoveddatasenteret svikter, må vi aktivere backupen. Dette kan gjøres manuelt/skriftlig/applikasjoner for orkestrering. Her vil vi oppnå RPO, sammenlignbart med replikasjonsfrekvensen, og RTO avhenger av administrasjonsrespons og kvaliteten på implementeringen/debugging av bytteplanen.
- Active-Active. I dette tilfellet finnes det kun synkron replikering, tilgjengeligheten til datasentrene bestemmes av kvorum/arbiter, plassert strengt på en tredje lokasjon. RPO = 0, mens RTO kan nå 0 (hvis applikasjonen tillater det) eller tilsvarer tiden det tar å håndtere en nod efeil i virtualiseringsklusteret. På virtualiseringsnivået opprettes et utvidet (Metro) kluster som krever Active-Active lagringssystem.
Vanligvis ser vi at kundene allerede har implementert en arkitektur med en klassisk lagringssystem i hoveddatasenteret, så vi designer en ny for replikering. Som jeg nevnte, tilbyr Cisco HyperFlex asynkron replikering og opprettelse av et utvidet virtualiseringskluster. Vi trenger ikke et dedikert lagringssystem på Midrange nivå eller høyere med kostbare replikasjonsfunksjoner og Active-Active datatilgang på to lagringssystemer.
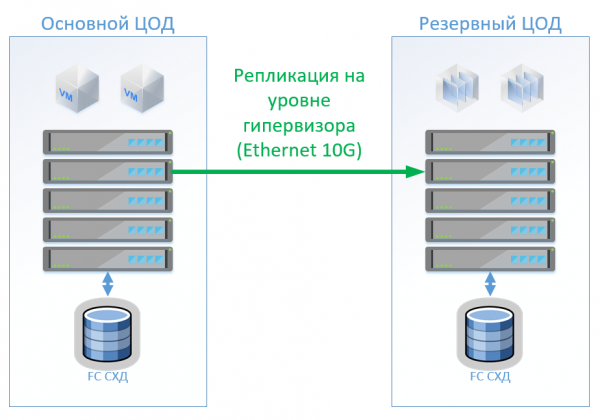
Scenario 1: Vi har et hoved- og et backupdatasenter, virtualiseringsplattformen er VMware vSphere. Alle produktive systemer ligger i hoveddatasenteret, mens replikering av virtuelle maskiner utføres på hypervisor-nivå, noe som gjør at vi ikke trenger å holde VM-er på i backupdatasenteret. Databaser og spesialapplikasjoner replikeres med innebygde verktøy, og vi holder VM-er på. Ved svikt i hoveddatasenteret starter vi opp systemene i backupdatasenteret. Vi vurderer at vi har rundt 100 virtuelle maskiner. Så lenge hoveddatasenteret fungerer, kan det kjøres testmiljøer og andre systemer i backupdatasenteret, som kan slåes av ved behov for å bytte hoveddatasenteret. Det er også mulig å bruke toveiskommunikasjon for replikering. Når det gjelder utstyret, vil ingenting endres.
I tilfelle av klassisk arkitektur vil vi installere en hybrid lagringsløsning i hvert datasenter med tilgang via FibreChannel, tiering, deduplisering og komprimering (men ikke online), 8 servere til hvert sted, 2 FibreChannel- og 2 Ethernet 10G switcher. For replikering og håndtering av failover i klassisk arkitektur kan vi bruke VMware-verktøy (Replication + SRM) eller tredjepartsverktøy som vil være litt billigere og noen ganger mer praktiske.
Diagrammet viser oppsettet.
Ved bruk av Cisco HyperFlex får vi følgende arkitektur:
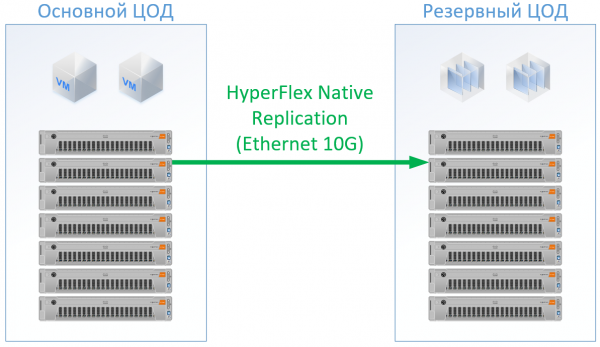
For HyperFlex brukte jeg servere med store CPU/RAM-ressurser, da en del av ressursene går til VM-kontrolleren for HyperFlex. Jeg overdimensjonerte til og med litt i HyperFlex-konfigurasjonen, for å ikke gå i retning av Cisco og sikre ressurser til de andre VM-ene. I stedet kan vi droppe FibreChannel-switchene, og vi trenger ikke Ethernet-porter for hver server; lokal trafikk blir håndtert internt i FI.
Resultatet ble følgende konfigurasjon for hvert datasenter:
Servere
8 x 1U Server (384 GB RAM, 2 x Intel Gold 6132, FC HBA)
8 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6150, 3,2 GB SSD, 10 x 6 TB NL-SAS)
Lagringssystem
Hybrid lagringsløsning med FC Front-End (20TB SSD, 130 TB NL-SAS)
—
LAN
2 x Ethernet switch 10G 12 porter
—
SAN
2 x FC switch 32/16Gb 24 porter
2 x Cisco UCS FI 6332
Lisenser
VMware Ent Plus
Replikering og/eller orkestrering av VM-failover
VMware Ent Plus
For HyperFlex har jeg ikke lagt inn lisenser for replikasjonsprogramvare, da dette er tilgjengelig out-of-the-box.
For klassisk arkitektur valgte jeg en leverandør som har vist seg som en kvalitets- og kostnadseffektiv produsent. For begge alternativene brukte jeg en standard rabatt for den spesifikke løsningen, og i utgangen fikk jeg reelle priser.
Løsningen på Cisco HyperFlex ble 13 % billigere.
Scenario 2: opprettelse av to aktive datasentre. I dette scenariet designer vi en utvidet klynge på VMware.
Den klassiske arkitekturen består av virtualiseringsservere, SAN (FC-protokoll) og to lagringsenheter som kan lese og skrive på data som er utvidet mellom dem. På hver lagringsenhet legger vi inn nyttig kapasitet for lokasjonen.
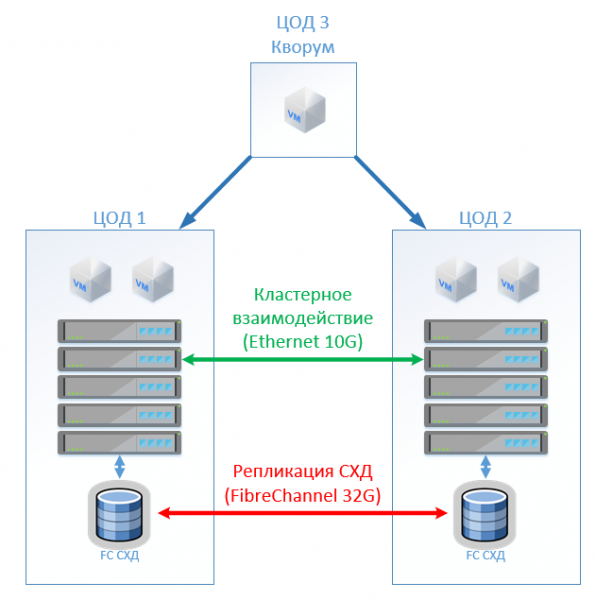
Med HyperFlex oppretter vi bare en Stretch Cluster med likt antall noder på begge steder. I dette tilfellet brukes en replikasjonsfaktor på 2+2.
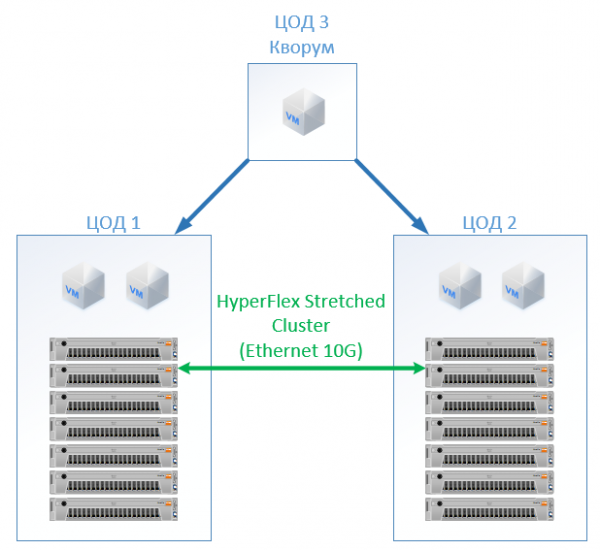
Resultatet ble følgende konfigurasjon:
Klassisk arkitektur
HyperFlex
Servere
16 x 1U Server (384 GB RAM, 2 x Intel Gold 6132, FC HBA, 2 x 10G NIC)
16 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6132, 1,6 TB NVMe, 12 x 3,8 TB SSD, VIC 1387)
Lagringssystem
2 x AllFlash lagringsenheter (150 TB SSD)
—
LAN
4 x Ethernet switch 10G 24 porter
—
SAN
4 x FC switch 32/16Gb 24 porter
4 x Cisco UCS FI 6332
Lisenser
VMware Ent Plus
VMware Ent Plus
I did not take into account the network infrastructure, data center costs, etc.: they will be the same for both classical architecture and HyperFlex solutions.
In terms of cost, HyperFlex turned out to be 5% more expensive. It is worth noting that for CPU/RAM resources, I had an imbalance for Cisco, as I configured the memory controller channels evenly. The cost is slightly higher, but not by an order of magnitude, which clearly indicates that hyperconvergence is not necessarily a 'toy for the rich', but can compete with the standard approach to building data centers. This may also be interesting for those who already have Cisco UCS servers and the corresponding infrastructure for them.
Among the advantages, we get the lack of SAN and storage administration costs, online compression and deduplication, a single point of entry for support (virtualization, servers, which are also storage), space savings (but not in all scenarios), and simplification of operations.
As for support, you get it from a single vendor — Cisco. Judging by my experience with Cisco UCS servers, I like it; with HyperFlex, I never had to open a ticket, everything worked fine. The engineers respond promptly and can solve not only typical problems but also complex edge cases. Sometimes I reach out to them with questions like, 'Can this be done, can we hook this up?' or 'I configured something here and it doesn’t want to work. Help!' — they patiently find the right guide and point out the correct actions, they won't just say, 'We only solve hardware issues.'
Lenker
- My email is StGeneralov@croc.ru
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish