

Nettverksalt av Amazon Web Services består av 69 soner verden over i 22 regioner: USA, Europa, Asia, Afrika og Australia. Hver sone har opptil 8 datasentre. I hvert datasenter finnes det tusenvis eller hundretusener av servere. Nettverket er bygget slik at alle lite sannsynlige driftsavbrudd er tatt i betraktning. For eksempel er alle regioner isolert fra hverandre, og tilgjengelighetssoner er spredt over flere kilometer. Selv om en kabel klippes, vil systemet gå over til reservekanaler, og datatapet vil være på nivå med enkeltpakker. Om hvilke andre prinsipper nettverket er bygget på og hvordan det er konstruert, forteller Vasilij Pantušin.
Vasilij Pantjuchin begynte som Unix-administrator i .ru selskaper, jobbet i 6 år med store maskiner fra Sun Microsystem, i 11 år forkynte datacenter-fokuset i EMC. Han har naturlig utviklet seg til private skyer, deretter beveget han seg mot offentlige skyer. Nå, som arkitekt i Amazon Web Services, gir han tekniske råd for å leve og utvikle seg i AWS-skyen.
I den forrige delen av trilogien om strukturen til AWS dykket Vasilij inn i hvordan fysiske servere fungerer og skalering av databaser. Nitro-kort, en spesialtilpasset hypervisor basert på KVM, databasen Amazon Aurora — alt dette i artikkelen «». Les for å dykke inn i konteksten, eller se på presentasjoner.
I denne delen vil vi ta for oss nettverks skalering — et av de mest kompliserte systemene i AWS. Evolusjonen fra et flatt nettverk til Virtual Private Cloud og hvordan det er strukturert, interne tjenester som Blackfoot og HyperPlane, problemet med «støyende naboer», og til slutt — nettverksstørrelser, backbone og fysiske kabler. Alt dette finner du i artikkelen.
Ansvarsfraskrivelse: alt nedenfor er Vasilijs personlige mening, og den kan avvike fra synspunktene til Amazon Web Services.
Nettverksskalerings
AWS-skyen ble lansert i 2006. Nettverket var ganske primitivt — med en flat struktur. Området med private adresser var felles for alle tenantene i skyen. Når en ny virtuell maskin ble startet, fikk du tilfeldig en tilgjengelig IP-adresse fra dette området.
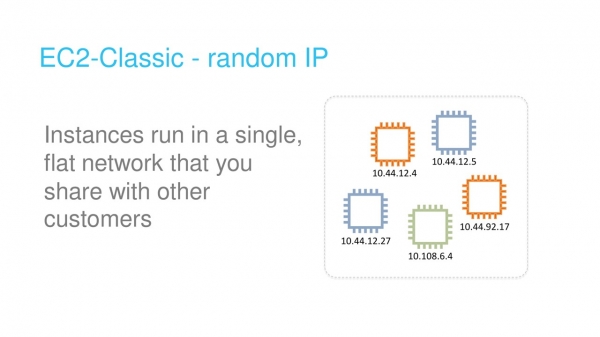
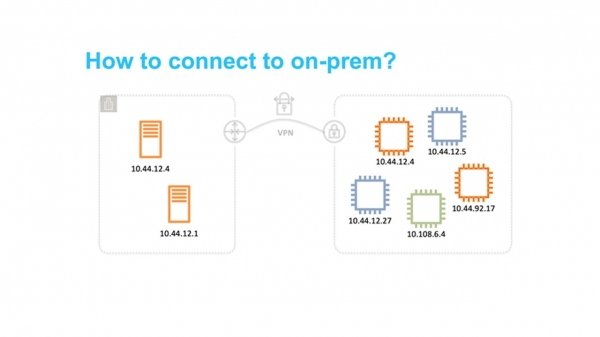
Denne tilnærmingen var enkel å implementere, men begrenset bruken av skyen på prinsippalt vis. Spesielt var det ganske vanskelig å utvikle hybridløsninger som kombinerte private nettverk både lokalt og i AWS. Det mest utbredte problemet var i skjæringspunktet mellom IP-adresseområder.
Virtual Private Cloud
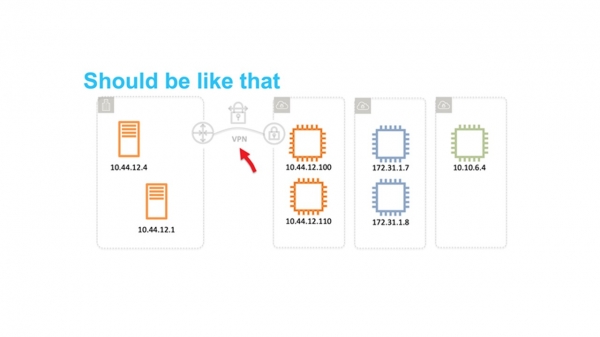
Skyen har blitt etterspurt. Det er på tide å tenke på skalerbarheten og muligheten for at den kan brukes av titalls millioner leietakere. Det flate nettverket har blitt det største hindret. Derfor begynte vi å vurdere hvordan vi kan isolere brukerne fra hverandre på nettverksnivå slik at de selv kan velge IP-områder.
Hva er det første som kommer til tankene når du tenker på nettverksisolasjon? Selvfølgelig VLAN og VRF – Virtual Routing and Forwarding.
Dessverre fungerte ikke dette. VLAN ID er bare 12 biter, hvilket gir oss bare 4096 isolerte segmenter. Selv i de største svitsjene kan man maksimalt bruke 1-2 tusen VRF-er. Samtidig bruk av VRF og VLAN gir oss bare noen få millioner undernett. Dette er absolutt ikke nok for titalls millioner leietakere, som hver bør ha mulighet til å bruke flere undernett.
Vi kan også rett og slett ikke tillate oss å kjøpe det nødvendige antallet store bokser, for eksempel fra Cisco eller Juniper. Det er to grunner: det er vanvittig dyrt, og vi ønsker ikke å bli avhengige av deres utviklings- og oppdateringspolitikk.
Én konklusjon – lage vår egen løsning.
I 2009 annonserte vi VPC — Virtual Private Cloud. Navnet har festet seg, og nå bruker mange skytilbydere det også.
VPC er et virtuelt nettverk SDN (Software Defined Network). Vi bestemte oss for ikke å oppfinne spesielle protokoller på L2 og L3-nivåene. Nettverket fungerer på standard Ethernet og IP. For å overføre trafikk fra virtuelle maskiner blir den innkapslet i omslaget av vår egen protokoll. Den angir en ID som tilhører leietakers VPC.
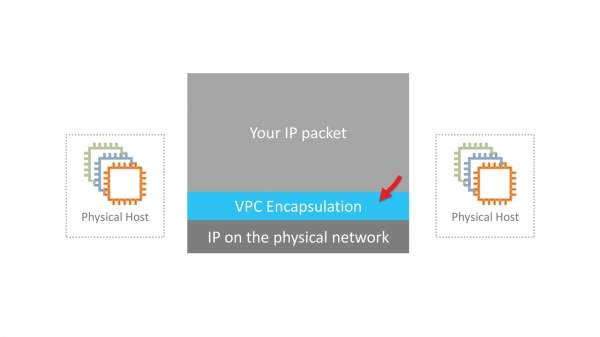
Det høres enkelt ut. Men det må løses flere alvorlige tekniske utfordringer. For eksempel, hvor og hvordan lagre data om kartlegging av virtuelle MAC/IP-adresser, VPC-ID og tilsvarende fysiske MAC/IP. I omfanget av AWS er dette en enorm tabell som må fungere med minimal forsinkelse ved forespørsel. Dette ansvaret ligger på kartleggingstjenesten, som er spredt tynt over hele nettverket.
I nye generasjons maskiner skjer innkapslingen gjennom Nitro-kort på maskinvare nivå. I eldre instanser er innkapslingen og dekapslingen programvarebasert.
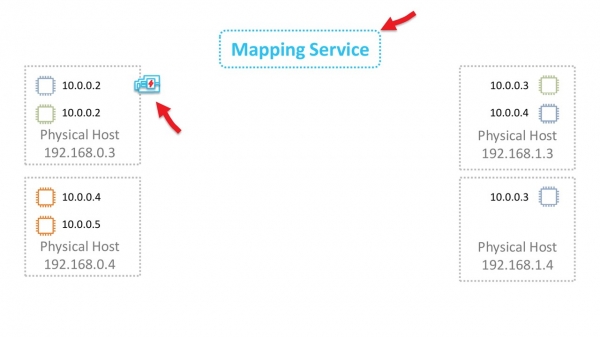
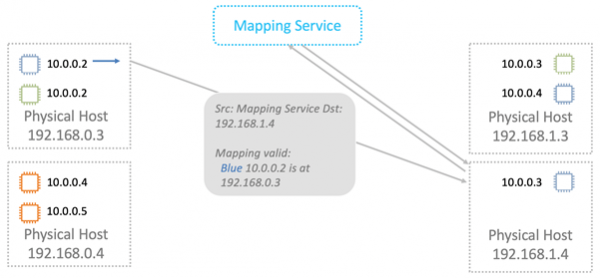
La oss forstå hvordan dette fungerer i grove trekk. Vi begynner med L2-nivået. La oss si at vi har en virtuell maskin med IP 10.0.0.2 på en fysisk server 192.168.0.3. Den sender data til den virtuelle maskinen 10.0.0.3, som befinner seg på 192.168.1.4. Det dannes en ARP-forespørsel som sendes til Nitro-nettverkskortet. For enkelhets skyld antar vi at begge de virtuelle maskinene befinner seg i samme "blå" VPC.
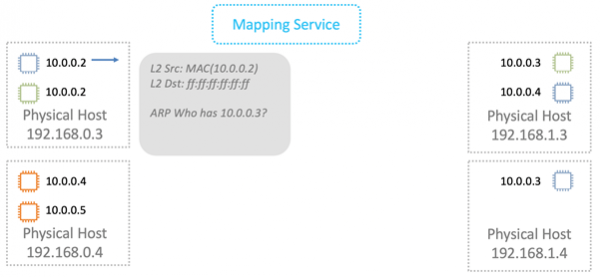
Nettverkskortet erstatter kildeadressen med sin egen og videresender ARP-rammen til mappertjenesten.
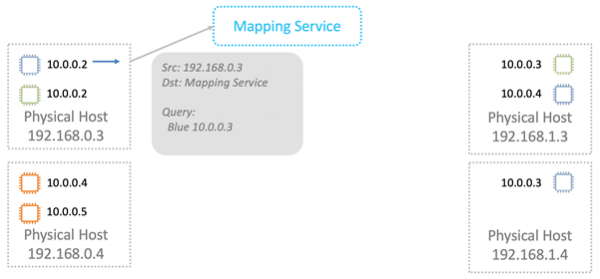
Mappertjenesten returnerer informasjonen som er nødvendig for overføring over det fysiske L2-nettet.
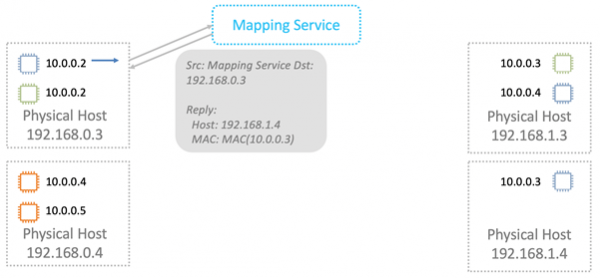
Nitro-nettverkskortet erstatter MAC-adressen i det fysiske nettverket med adressen i VPC i ARP-svaret.
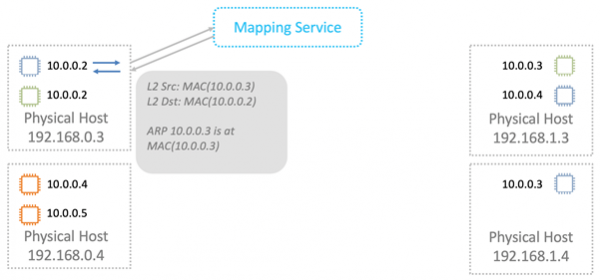
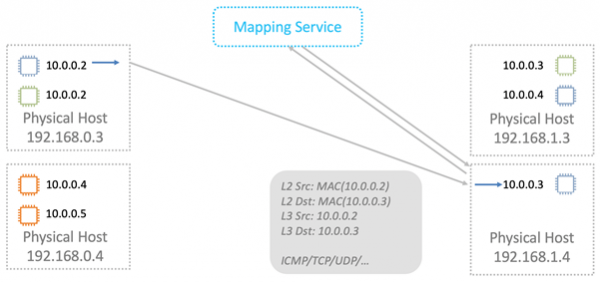
Når data sendes, pakker vi de logiske MAC- og IP-adressene i en VPC-innpakning. Alt dette sendes over det fysiske nettverket ved hjelp av de respektive IP-adressene til Nitro-kortene for kilde og destinasjon.
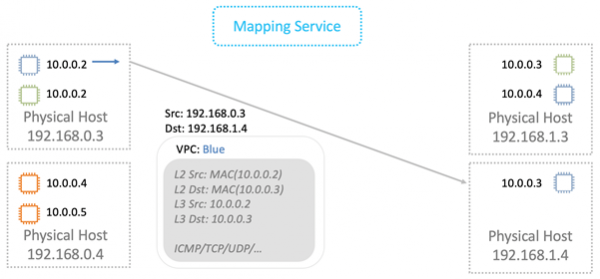
Den fysiske maskinen som pakke er ment for utfører en sjekk. Dette er nødvendig for å forhindre muligheten for adresseforfalskning. Maskinen sender en spesialforespørsel til mappertjenesten og spør: "Fra den fysiske maskinen 192.168.0.3 har jeg mottatt en pakke som er ment for 10.0.0.3 i den "blå" VPC. Er den legitim?"
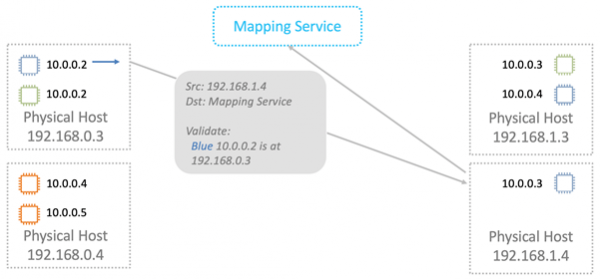
Mappertjenesten sammenligner med sin ressursplasseringstabell og tillater eller forhindrer videreføring av pakken. I alle nye instanser er ekstra validering implementert i Nitro-kortene. Den kan ikke omgås, selv teoretisk. Derfor vil spoofing av ressurser i en annen VPC ikke fungere.
Deretter sendes dataene til den virtuelle maskinen de er ment for.
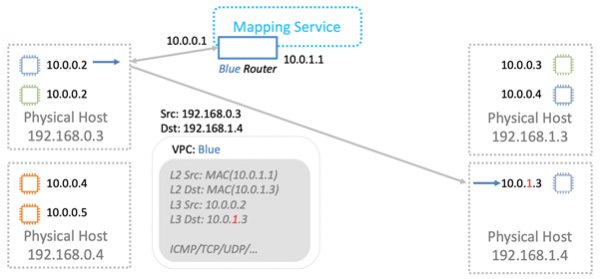
Mappertjenesten fungerer også som en logisk ruter for å overføre data mellom virtuelle maskiner i ulike subnett. Der er konseptet enkelt, jeg vil ikke gå i detalj.
Det viser seg at ved overføring av hver pakke henvender serverne seg til mappertjenesten. Hvordan kan vi håndtere de uunngåelige forsinkelsene? Ved hurtigbufring, selvsagt.
Hele poenget er at det ikke er nødvendig å hurtigbufre hele den enorme tabellen. På den fysiske serveren er det virtuelle maskiner fra et relativt lite antall VPC-er. Informasjonen trenger bare å hurtigbufres om disse VPC-ene. Dataoverføring til andre VPC-er i "standard" konfigurasjon er fortsatt ikke legitim. Hvis funksjonalitet som VPC-peering benyttes, lastes informasjon om de relevante VPC-ene også inn i hurtigbufferen.
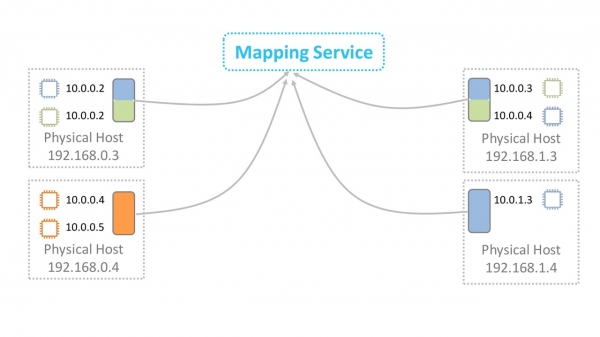
Vi har forstått dataoverføring i VPC.
Blackfoot
Hva skal man gjøre når man må sende trafikk ut, for eksempel til Internett eller via VPN til bakken? Her kommer Blackfoot — vår interne AWS-tjeneste til unnsetning. Den er utviklet av vårt team i Sør-Afrika. Derfor er tjenesten oppkalt etter pingvinen som lever i Sør-Afrika.
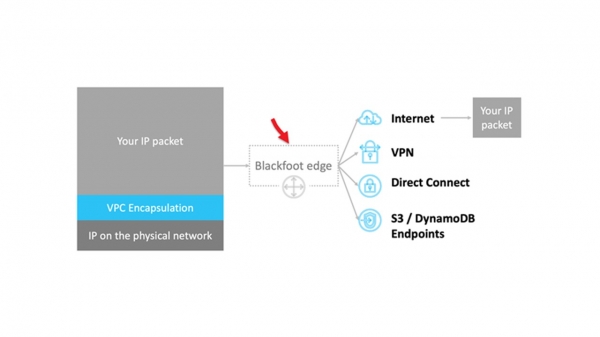
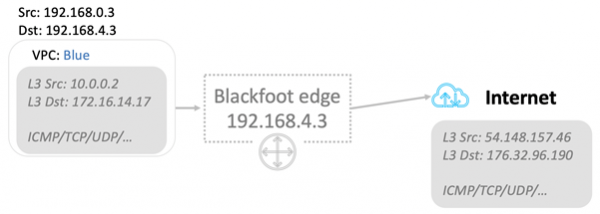
Blackfoot dekapsulerer trafikken og behandler den som nødvendig. Dataene sendes til Internett som de er.
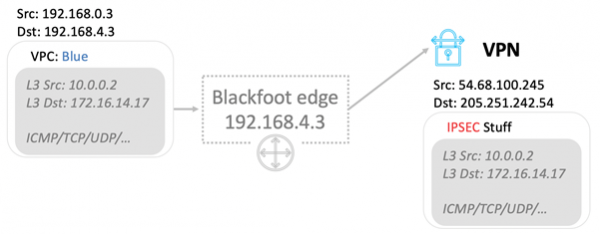
Dataene dekapsuleres og pakkes inn i en IPsec-innpakning ved bruk av VPN.
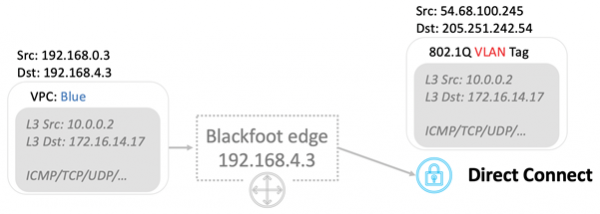
Ved bruk av Direct Connect blir trafikken merket og sendt til riktig VLAN.
HyperPlane
Dette er vår interne tjeneste for strømkontroll. Mange nettverkstjenester krever kontroll av datatrafikktilstanden. For eksempel, ved bruk av NAT, må trafikkontrollen sikre at hver «IP: destinasjonsport»-par har en unik utgående port. I tilfelle av lastbalanserer NLB — Network Load Balancer, må datatrafikken alltid sendes til den samme målvirtualmaskinen. Sikkerhetsgrupper er en tilstandsholdende brannmur. Den overvåker innkommende trafikk og åpner implisitt porter for utgående pakkestrøm.
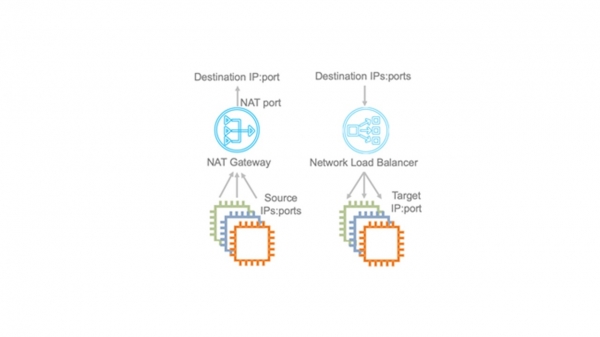
I AWS-skyen er kravene til overføringsevne ekstremt høye. Derfor HyperPlane er kritisk for nettverkets funksjonalitet.
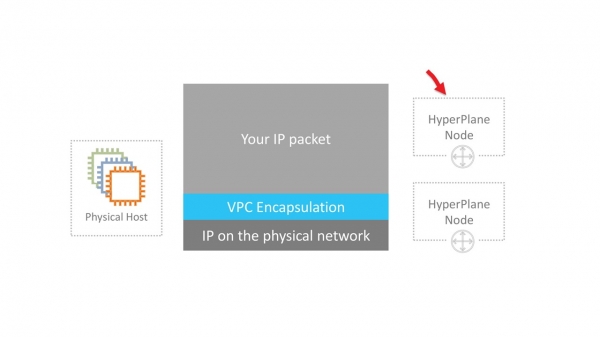
Hyperplane er bygget på EC2-virtualmaskiner. Det er ingen magi her, bare list. Listen er at dette er virtualmaskiner med mye RAM. Transaksjonsoperasjoner utføres utelukkende i minnet. Dette muliggjør latens på bare tiendeler av mikrosekunder. Å jobbe med disk ville ødelagt all ytelse.
Hyperplane er et distribuert system av et stort antall slike EC2-maskiner. Hver virtualmaskin har en båndbredde på 5 GB/s. På tvers av hele det regionale nettverket gir dette enorme terabiter med båndbredde og tillater behandling av millioner av tilkoblinger per sekund.
HyperPlane fungerer kun med strømmer. VPC-inkapslingen av pakker er helt transparent for den. Potensielle sårbarheter i denne interne tjenesten vil fortsatt ikke tillate å bryte VPC-isolasjonen. Sikkerheten ivaretas av nivåene under.
Noisy neighbor
Det finnes også et problem med den støyende naboen — noisy neighborLa oss anta at vi har 8 noder. Disse nodene håndterer strømmene fra alle brukerne i skyen. Alt virker bra, og belastningen skal fordeles jevnt over alle nodene. Nodene er svært kraftige, og det er vanskelig å overbelaste dem.
Men vi bygger arkitekturen vår med tanke på selv de mest usannsynlige scenariene.
Lav sannsynlighet betyr ikke umulighet.
Vi kan forestille oss en situasjon der en eller flere brukere genererer for mye belastning. Alle nodene i HyperPlane er involvert i håndtering av denne belastningen, og andre brukere kan potensielt oppleve en reduksjon i ytelsen. Dette undergraver konseptet med skyen, der leietakerne ikke har mulighet til å påvirke hverandre.
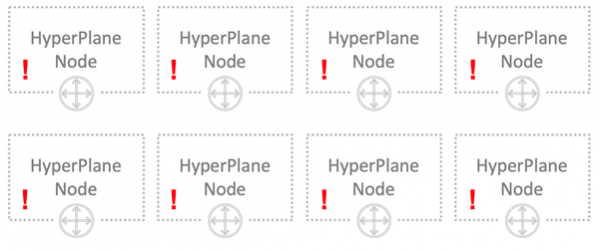
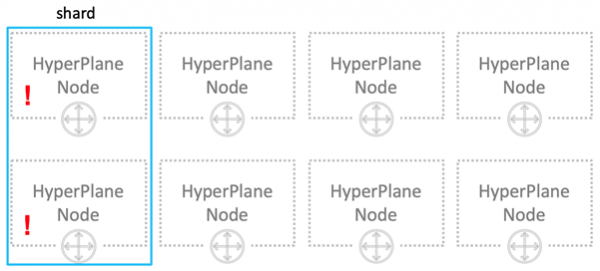
Hvordan kan vi løse problemet med den bråkete naboen? Det første som kommer i tankene er sharding. Våre 8 noder deles logisk inn i 4 shards med 2 noder i hver. Nå vil den bråkete naboen bare påvirke en fjerdedel av alle brukerne, men effektivt.
La oss gjøre det annerledes. Hver bruker tildeles bare 3 noder.
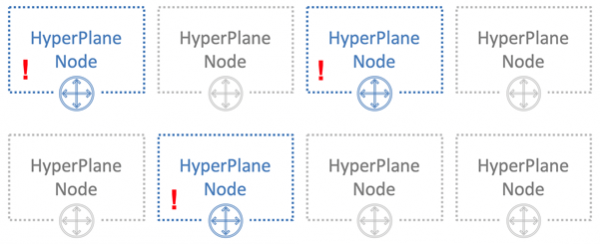
Trikset er å tildele noder til forskjellige brukere tilfeldig. I bildet nedenfor krysser den blå brukeren noder med en av de to andre brukerne - den grønne og den oransje.
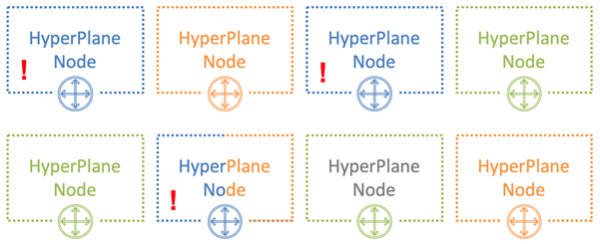
Med 8 noder og 3 brukere er sannsynligheten for kryssing av den bråkete naboen med en annen bruker 54%. Det er med denne sannsynligheten at den blå brukeren vil påvirke de andre leietakerne, og kun som en del av sin belastning. I vårt eksempel vil denne innflytelsen ikke bli merkbar for alle, men bare for en tredjedel av alle brukerne. Det er allerede et svært godt resultat.
Antall brukere som vil krysse hverandre
Sannsynlighet i prosent
0
18%
1
54%
2
26%
3
2%
La oss nærme oss situasjonen som er realistisk - vi tar 100 noder og 5 brukere på 5 noder. I dette tilfellet vil ingen av nodene krysse hverandre med en sannsynlighet på 77%.
Antall brukere som vil krysse hverandre
Sannsynlighet i prosent
0
77%
1
21%
2
1,8%
3
0,06%
4
0,0006%
5
0,00000013%
I en reell situasjon med et stort antall HyperPlane-noder og brukere er den potensielle påvirkningen fra den bråkete naboen på andre brukere minimal. Denne metoden kalles shuffle sharding — . Den minimerer den negative effekten av at noder går ned.Ved hjelp av HyperPlane er det bygget mange tjenester: Network Load Balancer, NAT Gateway, Amazon EFS, AWS PrivateLink, AWS Transit Gateway.
Nettverksstørrelse
Nettverksstørrelse
La oss nå snakke om omfanget av selve nettverket. I oktober 2019 tilbyr AWS sine tjenester i 22 regioner, med ytterligere 9 planlagt.
- Hver region inneholder flere tilgjengelighetssoner — Availability Zones. Totalt finnes det 69 av dem i verden.
- Hver AZ består av datasentre. Totalt finnes det ikke mer enn 8.
- I datasentrene finnes det et enormt antall servere, i noen tilfeller opp til 300 000.
La oss nå gjennomsnittliggjøre alt dette, multiplisere det, og vi får et imponerende tall som viser omfanget av Amazon Cloud.
Det er lagt mange optiske kanaler mellom tilgjengelighetssonene og datasentrene. I én av våre største regioner er det lagt 388 kanaler kun for å forbinde AZ med hverandre og med kommunikasjonssentrene i andre regioner (Transit Centers). Samlet gir dette en vanvittig 5000 Tbps.
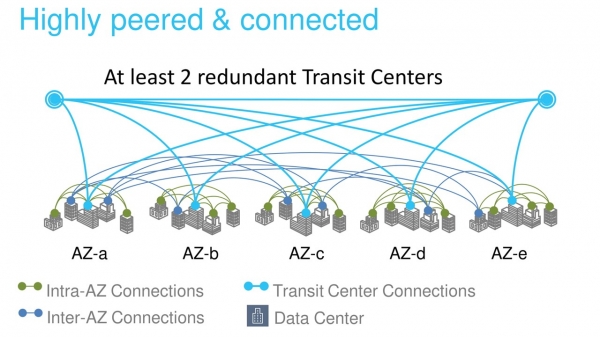
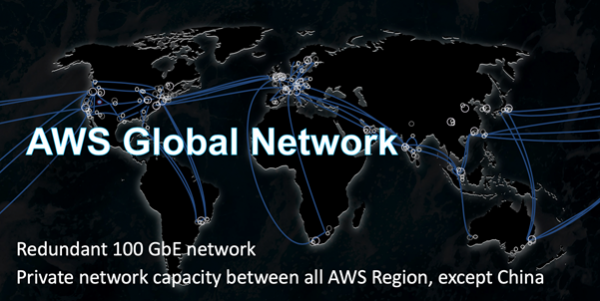
AWS backbone er bygget spesifikt for skyen og er optimalisert for å fungere med den. Vi bygger det på kanaler 100 Gbps. Vi kontrollerer dem fullstendig, unntatt i regionene i Kina. Trafikken deles ikke med belastningen fra andre selskaper.
Selvfølgelig er vi ikke den eneste skyleverandøren med et privat backbone-nettverk. Flere og flere store selskaper følger denne veien. Dette bekreftes av uavhengige forskere, for eksempel fra .
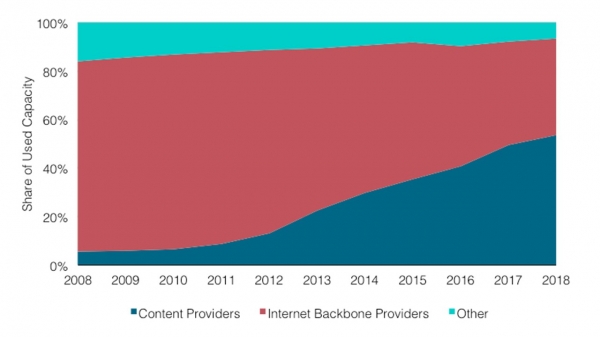
Grafikken viser at andelen innholdsleverandører og skyleverandører øker. Som et resultat synker andelen av Internett-trafikken fra backbone-leverandører stadig.
La meg forklare hvorfor dette skjer. Tidligere var de fleste webtjenester tilgjengelige og ble forbrukt direkte fra Internett. Nå er flere og flere servere plassert i skyen og er tilgjengelige gjennom CDN — Content Distribution Network. For å få tilgang til ressursen går brukeren gjennom Internett bare til nærmeste CDN PoP — Point of Presence. Ofte er dette ganske nær. Deretter forlater han det offentlige Internett og reiser gjennom en privat backbone over Atlanterhavet, for eksempel, og kommer direkte til ressursen.
Det er interessant å se hvordan Internett vil endre seg om 10 år hvis denne trenden fortsetter.
Fysiske kanaler
Forskere har fortsatt ikke funnet ut hvordan man kan øke lysfarten i universet, men de har gjort store fremskritt i metodene for overføring gjennom fiberoptikk. Nå bruker vi kabler med 6912 fibre. Dette bidrar til å betydelig optimalisere kostnadene ved legging av dem.
I noen regioner må vi bruke spesielle kabler. For eksempel i Sydney-regionen bruker vi kabler med spesialbelegg mot termitter.
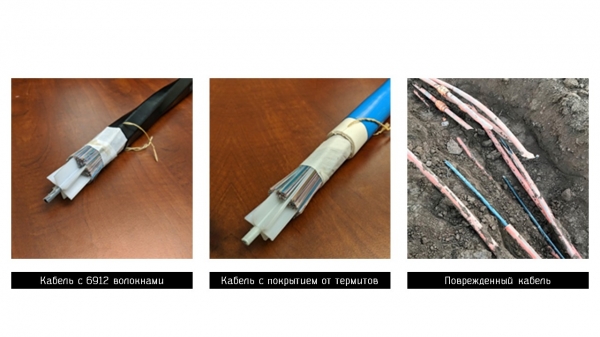
Ingen er immune mot problemer, og noen ganger blir kanalene våre skadet. På bildet til høyre er optiske kabler i en av de amerikanske regionene, som ble kuttet av bygningsarbeidere. Som et resultat av uhellet mistet vi bare 13 datapakker, noe som er utrolig. Igjen – bare 13! Systemet skiftet bokstavelig talt øyeblikkelig til reservekanaler – skalaen fungerer.
Vi har gitt en rask oversikt over noen av tjenestene og teknologiene i Amazon Cloud. Jeg håper du nå har fått en viss forståelse av omfanget av oppgavene som våre ingeniører må løse. Personlig synes jeg dette er veldig spennende.
Dette er den avsluttende delen av trilogien av Vasily Pantyukhin om oppbyggingen av AWS. I delen beskrives optimalisering av servere og skalering av databaser, og i – serverless-funksjoner og Firecracker.
På I november vil Vasily Pantyukhin dele nye detaljer om oppbyggingen av Amazon. Han vil snakke om årsakene til nedetid og design av distribuerte systemer i Amazon. Den 24. oktober er det fortsatt mulig å få billett til en god pris, og betale senere. Vi venter på deg på HighLoad++, kom innom – så skal vi prate!
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish