

Hei, Habr!
Etter nyttårsfeiringen har vi relansert vårt katastrofemotstandsdyktige sky på to steder. I dag vil vi forklare hvordan dette fungerer, og vise hva som skjer med kundenes virtuelle maskiner når enkelte elementer i klyngen svikter og en hel lokasjon faller ut (spoiler - de har det bra).
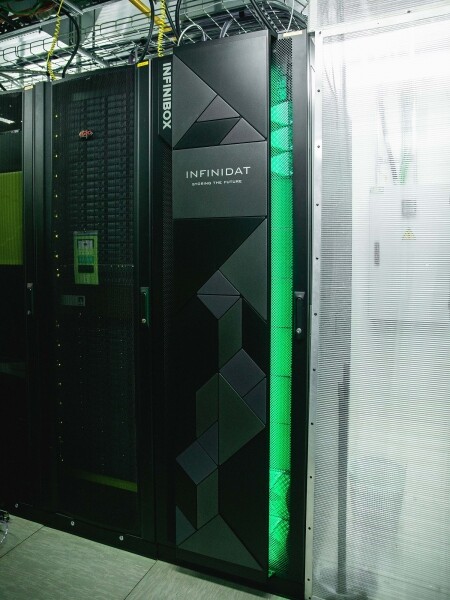
SAN for det katastrofemotstandsdyktige skyet på OST-lokasjonen.
Hva er inni
Under panseret i klyngen finner vi Cisco UCS-servere med hypervisoren VMware ESXi, to INFINIDAT InfiniBox F2240 SAN-er, Cisco Nexus nettverksutstyr, samt Brocade SAN-svitsjer. Klyngen er delt over to lokasjoner - OST og NORD, det vil si at hvert datasenter har et identisk sett med utstyr. Dette er det som gjør den katastrofemotstandsdyktig.
Innenfor en lokasjon er også hovedkomponentene duplisert (verter, SAN-svitsjer, nettverk).
De to lokasjonene er sammenkoblet med dedikerte fiberoptiske baner, som også er reservert.
Et par ord om SAN. Den første versjonen av den katastrofemotstandsdyktige skyen bygde vi på NetApp. Her valgte vi INFINIDAT, og her er grunnen:
- Active-Active replikasjonsalternativet. Det gjør at den virtuelle maskinen forblir i drift selv ved total svikt av en av SAN-ene. Jeg vil gi flere detaljer om replikasjonen senere.
- Tre diskontrollere for å øke systemets feilresistens. Vanligvis har de to.
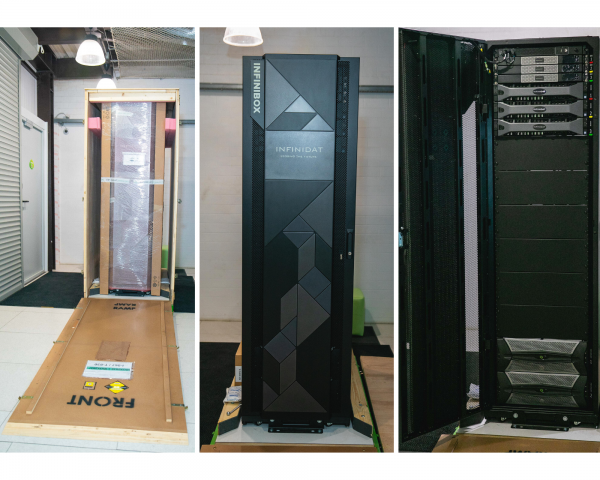
- Ferdig løsning. En forhåndsmontert rack kom til oss, som bare trenger å bli koblet til nettverket og konfigurert.
- Oppmerksom teknisk støtte. INFINIDATs ingeniører analyserer kontinuerlig logger og hendelser fra SAN, installerer nye versjoner i fastvaren, og hjelper med konfigurasjonen.
Her er noen bilder fra unpacking:
Slik fungerer det
Skyen er allerede motstandsdyktig mot interne feil. Den beskytter kunden mot enkeltstående maskinvare- og programvarefeil. Katastrofemotstandsdyktig sky vil hjelpe til med å beskytte mot massive feil innen en enkelt lokasjon: for eksempel svikt i SAN (eller SDS-klyngen, noe som skjer ofte 🙂), massfeil i lagringsnettverket, osv. Og det viktigste: en slik sky redder deg når en hel lokasjon blir utilgjengelig på grunn av brann, blackout, ran, eller invasjon fra romvesener.
I alle disse tilfellene fortsetter kundenes virtuelle maskiner å fungere, og det er derfor.
Klyngeschemat er organisert slik at enhver ESXi-vertsmaskin med klientvirtualiserte maskiner kan få tilgang til hvilken som helst av de to SAN-ene. Hvis SAN-en på OST-området feiler, vil de virtuelle maskinene fortsette å kjøre: vertene som de kjører på, vil hente data fra SAN-en på NORD.
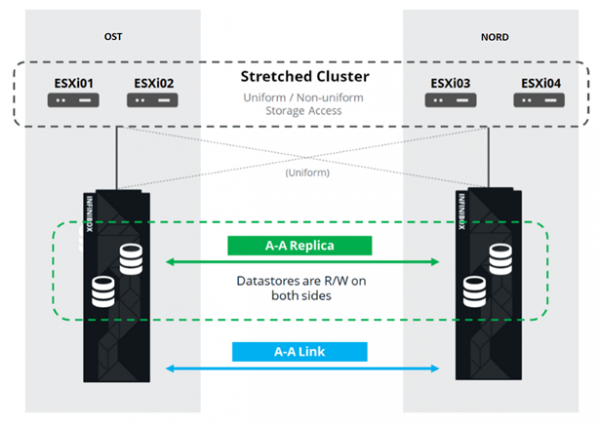
Slik ser tilkoblingsskjemaet i klyngen ut.
Dette er mulig takket være at det mellom SAN-fabrikkene på de to områdene er konfigurert Inter-Switch Link: SAN-bryteren Fabric A OST er koblet til SAN-bryteren Fabric A NORD, og det samme gjelder for SAN-bryterne Fabric B.
Og for at alle disse intrikate SAN-fabrikkene skal ha mening, er det mellom de to SAN-ene konfigurert Active-Active replikasjon: informasjon blir nesten samtidig skrevet til den lokale og den eksterne SAN-en, RPO=0. Det betyr at på én SAN lagres originaldataene, og på den andre lagres deres replikat. Data replikeres på volumnivåene til SAN-ene, og det er på dem at VM-dataene lagres (dens disker, konfigurasjonsfil, swap-fil osv.).
ESXi-vertsmaskinen ser hovedvolumet og dets replikat som en enkelt lagringsenhet (Storage Device). Fra ESXi-vertsmaskinen går det 24 veier til hver lagringsenhet:
12 veier kobler den til den lokale SAN-en (optimale veier), mens de resterende 12 kobler den til den eksterne (ikke-optimale veier). I normal drift henter ESXi data fra den lokale SAN-en ved å bruke de "optimale" veiene. Når denne SAN-en feiler, mister ESXi de optimale veiene og bytter over til de "ikke-optimale". Slik ser det ut i skjemaet.
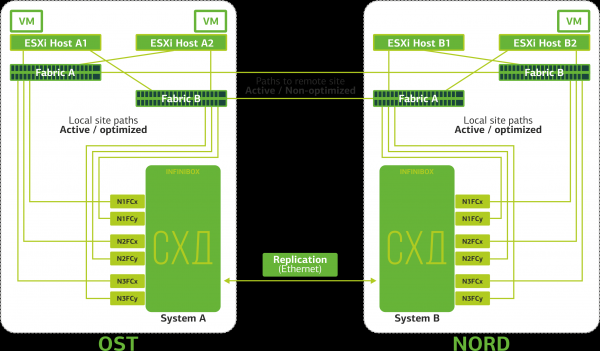
Skjema for katastrofesikre klynger.
Alle klientnettverk er koblet til begge områder gjennom en felles nettverksfabrikk. Hver plassering har en Provider Edge (PE), der klientenes nettverk termineres. PE-ene er samlet i en felles klynge. Hvis en PE på ett sted svikter, omdirigeres all trafikk til det andre stedet. Takket være dette forblir virtuelle maskiner fra stedet som mistet PE tilgjengelige over nettverket for klienten.
La oss nå se hva som skjer med klientens virtuelle maskiner ved ulike feil. Vi begynner med de enkleste alternativene og avslutter med det mest alvorlige – feilen med hele stedet. I eksemplene vil det primære stedet være OST, og det sekundære, med datamatrisene, vil være NORD.
Hva skjer med klientens virtuelle maskin hvis…
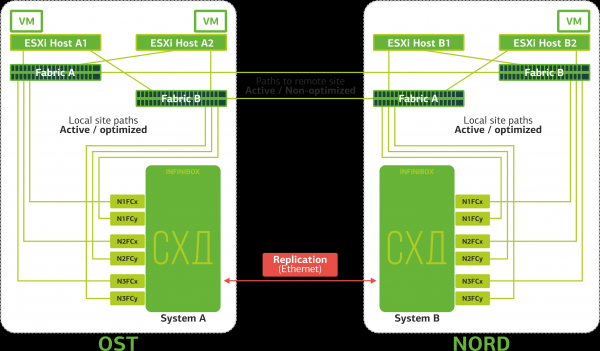
Replication Link svikter. Replikasjonen mellom SAN-ene på de to områdene stopper opp.
ESXi vil berre fungere med lokale lagringsenheter (via optimale stier).
Virtuelle maskiner fortsetter å fungere.
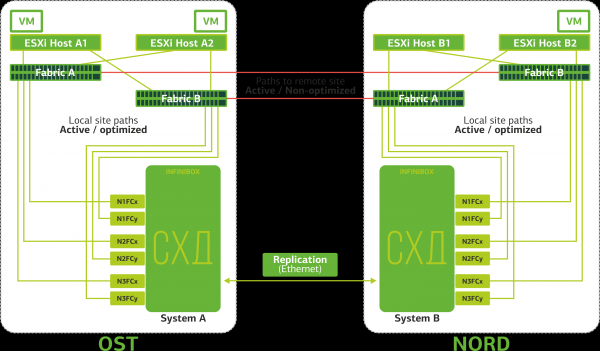
Det skjer et ISL (Inter-Switch Link) brudd. Dette er lite sannsynlig. Med mindre en gal gravemaskin graver opp flere optiske ruter som går uavhengige veier og går til plattformene gjennom forskjellige innganger. Men likevel. I dette tilfellet vil ESXi-verter miste halve stiene og kan bare få tilgang til sine lokale SAN-er. Replikaer blir samlet, men vertene vil ikke kunne få tilgang til dem.
Virtuelle maskiner fungerer normalt.
SAN-svitsjen på en av plattformene svikter. ESXi-vert erfarer tap av deler av stiene til SAN. I dette tilfellet vil vertene på plattformen der svitsjen svikter, bare fungere gjennom én av sine HBAs.
Virtuelle maskiner fortsetter å fungere normalt.
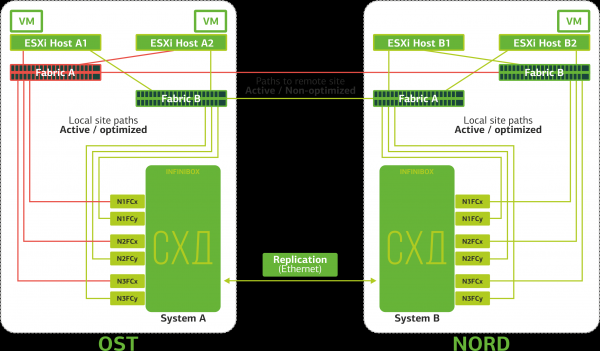
Alle SAN-svitsjer svikter på en av plattformene. La oss anta at et slikt problem oppstår på plattformen OST. I dette tilfellet vil ESXi-verts på denne plattformen miste alle stier til sine lagringsenheter. Den standard mekanismen i VMware vSphere HA treder i kraft: den vil starte alle virtuelle maskiner på plattformen OST i NORD innen maksimum 140 sekunder.
Virtuelle maskiner som kjører på vertene i plattformen NORD, fungerer normalt.
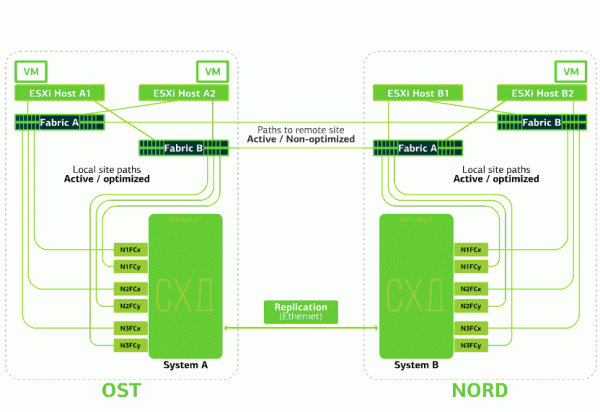
En ESXi-vert svikter på én plattform. Her treder igjen vSphere HA-mekanismen i kraft: virtuelle maskiner fra den sviktende verten blir startet på andre verter - på samme eller en annen plattform. Tiden for å starte en virtuell maskin er opptil 1 minutt.
Hvis alle ESXi-verter på plattformen OST svikter, er det ikke noen alternativer: VM-er startes på en annen. Oppstartstiden er den samme.
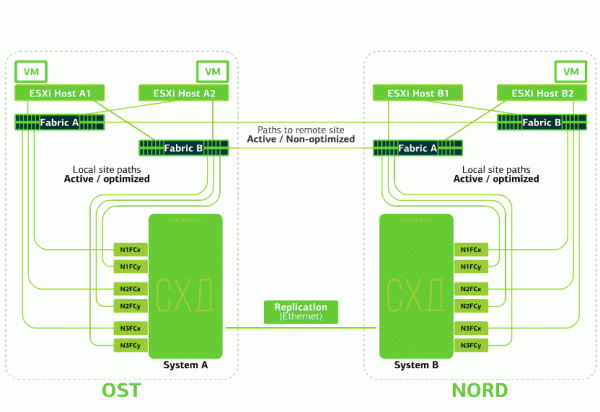
Et SAN svikter på en plattform. La oss si at SAN svikter på plattformen OST. Da vil ESXi-verter på plattformen OST bytte til å arbeide med replikaer fra SAN i NORD. Etter at den sviktende SAN er tilbake, vil det skje en tvunget replikering, og ESXi-verter OST vil igjen begynne å få tilgang til sin lokale SAN.
Virtuelle maskiner fungerer normalt i løpet av denne tiden.
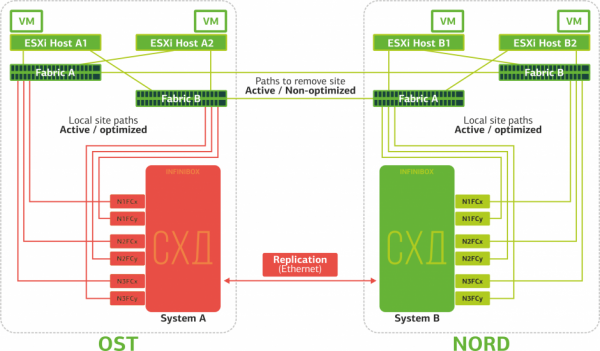
En av plattformene svikter. I dette tilfellet vil alle virtuelle maskiner bli startet på en reserveplattform via vSphere HA-mekanismen. Tiden for å starte VM-er er 140 sekunder. Alle nettverksinnstillinger for den virtuelle maskinen blir bevart, og den forblir tilgjengelig for kunden via nettet.
For the restart of machines on the backup site to go smoothly, each site is filled only halfway. The second half serves as a reserve in case all virtual machines need to be moved from the second, affected site.
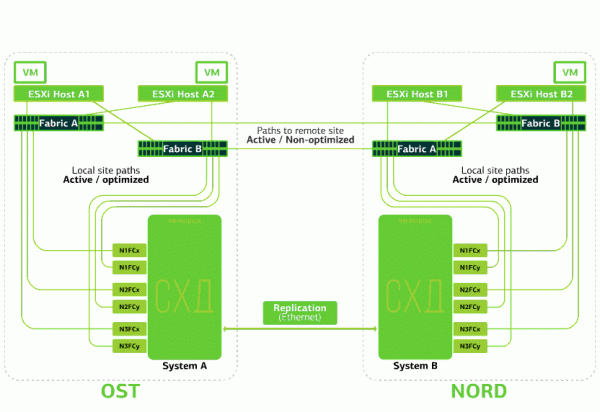
This is what a disaster-resistant cloud based on two data centers protects against.
This pleasure is not cheap, as in addition to the main resources, a reserve at the second site is required. Therefore, business-critical services are hosted in such clouds, where prolonged downtime leads to significant financial and reputational losses, or if there are disaster resistance requirements from regulators or the company's internal regulations.
Kilder:
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish