

Hei, Habr! Jeg presenterer for deg oversettelsen av artikkelen
.
Når det gjelder relasjonelle databaser, kan jeg ikke la være å tenke at noe mangler. De brukes overalt. Det finnes mange forskjellige databaser: fra den lille og nyttige SQLite til den kraftige Teradata. Men det finnes bare noen få artikler som forklarer hvordan en database fungerer. Du kan søke selv med forespørselen "howdoesarelationaldatabasework" for å se hvor få resultater det er. Dessuten er disse artiklene korte. Hvis du derimot leter etter de siste mote-teknologiene (BigData, NoSQL eller JavaScript), vil du finne flere dybdeartikler som forklarer hvordan de fungerer.
Er relasjonelle databaser for gamle og kjedelige til å forklare utenfor universitetets kurs, forskningsarbeid og bøker?
Som utvikler hater jeg å bruke det jeg ikke forstår. Og hvis databaser har vært i bruk i over 40 år, må det være en grunn. I løpet av disse årene har jeg brukt hundrevis av timer på å virkelig forstå disse merkelige svarte boksene jeg bruker hver dag. Relasjonsdatabaser svært interessante, fordi de er basert på nyttige og gjenbrukbare konsepter.Hvis du er interessert i å forstå databaser, men aldri har hatt tid eller lyst til å grave deg inn i dette omfattende temaet, vil du like denne artikkelen.
Selv om tittelen på denne artikkelen er åpenbar, er målet med denne artikkelen ikke å forstå hvordan man bruker en database.Følgende, bør du allerede vite hvordan man skriver en enkel sammenkobling og grunnleggende spørringer, CRUD; ellers vil du kanskje ikke forstå denne artikkelen. Dette er det eneste du trenger å vite, jeg vil forklare alt annet.
Jeg begynner med noen grunnleggende konsepter innen datavitenskap, som tidskompleksitet av algoritmer (BigO). Jeg vet at noen av dere hater dette konseptet, men uten det vil du ikke kunne forstå nyansene inne i databasen. Siden dette er et stort tema, skal jeg fokusere på det som jeg anser for viktig: hvordan databasen behandler SQL spørring.Jeg vil bare presentere grunnleggende databaskonsepter, slik at du ved slutten av artikkelen har en forståelse av hva som skjer under panseret.
Sidan detta är en lång och teknisk artikel som omfattar många algoritmer och datastrukturer, ta dig tid att läsa den. Vissa koncept kan vara svåra att förstå; du kan hoppa över dem och ändå få en allmän uppfattning.
För er som är mer insatta är denna artikel uppdelad i 3 delar:
- Översikt över lågnivå- och högnivådatabasekomponenter
- Översikt över frågaoptimeringsprocessen
- Översikt över transaktionshantering och buffertpoolen
Återgå till grunderna
Många år sedan (i en avlägsen, avlägsen galax…), var utvecklare tvungna att exakt veta hur många operationer de kodade. De visste sina algoritmer och datastrukturer utan och innan, eftersom de inte kunde ha råd med att slösa CPU och minne av sina långsamma datorer.
I denna del påminner jag dig om några av dessa koncept, eftersom de är nödvändiga för att förstå databaser. Jag kommer också att introducera konceptet databasindex.
O(1) vs O(n2)
För närvarande bryr sig många utvecklare inte om tidskomplexiteten av algoritmer… och de har rätt!
Men när du hanterar stora mängder data (jag pratar inte om tusentals) eller om du kämpar för millisekunder, blir det avgörande att förstå detta koncept. Och som du förstår måste databaser hantera båda situationerna! Jag ska inte låta dig spendera mer tid än nödvändigt för att fånga kärnan. Detta kommer hjälpa oss senare att förstå kostnadsbaserad optimering (cost based optimization).
Konseptet
Tidskomplexiteten av en algoritm används för att se hur lång tid det tar för algoritmen att utföra för en given mängd data. För att beskriva denna komplexitet används matematiska beteckningar för stora O. Denna notation används med en funktion som beskriver hur många operationer algoritmen behöver för en given mängd inmatningsdata.
Till exempel, när jag säger "denna algoritm har komplexitet O (some_function() )", betyder det att för att bearbeta en viss mängd data behövs some_function(a_certain_amount_of_data) operationer.
Samtidig det viktiga är inte mängden data**, utan hur ** antalet operationer ökar med ökande datamängd. Tidskomplexiteten ger inte det exakta antalet operationer, men är ett bra sätt att uppskatta körtiden.
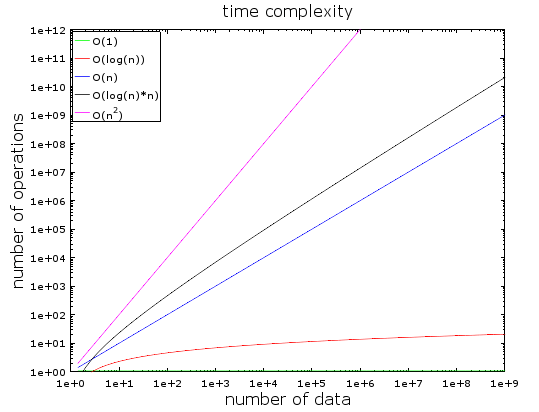
I denne grafen kan du se forholdet mellom antall operasjoner og mengden inndata for ulike typer tidskompleksitet. Jeg har brukt en logaritmisk skala for å vise dem. Med andre ord, mengden data øker raskt fra 1 til 1 milliard. Vi kan se at:
- O(1) eller konstant kompleksitet forblir konstant (ellers ville det ikke bli kalt konstant kompleksitet).
- O(log(n)) forblir lav selv med milliarder av data.
- Verste kompleksitet — O(n2), hvor antallet operasjoner vokser raskt.
- De to øvrige kompleksitetene øker også raskt.
Eksempler
Ved en liten mengde data er forskjellen mellom O(1) og O(n2) ubetydelig. La oss for eksempel anta at du har en algoritme som må behandle 2000 elementer.
- Algoritmen O(1) vil koste deg 1 operasjon
- Algoritmen O(log(n)) vil koste deg 7 operasjoner
- Algoritmen O(n) vil koste deg 2 000 operasjoner
- Algoritmen O(n * log(n)) vil koste deg 14 000 operasjoner
- Algoritmen O(n2) vil koste deg 4 000 000 operasjoner
Forskjellen mellom O(1) og O(n2) virker stor (4 millioner operasjoner), men du vil miste maksimalt 2 ms, bare tiden til å blinke med øynene. Faktisk kan moderne prosessorer håndtere . Det er derfor ytelse og optimalisering ikke er et problem i mange IT-prosjekter.
Som jeg allerede har sagt, er det fortsatt viktig å vite om dette konseptet når man arbeider med store mengder data. Hvis algoritmen denne gangen må behandle 1 000 000 elementer (som ikke er så mye for en database):
- Algoritmen O(1) vil koste deg 1 operasjon
- Algoritmen O(log(n)) vil koste deg 14 operasjoner
- Algoritmen O(n) vil koste deg 1 000 000 operasjoner
- Algoritmen O(n * log(n)) vil koste deg 14 000 000 operasjoner
- Algoritmen O(n2) vil koste deg 1 000 000 000 000 operasjoner
Jeg gjorde ikke beregningene, men jeg vil si at med algoritmen O(n2) har du tid til å ta en kaffe (kanskje til og med to!). Hvis du legger til enda en 0 til mengden data, har du tid til å ta en lur.
La oss gå dypere
Til informasjon:
- Søk i en god hashtabell finner et element på O(1).
- Søk i et godt balansert tre gir resultatet på O(log(n)).
- Søk i en liste gir resultatet på O(n).
- De beste sorteringsalgoritmene har kompleksitet O(n * log(n)).
- En dårlig sorteringsalgoritme har kompleksitet O(n2).
Merk: I de neste delene vil vi se disse algoritmene og datastrukturene.
Det finnes flere typer tidskompleksitet for algoritmer:
- den gjennomsnittlige scenariet
- det beste utfallet
- og det dårligste scenariet
Tidskompleksitet er ofte det dårligste scenariet.
Jeg har bare snakket om tidskompleksiteten til algoritmen, men kompleksiteten gjelder også for:
- minneforbruket til algoritmen
- disk I/O-forbruket til algoritmen
Selvfølgelig finnes det komplekser som er verre enn n², som for eksempel:
- n⁴: dette er fryktelig! Noen av de nevnte algoritmene har denne kompleksiteten.
- 3n: dette er enda verre! En av algoritmene vi skal se på senere i artikkelen har denne kompleksiteten (og den brukes faktisk i mange databaser).
- fakultet n: du får aldri resultatene dine selv med et lite datasett.
- nn: hvis du støter på denne kompleksiteten, bør du spørre deg selv om dette virkelig er ditt felt …
Merk: Jeg har gitt deg ikke en reell definisjon av betegnelsen «stor O», men bare en idé. Du kan lese denne artikkelen i for den reelle (asymptotiske) definisjonen.
MergeSort (Sammenslåing sortering)
Hva gjør du når du trenger å sortere en samling? Hva? Du kaller funksjonen sort()… Ok, godt svar… Men for databaser må du forstå hvordan denne sort()-funksjonen fungerer.
Det finnes flere gode sorteringsalgoritmer, så jeg vil fokusere på den viktigste: sammenslåingssortering. Kanskje du ikke forstår nå hvorfor datainndeling er nyttig, men du må forstå det etter delen om optimalisering av forespørslene. Videre vil forståelse av sammenslåingssortering hjelpe oss senere med å forstå den generelle join-operasjonen i databaser, kalt merge join (sammenslåing).
Merge (Sammenslåing)
Som mange nyttige algoritmer er sammenslåingssorteringen basert på en gimmik: å slå sammen 2 sorterede arrays av størrelse N/2 i et N-element sortert array koster bare N operasjoner. Denne operasjonen kalles sammenslåing.
La oss se hva dette betyr med et enkelt eksempel:
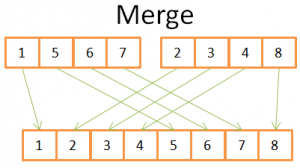
I denne illustrasjonen ser vi at for å konstruere det endelige sorterte arrayet på 8 elementer, trenger du bare å iterere én gang over 2x 4-element arrays. Siden begge 4-element arrays allerede er sortert:
- 1) du sammenligner begge nåværende elementer i de to arrayene (i starten er det nåværende = første)
- 2) så ta det minste tallet, og plasser det i et array med 8 elementer
- 3) og gå videre til neste element i arrayet der du tok det minste elementet
- og gjenta 1, 2, 3, inntil du når det siste elementet i et av arrayene.
- Deretter tar du de øvrige elementene fra det andre arrayet for å plassere dem i et array med 8 elementer.
Dette fungerer fordi begge 4-element arrayene er sortert, og dermed trenger du ikke å "gå tilbake" i disse arrayene.
Nå som vi har forstått dette trikset, her er pseudokoden min for sammenslåing:
array mergeSort(array a)
   if(length(a)==1)
      return a[0];
   end if

   //rekursive kall
   [left_array right_array] := split_into_2_equally_sized_arrays(a);
   array new_left_array := mergeSort(left_array);
   array new_right_array := mergeSort(right_array);

   //kombinere de 2 små ordnede arrayene til et stort
   array result := merge(new_left_array,new_right_array);
   return result;
Sammenslåingssortering deler opp oppgaven i mindre oppgaver, og deretter finner resultatene av de mindre oppgavene for å få resultatet av den opprinnelige oppgaven (merk: denne typen algoritme kalles del og hersk). Hvis du ikke forstår denne algoritmen, ikke bekymre deg; jeg forsto det ikke første gangen jeg så den. Hvis det kan hjelpe deg, ser jeg denne algoritmen som en to-fase algoritme:
- Delingsfase, hvor arrayet deles opp i mindre array
- Sorteringsfase, hvor små array kombineres (ved hjelp av sammenslåing) for å danne et større array.
Delingsfase (Division phase)
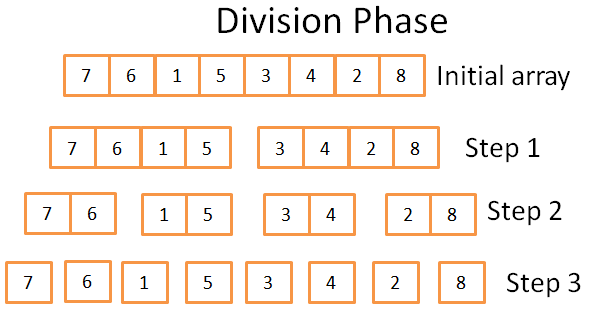
I delingsfasen deles arrayet opp i enhetlige array i 3 trinn. Det formelle antallet trinn er log(N) (siden N=8, log(N) = 3).
Hvordan vet jeg dette?
Jeg er et geni! Kort sagt – matematikk. Ideen er at hvert trinn deler størrelsen på det opprinnelige arrayet i 2. Antallet trinn er antallet ganger du kan dele det opprinnelige arrayet i to. Dette er den nøyaktige definisjonen av logaritmen (med base 2).
Sorteringsfase (Sorting phase)
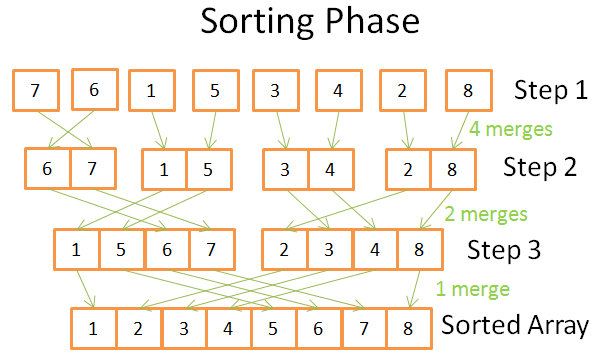
I sorteringsfasen begynner du med enhetlige (enkelt-element) arrays. I løpet av hvert trinn bruker du flere sammenslåingsoperasjoner, og den totale kostnaden er N = 8 operasjoner:
- I første trinn har du 4 sammenslåinger som koster 2 operasjoner hver
- I andre trinn har du 2 sammenslåinger som koster 4 operasjoner hver
- I tredje trinn har du 1 sammenslåing som koster 8 operasjoner
Siden det er log (N) trinn, den totale kostnaden N * log(N) operasjoner.
Fordelene med sammenslåingssortering
Hvorfor er denne algoritmen så kraftig?
Fordi:
- Du kan endre den for å redusere minnebruken, slik at du ikke oppretter nye matriser, men i stedet direkte endrer inngangsmatrisen.
Merk: denne typen algoritmer kalles (sortering uten ekstra minne).
- Du kan endre den for samtidig å bruke diskplass og lite minne uten betydelige kostnader for disk-I/O. Ideen er å laste inn i minnet bare de delene som for øyeblikket behandles. Dette er viktig når du må sortere en tabell som er flere gigabyte stor, kun med en minnebuffer på 100 megabyte.
Merk: denne typen algoritmer kalles .
- Du kan endre den for å kjøre på flere prosesser / tråder / servere.
For eksempel er distribuert sammenslåingssortering en av nøkkelkomponentene (som er en struktur i store data).
- Denne algoritmen kan forvandle bly til gull (sant!).
Denne sorteringsalgoritmen brukes i de fleste (om ikke alle) databaser, men den er ikke den eneste. Hvis du vil lære mer, kan du lese dette , som diskuterer fordeler og ulemper ved vanlige sorteringsalgoritmer i databaser.
Array, Tre og Hash-tabell
Nå som vi forstår ideen om tidskompleksitet og sortering, må jeg fortelle deg om 3 datatyper. Dette er viktig, fordi de er grunnlaget for moderne databaser.. Jeg vil også introdusere begrepet databasindex.
Array
Et todimensjonalt array er den enkleste datatypen. En tabell kan betraktes som et array. For eksempel:
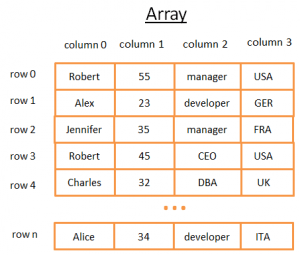
Dette 2-dimensjonale arrayet representerer en tabell med rader og kolonner:
- Hver rad representerer en enhet.
- Kolonnene lagrer egenskaper som beskriver enheten.
- Hver kolonne lagrer data av en bestemt type (integer, string, date …).
Det er så praktisk å lagre og visualisere data, men når du må finne en bestemt verdi, passer det ikke.
For eksempel, hvis du ønsker å finne alle guttene som jobber i Storbritannia, må du gå gjennom hver rad for å bestemme om denne raden tilhører Storbritannia. Dette vil koste deg N operasjoner., hvor N — antall rader, som er bra, men kan det være en raskere måte? Nå er det på tide å bli kjent med trær.
Merk: de fleste moderne databaser tilbyr utvidede matriser for effektiv lagring av tabeller: heap-organizedtables og index-organizedtables. Men dette endrer ikke problemet med rask søking av bestemte betingelser i en gruppe kolonner.
Database-tre og indeks
Et binært søketre er et binært tre med en spesiell egenskap, nøkkelen i hver node må være:
- større enn alle nøklene som er lagret i venstre undertre
- mindre enn alle nøklene som er lagret i høyre undertre
La oss se hva dette betyr visuelt
Ideen
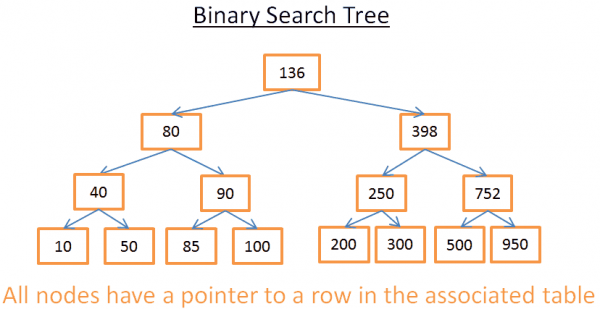
Dette treet har N = 15 elementer. La oss si at jeg leter etter 208:
- Jeg begynner med roten, hvis nøkkel er 136. Siden 136<208, ser jeg på høyre undertre til node 136.
- 398>208, derfor ser jeg på venstre undertre til node 398
- 250>208, derfor ser jeg på venstre undertre til node 250
- 200<208, derfor ser jeg på høyre undertre til node 200. Men 200 har ikke noe høyre undertre, verdien finnes ikke (fordi, hvis den fantes, ville den vært i høyre undertre til 200).
Nå, la oss si at jeg leter etter 40
- Jeg begynner med roten, hvis nøkkel er 136. Siden 136 > 40, ser jeg på venstre undertre til node 136.
- 80 > 40, derfor ser jeg på venstre undertre til node 80
- 40= 40, noden eksisterer. Jeg henter radidentifikatoren inne i noden (dette er ikke på bildet) og ser i tabellen for den gitte radidentifikatoren.
- Å kjenne radidentifikatoren lar meg vite hvor dataene faktisk ligger i tabellen, og derfor kan jeg hente dem umiddelbart.
Til slutt vil begge søkene koste meg antall nivåer inne i treet. Hvis du leser nøye delen om sammenfletting, må du se at det her er log (N) nivåer. Så det viser seg at kostnaden for søk er log(N), ikke dårlig!
La oss gå tilbake til problemet vårt
Men dette er veldig abstrakt, så la oss gå tilbake til problemet vårt. I stedet for et enkelt heltall, forestill deg en streng som representerer et lands navn i den forrige tabellen. La oss si at du har et tre som inneholder feltet "country" (kolonne 3) i tabellen:
- Hvis du vil vite hvem som jobber i Storbritannia
- ser du på treet for å få noden som representerer Storbritannia
- inni "UKnode" finner du plasseringen av postene til arbeidstakere i Storbritannia.
Denne søket vil koste log(N) operasjoner i stedet for N operasjoner hvis du bruker et array direkte. Det du nettopp har presentert, var databaseindeks.
Du kan bygge et indeks tre for hvilken som helst gruppe av felt (streng, tall, 2 strenger, tall og streng, dato...) så lenge du har en funksjon for å sammenligne nøkler (dvs. grupper av felt) slik at du kan sette rekkefølgen mellom nøklene (som er tilfelle for alle grunnleggende typer i databasen).
B+TreIndeks
Selv om dette treet fungerer godt for å få en bestemt verdi, er det et STORT problem når du trenger å hente flere elementer mellom to verdier. Dette vil koste O(N) fordi du må se på hver node i treet og sjekke om den ligger mellom disse to verdiene (for eksempel ved en sortert traversering av treet). Videre, denne operasjonen er ikke praktisk for disk I/O, da du må lese hele treet. Vi trenger å finne en måte å effektivt utføre intervalforespørselen. For å løse dette problemet, bruker moderne databaser en modifisert versjon av det tidligere treet kalt B+Tre. I B+Tre treet:
- bare de nederste nodene (bladene) lagrer informasjonen (plasseringen av radene i den tilknyttede tabellen)
- de andre nodene er her for ruting til riktig node under søk.
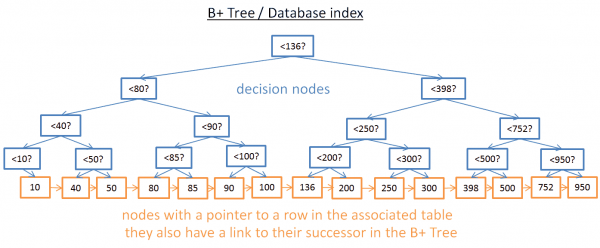
Som du kan se, er det flere noder her (dobbelt så mange). Faktisk har du ekstra noder, "beslutningstagere", som hjelper deg å finne riktig node (som lagrer plasseringen av radene i den tilknyttede tabellen). Men søke kompliserteheten er fortsatt O(log(N)) (det er bare et annet lag). Den store forskjellen er at nodene på det nederste nivået er knyttet til sine etterkommere.
Med dette B+Tre, hvis du leter etter verdier fra 40 til 100:
- Du trenger bare å søke etter 40 (eller den nærmeste verdien etter 40, hvis 40 ikke eksisterer), som du gjorde med det tidligere treet.
- Deretter samler du etterkommerne til 40, ved å bruke direkte referanser til etterkommerne, til du når 100.
Anta at du fant M etterkommere, og treet har N noder. Å søke etter en bestemt node koster log(N) slik som i det tidligere treet. Men, når du har fått denne noden, får du M etterkommere i M operasjoner med referanser til deres etterkommere. Dette søket koster bare M+log(N) operasjoner sammenlignet med N operasjoner med det forrige treet. Dessuten trenger du ikke å lese hele treet (kun M + log (N) noder), noe som betyr mindre diskbruk. Hvis M er lite (for eksempel 200 rader) og N er stort (1 000 000 rader), vil dette være en STOR forskjell.
Men her er det nye problemer (igjen!). Hvis du legger til eller fjerner en rad i databasen (og dermed i den tilknyttede B+Tree-indeksen):
- må du opprettholde rekkefølgen mellom nodene inne i B+Tree, ellers kan du ikke finne nodene inne i et usortert tre.
- du må bevare et minimum av nivåer i B+Tree, ellers vil den tidsmessige kompleksiteten i O(log(N)) bli O(N).
Med andre ord, B+Tree må være selvordnende og balansert. Heldigvis er dette mulig med smarte slettings- og innsettingsoperasjoner. Men det kommer til en kostnad: innsetting og sletting i B+ treet koster O(log(N)). Det er derfor noen av dere har hørt at å bruke for mange indekser ikke er en så god idé. Faktisk, du bremser rask innsetting / oppdatering / sletting av rader i tabellen, siden databasen må oppdatere tabelens indekser med kostbare O(log(N)) operasjoner for hver indeks. I tillegg betyr det å legge til indekser en større belastning for transaksjonsbehandleren (som vil bli beskrevet mot slutten av artikkelen).
For mer informasjon, kan du se artikkelen på Wikipedia om . Hvis du ønsker et eksempel på implementering av B+Tree i en database, se og fra en ledende MySQL-utvikler. Begge fokuserer på hvordan InnoDB (MySQL-motoren) håndterer indekser.
Merk: leseren fortalte meg at, på grunn av lavnivåoptimaliseringer, må B+ treet være fullstendig balansert.
Hashtable (Hash-table)
Vår siste viktige datastruktur er hashtabellen. Den er veldig nyttig når du vil raskt søke etter verdier. I tillegg vil forståelsen av hashtabeller hjelpe oss senere med å forstå den generelle operasjonen for sammenkobling i databasen, kalt hash-sammenkobling ( hash join). Denne datastrukturen brukes også av databasen for å lagre noen interne ting (for eksempel, låsetabell eller bufferpool, vi vil se begge disse konseptene senere).
En hash-tabell er en datakonstruksjon som raskt finner et element basert på nøkkelen. For å bygge en hash-tabell må du definere:
- nøkkel for elementene dine
- en hash-funksjon for nøklene. De beregnede hashene for nøklene gir plasseringen av elementene (kalt segmenter ).
- en funksjon for å sammenligne nøkler. Når du har funnet riktig segment, må du finne elementet du leter etter i segmentet, ved hjelp av denne sammenligningen.
Et enkelt eksempel
La oss ta et konkret eksempel:
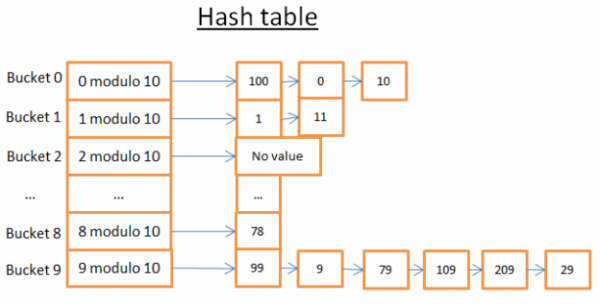
Denne hash-tabellen har 10 segmenter. Siden jeg er lat, har jeg bare illustrert 5 segmenter, men jeg vet at du er smart, så jeg lar deg forestille deg de 5 andre selv. Jeg har brukt en hash-funksjon som tar modulus 10 av nøkkelen. Med andre ord, beholdere bare det siste sifferet av nøkkelen for å finne segmentet:
- hvis det siste sifferet er 0, går elementet til segment 0,
- hvis det siste sifferet er 1, går elementet til segment 1,
- hvis det siste sifferet er 2, går elementet til segment 2,
- …
Sammenligningsfunksjonen jeg brukte er rett og slett likhet mellom to heltall.
Anta at du ønsker å hente elementet 78:
- Hash-tabellen beregner hash-koden for 78, som er 8.
- Hash-tabellen ser i segment 8, og det første elementet den finner, er 78.
- Den returnerer elementet 78 til deg
- Søket kostet bare 2 operasjoner (en for å beregne hash-funksjonsverdien og en annen for å finne elementet innen segmentet).
Nå, antatt at du vil hente elementet 59:
- Hash-tabellen beregner hash-koden for 59, som er 9.
- Hash-tabellen søker i segment 9, det første funnet elementet er 99. Siden 99!=59, er ikke elementet 99 det riktige elementet.
- Ved å bruke denne samme logikken, tas det andre elementet (9), tredje (79), …, siste (29).
- Elementet ble ikke funnet.
- Søket kostet 7 operasjoner.
En god hash-funksjon
Som du ser, avhenger kostnaden av verdien du leter etter!
Hvis jeg nå endrer hash-funksjonen til modulus 1 000 000 av nøkkelen (det vil si, tar de siste 6 sifrene), vil det andre søket koste bare 1 operasjon, siden det ikke finnes elementer i segment 000059. Den virkelige oppgaven er å finne en god hash-funksjon som lager segmenter som inneholder svært få elementer..
I mitt eksempel er det enkelt å finne en god hash-funksjon. Men dette er et enkelt eksempel; det er vanskeligere å finne en god hash-funksjon når nøkkelen er:
- en streng (for eksempel et etternavn)
- to strenger (for eksempel et etternavn og et fornavn)
- to strenger og en dato (for eksempel et etternavn, et fornavn og fødselsdato)
- …
Med en god hash-funksjon finner du i en hash-tabell i O(1).
Array vs. hash-tabell
Hvorfor ikke bruke array?
Hmm, godt spørsmål.
- Hash-tabellen kan være delvis lastet inn i minnet, mens de øvrige segmentene kan være lagret på disken.
- Med et array må du bruke kontinuerlig minneplass. Hvis du laster inn en stor tabell, er det veldig vanskelig å finne tilstrekkelig kontinuerlig plass.
- For hash-tabellen kan du velge ønsket nøkkel (for eksempel landet og etternavnet til en person).
For mer informasjon kan du lese artikkelen om , som er en effektiv implementering av hash-tabellen; du trenger ikke å forstå Java for å forstå konseptene som er presentert i denne artikkelen.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish