

Av og til trenger utvikleren å sende et sett med parametere eller til og med et helt utvalg «som input». Noen ganger møter man ganske merkelige løsninger på denne oppgaven.
La oss gå «den motsatte veien» og se på hvordan man ikke bør gjøre det, hvorfor, og hvordan man kan gjøre det bedre.
Direkte «injeksjon» av verdier i forespørselen
Ser vanligvis omtrent slik ut:
query = "SELECT * FROM tbl WHERE id = " + value… eller slik:
query = "SELECT * FROM tbl WHERE id = :param".format(param=value)Det er sagt, skrevet og ganske mye om denne metoden:
Nesten alltid er det — en direkte vei til SQL-injeksjoner og unødvendig belastning på forretningslogikken, som må «lime» sammen strengen i forespørselen din.
Delvis kan denne tilnærmingen rettferdiggjøres bare i tilfelle behov for å bruke partisjonering i PostgreSQL versjoner 10 og lavere for å oppnå en mer effektiv plan. I disse versjonene bestemmes listen over skannede seksjoner fortsatt uten hensyn til de overførte parameterne, bare basert på forespørselens innhold.
$n-argumenter
Bruken parametere — det er bra, det tillater bruk av , noe som reduserer belastningen både på forretningslogikken (spørringen dannes og sendes bare én gang), og på databasen (det er ikke nødvendig med ny parsing og planlegging for hver instans av forespørselen).
Variabelt antal argumenter
Problemer vil vente på oss når vi ønsker å sende et forhåndsukjent antall argumenter:
... id IN ($1, $2, $3, ...) -- $1 : 2, $2 : 3, $3 : 5, ...Hvis forespørselen står i slik form, vil det redde oss fra potensielle injeksjoner, men det vil fortsatt føre til behovet for å lime sammen/analysere forespørselen for hver variasjon av antallet argumenter.Det er allerede bedre enn å gjøre dette hver gang, men det er mulig å unngå dette.
Det er tilstrekkelig å sende bare ett parameter som inneholder en serialisert representasjon av et array:
... id = ANY($1::integer[]) -- $1 : '{2,3,5,8,13}'Den eneste forskjellen er nødvendigheten av å konvertere argumentet eksplisitt til den nødvendige array-typen. Men dette skaper ingen problemer, siden vi allerede vet hvor vi adresserer.
Sending av utvalg (matrise)
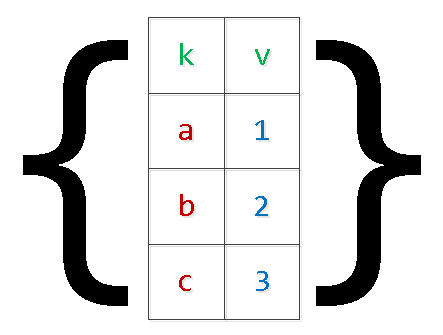
Vanligvis gjelder dette forskjellige alternativer for overføring av datasett for innsetting i databasen «i ett forespørsel»:
INSERT INTO tbl(k, v) VALUES($1,$2),($3,$4),...I tillegg til de nevnte problemene med "omkalling" av forespørselen, kan dette også føre til ut av minne og serverkrasj. Årsaken er enkel — PG reserverer ekstra minne for argumentene, mens antall poster i settet begrenses kun av applikasjonslogikkens ønsker. I spesielt kliniske tilfeller har man sett "numeriske" argumenter større enn $9000 — ikke gjør det.
La oss omskrive forespørselen ved å bruke "to-nivå" serialisering:
INSERT INTO tbl
SELECT
  unnest[1]::text k
, unnest[2]::integer v
FROM (
  SELECT
    unnest($1::text[])::text[] -- $1 : '{"{a,1}","{b,2}","{c,3}","{d,4}"}'
) T;
Ja, når det gjelder "komplekse" verdier inne i arrayet, må de omgis med anførselsestegn.
Det er klart at på denne måten kan man "utvide" utvalget med et vilkårlig antall felt.
unnest, unnest, …
Av og til finnes det varianter der man i stedet for "array av arrays" sender flere "kolonne-arrayer", som jeg har nevnt :
SELECT
  unnest($1::text[]) k
, unnest($2::integer[]) v;
Ved denne metoden, hvis man gjør en feil under generering av verdilister for forskjellige kolonner, kan man enkelt få helt overraskende resultater, som også avhenger av versjonen av serveren:
-- $1 : '{a,b,c}', $2 : '{1,2}'
-- PostgreSQL 9.4
k | v
-----
a | 1
b | 2
c | 1
a | 2
b | 1
c | 2
-- PostgreSQL 11
k | v
-----
a | 1
b | 2
c |
JSON
Fra og med versjon 9.3 i PostgreSQL ble det innført fullverdige funksjoner for å jobbe med json-typen. Så hvis definisjonen av inngangsparametrene dine skjer i nettleseren, kan du direkte der lage json-objektet for SQL-forespørselen:
SELECT
  key k
, value v
FROM
  json_each($1::json); -- '{"a":1,"b":2,"c":3,"d":4}'
For tidligere versjoner kan man bruke samme metode for each(hstore), men korrekt "sammenslåing" med escaping av komplekse objekter i hstore kan føre til problemer.
json_populate_recordset
Hvis du på forhånd vet at dataene fra "inngangs" json-arrayet skal brukes til å fylle en bestemt tabell, kan du spare mye på "derreferering" av felt og konvertering til de nødvendige typene ved å bruke funksjonen json_populate_recordset:
SELECT
  *
FROM
  json_populate_recordset(
    NULL::pg_class
  , $1::json -- $1 : '[{"relname":"pg_class","oid":1262},{"relname":"pg_namespace","oid":2615}]'
  );
json_to_recordset
Og denne funksjonen vil helt enkelt "utvide" det sendte arrayet av objekter til et utvalg, uten å være avhengig av tabellformatet:
SELECT
  *
FROM
  json_to_recordset($1::json) T(k text, v integer);
-- $1 : '[{"k":"a","v":1},{"k":"b","v":2}]'
k | v
-----
a | 1
b | 2
MIDLERTIDIG TABELL
Men hvis datamengden i den overførte utvalget er veldig stor, er det tungvint å overføre det i én serialisert parameter, av og til umulig, ettersom det krever én gang å allokere et stort minnevolum. For eksempel, hvis du må samle en stor datamengde over lengre tid fra et eksternt system, og deretter ønsker å bearbeide det hele på én gang i databasen.
I dette tilfellet vil den beste løsningen være å bruke :
CREATE TEMPORARY TABLE tbl(k text, v integer);
...
INSERT INTO tbl(k, v) VALUES($1, $2); -- gjenta mange, mange ganger
...
-- her gjør vi noe nyttig med hele denne tabellen
Metoden er spesielt god for sjelden overføring av store volum data.
Når det gjelder beskrivelsen av strukturen til dataene dine, skiller en midlertidig tabell seg fra en 'vanlig' bare ved én egenskap i systemtabellen pg_class, og i pg_type, pg_depend, pg_attribute, pg_attrdef, … – så og si ingenting.
Derfor, i web-systemer med mange kortvarige tilkoblinger, vil hver av dem generere nye systemoppføringer hver gang, som slettes når tilkoblingen til databasen lukkes. Resultatet blir ukontrollert bruk av TEMP TABLE fører til 'oppblåsing' av tabeller i pg_catalog og forsinkelse av mange operasjoner som bruker dem.
Selvfølgelig kan dette bekjempes med hjelp av periodisk VACUUM FULL av systemkatalogtabeller.
Sessionvariabler
Anta at databehandlingen fra det forrige tilfellet er ganske kompleks for én SQL-forespørsel, men vi ønsker å gjøre det ganske ofte. Vi vil gjerne bruke prosedyremessig behandling i , men det vil bli for kostbart å bruke overføring av data gjennom midlertidige tabeller.
Å bruke $n-parametere for overføring til en anonym blokk vil vi heller ikke kunne gjøre. Vi kan løse problemet med sessionvariabler og funksjonen current_setting.
Før versjon 9.2 måtte man først konfigurere custom_variable_classes for 'dine' sessionvariabler. I aktuelle versjoner kan det skrives omtrent slik:
SET my.val = '{1,2,3}';
DO $$
DECLARE
  id integer;
BEGIN
  FOR id IN (SELECT unnest(current_setting('my.val')::integer[])) LOOP
    RAISE NOTICE 'id : %', id;
  END LOOP;
END;
$$ LANGUAGE plpgsql;
-- NOTICE:  id : 1
-- NOTICE:  id : 2
-- NOTICE:  id : 3
I andre støttede prosedyremessige språk kan man finne flere løsninger.
Kjenner du flere metoder? Del dem i kommentarfeltet!
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish