

Artikkelen består av to deler:
- En kort beskrivelse av noen arkitekturer for nettverk som oppdager objekter i bilder og segmentering av bilder, med de mest forståelige ressurslenkene for meg. Jeg har forsøkt å velge video forklaringer, helst på russisk.
- Den andre delen handler om å forstå retningen for utvikling av arkitekturer for nevrale nettverk. Og teknologiene basert på dem.
Figur 1 – Å forstå arkitekturer av nevrale nettverk er ikke enkelt
Alt begynte med at jeg lagde to demonstrasjonsapplikasjoner for klassifisering og oppdagelse av objekter på Android-telefonen:
- , der data behandles på serveren og overføres til telefonen. Klassifisering av bilder (image classification) av tre typer bjørner: brun, svart og kosebamse.
- , der data behandles på selve telefonen. Oppdagelse av objekter (object detection) av tre typer: hasselnøtt, fiken og dadler.
Det er en forskjell mellom oppgaver for klassifisering av bilder, oppdagelse av objekter i bilder og . Derfor oppstod det et behov for å finne ut hvilke arkitekturer for nevrale nettverk som oppdager objekter i bilder og hvilke som kan segmentere. Jeg fant følgende eksempler på arkitekturer med de mest forståelige ressurslenkene for meg:
- En serie arkitekturer basert på R-CNN (Regions with Convolution Neural Networks features): R-CNN, Fast R-CNN, , . For å oppdage objekter i bilder ved hjelp av Region Proposal Network (RPN) fremheves begrensede regioner (bounding boxes). I utgangspunktet ble en tregere mekanisme, Selective Search, brukt i stedet for RPN. Deretter leveres de begrensede regionene inn i en vanlig nevrale nettverk for klassifisering. Arkitekturen til R-CNN har eksplisitte 'for'-løkker som itererer over de begrensede regionene, med totalt opptil 2000 kjøringer gjennom det interne nettverket AlexNet. På grunn av de eksplisitte 'for'-løkene reduseres hastigheten på bildebehandlingen. Antallet eksplisitte løkker, kjøringer gjennom det interne nevrale nettverket, reduseres for hver ny versjon av arkitekturen, og det gjøres også dusinvis av andre endringer for å øke hastigheten og for å erstatte oppgaven med oppdagelse av objekter med segmentering av objekter i Mask R-CNN.
- (You Only Look OYOLO – den første nevrale nettverket som gjenkjente objekter i sanntid på mobile enheter. Den karakteristiske funksjonen: gjenkjenning av objekter på én runde (det er nok å se én gang). Det vil si at arkitekturen til YOLO ikke har åpenbare «for»-løkker, noe som gjør at nettverket fungerer raskt. For eksempel, slik det finnes i NumPy under matriseoperasjoner, finnes det heller ikke åpenbare «for»-løkker. Som i NumPy, som blir implementert på lavere nivåer gjennom programmeringsspråket C. YOLO bruker et rutenett med forhåndsdefinerte vinduer. For å unngå at det samme objektet blir oppdaget flere ganger, brukes et overlappingskoeffisient (IoU, Iinterseksjon ounion). Denne arkitekturen fungerer over et bredt spekter og har høy Urobusthet Single
- (SShot MultiBox Sdetektor) – de mest vellykkede «hackene» fra YOLO-arkitekturen (for eksempel non-maximum suppression) brukes, og nye legges til for å gjøre nevrale nettverket raskere og mer nøyaktig. Den karakteristiske funksjonen: gjenkjenning av objekter på én runde ved hjelp av et spesifisert rutenett med vinduer (default box) på bilde-pyramider. Bilde-pyramiden er kodet i konvolusjonelle tensorer ved sekvensielle konvolusjons- og pooling-operasjoner (under max-pooling reduseres romlig dimensjon). På denne måten kan både store og små objekter bli gjenkjent på én runde av nettverket. DMobileSSD (
- NetV2 +Mobile) – en kombinasjon av to arkitekturer av nevrale nettverk. Det første nettverket SSDMobileNetV2 . Det andre nettverket SSD bestemmer plasseringen av objekter på bildet. SqueezeNet
- DeepLab
- (Semantic Image Segmentation with Deep Convolutional Nets) – segmentering av objekter på bilder. Den karakteristiske funksjonen ved arkitekturen er sparsommelig (dilated convolution) konvolusjon, som opprettholder romlig oppløsning. Deretter følger en post-prosessering av resultater ved hjelp av en grafisk probabilistisk modell (conditional random field), noe som gjør det mulig å fjerne små støy i segmenteringen og forbedre kvaliteten på det segmenterte bildet. Bak det imponerende navnet «grafisk probabilistisk modell» skjuler det seg et vanlig Gauss-filter, som er approksimert over fem punkter.
- Prøvde å forstå oppsettet (Single-Shot Refinement Neural Network for Object Detection), men skjønte lite.
- Så så jeg på hvordan «oppmerksomhet»-teknologien fungerer (attention): , , . Den karakteristiske funksjonen ved arkitekturen «oppmerksomhet» er automatisk fremheving av områder med økt oppmerksomhet på bildet (RoI, Regions of Interest) ved hjelp av et nevralt nettverk kalt Attention Unit. Områder med økt oppmerksomhet ligner på begrensede områder (bounding boxes), men i motsetning til dem er de ikke fastlåst på bildet og kan ha uskarpe grenser. Deretter trekker vi ut trekk (features) fra områdene med økt oppmerksomhet, som «mates» inn i rekurserende nevrale nettverk med arkitekturer . Rekurserende nevrale nettverk kan analysere forholdet mellom trekk i sekvenser. Rekurserende nevrale nettverk ble opprinnelig brukt for oversettelser av tekst til andre språk, og nå også for å oversette og .
Etter hvert som jeg studerte disse arkitekturene forstod jeg at jeg ikke forsto noe.. Og det er ikke det at mitt nevrale nettverk har problemer med oppmerksomhetsmekanismen. Opprettelsen av alle disse arkitekturene ligner på et stort hackathon, der forfatterne konkurrerer i hacking. Hack (hack) – en rask løsning på et vanskelig programvareproblem. Så mellom alle disse arkitekturene er det ingen synlig eller forståelig logisk sammenheng. Alt som forener dem er et sett av de mest vellykkede hackene, som de låner fra hverandre, pluss en felles (tilbakepropagering av feil, backpropagation). Det er ikke ! Det er uklart hva som skal endres og hvordan man skal optimalisere de eksisterende prestasjonene.
Som resultat av mangel på logisk sammenheng mellom hackene, er de ekstremt vanskelige å huske og bruke i praksis. Dette er fragmentert kunnskap. I beste fall huskes noen interessante og overraskende punkter, men det meste av det som er forstått og ikke forstått forsvinner fra hukommelsen allerede etter noen dager. Det ville være bra om man etter en uke i det minste husker navnet på arkitekturen. Og for dette ble det brukt flere timer og til og med dager av arbeidstiden på å lese artikler og se oppsummeringsvideoer!
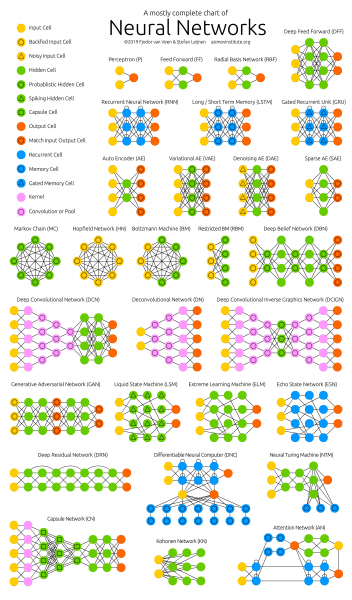
Figur 2 –
De fleste forfattere av vitenskapelige artikler, etter min personlige mening, gjør alt de kan for å sikre at selv denne fragmenterte kunnskapen ikke blir forstått av leseren. Men gerundialte fraser i ti linjers setninger med formler som er 'plukket fra luften' – dette er et tema for en egen artikkel (problem ).
Av denne grunn oppstod det et behov for å systematisere informasjon om nevrale nettverk og dermed øke kvaliteten på forståelsen og hukommelsen. Derfor ble hovedtemaet for analysen av enkelte teknologier og arkitekturer innen kunstige nevrale nettverk følgende oppgave: finne ut hvor dette hele er på vei, ikke hvordan en bestemt nevralnettverksstruktur fungerer isolert.
Hvor alt dette er på vei. Hovedresultater:
- Antallet oppstart i machine learning-området de siste to årene . En mulig årsak: 'nevrale nettverk har sluttet å være noe nytt'.
- Hver person kan lage et fungerende nevralnettverk for å løse en enkel oppgave. For dette tar man en ferdig modell fra 'dyrehagen av modeller' (model zoo) og trener det siste laget i nevralnettverket () på eksisterende data fra eller fra i gratis .
- Store produsenter av nevralnettverk har begynt å opprette 'modellsamlinger' (model zoo). Ved hjelp av dem kan man raskt lage en kommersiell applikasjon: TF Hub MMDetection Detectron chainer-modelzoo Nevrale nettverk som opererer i .
- sanntid (real-time) på mobile enheter. Fra 10 til 50 bilder per sekund. Bruken av nevrale nettverk i telefoner (TF Lite), i nettlesere (TF.js) og i
- husgeråd Internet Iof Things). Spesielt i telefoner som allerede støtter nevrale nettverk på maskinvare-nivå (neuroakseleratorer). of Tspesielt på telefoner som allerede støtter nevrale nettverk på maskinvare-nivå (nevroakseleratorer).
- «Hvert apparaat, klær og kanskje til og med mat vil ha IP-v6 adresse og kommunisere med hverandre» – .
- Veksten i antallet publikasjoner om maskinlæring har begynt (dobling hvert andre år) siden 2015. Det er tydelig at vi trenger nevrale nettverk for analyse av artikler.
- Følgende teknologier blir stadig mer populære:
- PyTorch – populariteten vokser raskt og ser ut til å overgå TensorFlow.
- Automatisk hyperparameter-tuning AutoML – populariteten vokser jevnt.
- Gradvis reduksjon av nøyaktighet og økning av beregningseffektivitet: , algoritmer , upresise (tilnærmede) beregninger, kvantisering (når vektene til det nevrale nettverket konverteres til hele tall og kvantiseres), nevrale akseleratorer.
- Translation og .
- Opprette , nå allerede i sanntid.
- Essensen av DL er å ha mye data, men å samle og annotere dem er ikke enkelt. Derfor utvikles automatisering av annotering () for nevrale nettverk ved hjelp av nevrale nettverk.
- Med nevrale nettverk ble datavitenskap plutselig en eksperimentell vitenskap og det oppstod .
- IT-penger og populariteten til nevrale nettverk oppstod samtidig som beregningene ble en markedsverdi. Økonomien går fra gull-valuta til gull-valuta-beregning. Se min artikkel om og årsaken til IT-penger.
Gradvis dukker det opp en ny (Maskinlæring & Dyp læring), som er basert på å se programmet som en samling av trente nevrale nettverksmodeller.
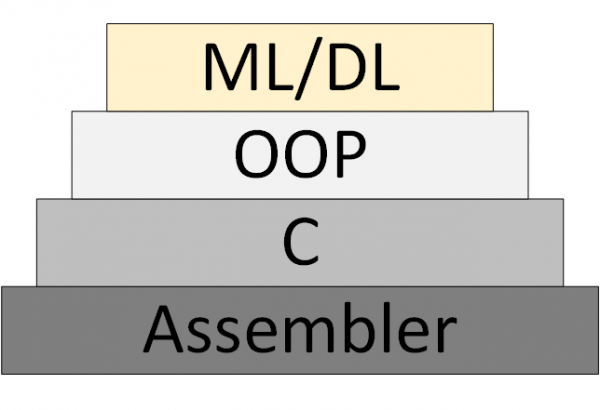
Figur 3 – ML/DL som en ny programmeringsmetodikk
Imidlertid har det fortsatt ikke oppstått «teorien om nevrale nettverk», innen rammene av hvilken man kan tenke og arbeide systematisk. Det som nå kalles «teori» er faktisk eksperimentelle, heuristiske algoritmer.
Lenker til mine og andre ressurser:
- Nyhetsbrev om Data Science. Hovedsakelig om bildebehandling. De som ønsker å motta det, kan sende e-post (foobar167<ruff-ruff>gmail<dot>com). Lenker til artikler og videoer sendes ut etter hvert som materialet samles.
- Generell , som jeg har fullført og som jeg ønsker å ta.
- , som man bør begynne å studere nevrale nettverk med. I tillegg et hefte .
- , der kvar ein og annan interessant for seg.
- Mykje nyttig har vist seg å vera videokanalar for analyse av vitskapelege artiklar innen Data Science. Finn, abonner på dei, og del lenkene med kollegaene dine, og meg også. Eksempler:
- og med steg-for-steg instruksjonar og opent kildekode.
Takk for oppmerksomheten!
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish