

9. januar ble Pandas 1.0.0rc utgitt. Den forrige versjonen av biblioteket er 0.25.
Den første større utgivelsen inneholder mange fantastiske nyheter, inkludert forbedret automatisk summering av datasett, flere utdataformater, nye datatyper, og til og med et nytt dokumentasjonsnettsted.
Alle endringer kan ses , i artikkelen vil vi imidlertid begrense oss til en liten, mindre teknisk oversikt over det viktigste.
Du kan installere biblioteket som vanlig ved hjelp av pip, men siden Pandas 1.0 fortsatt er release candidate, må du spesifikt angi versjonen:
pip install --upgrade pandas==1.0.0rc0Vær oppmerksom: siden dette er en større utgivelse, kan oppdateringen bryte gammel kode!
Forresten, fra denne versjonen er støtten for Python 2 helt avsluttet (som kan være en god grunn til — anm. overs.). Pandas 1.0 krever minst Python 3.6+, så hvis du er usikker, sjekk hvilken versjon du har installert:
$ pip --version
pip 19.3.1 fra /usr/local/lib/python3.7/site-packages/pip (python 3.7)

$ python --version
Python 3.7.5
Å sjekke versjonen av Pandas er enklest slik:
>>> import pandas as pd
>>> pd.__version__
1.0.0rc0
Forbedret automatisk summering med DataFrame.info
Min favorittnyhet er oppdateringen av metoden DataFrame.info. Funksjonen har blitt mye mer lesbar, noe som gjør datainnsiktsprosessen enda enklere:
>>> df = pd.DataFrame({
...:   'A': [1,2,3],
...:   'B': ["goodbye", "cruel", "world"],
...:   'C': [False, True, False]
...:})
>>> df.info()

RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      object
 2   C       3 non-null      object
dtypes: int64(1), object(2)
memory usage: 200.0+ bytes
Utdata av tabeller i Markdown-format
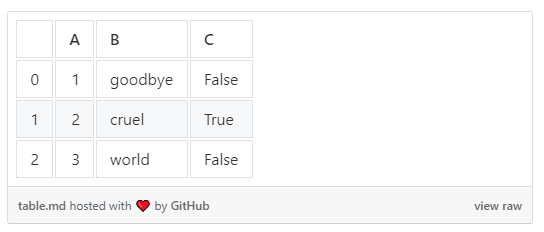
En annen hyggelig nyhet er muligheten til å eksportere datasett til Markdown-tabeller ved hjelp av DataFrame.to_markdown.
>>> df.to_markdown()
|    |   A | B       | C     |
|---:|----:|:--------|:------|
|  0 |   1 | goodbye | False |
|  1 |   2 | cruel   | True  |
|  2 |   3 | world   | False |
Dette forenkler publisering av tabeller på nettsteder som Medium ved hjelp av github gists.
Nye typer for strenger og boolske verdier
Den nye utgivelsen av Pandas 1.0 har også lagt til nye eksperimentelle typer. Deres API kan fortsatt endres, så bruk det med forsiktighet. Men generelt anbefaler Pandas å bruke nye typer der det gir mening.
Foreløpig må konvertering gjøres eksplisitt:
>>> B = pd.Series(["goodbye", "cruel", "world"], dtype="string")
>>> C = pd.Series([False, True, False], dtype="bool")
>>> df.B = B, df.C = C
>>> df.info()

RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      string
 2   C       3 non-null      bool
dtypes: int64(1), object(1), string(1)
memory usage: 200.0+ bytes
Merk deg at kolonnen Dtype viser nye typer — strengen og bool.
Den mest nyttige funksjonen til den nye strenge typen er muligheten til å velge bare strengkolonner fra dataframes. Dette kan gjøre analysen av tekstdata betydelig enklere:
df.select_dtypes("string")Tidligere kunne ikke strengkolonner velges uten å spesifisere navn eksplisitt.
Les mer om de nye typene .
Takk for at du leste! Den komplette listen over endringer, som allerede nevnt, kan sees .
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish