

I henhold til , data engineer er i dag et yrke som etterspørres raskere enn noen andre. Data engineer har en kritisk rolle i organisasjoner – de lager og opprettholder pipelines og databaser som brukes til behandling, transformasjon og lagring av data. Hvilke ferdigheter trenger folk i dette yrket først og fremst? Skiller listen seg fra det som kreves av data scientists? Alt dette vil du finne ut av i artikkelen min.
Jeg har analysert stillingsannonser for data engineer slik de fremstår i januar 2020 for å forstå hvilke teknologiske ferdigheter som er mest etterspurt. Deretter sammenlignet jeg resultatene med statistikken for stillingsannonser for data scientist – og det ble avdekket noen interessante forskjeller.
La oss komme til sak uten lange forord – her er toppen av ti teknologier som oftest nevnes i stillingsannonser:
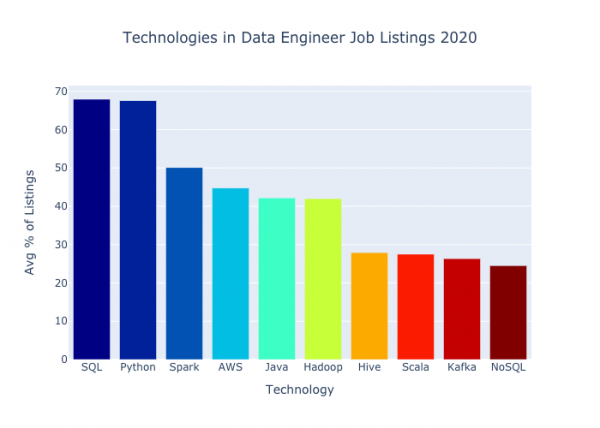
Omfattning av teknologier i stillingsannonser for data engineer i 2020
La oss se nærmere på dette.
Ansvarsområder for data engineer
I dag har arbeidet som data engineers enorm betydning for organisasjoner – det er disse menneskene som er ansvarlige for lagring av informasjon og får den til å bli i en form som andre ansatte kan jobbe med. Data engineers bygger pipelines for å sikre datainnhenting, enten strømmet eller i pakker, fra mange kilder. Deretter utfører disse pipelinene ekstraksjons-, transformasjons- og lastingsprosesser (i andre ord, ETL-prosesser), som gjør data mer egnet til videre bruk. Etter dette leveres data til analytikere og data scientists for dypere behandling. Til slutt ender dataene sin reise på informasjonsdashboards, i rapporter og modeller for maskinlæring.
Jeg har lett etter informasjon som kunne gi indikasjoner på hvilke teknologier som er mest etterspurt i arbeidet som data engineer for tiden.
Metoder
Jeg samlet informasjon fra tre jobbnettsider — , og og så på hvilke nøkkelord som dukker opp i sammenheng med «data engineer» i stillingsannonser rettet mot innbyggere i USA. For denne oppgaven brukte jeg to Python-biblioteker — og . I included keywords both from the previous list for analyzing job postings for the data scientist position, as well as those I manually selected while reading job descriptions for data engineers. LinkedIn was not included as a source because I was banned there after my last attempt to collect data.
For each keyword, I calculated the percentage of occurrences from the total number of texts on each site individually, and then computed the average across the three sources.
Resultater
Below are thirty technical terms from the field of data engineering with the highest indicators across all three job sites.
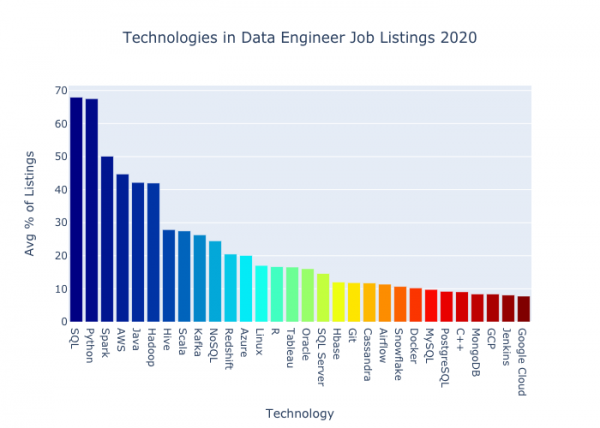
Here are the same numbers, but presented in table form:
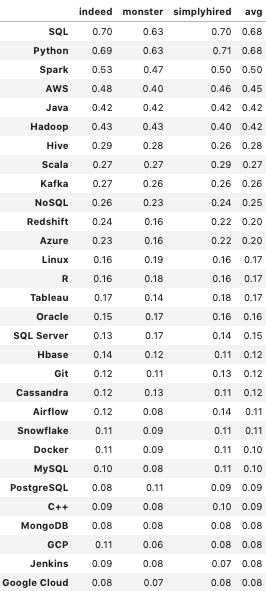
Let's go in order.
Overview of Results
Both SQL and Python appear in more than two-thirds of the reviewed job postings. These two technologies are indeed the most important to study first. – a very popular programming language used for data work, website creation, and script writing. stands for Structured Query Language; it implies a standard realized by a group of languages, and is used to extract data from relational databases. It has been around for a long time and has established itself with high reliability.
Spark is mentioned in about half of the job postings. – a unified analytics engine for big data processing with built-in modules for streaming, SQL, machine learning, and graph processing. It is especially popular among those working with large databases.
AWS appears in about 45% of job postings. It is Amazon's cloud computing platform; it holds the largest market share among all cloud platforms.
Next are Java and Hadoop – just over 40% each. – a widely used, battle-tested language which in ranked tenth among languages that programmers dread. In contrast, Python came second among the most loved languages. Java is controlled by Oracle, and everything you need to know about it can be understood from this screenshot of the official page from January 2020.
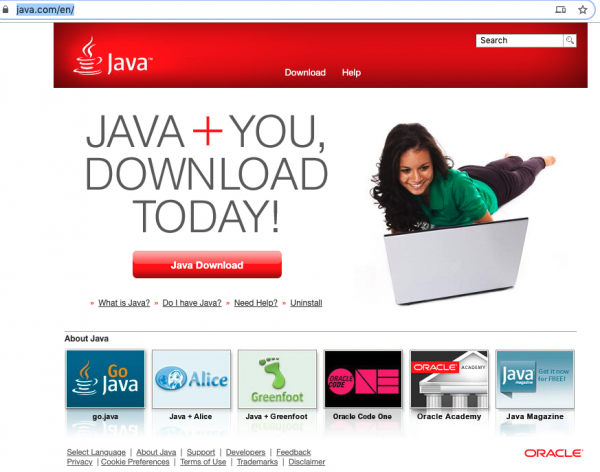
As if I took a ride in a time machine
benytter MapReduce-programmodellen med klynger av servere for store data. Denne modellen blir nå oftere forlatt.
Videre ser vi Hive, Scala, Kafka og NoSQL – hver av disse teknologiene nevnes i en fjerdedel av de presenterte stillingsannonsene. Apache Hive er et datalagerprogram som "forenkler lesing, skriving og håndtering av store datamengder som befinner seg i distribuerte lagre, ved hjelp av SQL." er et programmeringsspråk som aktivt brukes i arbeidet med store data. Spilleren Scala brukes til å utvikle Spark. På den allerede nevnte rangeringen av fryktende programmeringsspråk, inntar Scala den ellevte plassen. - er en distribuert plattform for behandling av strømmedata. Den er veldig populær som et verktøy for datastreaming.
setter seg i mot SQL. De skiller seg ved at de ikke er relasjonelle, ikke strukturerte, og de har horisontal skalerbarhet. NoSQL har oppnådd en viss popularitet, men den febrilske besettelsen med denne tilnærmingen, inkludert spådommene om at den vil erstatte SQL som den dominerende lagringsparadigmen, synes allerede å være bak oss.
Sammenligning med termer i stillingsannonser for data scientist
Her er tretti teknologiske termer som er mest brukte av arbeidsgivere innen data science. Denne listen fikk jeg på samme måte som beskrevet ovenfor for data engineering.
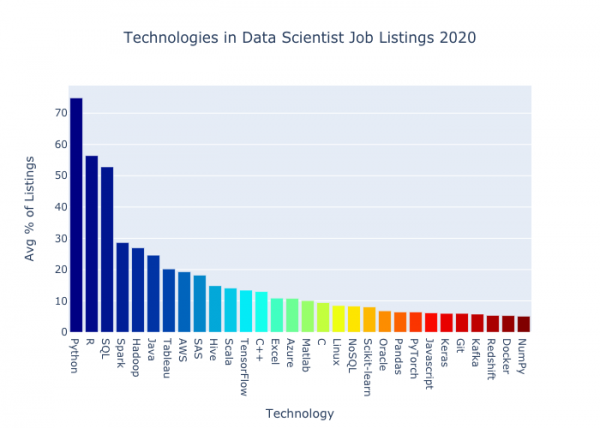
Henvisninger til teknologier i stillingsannonser for data scientist i 2020
Når vi ser på det totale antallet, er det 28% flere stillinger sammenlignet med den tidligere vurderte settet (12 013 mot 9396). La oss se hvilke teknologier som forekommer sjeldnere i stillingsannonser for data scientist enn for data engineer.
Mer populære innen data engineering
Grafikken nedenfor viser nøkkelord med en gjennomsnittlig differanse i verdier på mer enn 10% eller mindre enn -10%.
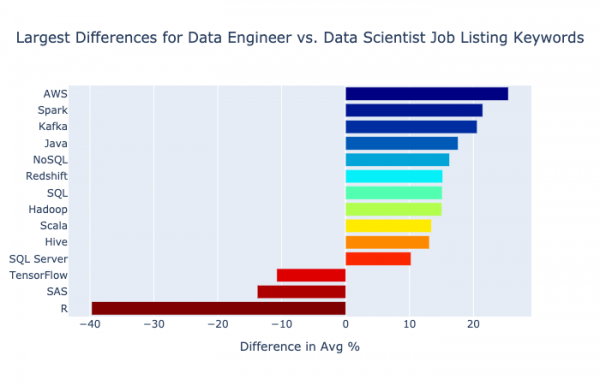
De største forskjellene i frekvens av nøkkelord mellom data engineer og data scientist
Den mest betydelige økningen observeres for AWS: i data engineering forekommer det 25% mer regelmessig enn i data science (henholdsvis omtrent 45% og 20% av totalt antall stillinger). Forskjellen er betydelig!
Her er de samme dataene i en litt annen fremstilling – grafen viser resultatene for det samme nøkkelordet i stillingsannonser for data engineer og data scientist side om side.
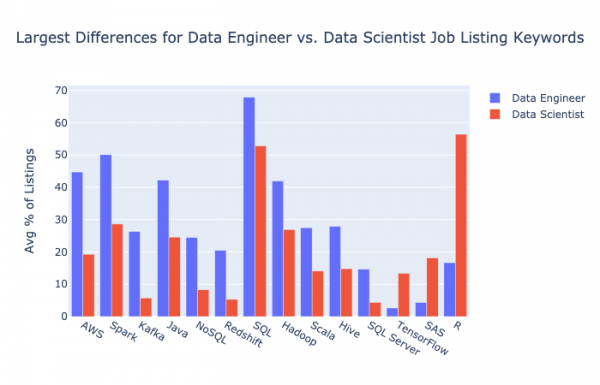
De største forskjellene i frekvens av nøkkelord mellom data engineer og data scientist
Den neste store økningen merket jeg hos Spark – dataingeniører må ofte jobbe med store datamengder. økte også med 20%, noe som er nesten fire ganger sammenlignet med resultatene for data scientist-stillinger. Datatransport er en av de viktigste oppgavene for dataingeniører. Til slutt var antallet omtaler 15% høyere innen data engineering for Java, NoSQL, Redshift, SQL og Hadoop.
Mindre populære i data engineering
Nå la oss se på hvilke teknologier som er mindre populære i dataingeniør-stillinger.
Den største nedgangen sammenlignet med data science skjedde i : der ble det nevnt i omtrent 56% av stillingene, her bare i 17%. Imponerende. R er et programmeringsspråk som er populært blant forskere og statistikere, og det kom på åttende plass i rangeringen av de mest fryktede språkene.
forekommer også i dataingeniør-stillinger betydelig sjeldnere – forskjellen er 14%. SAS er et proprietært språk designet for statistikk og datahåndtering. Interessant å merke seg: i følge resultatene , har det i det siste tapt stilling – mer enn noen annen teknologi.
Etterspurt både i data engineering og i data science
Det er verdt å merke seg at åtte av de ti øverste posisjonene er de samme i begge sett. SQL, Python, Spark, AWS, Java, Hadoop, Hive og Scala kom inn på topp ti både for data engineering og for data science. I diagrammet nedenfor kan du se de femten mest populære teknologiene blant arbeidsgivere av dataingeniører, sammen med deres tall for stillinger for data scientists.
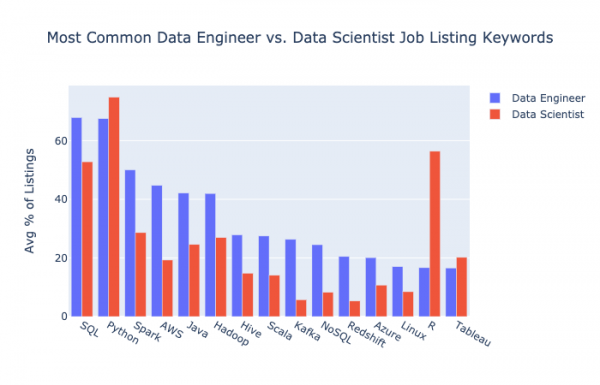
Anbefalinger
Hvis du ønsker å jobbe med data engineering, ville jeg anbefale å mestre følgende teknologier – jeg lister dem i rekkefølge etter omtrent hvilken prioritet de har.
Lær deg SQL. Jeg anbefaler spesielt PostgreSQL, fordi det har åpen kildekode, stor popularitet i fellesskapet og er i vekst. Hvordan man bruker språket kan man lære fra boken My Memorable SQL – pilotversjonen er tilgjengelig .
Lær deg Python, men ikke på det mest avanserte nivået. Boken My Memorable Python er nettopp for nybegynnere. Den kan kjøpes på , både digital kopi eller fysisk, etter ditt valg, eller lastes ned i pdf- eller epub-format .
Når du har blitt kjent med Python, kan du gå videre til pandas – Python-biblioteket som brukes til rengjøring og behandling av data. Hvis du har som mål å jobbe i et selskap som krever Python-kunnskaper (og de fleste gjør det), kan du være trygg på at kjennskap til pandas forventes som standard. Jeg avslutter nå en introduksjonsguide for å jobbe med pandas – du kan , for å ikke gå glipp av lanseringen.
Lær AWS. Hvis du vil bli dataingeniør, kan du ikke klare deg uten en skyplattform, og AWS er den mest populære av dem. Kursene , hjalp meg mye da jeg studerte , jeg tror de også har gode ressurser for AWS.
Hvis du allerede har mestret denne listen og ønsker å vokse videre i øynene til arbeidsgiverne som dataingeniør, foreslår jeg at du legger til Apache Spark for arbeid med store data. Selv om min forskning på data science-jobber viste en nedgang i interessen, er den likevel til stede i nesten annenhver stilling for dataingeniører.
Til slutt
Håper du fant denne oversikten over de mest ettertraktede teknologiene for dataingeniører nyttig. Hvis du er interessert i hvordan det står til med jobbene for analytikere, kan du lese . Lykke til med ingeniøren!
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish