

Analytisk DB ClickHouse håndterer mange forskjellige strenger og bruker ressurser. For å akselerere systemet legges det hele tiden til nye optimaliseringer. Utvikler av ClickHouse, Nikolai Kochetov, snakker om datatypen for strenger, inkludert den nye typen, LowCardinality, og forklarer hvordan man kan gjøre operasjoner med strenger raskere.
— La oss først se på hvordan vi kan lagre strenger.
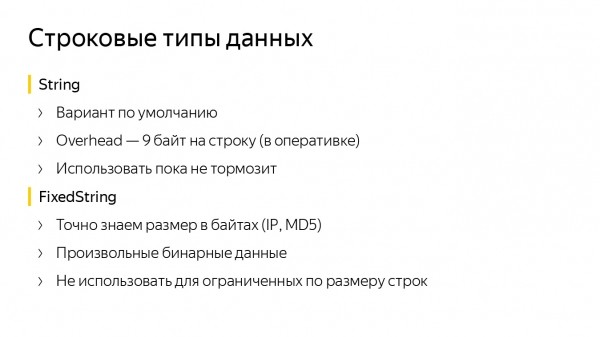
Vi har datatyper for strenger. String fungerer godt som standard, og det bør nesten alltid brukes. Det har en liten Overhead — 9 byte per streng. Hvis vi ønsker at størrelsen på strenger skal være fast og kjent på forhånd, er det bedre å bruke FixedString. I den kan vi spesifisere ønsket antall byte, og den er praktisk for data som IP-adresser eller hash-funksjoner.
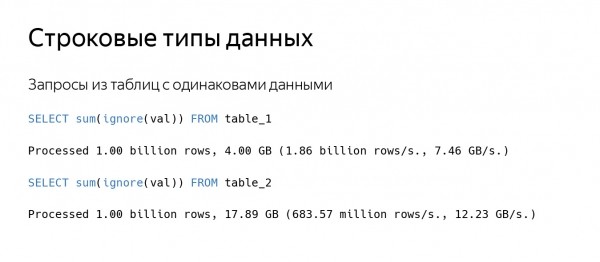
Selvfølgelig hender det noen ganger at noe er tregt. La oss si at du gjør en forespørsel til en tabell. ClickHouse leser ganske mye data, si med en hastighet på 100 GB/s, mens antallet strenger som behandles er ganske lite. Vi har to tabeller som lagrer nesten identiske data. Fra den andre tabellen leser ClickHouse data raskere, men antallet strenger som leses per sekund er tre ganger lavere.
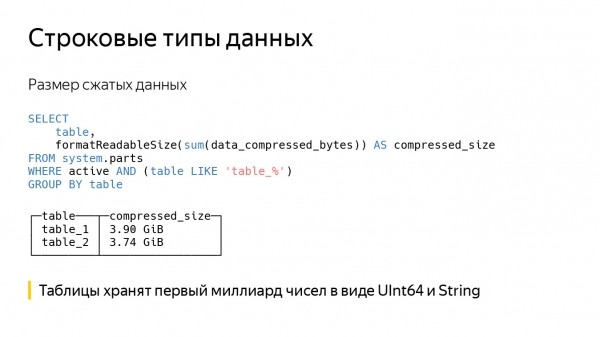
Hvis vi ser på størrelsen av de komprimerte dataene, vil de vise seg å være nesten like. I virkeligheten er det skrevet de samme dataene i tabellene — den første milliarden tall — bare i den første kolonnen er de skrevet som UInt64, mens i den andre kolonnen er de skrevet som String. På grunn av dette bruker den andre forespørselen lengre tid på å lese data fra disken og dekomprimere dem.
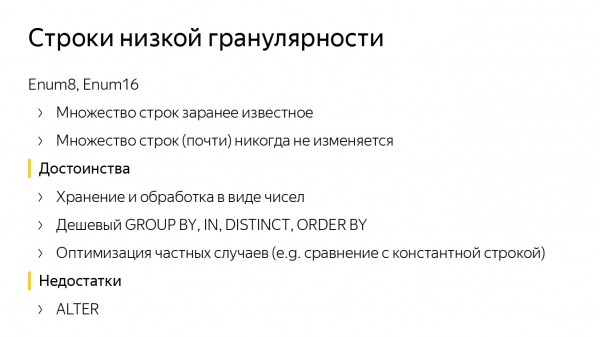
Her er et annet eksempel. Anta at det er et forhåndsbekjent sett med strenger, begrenset av en konstant på 1000 eller 10 000 og som praktisk talt aldri endres. I dette tilfellet passer datatypen Enum for oss, i ClickHouse er det to — Enum8 og Enum16. Ved å lagre i Enum kan vi raskt behandle forespørslene.
I ClickHouse finnes det akselerasjoner for GROUP BY, IN, DISTINCT og optimaliseringer for visse funksjoner, for eksempel for sammenligning med en konstant streng. Selvfølgelig konverteres ikke tall i strengen, men derimot konverteres den konstante strengen til verdien Enum. Etter dette blir alt raskt sammenlignet.
Men det finnes også ulemper. Selv om vi vet det eksakte settet av strenger, må det noen ganger oppdateres. En ny streng har kommet — vi må utføre ALTER.
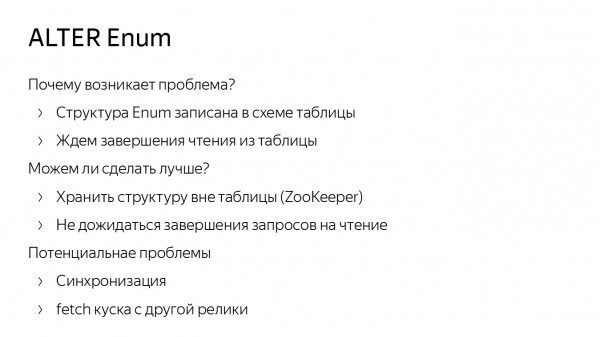
ALTER for Enum in ClickHouse is implemented optimally. We do not rewrite data on disk, but ALTER operations can be slow due to the fact that Enum structures are stored in the table’s schema. Therefore, we must wait for read requests from the table, for example.
This raises the question: can it be done better? Probably, yes. You could store the Enum structure not in the table schema, but in ZooKeeper. However, this could create synchronization issues. For instance, one replica may have received the data while another has not, and if it has an old Enum, something could break. (In ClickHouse, we have almost completed non-blocking ALTER queries. Once we finish them, there will be no need to wait for read requests.)
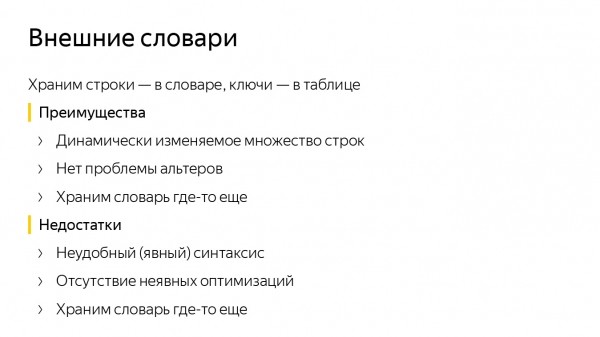
To avoid dealing with ALTER Enum, you can use ClickHouse external dictionaries. Recall that this is a key-value data structure within ClickHouse that allows you to retrieve data from external sources, such as MySQL tables.
In the ClickHouse dictionary, we store many different strings, while in the table, we store their identifiers as numbers. When we need to fetch a string, we call the dictGet function and work with it. After that, we don’t need to perform an ALTER operation. To add something to the Enum, we insert it into the same MySQL table.
However, this introduces other problems. First, there’s inconvenient syntax. If we want to get a string, we have to call dictGet. Second, there’s a lack of certain optimizations. Comparing with a constant string for dictionaries is not as fast.
There could also be issues with updates. Suppose we requested a string from the cache dictionary, but it didn’t get into the cache. Then we must wait for the data to load from the external source.
The overall disadvantage of both methods is that we store all keys in one place and synchronize them. So why not store dictionaries locally? No synchronization means no problems. You can store the dictionary locally in a chunk on disk. That is, we perform an Insert, write the dictionary. If we work with data in memory, we can store the dictionary either in a data block, or in a column chunk, or in some cache to speed up computations.
Dictionary encoding of strings
Thus, we have come to create a new data type in ClickHouse — LowCardinality. This is a data storage format: how it is written to disk, how it is read, how it is represented in memory, and the scheme of its processing.
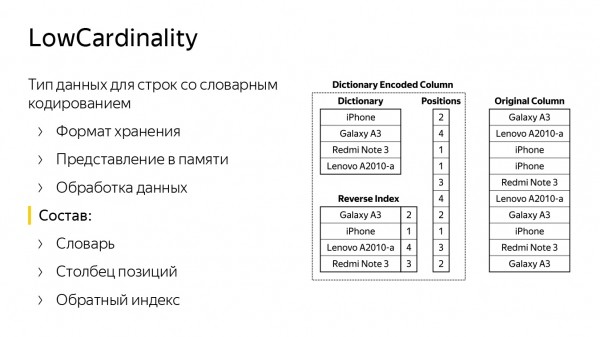
Lysbildet inneholder to kolonner. Til høyre lagres radene standardmessig, som Streng. Det er tydelig at dette er noen mobiltelefonmodeller. Til venstre er det en identisk kolonne, men i LowCardinality-type. Den består av et ordbok med mange forskjellige strenger (strengene fra kolonnen til høyre) og en liste med posisjoner (radnumre).
Med disse to strukturene kan man gjenskape den opprinnelige kolonnen. Det finnes også en omvendt omvendt indeks — en hash-tabell som hjelper med å finne posisjonen i ordboken basert på strengen. Den er nødvendig for å akselerere enkelte forespørseler. For eksempel, hvis vi ønsker å sammenligne, søke etter en streng i kolonnen vår eller slå dem sammen.
LowCardinality er en parameterisk datatype. Den kan være enten et tall, eller noe som lagres som et tall, eller en streng, eller Nullable av dem.
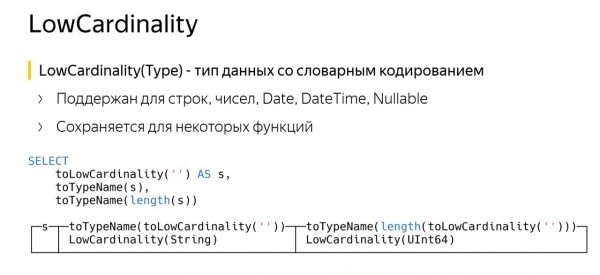
Spesialiteten til LowCardinality er at den kan lagres for enkelte funksjoner. På lysbildet vises et eksempel på en forespørsel. I den første linjen laget jeg en kolonne av LowCardinality av Streng, jeg kalte den S. Deretter spurte jeg om navnet, — ClickHouse sa at det var LowCardinality av Streng. Det stemmer.
Den tredje linjen er nesten lik, bare at vi kalte funksjonen length. I ClickHouse returnerer length-funksjonen datatypen UInt64. Men vi fikk LowCardinality av UInt64. Hva er meningen?
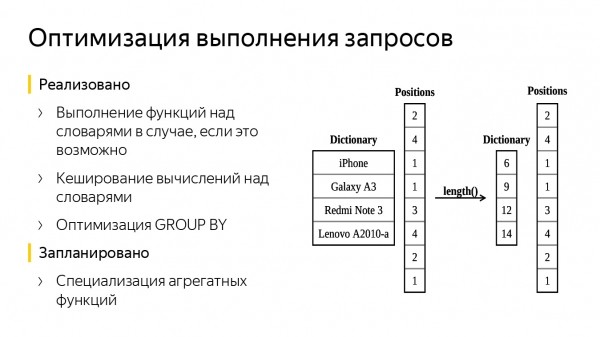
I ordboken ble navnene på mobiltelefonene lagret, vi brukte funksjonen length. Nå har vi fått en tilsvarende ordbok bestående bare av tall — dette er lengdene på strenger. Kolonnen med posisjoner forble uendret. I resultatet behandlet vi mindre data, sparte tid på forespørselen.
Det kan også være andre optimaliseringer, for eksempel ved å legge til en enkel cache. Når man beregner verdien av funksjonen, kan man huske den og lage en lignende uten å beregne på nytt.
Det kan også gjøres en optimalisering av GROUP BY, fordi kolonnen vår med ordboken allerede er delvis aggregert — det kan være raskere å beregne verdien av hash-funksjoner og omtrentlig finne bøttet der neste rad kan plasseres. Det er også mulig å spesialisere enkelte aggregeringsfunksjoner, for eksempel uniq, ettersom vi kun kan sende ordboken til den, mens posisjonene forblir urørt — slik vil alt fungere raskere. De første to optimaliseringene har vi allerede lagt til i ClickHouse.
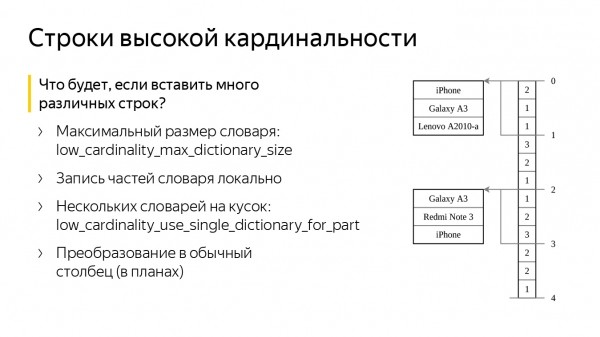
Hva om vi lager en kolonne med vår datatype og setter inn mange dårlige, forskjellige strenger? Vil ikke minnet vårt bli overfylt? Nei, for dette har ClickHouse to spesielle innstillinger. Den første er low_cardinality_max_dictionary_size. Dette er den maksimale størrelsen på et ordforråd som kan skrives til disk. Innsetting skjer slik: når vi setter inn data, får vi en strøm av strenger, og av dem danner vi et stort felles ordforråd. Hvis ordforrådet blir større enn innstillingsverdien, skriver vi det nåværende ordforrådet til disk, mens de andre strengene blir «liggende» ved siden av indeksene. Resultatet blir at vi aldri må gjenberegne et stort ordforråd og får ikke problemer med minnet.
Den andre innstillingen kalles low_cardinality_use_single_dictionary_for_part. Tenk deg at i det forrige scenariet, når vi satte inn data, ble ordforrådet vårt overfylt, og vi skrev det til disk. Spørsmålet oppstår, hvorfor ikke lage et annet nøyaktig likt ordforråd?
Når det blir overfylt, skriver vi det igjen til disk og begynner å danne et tredje. Denne innstillingen deaktiverer som standard denne muligheten.
Faktisk kan mange ordforråd være nyttige, hvis vi vil sette inn en viss mengde strenger, men tilfeldig har satt inn «søppel». Si at vi først satte inn dårlige strenger, og deretter satte inn gode. Da vil ordforrådet deles opp i mange små ordforråd. Noen av dem vil ha «søppel», men de siste vil ha gode strenger. Og hvis vi leser bare den siste granulen, vil alt også fungere raskt.
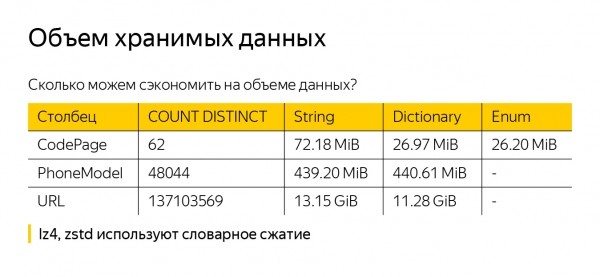
Før vi snakker om fordelene med LowCardinality, skal jeg straks si at vi neppe vil oppnå en reduksjon av dataene på disken (selv om det kan hende), fordi ClickHouse komprimerer dataene. Det er en standardmulighet — LZ4. Det er også mulig å gjøre komprimering med ZSTD. Men begge algoritmene implementerer allerede ordkomprimering, så vårt eksterne ordforråd i ClickHouse vil ikke være til stor hjelp.
For the sake of being concrete, I took some data from the metrics — String, LowCardinality(String), and Enum — and saved them in different data types. This resulted in three columns containing one billion rows. In the first column, CodePage, there are only 62 values. It's clear that LowCardinality(String) compresses them better. String is slightly worse, but that's likely due to the short strings; we store their lengths, which takes up a lot of space and compresses poorly.
Taking PhoneModel as an example, there are 48 thousand of them — already more, and the differences between String and LowCardinality(String) are negligible. We also saved just 2 GB for URLs — I think it’s not worth relying on.
Performance Evaluation
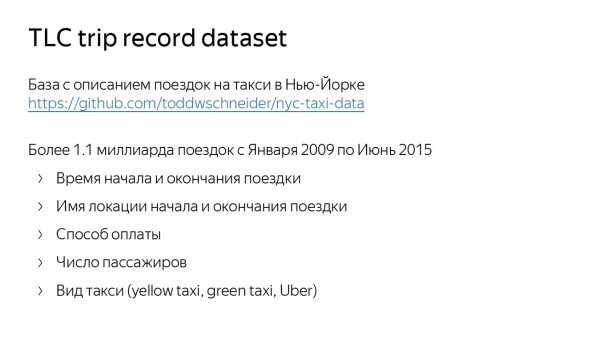
Now let’s evaluate the performance. To do this, I used a dataset describing taxi rides in New York. It’s on GitHub. It has just over a billion rides. It includes the location, start and end time of the ride, payment method, number of passengers, and even the type of taxi — green, yellow, or Uber.
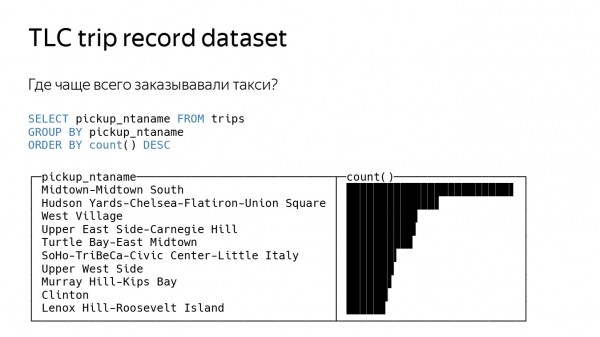
My first query was quite simple — I asked where taxis are most frequently ordered from. For this, we need to take the location from which the taxi was ordered, GROUP BY it, and count the function count. Here’s what ClickHouse outputs.
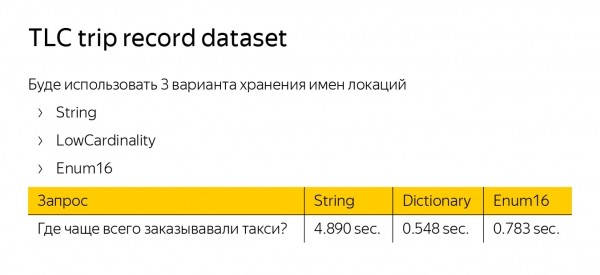
To measure the query processing speed, I created three tables with the same data, but I used three different data types for our starting location — String, LowCardinality, and Enum. LowCardinality and Enum turned out to be five times faster than String. Enum is faster because it works with numbers. LowCardinality is faster due to the GROUP BY optimization.
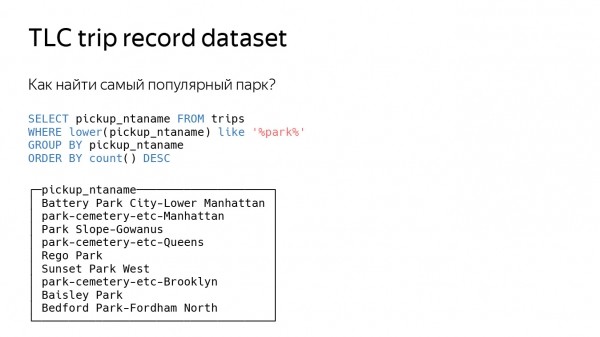
Let’s complicate the query a bit more — let’s ask where the most popular park in New York is located. Again, we will measure this by where taxis are most frequently ordered, but we will filter only those locations that contain the word “park.” We will also add the like function.
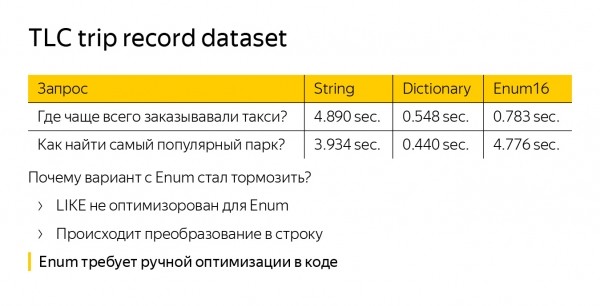
Looking at the time — we see that Enum suddenly started to lag. In fact, it works even slower than the standard data type String. This happens because the like function is not optimized for Enum at all. We have to convert our strings from Enum to regular strings — we’re doing more work. LowCardinality(String) is also not optimized by default, but there, like operates on the dictionary, so the query is accelerated compared to String.
Når vi arbeider med Enum, er det et mer overordnet problem. Hvis vi ønsker å optimalisere det, må vi gjøre det på hver eneste plass i koden. La oss si at vi har skrevet en ny funksjon – vi må absolutt finne en optimalisering for Enum. I LowCardinality er alt optimalisert som standard.
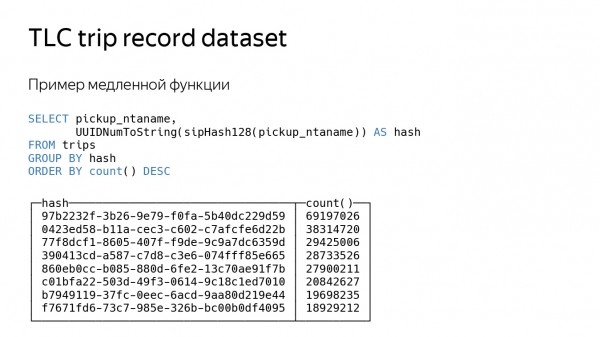
La oss se på den siste forespørselen, som er mer kunstig. Vi vil bare beregne hash-funksjonen for plasseringen vår. Hash-funksjonen er en ganske treig forespørsel som tar tid, så alt vil bli tre ganger langsommere.
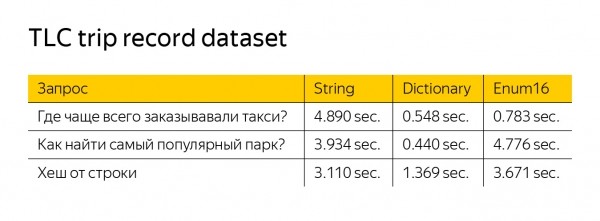
LowCardinality fungerer fortsatt raskere, selv om det ikke er noen filtrering her. Dette skjer fordi funksjonene våre kun arbeider med ordboken. Hash-beregningsfunksjonen har én parameter – den kan behandle mindre data og kan også returnere LowCardinality.
Vår globale plan er å oppnå en hastighet som ikke er lavere enn String i alle tilfeller, og å opprettholde forbedringer. Og kanskje en dag vil vi erstatte String med LowCardinality, du oppdaterer ClickHouse, og alt vil fungere litt raskere.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish