

Kanari — en liten fugl som synger konstant. Disse fuglene er sensitive for metan og karbonmonoksid. Selv fra en liten konsentrasjon av ekstra gasser i luften, mister de bevisstheten eller dør. Gullgravere og gruvearbeidere tok med seg fuglene: mens kanariene synger, kan man jobbe, hvis de stopper — betyr det at det er gass i gruven og det er på tide å forlate den. Gruvearbeidere ofret små fugler for å komme ut av gruvene i live.
En tilsvarende praksis har også funnet veien til IT. For eksempel i den standard oppgaven med å distribuere en ny versjon av en tjeneste eller applikasjon til produksjon etter å ha testet den. Testmiljøet kan være for kostbart, automatiserte tester dekker ikke alt man skulle ønske, og det er risikabelt å ikke teste og ofre kvaliteten. I slike tilfeller er Canary Deployment-tilnærmingen nyttig, hvor litt ekte produksjonstrafikk sendes til den nye versjonen. Denne tilnærmingen hjelper trygt å sjekke den nye versjonen i produksjon, og ofre lite for å oppnå et stort mål. Mer om hvordan denne tilnærmingen fungerer, hvilke fordeler den har og hvordan den kan implementeres, vil Andrey Markelov (), med et eksempel på implementering i selskapet Infobip.
Andrey Markelov — ledende programvareingeniør i Infobip, har jobbet med utvikling av applikasjoner i Java innen finans og telekommunikasjon i 11 år. Han utvikler Open Source-produkter, deltar aktivt i Atlassian Community og skriver plugins for Atlassians produkter. Evangelist for Prometheus, Docker og Redis.
Om Infobip
Dette er en global telekommunikasjonsplattform som lar banker, detaljhandlere, nettbutikker og transportselskaper sende meldinger til sine kunder via SMS, push, e-post og talebeskjeder. I denne bransjen er stabilitet og pålitelighet viktig, slik at kundene mottar meldingene i tide.
IT-infrastrukturen til Infobip i tall:
- 15 datasentre over hele verden;
- 500 unike tjenester i drift;
- 2500 instanser av tjenester, noe som er betydelig mer enn teamene;
- 4,5 TByte månedlig trafikk;
- 4,5 milliarder telefonnumre;
Bedriften vokser, og det samme gjør antall utgivelser. Vi gjennomfører omtrent 60 utgivelser om dagen, fordi kundene ønsker flere muligheter og kapasitet. Men det er komplisert — det er mange tjenester, men få team. Man må raskt skrive kode som må fungere i produksjon uten feil.
Utgivelser
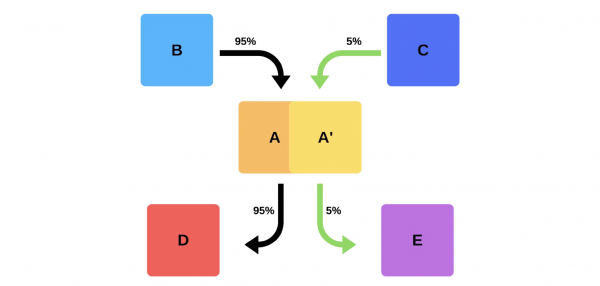
En typisk release hos oss går til slik. For eksempel, det finnes tjenester A, B, C, D og E, hver av dem utvikles av et eget team.
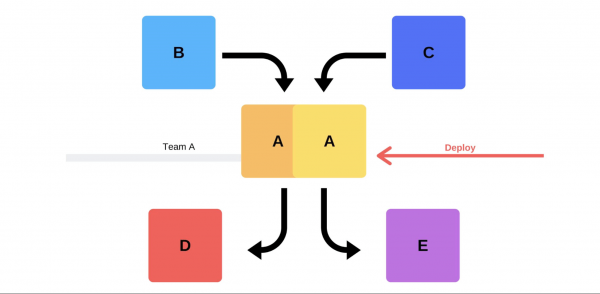
På et tidspunkt bestemmer teamet for tjeneste A seg for å deployere en ny versjon, men teamene for tjenestene B, C, D og E vet ingenting om dette. Teamet for tjeneste A har to alternativer.
De vil utføre en inkrementell release: de vil først erstatte én versjon, og så den andre.
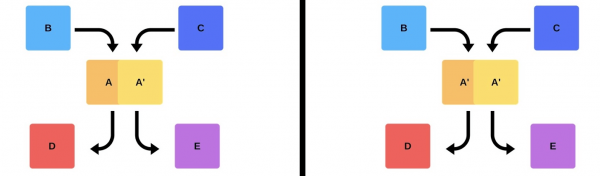
Men det finnes et annet alternativ: teamet finner ekstra ressurser og maskiner, deployerer den nye versjonen, og så bytter de ruteren, og versjonen begynner å fungere i produksjon.
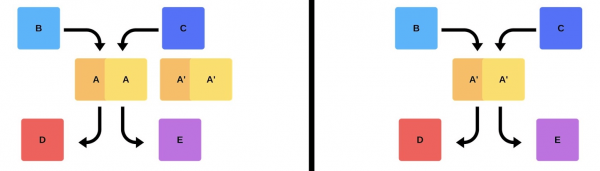
Uansett hvilket alternativ som velges, oppstår det nesten alltid problemer etter deployeringen, selv om versjonen er testet. Testing kan gjøres manuelt, automatisk, eller man kan unngå testing — problemer vil oppstå uansett. Den enkleste og mest riktige måten å løse dem på, er å rulle tilbake til den arbeidende versjonen. Først etterpå kan man begynne å se på skadene, årsakene og rette opp i dem.
Så, hva ønsker vi?
Vi trenger ikke problemer. Hvis kundene oppdager dem raskere enn oss, vil det skade omdømmet vårt. Derfor må vi oppdage problemer raskere enn kundene. Ved å arbeide proaktivt, minimerer vi skadene.
Samtidig ønsker vi å fremskynde deployeringen, så det skjer raskt, enkelt, av seg selv og uten stress for teamet. Ingeniører, DevOps-ingeniører og programmerere må ivaretas — en ny versjon av programvaren er stressende. Teamet er ikke et forbruksmateriell, vi streber etter å utnytte menneskelige ressurser på en fornuftig måte..
Problemer med deployering
Kundetrafikk er uforutsigbar. Det er umulig å forutsi når kundetrafikken vil være minimal. Vi vet ikke når og hvor kundene starter sine kampanjer — kanskje i natt i India, og i morgen i Hongkong. Med store tidsforskjeller, gir ikke en deployering kl 02:00 noen garantier for at kundene ikke vil lide.
Problemer med leverandører. Meldingsplattformer og leverandører er våre partnere. Av og til opplever de nedetid, noe som kan forårsake feil under deployeringen av nye versjoner.
Fordelte team. Teamene som utvikler klientdelen og backend, befinner seg i ulike tidssoner. På grunn av dette kan de ofte ikke bli enige med hverandre.
Datasentre kan ikke replikeres i staging. Ett datasenter har 200 stativer — å gjenskape dette i en sandkasse kan selv ikke gjøres omtrent.
Nedetiderer uakseptable! Vi har et akseptabelt tilgjengelighetsnivå (Error Budget), hvor vi jobber 99,99% av tiden, for eksempel, og de gjenværende prosentene er vårt «feilrett», å oppnå 100% pålitelighet er umulig, men det er viktig å kontinuerlig overvåke nedetider og driftsstans.
Klassiske løsningsalternativer
Å skrive kode uten feil. Da jeg var en ung utvikler, kom ledere til meg og ba om å levere uten feil, men det er ikke alltid mulig.
Å skrive tester. Tester fungerer, men ikke alltid slik virksomheten ønsker. Å tjene penger er ikke testenes oppgave.
Å teste på staging. I løpet av mine 3,5 år i Infobip har jeg aldri sett at staging-tilstanden er i det minste delvis lik produksjon.
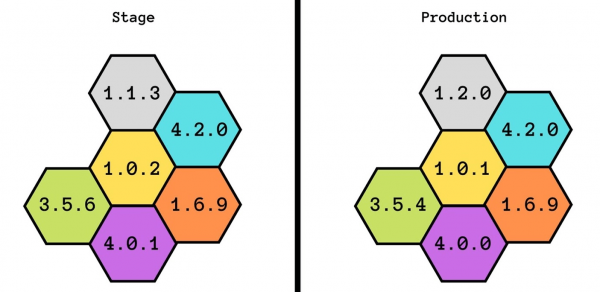
Vi forsøkte til og med å utvikle denne ideen: først hadde vi staging, så pre-produksjon, og deretter pre-pre-produksjon. Men det hjalp ikke — de samsvarte ikke engang i kapasitet. Med staging kan vi garantere grunnleggende funksjonalitet, men vi vet ikke hvordan den vil oppføre seg under belastning.
Utgivelsen gjøres av den som utviklet. Dette er en god praksis: selv om noen endrer navnet på kommentaren, legges det umiddelbart til i produksjon. Dette hjelper til med å utvikle ansvarlighet og ikke glemme endringene som er gjort.
Det er også ytterligere komplikasjoner. For utvikleren er det stressende å bruke mye tid på å sjekke alt manuelt.
Koordinerte utgivelser. Denne løsningen tilbys vanligvis av ledelsen: «La oss bli enige om at dere tester og legger til nye versjoner hver dag». Det fungerer ikke: det er alltid et team som venter på alle de andre, eller omvendt.
Smoke-tester
En annen måte å løse våre utplasseringsproblemer på. La oss se hvordan smoke-tester fungerer i det forrige eksempelet, når team A ønsker å deployere en ny versjon.
Først deployer teamet én instans til produksjon. Beskjeder i instansen fra mockene simulerer reell trafikk, slik at den samsvarer med den normale daglige trafikken. Hvis alt ser bra ut, bytter teamet den nye versjonen til brukertrafikk.
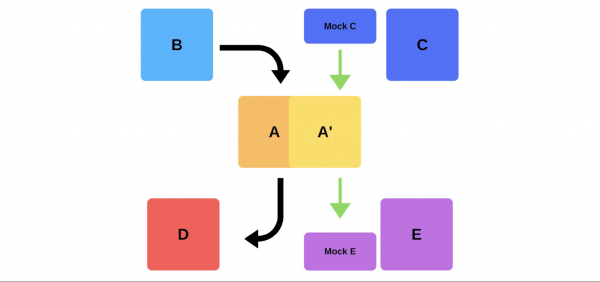
Den andre muligheten er å deployere med ekstra maskinvare. Teamet tester det på produksjon, så bytter de, og alt fungerer.
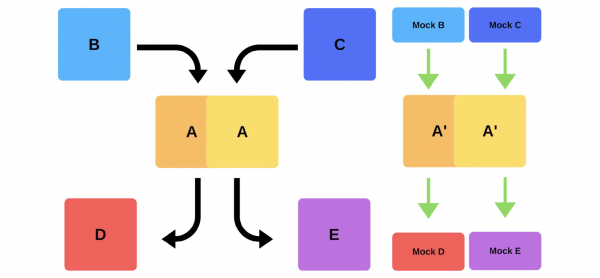
Ulemper med smoke-tester:
- Man kan ikke stole på tester. Hvor kan man få den samme trafikken som i produksjon? Man kan bruke trafikk fra i går eller fra forrige uke, men den samsvarer ikke alltid med den nåværende.
- Vanskelig å opprettholde. Man må vedlikeholde testkontoer, og stadig tilbakestille dem før hver distribusjon når aktive poster blir sendt til lagringen. Dette er mer komplisert enn å skrive tester i sin egen sandkasse.
Den eneste fordelen her er man kan sjekke ytelsen.
Canary-utgivelser
På grunn av manglene ved smoke-tester begynte vi å bruke canary-utgivelser.
Praksisen, lik den hvordan gruvearbeidere brukte kanarifugler for å indikere gassnivåer, har også funnet sin plass i IT. Vi sender litt ekte produksjonstrafikk til den nye versjonen, samtidig som vi prøver å holde oss innenfor Service Level Agreement (SLA). SLA er vår "feilmargin" som vi kan bruke en gang i året (eller i en annen tidsperiode). Hvis alt går bra, slipper vi ut mer trafikk. Hvis ikke – går vi tilbake til tidligere versjoner.
Implementering og detaljer
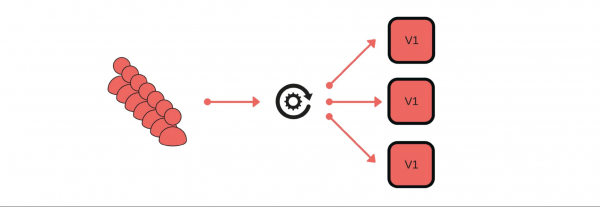
Hvordan implementerte vi canary-utgivelser? For eksempel, en gruppe kunder sender meldinger gjennom vår tjeneste.
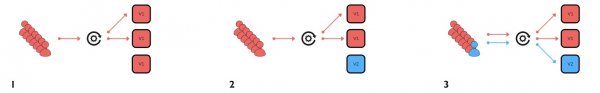
Distribusjonen skjer slik: vi fjerner en node fra lastbalansereren (1), endrer versjonen (2) og sender deretter ut litt trafikk (3).
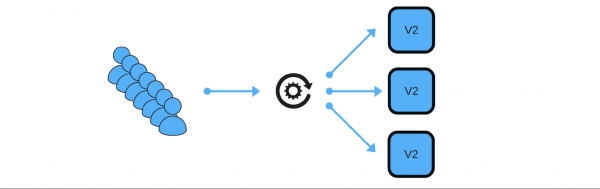
Generelt vil alle i gruppen være glade, selv om en bruker er misfornøyd. Hvis alt går bra – oppdaterer vi alle versjonene.
Jeg vil vise skjematisk hvordan dette ser ut for mikrotjenester i de fleste tilfeller.
Det er Service Discovery og to andre tjenester: S1N1 og S2. Den første tjenesten (S1N1) varsler Service Discovery når den starter, og Service Discovery lagrer den. Den andre tjenesten med to noder (S2N1 og S2N2) varsler også Service Discovery når den starter.
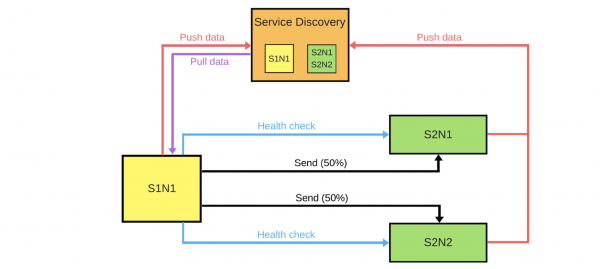
Den andre tjenesten fungerer som server for den første. Den første spør Service Discovery om informasjon om sine servere, og når den får det, leter den etter og sjekker dem ("helse-sjekk"). Når den har sjekket, sender den meldinger til dem.
Når noen vil utbre den nye versjonen av den andre tjenesten, varsler de Service Discovery om at den andre noden vil være canary-node: den vil motta mindre trafikk fordi det skal skje en distribusjon nå. Vi fjerner canary-noden fra lastbalansereren, og den første tjenesten sender ikke trafikk til den.
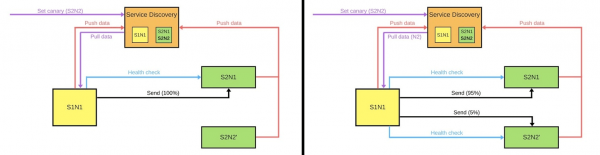
Vi endrer versjonen, og Service Discovery vet at den andre noden nå er canary — vi kan gi den mindre belastning (5%). Hvis alt går bra, endrer vi versjonen, gjenoppretter belastningen og fortsetter videre.
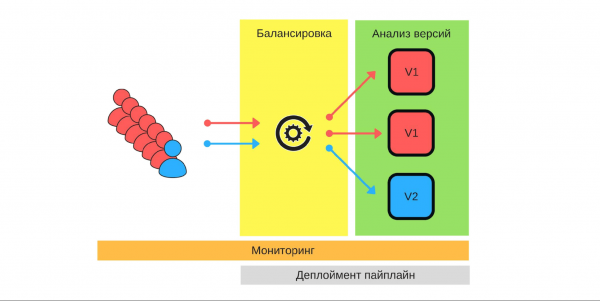
For å realisere alt dette trenger vi:
- lastbalansering;
- overvåking, da det er viktig å vite hva hver bruker forventer, og hvordan våre tjenester fungerer i detalj;
- versjonsanalyse, for å forstå hvor godt den nye versjonen vil fungere i produksjon;
- automatisering — vi skriver oppsettet for distribusjon (deployment pipeline).
Belastningsbalansering
Dette er det første vi må tenke på. Det finnes to balanseringsstrategier.
Den enkleste varianten, når en node alltid er canary. Denne noden får alltid mindre trafikk, og vi begynner distribusjonen med den. Ved problemer kan vi sammenligne ytelsen før og under distribusjonen. For eksempel, hvis feilene har doblet seg, har også skaden økt med det samme.
Canary-noden defineres under distribusjonen. Når distribusjonen er fullført og vi fjerner canary-statusen fra den, gjenopprettes trafikbalansen. Med færre maskiner får vi en rettferdig fordeling.
Overvåkning
Grunnlaget for canary-utgivelser. Vi må tydelig forstå hvorfor vi gjør dette, og hvilke metrikker vi ønsker å samle inn.
Eksempler på metrikker vi samler inn fra våre tjenester.
- Antall feil, som skrives til loggene. Dette er et åpenbart mål på at alt fungerer som det skal. Generelt er dette en god metrikk.
- Tidsbruk for forespørslene (latency). Denne metrikken overvåkes av alle, fordi alle ønsker å jobbe raskt.
- Køstørrelse (throughput).
- Antallet vellykkede svar per sekund.
- Tiden det tar å håndtere 95% av alle forespørslene.
- Forretningsmetrikker: hvor mye penger virksomheten tjener over en viss periode eller kundeavgang. Disse metrikker kan være viktigere for vår nye versjon enn de som ingeniører legger til.
Eksempler på metrikker i de mest populære overvåkningssystemene.
Teller. Dette er en økende størrelse, for eksempel antall feil. Denne metrikken er enkel å interpolere og studere kurven: i går var det 2 feil, og i dag 500, så noe har gått galt.
Antallet feil per minutt eller per sekund, er den viktigste indikatoren som kan beregnes ved hjelp av Teller. Disse dataene gir et klart bilde av systemets ytelse over tid. La oss vurdere et eksempel på kurven for antall feil per sekund for to versjoner av produksjonssystemet.
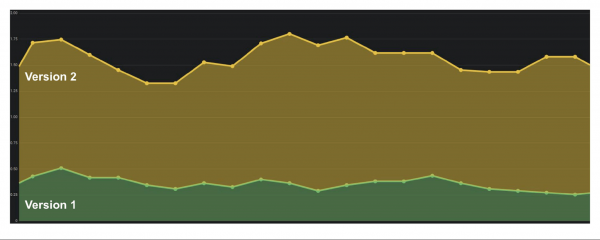
I den første versjonen var det få feil, muligens fungerte ikke revisjonen. I den andre versjonen er alt mye verre. Man kan helt klart si at det er problemer, så vi må rulle tilbake denne versjonen.
Gauge. Metrikker ligner på Counter, men vi registrerer verdier som både kan øke og minke. For eksempel, tiden for forespørselene eller størrelsen på køen.
På diagrammet er et eksempel på responstid (latency). Diagrammet viser at versjonene ligner, og de kan brukes. Men hvis man ser nærmere etter, er det tydelig hvordan størrelsen endres. Hvis tiden for forespørslene øker når man legger til brukere, er det klart at det er problemer — slik var det ikke før.
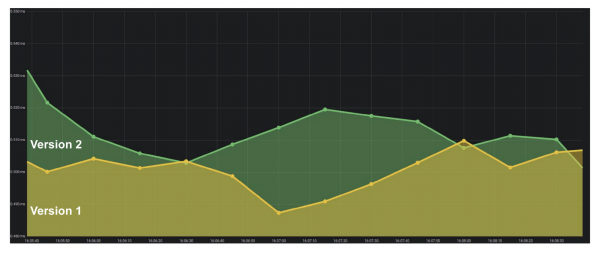
Summary. En av de viktigste indikatorene for virksomheten er percentilene. Målingen viser at i 95% av tilfellene fungerer systemet vårt slik vi ønsker. Vi kan akseptere at det er problemer et sted, fordi vi forstår den generelle trenden, hvor bra eller dårlig alt står til.
Tools
ELK Stack. For å implementere canary kan man bruke Elasticsearch — vi registrerer feil der når hendelser skjer. Med et enkelt API-kall kan man hente antall feil når som helst og sammenligne med tidligere perioder: GET /applg/_cunt?q=level:errr.
Prometheus. Har fungert godt i Infobip. Den lar deg implementere flerdimensjonale metrikker, fordi det brukes labeler.
Vi kan bruke nivå, instance, tjeneste, kombinere dem i ett system. Med offset kan man for eksempel se verdien av størrelsen for en uke siden med bare én kommando GET /api/v1/query?query={query}, hvor {query}:
rate(logback_appender_total{
    level="error",
    instance=~"$instance"
}[5m] offset $offset_value)
Versjon analyse
Det finnes flere strategier for versjonsanalyse.
Se på metrikker bare fra canary-noden. En av de enkleste alternativene: vi har deployert en ny versjon og studerer bare ytelsen. Men hvis ingeniøren i løpet av dette begynner å undersøke loggene, stadig nervøst oppdaterer sidene, da er ikke denne løsningen forskjellig fra de andre.
Canary-noden sammenlignes med enhver annen node. Dette er en sammenligning med andre instanser som kjører med full trafikk. For eksempel, hvis det er verre, eller ikke bedre, med liten trafikk enn på de virkelige instansene, så er noe galt.
Canary-noden sammenlignes med seg selv fra fortiden. Noder som er tildelt for canary kan sammenlignes med historiske data. For eksempel, hvis alt var bra for en uke siden, kan vi bruke disse dataene for å forstå den nåværende situasjonen.
Automatisering
Vi ønsker å frigjøre ingeniørene fra manuell sammenligning, så det er viktig å implementere automatisering. Utrullingsprosessen (deployment pipeline) ser vanligvis slik ut:
- vi starter;
- fjerner noden fra balanseføreren;
- setter canary-noden;
- aktiverer balanseføreren med begrenset trafikk;
- sammenligner.
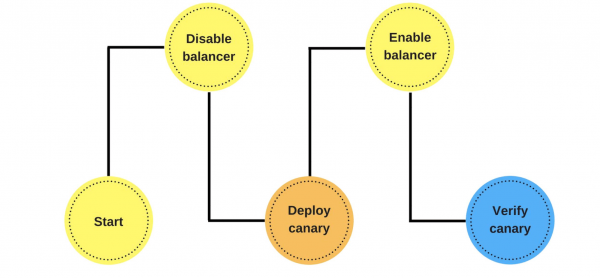
I dette trinnet implementerer vi automatisk sammenligning. Hvordan det kan se ut og hvorfor det er bedre enn manuell sjekk etter utrulling, vil vi se på et eksempel fra Jenkins.
Dette er en pipeline til Groovy.
while (System.currentTimeMillis() < endCanaryTs) {
    def isOk = compare(srv, canary, time, base, offset, metrics)
    if (isOk) {
        sleep DEFAULT SLEEP
    }   else {
        echo "Canary feilet, må tilbakestille"
        return false
    }
}
Her i løkken setter vi at vi vil sammenligne den nye noden i løpet av en time. Hvis canary-prosessen ikke er fullført, kaller vi funksjonen. Den forteller om alt er i orden eller ikke: def isOk = compare(srv, canary, time, base, offset, metrics).
Hvis alt er i orden — sleep DEFAULT SLEEP, for eksempel i ett sekund, og fortsetter. Hvis ikke, går vi ut — utrullingen mislykkes.
Beskrivelse av metrikken. La oss se hvordan funksjonen compare kan se ut i et DSL-eksempel.
metric(
    'errorCounts',
    'rate(errorCounts{node=~"$canaryInst"}[5m] offset $offset)',
    {   baseValue, canaryValue ->
        if (canaryValue > baseValue * 1.3) return false
        return true
    }
)
La oss anta at vi sammenligner antall feil og vil vite antallet feil per sekund de siste 5 minuttene.
Vi har to verdier: den grunnleggende og canary-noden. Verdien for canary-noden er den nåværende. Den grunnleggende er baseValue — dette er verdien av enhver annen non-canary node. Vi sammenligner verdiene mot hverandre etter formelen vi har basert på vår erfaring og observasjoner. Hvis verdien canaryValue er dårlig, så mislykkes utrullingen, og vi ruller tilbake.
Hvorfor er dette alt nødvendig?
Et menneske kan ikke sjekke hundrevis og tusenvis av metrikker, spesielt ikke gjøre det raskt. Automatisk sammenligning hjelper til med å kontrollere alle metrikker og varsler raskt om problemer. Tid til varsling er kritisk: hvis noe har skjedd de siste 2 sekundene, vil skaden ikke være så stor som hvis det skjedde for 15 minutter siden. Mens noen merker problemet, sender en melding til support, og mens support kontakter oss for å tilbakestille, kan vi miste kunder.
Hvis prosessen gikk bra, distribuerer vi automatisk alle de andre nodene. I mellomtiden gjør ingeniørene ingenting. Først når de starter canary, bestemmer de hvilke metrikker de skal ta, hvor lenge sammenligningen skal vare, og hvilken strategi som skal brukes.
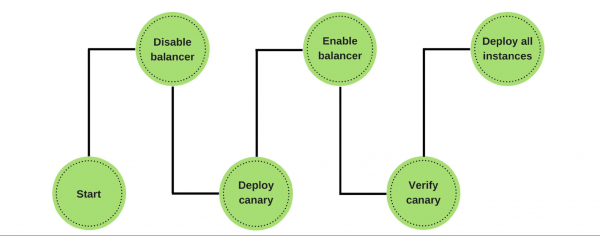
Hvis det oppstår problemer – ruller vi automatisk tilbake canary-noden, jobber med tidligere versjoner og fikser feilene vi har funnet. Med metrikker er det lett å finne og se skaden fra den nye versjonen.
Hindringer
Å implementere dette er selvfølgelig ikke enkelt. Først og fremst trenger vi et felles overvåkingssystem. Ingeniørene har sine egne metrikker, support og analytikere har andre, og forretningssiden har tredje. Et felles system er et felles språk som virksomhet og utvikling snakker.
Vi må teste i praksis stabiliteten til metrikker. Testing hjelper oss å forstå, hva det minste antallet metrikker er for å sikre kvalitet.
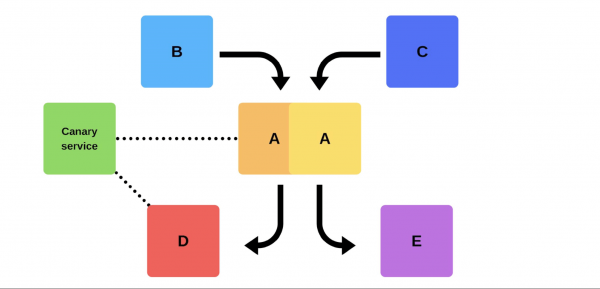
Hvordan oppnå dette? Bruke canary-tjenesten ikke i distribusjonsøyeblikket. Vi legger til en eller annen tjeneste på den gamle versjonen som når som helst kan ta hvilken som helst dedikert node, redusere trafikken uten distribusjon. Deretter sammenligner vi: vi studerer feilene og ser etter den grensen der vi oppnår kvalitet.
Hvilken nytte har vi fått fra canary-utgivelser
Vi har minimert prosentandelen skade fra feil. De fleste distribusjonsfeil skjer på grunn av inkonsistens i data eller prioriteringer. Slike feil har blitt mye færre fordi vi kan løse problemet i løpet av de første sekundene.
Vi har optimalisert teamenes arbeid. Nykommere har et 'rett til feil': de kan distribuere til produksjon uten frykt for å gjøre feil, noe som gir dem ekstra initiativ og motivasjon til å jobbe. Hvis de ødelegger noe, vil det ikke være kritisk, og den som feilet, vil ikke bli sagt opp.
Vi har automatisert distribusjonen. Dette er ikke lenger en manuell prosess som før, men en ekte automatisert prosess. Men den tar lengre tid.
Vi har identifisert viktige metrikker. Hele selskapet, fra virksomheten til ingeniørene, forstår hva som virkelig er viktig i produktet vårt, hvilke metrikker, for eksempel kundeavgang og tilstrømning. Vi kontrollerer prosessen: tester metrikker, introduserer nye, ser hvordan de gamle fungerer, for å bygge et system som vil tjene penger mer effektivt.
Vi har mange flotte praksiser og systemer som hjelper oss. Likevel streber vi etter å være profesjonelle og gjøre jobben vår på en kvalitetsmessig måte, uansett om vi har et system som kan hjelpe oss eller ikke.
Ingeniørmetoder og praksiser — . Hvis du har oppnådd suksess på veien mot teknisk dyktighet og er klar til å dele hva som har hjulpet deg, — .
Vi planlegger å gjennomføre 8. juni. Vi forstår at det er vanskelig å ta beslutninger om deltagelse på konferansen nå. Men samtidig mener vi at karantenen ikke er en grunn til å stoppe profesjonell kommunikasjon og utvikling. Derfor vil vi på en eller annen måte finne en måte å diskutere tech-lederens utfordringer og tilnærminger til å løse dem — om nødvendig går vi online og setter opp nettverking der!
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish