

I dag skal vi snakke om en interessant teknologi implementert i lagringssystemet Unity/Unity XT – FAST VP. Hvis du hører om Unity for første gang, finner du en lenke til systemspesifikasjonene på slutten av artikkelen. I prosjektteamet hos Dell EMC har jeg jobbet med FAST VP i over ett år. I dag vil jeg fortelle mer om denne teknologien og avdekke noen detaljer om implementeringen. Selvfølgelig bare de detaljene som kan deles. Hvis du er interessert i effektive datalagringsmetoder, eller hvis du ikke er helt sikker på dokumentasjonen, vil denne artikkelen garantert være nyttig og interessant.
La meg straks si hva dette materialet ikke vil inneholde. Det vil ikke være noen søk etter konkurrenter eller sammenligning med dem. Jeg planlegger heller ikke å diskutere lignende teknologier fra open source, fordi nysgjerrige lesere allerede vet om dem. Og selvfølgelig har jeg ikke tenkt å reklamere for noe.
Lagringstiering. Mål og oppgaver for FAST VP
FAST VP står for Fully Automated Storage Tiering for Virtual Pool. Litt komplisert? Ingen fare, vi skal gå gjennom det. Tiering er en metode for datalagring der det finnes flere nivåer (tiers) hvor dataene lagres. Hvert nivå har sine egne egenskaper. De viktigste er: ytelse, volum og pris for lagring av informasjon. Selvfølgelig er det en sammenheng mellom dem.
En viktig egenskap ved tiering er at tilgangen til dataene er ensartet, uavhengig av hvilket lagringsnivå de befinner seg på, og størrelsen på lageret er lik summen av størrelsene til ressursene som inngår i det. Her ligger forskjellene fra cache: størrelsen på cachen legges ikke til den totale størrelsen på ressursen (lageret i dette tilfellet), og cachedataene dupliserer et fragment av dataene på hovedmediet (eller vil duplisere det hvis dataene fra cachen ennå ikke er lagret). Fordelingen av data på nivåene er også skjult for brukeren. Det vil si at han ikke ser hvilke data som ligger på hvert nivå, selv om han kan påvirke dette indirekte ved å angi politikker (om dem senere).
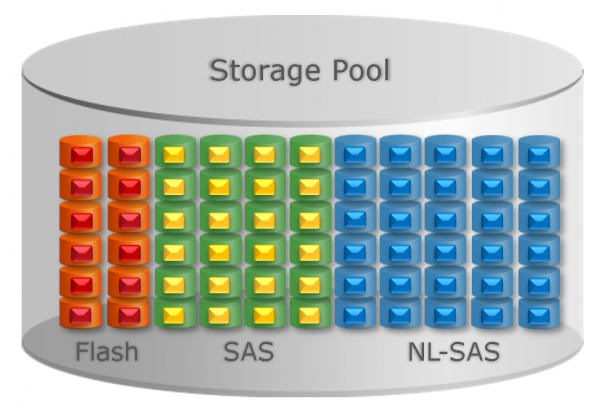
La oss nå se på funksjonene ved implementeringen av lagringstiering i Unity. I Unity skilles det mellom 3 nivåer eller tiers:
- Ekstrem ytelse (SSD-er)
- Ytelse (SAS HDD 10k/15k RPM)
- Lagringskapasitet (NL-SAS HDD 7200 RPM)
De er listet i synkende rekkefølge etter ytelse og pris. I Extreme performance inngår utelukkende solid state-disker (SSD). De to andre nivåene har magnetiske lagringsmedier, som skiller seg i rotasjonshastighet og dermed ytelse.
Informasjonsbærere fra ett nivå og én størrelse kombineres i et RAID-array, som danner en RAID-gruppe (RAID group, forkortet – RG); du kan lese om tilgjengelige og anbefalte RAID-nivåer i den offisielle dokumentasjonen. Fra RAID-grupper av ett eller flere nivåer dannes lagringspuljer (Storage pool), deretter distribueres den ledige plassen. Fra puljen tildeles plass til filsystemer og LUN-er.
Hvorfor trenger jeg tiering?
Kort og abstrakt: for å oppnå et bedre resultat ved å bruke minimum ressurser. Mer konkret, omtales resultatet vanligvis som en samling egenskaper ved lagringssystemet – hastighet og tilgangstid, lagringskostnad og så videre. Minimum ressurser refererer til de laveste kostnadene: penger, energi, osv. FAST VP implementerer nettopp mekanismer for omfordeling av data på ulike nivåer i Unity/Unity XT-lagringssystemet. Hvis du vil, kan du hoppe over neste avsnitt. For de andre vil jeg forklare litt mer.
Riktig omfordeling av data på lagringsnivåer lar deg spare på de totale kostnadene ved lagringssystemet, ved å ofre tilgangshastigheten til noe sjeldent brukt informasjon, og øke ytelsen ved å flytte ofte brukte data til raskere medier. Her kan noen innvende at selv uten tiering vet en god administrator hvor ulike data skal plasseres, hvilke ønskelige egenskaper lagringssystemet bør ha for oppgaven, osv. Uten tvil er dette sant, men manuell fordeling av data har sine ulemper:
- det krever tid og oppmerksomhet fra administratoren;
- det er ikke alltid mulig å "tilpasse" ressursene i lagringssystemet til endrede forhold;
- et viktig fordel forsvinner: enhetlig tilgang til ressurser som er på ulike lagringsnivåer.
For storage admins to worry less about job security, I will add that proper resource planning is essential here as well. Now that the tasks of tiering have been briefly outlined, let's look at what can be expected from FAST VP. Now is the perfect time to return to the definition. The first two words – Fully Automated – translate literally to "full automation" and mean that tier distribution occurs automatically. And Virtual Pool refers to a data pool that includes resources from different storage levels. Here's how it looks:
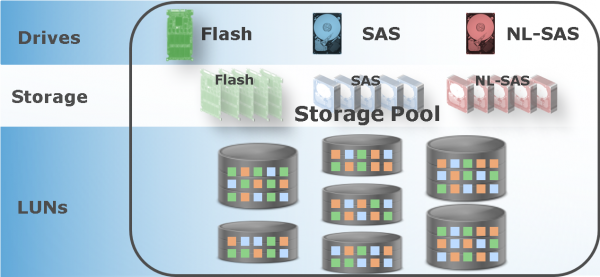
To jump ahead, I will say that FAST VP only moves data within a single pool, not between multiple pools.
Tasks solved by FAST VP
Let's start with a general discussion. We have a pool and some mechanism that can redistribute data within that pool. Keeping in mind that our goal is to achieve maximum performance, let's ask the question: How can this be achieved? There may be several ways, and FAST VP has much to offer users, as the technology represents something more than just storage tiering. Here are ways FAST VP can enhance the performance of the pool:
- Data distribution across different types of disks and levels
- Data distribution among disks of the same type
- Data distribution during pool expansion
Before we delve into how these tasks are addressed, we need to know some necessary facts about how FAST VP works. FAST VP operates with blocks of a specific size – 256 megabytes. This is the minimum continuous "chunk" of data that can be moved. In the documentation, it is referred to as a slice. From the perspective of FAST VP, all RAID groups consist of a set of such "chunks." Accordingly, all input-output statistics are accumulated for such data blocks. Why is this particular block size chosen, and will it be reduced? The block is large enough, but this is a compromise between data granularity (smaller block size – more precise distribution) and the available computational resources: with existing strict memory limitations and a large number of blocks, data statistics can take up too much space, and the number of calculations will increase proportionally.
How FAST VP places data in the pool. Policies
For managing data placement in a pool with FAST VP enabled, there are the following policies:
- Høyest tilgjengelig nivå
- Auto-nivå
- Start høy så auto-nivå (standard)
- Lavest tilgjengelig nivå
De påvirker både den opprinnelige plasseringen av blokken (data skrevet for første gang) og den påfølgende omfordelingen. Når dataene først er plassert på diskene, vil omfordelingen bli initiert etter timeplan eller manuelt.
Highest Available Tier prøver å plassere en ny blokk på det mest ytelsesorienterte nivået. Hvis det ikke er nok plass på det nivået, går den til neste beste ytelse, men dataene kan deretter flyttes til et mer ytelsesorientert nivå (når det er plass, eller ved å fortrenge andre data). Auto-Tier plasserer nye data på forskjellige nivåer avhengig av størrelsen på tilgjengelig plass, og de omfordeles basert på etterspørselen og ledig plass. Start High then Auto-Tier er standardpolitikken og også den anbefalte. Ved den opprinnelige plasseringen fungerer den som Highest Available Tier, og deretter skjer flyttingen av dataene basert på bruksstatistikken. Politikken Lowest Available Tier prøver å plassere dataene på det minst ytelsesorienterte nivået.
Dataflytting skjer med lav prioritet for å ikke forstyrre den nyttige driften av lagringssystemet, men det er en innstilling kalt «Data relocation rate» som endrer prioriteten. Det er en spesiell egenskap her: ikke alle datablokker har samme prioritet for omfordeling. For eksempel vil blokker som er merket som metadata, bli flyttet til et raskere nivå først. Metadata er i så måte 'data om data', en slags tilleggsinformasjon som ikke er brukerdata, men som lagrer beskrivelsen deres. For eksempel informasjon i filsystemet om hvilken blokk en bestemt fil befinner seg i. Det betyr at tilgangen til data avhenger av tilgangen til metadata. Gitt at metadata vanligvis er mye mindre i størrelse, er gevinsten fra deres flytting til mer ytelsesorienterte disker forventet å være større.
Kriteriene som Fast VP bruker i sitt arbeid
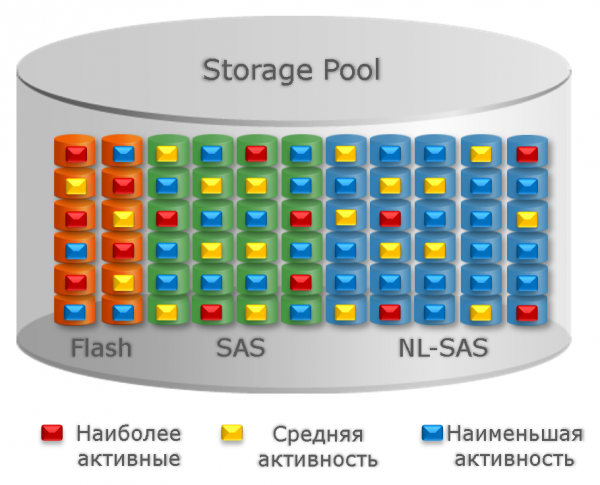
Hovudkriteriet for hver blokk, om vi skal være veldig grove, er karakteristikken for «etterspørselen» etter data, som avhenger av antall lese- og skriveoperasjoner for datadelen. Denne karakteristikken kaller vi «Temperatur». Det finnes etterspurte (hot) data som er «varmere» enn ikke-etterspurte. Den beregnes periodisk, som standard med et intervall på én time.
Funksjonen for å beregne temperatur har følgende egenskaper:
- Når det ikke er noe inn- eller utdata, «kjøler» dataene over tid.
- Ved mer eller mindre jevn belastning over tid, stiger temperaturen først og stabiliseres deretter innenfor et visst område.
Deretter tas politikker omtalt ovenfor, samt ledig plass på hvert nivå, i betraktning. For å illustrere dette, vil jeg bringe opp et bilde fra dokumentasjonen. Her er blokkene med høy, medium og lav temperatur merket med rødt, gult og blått henholdsvis.
Men la oss gå tilbake til oppgavene. Så, vi kan begynne å se på hva som gjøres for å løse oppgavene til FAST VP.
A. Fordeling av data på forskjellige typer disker, nivåer
Dette er faktisk hovedoppgaven til FAST VP. De andre er på en eller annen måte avledet fra den. Avhengig av valgt politikk, vil dataene bli fordelt på forskjellige lagringsnivåer. Først og fremst vurderes plasseringPolitikk, deretter blokktemperatur og størrelse/hastighet på RAID-gruppene.
For politikkene Høyeste/Laveste Tilgjengelige Nivå er det ganske enkelt. For de to andre er saken slik. Dataene fordeles på forskjellige nivåer med hensyn til størrelse og ytelse på RAID-gruppene: slik at forholdet mellom den samlede blokkens «temperatur» og den «tevære maksimale ytelsen» til hver RAID-gruppe er omtrent lik. Dermed fordeles belastningen mer eller mindre jevnt. Mer etterspurte data flyttes til raske lagringsenheter, sjeldent brukte til langsommere. Ideelt sett skal fordelingen bli omtrent slik:
B. Fordeling av data mellom disker av samme type
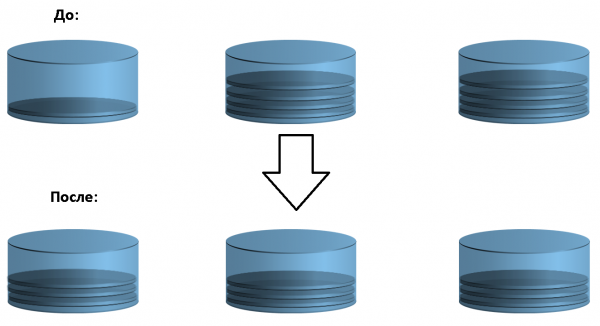
Husker du, i begynnelsen nevnte jeg at lagringsmediene fra ett eller flere blokk nivåer blir slått sammen til en pool? I tilegg til det enkelt nivået for FAST VP, er det også arbeid. For at ytelsen til et nivå skal være maksimal, er det ønskelig å fordele data jevnt mellom diskene. Dette vil (teoretisk) gi maksimal IOPS. Dataene inne i RAID-gruppen kan anses å være jevnt fordelt på diskene, men mellom RAID-grupper er det langt fra alltid slik. Ved ubalanse vil FAST VP flytte data mellom RAID-gruppene proporsjonalt med deres volum og «betinget ytelse» (i numerisk uttrykk). For å illustrere, vil jeg vise et rebalanseringsskjema mellom tre RAID-grupper:
B. Fordeling av data ved utvidelse av pool
Denne oppgaven er et spesialtilfelle av den forrige og utføres når en RAID-gruppe legges til i poolen. For at den nylig tillagte RAID-gruppen ikke skal være inaktiv, vil en del av dataene bli flyttet til den, og dermed vil belastningen fordeles om på alle RAID-gruppene.
Ubalansert slitasje av SSD
Gjennom balansering av slitasje kan FAST VP forlenge levetiden til SSD, selv om denne funksjonen ikke direkte gjelder Storage Tiering. Siden temperaturopplysningene allerede er tilgjengelige, tas også antall skriveoperasjoner i betraktning, og vi kan flytte datablokker, så det ville vært logisk for FAST VP å løse denne oppgaven.
Hvis antallet skriveoperasjoner til en RAID-gruppe betydelig overstiger antallet skriveoperasjoner til en annen, vil FAST VP omfordele dataene i samsvar med antall skriveoperasjoner. På den ene siden reduserer dette belastningen og bevarer ressursene på noen disker, mens det på den annen side øker «arbeidet» for mindre belastede, og forbedrer den totale ytelsen.
Dermed påtar FAST VP seg de tradisjonelle oppgavene med Storage Tiering, og gjør enda litt mer i tillegg. Alt dette gjør det mulig å lagre data ganske effektivt i Unity-familien av lagringssystemer.
Noen tips
- Ikke forsøm å lese dokumentasjonen. Det finnes beste praksiser, og de fungerer ganske godt. Hvis man følger dem, oppstår det vanligvis ikke alvorlige problemer. De andre tipsene gjentar eller supplerer dem for det meste.
- Dersom du har konfigurert og aktivert FAST VP, bør du la det stå på. La det fordele data over tid, litt etter litt, i stedet for én gang i året med betydelig påvirkning på ytelsen til andre oppgaver. I slike tilfeller kan datafordelingen ta lang tid.
- Vær nøye med valget av vindu for relokalisering. Selv om dette er åpenbart, prøv å velge et tidspunkt med minst belastning på Unity, og sørg for å sette av tilstrekkelig tid.
- Planlegg utvidelsen av lagringssystemet, og gjør det i tide. Dette er et generelt råd som også er viktig for FAST VP. Hvis mengden ledig plass er veldig lite, vil flytting av data bli forsinket eller bli umulig. Spesielt hvis du har oversett punkt 2.
- Når du utvider pulen med FAST VP aktivert, bør du ikke begynne med de tregeste diskene. Det vil si at vi enten legger til alle planlagte RAID-grupper samtidig, eller først legger til de raskeste diskene. I så fall vil omfordeling av data på de nye «raske» diskene øke den totale hastigheten på pulen. Hvis vi derimot starter med de «trege» diskene, kan det oppstå en veldig ubehagelig situasjon. Først vil data bli overført til de nye, relativt sakte diskene, og deretter, når raskere diskene legges til, vil det skje i motsatt retning. Her er det nyanser knyttet til forskjellige politikker for FAST VP, men i all hovedsak er en slik situasjon mulig.
Hvis du vurderer dette produktet, kan du prøve Unity gratis ved å laste ned Unity VSA virtuelle applikasjon.
Avslutningsvis deler jeg noen nyttige lenker:
- Side
- – en kort beskrivelse av funksjonen
- , pdf-format
Konklusjon
Det er mye jeg ønsker å skrive om, men jeg forstår at ikke alle detaljer vil interessere leserne. For eksempel kan jeg utdype kriteriene FAST VP bruker for å ta beslutninger om datamigrering, og prosessene for analyse av inn- og utdata-statistikk. Temaet om samhandling med , er helt uteglemt, og det fortjener en egen artikkel. Man kan til og med spekulere om utviklingen av denne teknologien. Jeg håper det ikke ble for kjedelig, og at jeg ikke har utmattet dere. Vi sees neste gang!
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish