

Mange møter Elasticsearch. Men hva skjer når man ønsker å lagre logger "i særdeles store mengder" med hjelp av det? Og samtidig uten å oppleve smertefulle avbrudd på grunn av nedetid i en av flere datasentre? Hvilken arkitektur bør man velge, og hvilke skjulte fallgruver kan man støte på?
Vi i Odnoklassniki bestemte oss for å løse logg-håndteringsproblemet med Elasticsearch, og nå deler vi erfaringene våre med Habr: både om arkitekturen og om fallgruvene.
Jeg er Pjotr Zaikov, arbeider som systemadministrator i Odnoklassniki. Før dette var jeg også administrator, og jobbet med Manticore Search, Sphinx search, Elasticsearch. Det kan hende at hvis det dukker opp noe nytt ... search, så vil jeg også jobbe med det. I tillegg deltar jeg i flere open source-prosjekter på frivillig basis.
Da jeg begynte i Odnoklassniki, sa jeg ubetenksomt i intervjuet at jeg kunne jobbe med Elasticsearch. Etter å ha blitt kjent med det og gjort noen enkle oppgaver, fikk jeg tildelt en stor oppgave med å reformere logg-håndteringssystemet som eksisterte på det tidspunktet.
Krav
Kravene til systemet ble formulert som følger:
- Som frontend skulle Graylog brukes. Fordi selskapet allerede hadde erfaring med dette produktet, var både programmerere og testere kjent med det, og de syntes det var komfortabelt å bruke.
- Datamengden: i gjennomsnitt 50-80 tusen meldinger per sekund, men hvis noe går galt, så er trafikken uten begrensning, og det kan være 2-3 millioner linjer per sekund.
- Etter å ha diskutert med kundene kravene til hastigheten ved behandling av søkespørsmål, forsto vi at den typiske bruken av et slikt system er slik at folk søker logger fra applikasjonen sin de siste to dagene og ikke ønsker å vente lenger enn ett sekund på resultatet av forespørselen.
- Administratorene insisterte på at systemet lett skulle kunne skaleres ved behov, uten å kreve at de måtte sette seg grundig inn i hvordan det var bygget opp.
- Den eneste oppgaven med vedlikehold som disse systemene trengte fra tid til annen var å bytte ut noe maskinvare.
- I tillegg har Odnoklassniki en flott teknisk tradisjon: enhver tjeneste vi lanserer, må kunne håndtere et datasenter-nedbrudd (uventet, upålagt og til enhver tid).
Det siste kravet i gjennomføringen av dette prosjektet har kostet oss mest, noe jeg vil fortelle mer om senere.
Miljø
Vi jobber med fire datasentre, men Elasticsearch-nodene kan kun plasseres i tre (av en rekke ikke-tekniske grunner).
I disse fire datasentrene finnes det omtrent 18 000 ulike loggkilder — maskinvare, containere, virtuelle maskiner.
En viktig funksjon: klustret startes i containere ikke på fysiske maskiner, men på . Containerne garanteres 2 kjerner, tilsvarende 2.0Ghz v4 med mulighet for utnyttelse av de øvrige kjernene i tilfelle de er inaktive.
Med andre ord:
Topologi
Den overordnede løsningen så jeg i utgangspunktet slik ut:
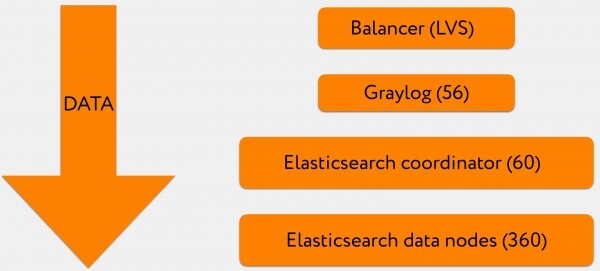
- 3-4 VIP-er står bak A-posten til domenet Graylog, det er adressen som loggene sendes til.
- hver VIP fungerer som en LVS-balancer.
- Etter det blir loggene sendt til en Graylog-batteri, hvorav en del data går i GELF-format, og en del i syslog-format.
- Deretter skrives alt dette i store batcher til en gruppe med Elasticsearch-koordinatorer.
- Og de sender forespørslene om skriving og lesing til relevante datanoder.
Terminologi
Kanskje ikke alle har kjennskap til terminologien, derfor vil jeg gjerne stoppe litt opp ved den.
I Elasticsearch finnes det flere typer noder — master, koordinator, datanode. Det er også to andre typer for ulike konverteringer av logger og kommunikasjon mellom forskjellige klynger, men vi brukte kun de nevnte.
Master
Pinger alle nodene som er tilstede i klyngen, opprettholder et oppdatert kart over klyngen og sprer det mellom nodene, behandler hendelseslogikk, driver med diverse cluster wide housekeeping.
Koordinator
Utfører en eneste oppgave: tar imot forespørselene fra klientene for lesing eller skriving og ruter denne trafikken. Når det er en skrivingsforespørsel, vil den sannsynligvis spørre master hvilken shard i den relevante indeksen den skal legge dette til, og videresende forespørselen videre.
Datanode
Lagrer data, utfører søkebegjæringer og operasjoner på sharder som er plassert på den.
Graylog
Dette er noe som ligner en sammensmelting av Kibana med Logstash i ELK-stakken. Graylog kombinerer både UI og loggbehandlingspipeline. Bak kulissene i Graylog fungerer Kafka og Zookeeper, som sikrer tilkoblingen av Graylog som en klynge. Graylog kan cache logger (Kafka) i tilfelle Elasticsearch ikke er tilgjengelig og gjenta mislykkede lese- og skriveforespørselene, gruppere og merke loggene etter angitte regler. Som Logstash har Graylog funksjonalitet for å modifisere strenger før de skrives til Elasticsearch.
I tillegg har Graylog innebygd service discovery, som lar deg hente hele klyngeoversikten basert på en tilgjengelig Elasticsearch-node, og filtrere den etter et bestemt tag, noe som gir mulighet for å sende forespørselene til bestemte containere.
Visuelt ser det omtrent slik ut:

Dette er et skjermbilde fra en spesifikk instans. Her bygger vi et histogram basert på søkespørsmålet og viser relevante linjer.
Indexes
Når vi går tilbake til systemarkitekturen, vil jeg gjerne gå nærmere inn på hvordan vi bygde modellene for indekser for at alt skulle fungere riktig.
I det tidligere diagrammet er dette det laveste nivået: Elasticsearch data noder.
En indeks er en stor virtuell enhet bestående av Elasticsearch-shards. Hver av shardene i seg selv er intet annet enn en Lucene-indeks. Og hver Lucene-indeks består igjen av ett eller flere segmenter.
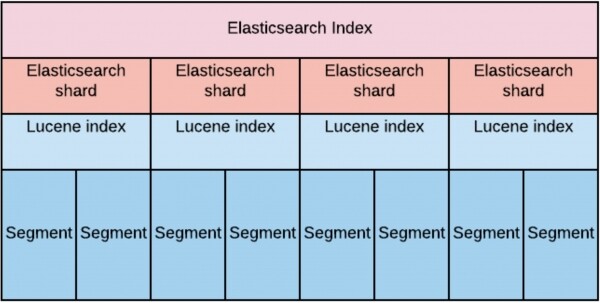
Ved prosjektplanleggingen antok vi at for å tilfredsstille lesehastighetskravene ved store datamengder måtte vi jevnt 'fordele' disse dataene over datanodene.
Dette resulterte i at antallet shards per indeks (med replikasjoner) måtte være nøyaktig likt antallet datanoder. For det første for å oppnå en replikasjonsfaktor på to (det vil si at vi kan miste halvparten av klyngen). Og for det andre for å kunne behandle lese- og skriveforespørslene på minst halvparten av klyngen.
Vi bestemte først lagringstiden til 30 dager.
Fordelingen av shards kan grafisk presenteres som følger:
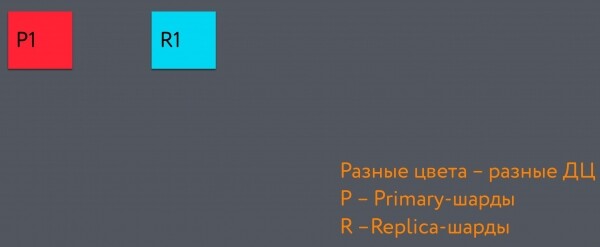
Den mørkegrå rektangelen i sin helhet er indeksen. Den venstre røde kvadraten i den er primary-sharden, den første i indeksen. Den blå kvadraten er replica-sharden. De befinner seg i forskjellige datasentre.
Når vi legger til en ny shard, går den til det tredje datasenteret. Til slutt får vi en struktur som gjør det mulig å miste et datasenter uten å miste datakonsistens.
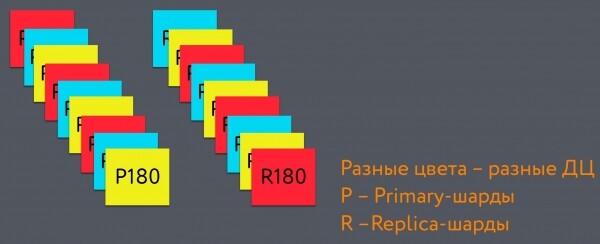
Vi har satt rotasjonen av indekser, det vil si å opprette en ny indeks og fjerne den eldste, til 48 timer (basert på bruken av indeksen: de siste 48 timene blir søkt oftest).
Dette rotasjonsintervallet for indekser er knyttet til følgende årsaker:
Når en spesifikk datanode mottar en søkeforespørsel, er det mer gunstig med ytelse å spørre en shard, hvis størrelsen er sammenlignbar med størrelsen på nodens heap. Dette gjør at vi kan holde den ‘hvite’ delen av indeksen i heapen og raskt få tilgang til den. Når det blir flere ‘hvite deler’, reduseres hastigheten på søket i indeksen.
Når en node begynner å utføre en søkeforespørsel på en shard, tilordner den antall tråder lik antall hypertrådede kjerner på den fysiske maskinen. Hvis søkeforespørselen berører et stort antall shards, øker antallet tråder proporsjonalt. Dette påvirker søkehastigheten negativt og har en dårlig effekt på indeksering av nye data.
For å sikre nødvendig søkeforsinkelse, bestemte vi oss for å bruke SSD. For rask behandling av forespørslene måtte maskinene som vertet disse containerne ha minst 56 kjerner. Tallet 56 er valgt som en betinget tilstrekkelig størrelse, som bestemmer antall tråder Elasticsearch vil produsere under drift. I Elasticsearch avhenger mange innstillinger for trådpool direkte av antallet tilgjengelige kjerner, som igjen direkte påvirker antall noder som kreves i klyngen etter prinsippet "fewer cores — more nodes".
Vi endte opp med at gjennomsnittlig veier en shard omtrent 20 gigabyte, og det er 360 shards per indeks. Dermed, hvis vi roterer dem hver 48. time, har vi 15 av dem. Hver indeks inneholder data for 2 dager.
Skrive- og leseordninger for data
La oss se nærmere på hvordan data skrives i dette systemet.
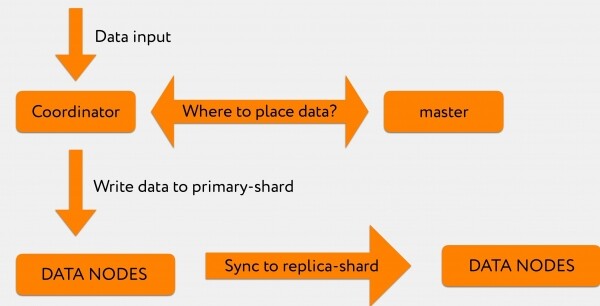
La oss si at vi mottar en forespørsel fra Graylog til koordinatoren. For eksempel, vi ønsker å indeksere 2-3 tusen linjer.
Koordinatoren, etter å ha mottatt en forespørsel fra Graylog, spør masteren: «I forespørselen om indeksering var vi spesifikt angitt en indeks, men i hvilken shard dette skulle skrives – var ikke angitt».
Masteren svarer: «Skriv denne informasjonen i shard nummer 71», deretter sendes den direkte til den relevante datanoden, hvor primær-shard nummer 71 befinner seg.
Deretter blir transaksjonsloggen replikert til replica-shard, som allerede ligger i et annet datasenter.
Fra Graylog kommer en søkforespørsel til koordinatoren. Koordinatoren videresender den etter indeksen, mens Elasticsearch, etter prinsippet om round-robin, fordeler forespørslene mellom primær-shard og replica-shard.
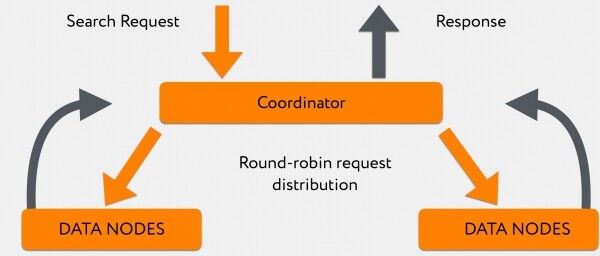
Nodene, som er 180 i antall, svarer ujevnt, og mens de svarer, samler koordinatoren informasjonen som allerede er «spyttet ut» av raskere datanoder. Når enten all informasjon er kommet, eller forespørselen har nådd tidsgrensen, gir den alt direkte til klienten.
Hele dette systemet behandler i gjennomsnitt søkforespørslene for de siste 48 timene på 300-400ms, unntatt de forespørslene som har ledende wildcard.
«Små detaljer» med Elasticsearch: Java-konfigurasjon
For at alt dette skulle fungere slik vi opprinnelig ønsket, brukte vi mye tid på å finjustere forskjellige saker i klyngen.
Den første delen av de oppdagede problemene var relatert til hvordan Java er forhåndsinnstilt i Elasticsearch som standard.
Problem én
Vi observerte et stort antall meldinger om at på Lucene-nivå, når bakgrunnsjobber kjøres, feiler segmentfusjoner i Lucene med en feil. Det var synlig i loggene at dette var en OutOfMemoryError. Gjennom telemetri så vi at heap-en var ledig, og det var uklart hvorfor denne operasjonen feilet.
Det viste seg at fusjoner av Lucene-indekser skjer utenfor heap-en. Containerne har ganske strenge begrensninger på forbrukte ressurser. Bare heap-en var innenfor disse ressursene (heap.size-verdien var omtrent lik RAM), og noen off-heap-operasjoner feilet med minneallokeringsfeil hvis de av en eller annen grunn ikke ble utført innenfor de ~500MB som var igjen til grensen.
Løsningen var ganske triviale: vi økte RAM-omfanget tilgjengelig for containeren, hvoretter vi glemte at slike problemer noensinne hadde oppstått.
Det andre problemet
Omtrent 4-5 dager etter oppstart av klyngen la vi merke til at datanodene begynte å falle ut av klyngen periodisk og kom tilbake etter ca. 10-20 sekunder.
Da vi begynte å undersøke, fant vi ut at denne såkalte off-heap minnet i Elasticsearch nesten ikke blir kontrollert i det hele tatt. Når vi ga containeren mer minne, fikk vi muligheten til å fylle direkte buffer-pooler med ulik informasjon, og det ble ryddet opp først etter at explicit GC fra Elasticsearch ble kjørt.
I noen tilfeller tok dette operasjonen en ganske lang tid, og i løpet av den tiden klarte klustret å merke denne noden som allerede ute av drift. Dette problemet er godt dokumentert. .
Løsningen var som følger: Vi begrenset Java sin mulighet til å bruke hoveddelen av minnet utenfor heap til disse operasjonene. Vi satte en grense på 16 gigabyte (-XX:MaxDirectMemorySize=16g), som resulterte i at explicit GC ble kalt betydelig oftere og kjørte mye raskere, noe som igjen stabiliserte klustret.
Det tredje problemet.
Hvis du tror at problemene med «noder som forlater klustret på de mest uventede tidspunktene» er over, tar du feil.
Når vi konfigurerte arbeidet med indekser, valgte vi mmapfs for å etter ferske shards med høy segmentering. Dette var en ganske grov feil, fordi ved bruk av mmapfs blir filen mappet inn i RAM, og deretter jobber vi med den mappede filen. Dette resulterte i at når GC forsøk å stoppe trådene i applikasjonen, tok det veldig lang tid før vi kom til safepoint, og på veien dit slutter applikasjonen å svare på masterens forespørsel om den fortsatt er aktiv. Dermed mener masteren at noden ikke lenger er tilstede i klustret. Etter fem til ti sekunder utføres garbage collector, noden kommer tilbake, går inn igjen i klustret og begynner å initialisere shards. Alt dette minnet sterkt om “produksjonen vi fortjente” og var ikke egnet for noe seriøst.
For å bli kvitt denne oppførselen, gikk vi først over til standard niofs, og etter at vi hadde migrert fra femte til sjette versjon av Elastic, prøvde vi hybridfs, hvor dette problemet ikke forekom. Du kan lese mer om lagringstyper. .
Det fjerde problemet.
Deretter var det et annet veldig interessant problem som vi brukte rekordlang tid på å løse. Vi jaktet på det i 2-3 måneder, fordi mønsteret var helt uforståelig.
Noen ganger gikk koordinatorene våre i Full GC, vanligvis etter lunsj, og kom aldri tilbake. På logsynkronisering av GC så det slik ut: alt går bra, bra, bra, så plutselig — alt ble dårlig.
Først trodde vi at vi hadde en ond bruker som kjørte en forespørsel som fikk koordinatoren til å gå ut av arbeidsmodus. Vi logget forespørslene lenge i et forsøk på å finne ut hva som skjedde.
Det viste seg at når en bruker kjører en stor forespørsel, og den treffer en spesifikk Elasticsearch-koordinator, responderer noen noder tregere enn de andre.
Mens koordinatoren venter på svar fra alle nodene, akkumulerer den resultatene fra nodene som har svart. For GC betyr dette at bruksmønsteret for heapen endrer seg raskt. Den GC-en vi brukte klarte ikke å håndtere denne oppgaven.
Den eneste løsningen vi fant for å endre atferden til klyngen i en slik situasjon, var å migrere til JDK13 og bruke søppelsamleren Shenandoah. Dette løste problemet, og koordinatorene våre sluttet å falle.
Her sluttet problemene med Java, og problemene med båndbredde begynte.
«Bær» med Elasticsearch: båndbredde
Problemer med båndbredde betyr at klyngen vår fungerer stabilt, men at ytelsen er utilstrekkelig under topptider for indekserte dokumenter og ved manøvrering.
Det første symptomet vi oppdaget: under visse «eksplosjoner» i produksjon, når et stort antall logger genereres raskt, begynte Graylog å vise feilmeldinger for indeksering es_rejected_execution.
Dette skjedde fordi thread_pool.write.queue på en datanode, før Elasticsearch får behandlet forespørselen om indeksering og sendt informasjon til shard på disk, kun kan cache 200 forespørslene som standard. Og legges det lite vekt på denne parameteren. Det nevnes bare maks antall tråder og standardstørrelse.
Selvfølgelig begynte vi å justere denne verdien og fant ut følgende: spesielt i vår oppsett kan det caches opp til 300 forespørseler ganske bra, mens høyere verdier fører til at vi havner tilbake i Full GC.
I tillegg, ettersom dette er meldingsseksjoner som kommer innenfor én forespørsel, måtte Graylog også justeres slik at det ikke skrev ofte og i små batcher, men i store batcher eller hvert 3. sekund, hvis batchen fortsatt ikke er full. I så fall blir informasjonen vi skriver i Elasticsearch tilgjengelig ikke etter to sekunder, men etter fem (som er helt akseptabelt for oss), men antallet retriever som må gjøres for å presse gjennom en stor mengde informasjon reduseres.
Dette er særlig viktig når noe går galt og rapporterer frustrert, slik at vi ikke får en helt spammende Elastic, og etter en stund — ikke-fungerende Graylog-noder på grunn av fulle buffere.
I tillegg, når vi hadde disse eksplosjonene i produksjonen, fikk vi klager fra programmerere og testere: i det øyeblikket de virkelig trenger disse loggene, blir de levert til dem veldig sakte.
Vi begynte å undersøke. På den ene siden var det klart at både søkeforespørslene og forespørslene om indeksering egentlig kjørte på de samme fysiske maskinene, og på en eller annen måte ville det helt klart være visse nedganger.
Men dette kunne delvis omgås ved at det i versjon seks av Elasticsearch kom en algoritme som tillater å fordele forespørslene mellom relevante datanoder ikke på tilfeldig round-robin-prinsipp (containeren som tar seg av indeksering og holder primary-shard, kan være veldig opptatt, og der vil det ikke være mulighet for å svare raskt), men å sende denne forespørselen til en mindre belastet container med replica-shard, som vil svare mye raskere. Med andre ord, vi kom frem til use_adaptive_replica_selection: true.
Bildet av lesingen begynner å se slik ut:
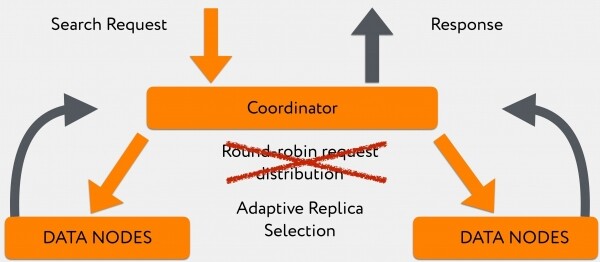
Overgangen til denne algoritmen tillot en betydelig forbedring av spørringstiden i de øyeblikkene vi hadde en stor strøm av logger inn.
Til slutt var hovedproblemet å trekke ut datasenteret uten komplikasjoner.
Hva vi ønsket fra klyngen umiddelbart etter tap av kontakt med ett DC:
- Hvis vår nåværende master befinner seg i det avkoblede datasenteret, vil det bli valgt på nytt og flytte rollen til en annen node i et annet DC.
- Masteren vil raskt kaste ut alle utilgjengelige noder fra klyngen.
- Basert på de gjenværende vil han forstå: i det tapte datasenteret hadde vi slike primary-sharder, han vil raskt promotere komplementære replica-sharder i de gjenværende datasentrene, og vår datainndeksering vil fortsette.
- Som et resultat av dette vil båndbredden til klyngen for skriving og lesing gradvis avta, men generelt vil alt fungere selv om det går sakte, men stabilt.
Som det viste seg, ønsket vi noe slikt:
Og vi fikk følgende:
Hvordan gikk dette til?
I øyeblikket av datasenterets fall ble mesteren vårt flaskehals.
Why?
Saken er at det i mesteren er en TaskBatcher, som ansvarlig for distribusjonen av bestemte oppgaver og hendelser i klyngen. Ethvert utfall av en node, enhver promovering av en sharde fra replica til primary, enhver oppgave for å opprette en sharde et sted — alt dette går først inn i TaskBatcher, hvor det behandles sekvensielt og i én tråd.
I øyeblikket av utgangen av et datasenter skjedde det at alle datanoder i de overlevende datasentrene følte det som sin plikt å informere mesteren "vi har mistet slike shard og slike datanoder".
Samtidig sendte de overlevende datanodene all denne informasjonen til den nåværende mesteren og prøvde å vente på bekreftelse på at han hadde mottatt den. De ventet ikke på dette, da mesteren mottok oppgaver raskere enn han klarte å svare. Noder gjentok forespørslene på timeout, mens mesteren i mellomtiden ikke engang prøvde å svare dem, men var helt oppslukt av oppgaven med å sortere forespørslene etter prioritet.
I terminal form ble det slik at datanodene spammet mesteren til det punktet at han gikk inn i full GC. Etter dette ble rollen som mester overført til en eller annen neste node, og det skjedde akkurat det samme med den, og til slutt kollapset klyngen helt.
Vi utførte målinger, og før versjon 6.4.0, hvor dette ble fikset, var det tilstrekkelig å ta ut bare 10 datanoder samtidig fra 360 for å helt legge klyngen ned.
Det så omtrent slik ut:
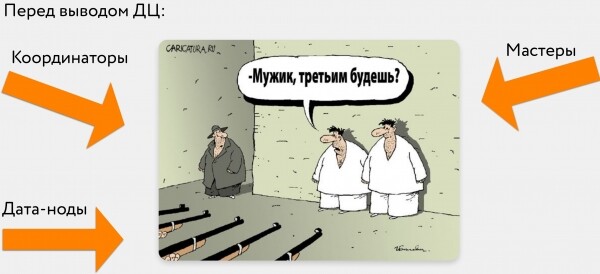
Etter versjon 6.4.0, hvor denne skumle feilen ble fikset, sluttet datanodene å drepe mesteren. Men han ble ikke "smartere" av den grunn. Nemlig: når vi tar ut 2, 3 eller 10 (hvilket som helst antall annet enn én) datanoder, får mesteren et eller annet første meldingen som forteller at node A har falt ut, og prøver å fortelle dette til node B, node C, node D.
Og for øyeblikket kan dette bare tackles ved å sette en tidsavbrudd på forsøkene om å informere noen om noe, lik et sted rundt 20-30 sekunder, og dermed styre hastigheten på datasenterets utgang fra klustret.
I prinsippet passer dette inn i de kravene som opprinnelig ble stilt til det endelige produktet i prosjektets rammeverk, men i lys av «ren vitenskap» er dette en feil. En feil som forresten ble vellykket fikset av utviklerne i versjon 7.2.
Dessuten, når en datanode gikk ut, viste det seg at det var viktigere å spre informasjonen om dens utgang enn å informere hele klustret om at den hadde slike primary-shard (for å promotere replica-shard i et annet datasenter til primary, slik at det kunne skrives informasjon).
Derfor, når alt «har roet seg», markeres ikke de utgåtte datanodene som stale umiddelbart. Dermed må vi vente til alle pingene til de utgåtte datanodene har timed out, og først deretter begynner klustret å informere om at der og der må skrivingen av informasjon fortsette. Du kan lese mer om dette. .
Som et resultat tar operasjonen å trekke datasenteret vårt i dag omtrent 5 minutter i rushtiden. For en så stor og treg maskin er det et ganske godt resultat.
Som et resultat kom vi til følgende løsning:
- Vi har 360 datanoder med disker på 700 gigabyte.
- 60 koordinatorer for ruting av trafikk mellom disse datanodene.
- 40 mastere, som vi har igjen som et slags arv fra tidene før versjon 6.4.0 — for å overleve trekkingen av datasenteret var vi moralsk forberedt på å miste noen maskiner, for å garantere at vi, selv i det dårligste scenarioet, hadde kvorum av mastere.
- Enhver forsøkt kombinasjon av roller i en container støttet på at noden til slutt ville feile under belastning.
- Hele klustret bruker en heap.size på 31 gigabyte: alle forsøk på å redusere størrelsen førte til at tunge søkespørsmål med leading wildcard enten drepte noen noder, eller aktivere circuit breaker i Elasticsearch selv.
- I tillegg, for å sikre søkeytelse, prøvde vi å holde antallet objekter i klustret så lavt som mulig, for å behandle så få hendelser som mulig i det trange punktet vi hadde i masteren.
Til slutt om overvåkning
For everything to work as intended, we monitor the following:
- Each data node reports to our cloud that it exists and has certain shards on it. When we take down something somewhere, the cluster reports within 2-3 seconds that in data center A we have taken down nodes 2, 3, and 4 — this means that in other data centers, we absolutely cannot take down those nodes that still have shards in a single instance.
- Understanding the master's behavior, we pay close attention to the number of pending tasks. Because even one stuck task, if not timed out promptly, could theoretically be the reason we can't, for instance, promote a replica shard to primary, causing indexing to stop.
- We also closely monitor garbage collector delays, as we have already faced significant challenges with this during optimization.
- Rejections by threads, to understand in advance where the 'bottleneck' is.
- And the standard metrics, like heap, RAM, and I/O.
When building monitoring, it is essential to consider the peculiarities of the Thread Pool in Elasticsearch. describes the configuration capabilities and default values for searching, indexing, but completely omits thread_pool.management. These threads handle, among other things, requests like _cat/shards and other similar ones that are convenient for writing monitoring. The larger the cluster, the more of these requests are executed in a given time, and the aforementioned thread_pool.management is not only absent from the official documentation, but it is also limited by default to 5 threads, which can be quickly utilized, after which monitoring ceases to function correctly.
In conclusion, I want to say: we did it! We managed to provide our programmers and developers with a tool that can quickly and reliably provide information about what is happening in production in almost any situation.
Yes, it turned out quite complex, but nevertheless, we were able to fit our wishes into existing products, which did not need to be patched or rewritten for ourselves.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish