

Data Scientist-yrket og Data Engineer-yrket blir ofte forvekslet. Hver bedrift har sine egne spesifikasjoner for hvordan de jobber med data, ulike mål for analyse og forskjellige oppfatninger om hvilke spesialister som skal ha ansvar for hvilke deler av arbeidet, derfor er kravene også forskjellige.
Vi ser nærmere på forskjellene mellom disse spesialistene, hvilke forretningsoppgaver de løser, hvilke ferdigheter de har, og hvor mye de tjener. Materialet ble omfattende, derfor har vi delt det opp i to publikasjoner.
I den første artikkelen forteller Elena Gerasimova, leder for fakultetet "" i Netology, om forskjellene mellom Data Scientist og Data Engineer og hvilke verktøy de arbeider med.
Hvordan rollene til ingeniører og dataforskere skiller seg
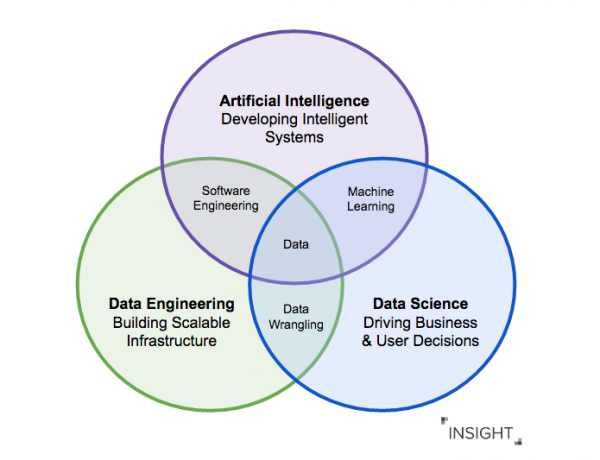
Dataingeniør er en spesialist som, på den ene siden, utvikler, tester og vedlikeholder infrastrukturen for databehandling: databaser, lagringssystemer og systemer for massebehandling. På den andre siden er det personen som renser og «kjemmer» data for bruk av analytikere og dataforskere, altså skaper databehandlingspipelines.
Data Scientist skaper og trener prediktive (og andre) modeller ved hjelp av algoritmer for maskinlæring og nevrale nettverk, som hjelper bedriften med å finne skjulte mønstre, forutsi hendelser og optimalisere nøkkeldriftsprosesser.
Hovedforskjellen mellom Data Scientist og Data Engineer ligger i at de vanligvis har forskjellige mål. Begge jobber for å sikre at dataene er tilgjengelige og av god kvalitet. Men Data Scientist finner svar på sine spørsmål og tester hypoteser i datamiljøet (for eksempel på en Hadoop-plattform), mens Data Engineer skaper en pipeline for vedlikehold av algoritmen for maskinlæring skrevet av dataforskeren, i en Spark-klynge innenfor det samme miljøet.
Dataingeniøren tilfører verdi til virksomheten ved å jobbe i team. Hans oppgave er å fungere som en viktig kobling mellom forskjellige aktører: fra utviklere til forretningsforbrukere av rapporter — og øke produktiviteten til analytikere — fra markedsførings- og produktteam til BI.
Data Scientist, derimot, deltar aktivt i selskapets strategi og innhenting av innsikt, beslutningstaking, implementering av automatiseringsalgoritmer, modellering og generering av verdi fra data.
Arbeidet med data følger prinsippet GIGO (garbage in — garbage out): hvis analytikere og datavitere håndterer uforberedte og potensielt feilaktige data, vil resultatene, selv med de mest sofistikerte analysealgoritmene, være unøyaktige.
Dataingeniører løser dette problemet ved å bygge rørledninger for behandling, rensing og transformasjon av data, slik at datavitere kan arbeide med kvalitetsdata.
Det finnes mange verktøy for databehandling på markedet som dekker hvert trinn: fra datakilde til presentasjon på dashbordet for styret. Det er viktig at beslutningen om å bruke dem tas av ingeniøren, ikke fordi det er trendy, men fordi det faktisk vil hjelpe de andre deltagere i prosessen.
Kort sagt: hvis selskapet trenger å koble BI og ETL — datainnhenting og rapportoppdateringer, her er det typiske legacy-grunnlaget som Data Engineer må håndtere (det er bra hvis det også er en arkitekt i teamet).
Ansvarsområder for Data Engineer
- Utvikling, bygging og vedlikehold av infrastruktur for databehandling.
- Feilhåndtering og oppretting av pålitelige databehandlingsrørledninger.
- Konvertering av ustrukturerte data fra ulike dynamiske kilder til et format som er nødvendig for analytikere.
- Gi anbefalinger for å forbedre konsistensen og kvaliteten på dataene.
- Sikre og støtte datainfrastrukturen som brukes av datavitere og dataanalytikere.
- Behandling og lagring av data konsekvent og effektivt i et distribuert kluster med titalls eller hundrevis av servere.
- Vurdering av tekniske kompromisser i verktøyene for å lage enkle, men pålitelige arkitekturer som kan overleve feil.
- Overvåking og vedlikehold av datastreamer og relaterte systemer (oppsett av overvåkning og varsler).
Det finnes også en annen spesialisering innen Data Engineer-banen — ML engineer. Kort sagt, disse ingeniørene spesialiserer seg på å få maskinlæringsmodeller fra forskning til industriell implementering og bruk. Ofte er modellen fra dataviteren en del av et eksperiment og fungerer kanskje ikke i produksjonsmiljø.
Ansvarsområder for Data Scientist
- Uttrekking av funksjoner fra data for bruk med maskinlæringsalgoritmer.
- Bruk av ulike maskinlæringsverktøy for å forutsi og klassifisere mønstre i dataene.
- Forbedring av ytelsen og nøyaktigheten til maskinlæringsalgoritmer gjennom finjustering og optimalisering av algoritmene.
- Utvikling av «sterke» hypoteser i samsvar med selskapets strategi som må testes.
Både Data Engineer og Data Scientist bidrar merkbart til utviklingen av en datakultur som gjør det mulig for selskapet å generere ekstra inntekter eller redusere kostnader.
Hvilke språk og verktøy jobber ingeniører og scientister med
I dag har forventningene til databehandlingsspesialister endret seg. Tidligere samlet ingeniører store SQL-spørsmål, skrev MapReduce manuelt og behandlet data med verktøy som Informatica ETL, Pentaho ETL, Talend.
I 2020 kan en spesialist ikke unngå å kjenne til Python og moderne verktøy for beregninger (for eksempel Airflow), samt forstå prinsippene for bruk av skyplattformer (for å spare på «maskinvare» og samtidig opprettholde sikkerhetsprinsippene).
SAP, Oracle, MySQL, Redis er tradisjonelle verktøy for dataingeniører i store selskaper. De er gode, men lisenskostnadene er så høye at det kun gir mening å lære å bruke dem i industrielle prosjekter. Det finnes imidlertid et gratis alternativ i form av Postgres — det er gratis og ikke bare egnet for opplæring.
Historisk sett har det ofte vært etterspørsel etter Java og Scala, selv om disse språkene gradvis går ut på dato i takt med utviklingen av teknologi og metoder.
Likevel er hardcore BigData-verktøy som Hadoop, Spark og resten av dyrehagen ikke lenger et obligatorisk krav for dataingeniører, men snarere et utvalg verktøy for å løse oppgaver som ikke kan løses med tradisjonell ETL.
Trenden er tjenester for å bruke verktøy uten å måtte kunne språket de er skrevet i (for eksempel Hadoop uten kunnskap om Java), samt å tilby klare tjenester for behandling av strømmedata (gjenkjenning av tale eller bilder i video).
Industrielle løsninger fra SAS og SPSS er populære, mens Tableau, Rapidminer, Stata og Julia også er mye brukt av datascientister til lokale oppgaver.
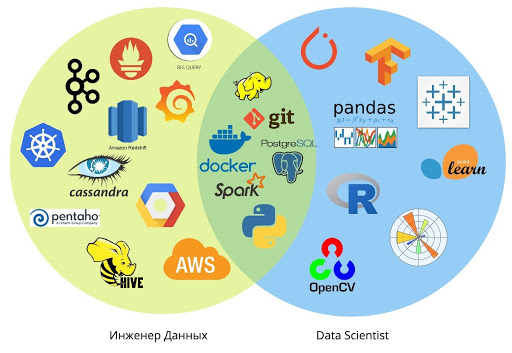
Mulighet for å bygge egne pipelines har kommet til analytikere og datavitere for bare et par år siden: for eksempel kan man nå bruke relativt enkle skript for å sende data til en lagring basert på PostgreSQL.
Vanligvis er bruken av rørledninger og integrerte datastrukturer under datateknikernes ansvar. Men i dag er trenden for T-formede spesialister sterkere enn noensinne — med brede kompetanser innen beslektede områder, ettersom verktøyene stadig blir enklere.
Hvorfor bør Data Engineer og Data Scientist samarbeide?
Ved å arbeide tett sammen med ingeniører kan Data Scientists fokusere på forskningsdelen, og utvikle klare algoritmer for maskinlæring.
Ingeniørene kan fokusere på skalerbarhet, gjenbruk av data, og sikre at inn- og utdata pipelines i hvert enkelt prosjekt samsvarer med den globale arkitekturen.
Denne tydelige fordelingen av oppgaver sikrer at det er enighet mellom grupper av spesialister som jobber med ulike maskinlæringsprosjekter.
Samarbeid bidrar til effektiv utvikling av nye produkter. Hastighet og kvalitet oppnås gjennom balansen mellom å lage tjenester for alle (global lagring eller integrering av dashbord) og å oppfylle hver enkelt behov eller prosjekt (spesialiserte pipelines, tilkobling av eksterne kilder).
Tett samarbeid med datavitere og analytikere hjelper ingeniører med å utvikle analytiske og forskningsferdigheter for å skrive bedre kode. Kunnskapsutvekslingen mellom brukerne av lagringssteder og datalagre forbedres, noe som gjør prosjektene mer fleksible og sikrer mer bærekraftige langsiktige resultater.
I selskaper som har som mål å utvikle en datakultur og bygge forretningsprosesser basert på dette, utfyller Data Scientist og Data Engineer hverandre og skaper et komplett system for dataanalyse.
I den neste artikkelen skal vi diskutere hvilken utdanning Data Engineers og Data Scientists bør ha, hvilke ferdigheter de må utvikle, og hvordan markedet er strukturert.
From the editorial team of Netology
If you are considering a career as a Data Engineer or Data Scientist, we invite you to explore our course programs:
- The profession of “».
- The profession of “».
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish