

Hei, Habr!
Data er den mest verdifulle ressursen til et selskap. Dette er noe nesten hver digitalt orientert virksomhet påpeker. Det er vanskelig å motsi dette: uten å diskutere tilnærminger til datastyring, lagring og behandling finner man ikke en eneste stor IT-konferanse hvor dette ikke er et tema.
Data kommer til oss fra utsiden, men de dannes også internt i selskapet. Når vi snakker om data fra telekom-selskaper, er dette en skattekiste av informasjon for interne ansatte om kundens interesser, vaner og lokasjon. Med riktig profiling og segmentering vil reklameforslag fungere mest effektivt. Imidlertid er ikke alt så rosenrødt i praksis. De dataene som deles av selskapene, kan være håpløst utdaterte, overflødige, repeterende, eller det kan være slik at ingen vet om deres eksistens utenom en liten gruppe brukere. ¯_(ツ)_/¯
Med andre ord, man må effektivt håndtere data – kun da vil de bli en ressurs som gir virksomheten reell nytte og fortjeneste. Dessverre er det mange utfordringer knyttet til datastyring som må overkommes. Disse er først og fremst forårsaket av historisk arv i form av "dyreparker" av systemer, samt mangel på enhetlige prosesser og tilnærminger til datastyring. Men hva betyr det å "håndtere data"?
Det er nettopp dette vi skal diskutere under cut, samt hvordan vi har fått hjelp av en åpen kildekode-stabel.
Konseptet med strategisk datastyring, Data Governance (DG), er allerede godt kjent i det russiske markedet, og målene som virksomheter oppnår som følge av implementeringen er klare og tydelig erklært. Vårt selskap er ikke noe unntak og har satt seg som mål å implementere konseptet med datastyring.
Så, hva begynte vi med? Først og fremst definerte vi våre nøkkelmål:
- Sikre tilgjengeligheten av våre data.
- Sikre åpenheten i datalivssyklusen.
- Gi selskapets brukere samsvarende og konsistente data.
- Gi selskapets brukere pålitelige data.
I dag finnes det ti-talls verktøy av Data Governance-klassen på programvaremarkedet.
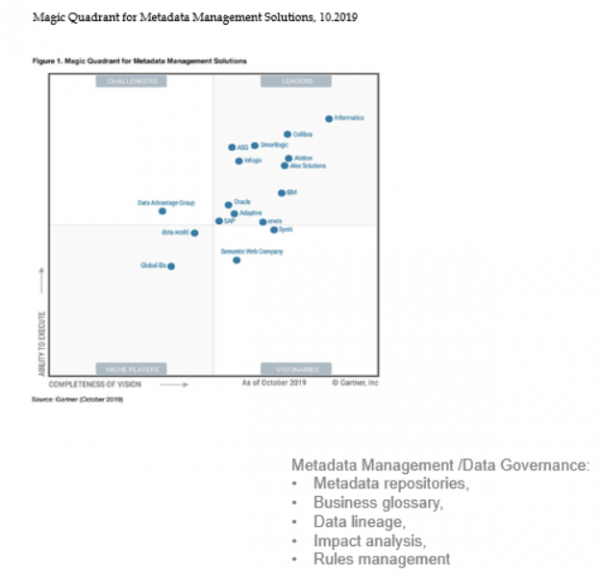
Men etter en grundig analyse og undersøkelse av løsningene, har vi notert flere kritiske bemerkninger:
- De fleste produsenter tilbyr et omfattende sett av løsninger som for oss er overflødige og dupliserer eksisterende funksjonalitet. I tillegg er integrasjonen i det nåværende IT-landskapet ressurskrevende.
- Funksjonalitet og grensesnitt er laget for teknologer, ikke sluttbrukere i virksomheten.
- Lav overlevelsesrate for produkter og mangel på vellykkede implementeringer på det russiske markedet.
- Høy kostnad for programvare og videre støtte.
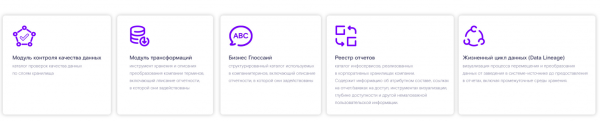
Kriteriene og anbefalingene nevnt ovenfor angående programvareforvaltning for russiske selskaper overbeviste oss om å gå i retning av egen utvikling på opensource-stacken. Vi valgte Django som plattform – et gratis og åpen kildekode rammeverk skrevet i Python. Slik har vi definert nøkkelmødule som vil støtte de nevnte målene:
- Rapportregister.
- Forretningsglossar.
- Modul for beskrivelse av tekniske transformasjoner.
- Modul for beskrivelse av livssyklusen til data fra kilde til BI-verktøy.
- Modul for datakvalitetskontroll.
Rapportregister
Ifølge interne undersøkelser i store selskaper bruker ansatte 40–80% av tiden sin på å finne data når de løser datarelaterte oppgaver. Derfor har vi satt oss som mål å gjøre informasjon om eksisterende rapporter, som tidligere kun var tilgjengelig for bestillerne, gjennomsiktig. Dermed reduserer vi tiden brukt på å lage ny rapportering og sikrer demokratisering av data.
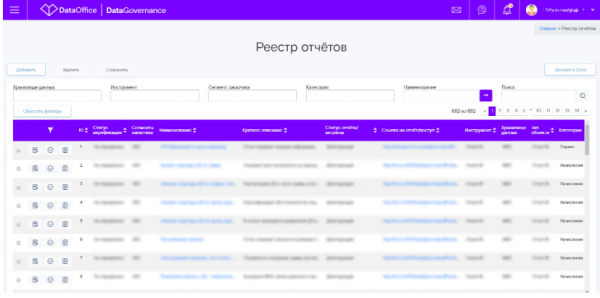
Rapportregisteret har blitt en enhetlig rapporteringsplattform for interne brukere fra ulike regioner, avdelinger og seksjoner. Det inneholder informasjon om informasjonstjenester opprettet i flere bedriftslagre, og det er mange i Rostelecom.
Men registeret er ikke bare en tørr liste over utviklede rapporter. For hver rapport gir vi informasjon som brukeren trenger for å bli kjent med den på egen hånd:
- kort beskrivelse av rapporten;
- dybde av tilgjengelighet av data;
- kundesegment;
- visualiseringsverktøy;
- navn på det bedriftslagret;
- forretningsfunksjonelle krav;
- lenke til rapporten;
- lenke til forespørsel om tilgang;
- implementeringsstatus.
Rapportene gir en analyse av brukenivået, og rapportene kommer på topplisten basert på logganalysen av antall unike brukere. Og dette er ikke alt. I tillegg til de generelle egenskapene har vi også inkludert en detaljert beskrivelse av attributtinnholdet i rapportene med eksempelverdier og beregningsmetodikk. Denne detaljeringen gir umiddelbart brukeren svar på om rapporten er nyttig eller ikke.
Utviklingen av denne modulen har vært et viktig skritt mot demokratisering av data, og den har betydelig redusert tiden det tar å finne nødvendig informasjon. I tillegg til å redusere søketid er det også redusert antall henvendelser til supportteamet for rådgivning. Det er verdt å merke seg et annet nyttig resultat vi har oppnådd ved å utvikle et enhetlig register over rapporter – å forhindre utvikling av dupliserende rapporter for ulike strukturelle enheter.
Forretningsordliste
Alle vet at selv innenfor samme selskap snakker forretningen på forskjellige språk. Ja, de bruker de samme termene, men forstår helt forskjellige ting under dem. Forretningsordlisten er ment å løse dette problemet.
For oss er forretningsordlisten ikke bare et oppslagsverk med beskrivelser av termer og beregningsmetodikk. Det er et fullverdig utviklingsmiljø for samordning og godkjenning av terminologi, samt for oppbygging av relasjoner mellom termer og andre informasjonsaktiva i selskapet. Før en term kan komme inn i forretningsordlisten, må den gjennomgå alle samsvarssteg med forretningsbestillerne og datasenteret for kvalitet. Kun etter dette blir den tilgjengelig for bruk.
Som jeg allerede har skrevet ovenfor, er unikheten til dette verktøyet at det lar brukerne spore forbindelser fra forretningsbegrepsnivået til spesifikke brukerdefinerte rapporter der det brukes, samt til nivået av fysiske objekter i databasene.
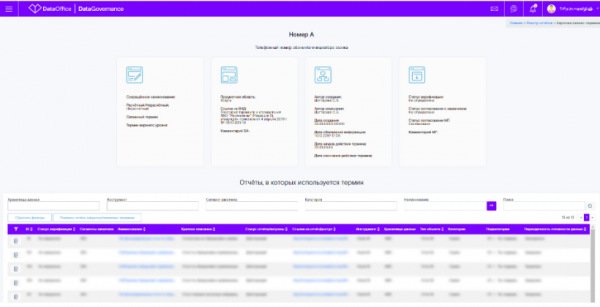
Dette ble muliggjort ved bruk av identifikatorene til ordlister i den detaljerte beskrivelsen av rapportene fra registeret og i beskrivelsen av de fysiske objektene i databasene.
I dag er det definert og godkjent over 4000 termer i ordlisten. Bruken av den forenkler og akselererer behandlingen av forespørslene om endringer i selskapets informasjonssystemer. Hvis den nødvendige indikatoren allerede er implementert i en rapport, vil brukeren umiddelbart se en rekke ferdige rapporter der denne indikatoren er brukt, og vil kunne ta en beslutning om effektiv gjenbruk av eksisterende funksjonalitet eller minimal tilpasning, uten å initiere nye forespørsel om utvikling av en ny rapport.
Modul for beskrivelse av tekniske transformasjoner og DataLineage
Du lurer kanskje på hva disse modulene er? Det er ikke nok bare å implementere rapportregisteret og ordlisten, man må også kartlegge alle forretningsbegrepene på den fysiske datamodellen. På denne måten har vi kunnet fullføre prosessen med å forme livssyklusen til data fra kildesystemene til BI-visualisering gjennom alle lagene i datalageret. Med andre ord — bygge DataLineage.
Vi har utviklet et grensesnitt basert på det formatet som tidligere ble brukt i selskapet til å beskrive reglene og logikken for datatransformasjon. Gjennom grensesnittet samles den samme informasjonen som før, men det er nå et obligatorisk krav å definere identifikatoren til termen fra forretningsordlisten. På den måten bygger vi bro mellom forretnings- og fysiske lag.
Hvem trenger dette? Hva var galt med det gamle formatet vi har jobbet med i flere år? Hvor mye har arbeidsbelastningen økt for å utforme krav? Vi har måttet håndtere slike spørsmål under implementeringen av verktøyet. Her er svarene ganske enkle – dette er nødvendig for oss alle, dataavdelingen i selskapet vårt og våre brukere.
Det var sant at ansatte måtte omstille seg; i begynnelsen førte dette til små økninger i arbeidsmengden for dokumentasjonsforberedelse, men vi løste det. Praksis, identifisering og optimalisering av problemområder gjorde sitt. Vi oppnådde hovedmålet — vi hevet kvaliteten på de utarbeidede kravene. Obligatoriske felt, standardiserte referanser, inndata-maler og innebygde kontroller — alt dette har betydelig hevet kvaliteten på beskrivelsene av transformasjoner. Vi har gått bort fra praksisen med å overlevere skript som krav til utvikling, og delt kunnskap som tidligere bare var tilgjengelig for utviklingsteamet. Den etablerte metadata-basen reduserer tiden brukt på regresjonsanalyse betydelig, og gir mulighet for rask vurdering av endringer på alle lag i IT-landskapet (rapporter, aggregater, kilder).
Og hva har vanlige brukere av rapportene med dette å gjøre? Hvilke fordeler finnes for dem? Takket være muligheten til å bygge DataLineage, får våre brukere — selv de som er langt unna SQL og andre programmeringsspråk — raskt informasjon om kilder og objekter som rapportene er basert på.
Modul for datakvalitetskontroll
Alt vi har diskutert ovenfor i forhold til å sikre datatransparens, er uvesentlig uten forståelsen av at dataene vi gir til brukerne er korrekte. En av de viktige modulene i vår Data Governance-konsept er modulen for datakvalitetskontroll.
På nåværende stadium er dette en katalog over kontroller for utvalgte enheter. Den nærmeste utviklingsmålet for produktet er å utvide sjekklisten og integrere den med registeret for rapporter.
Hva vil dette gi og for hvem? For sluttbrukeren av registeret vil det være tilgjengelig informasjon om planlagte og faktiske datoer for ferdigstilling av rapporten, resultatene av gjennomførte kontroller med dynamikk, og opplysninger om kildene som er lastet inn i rapporten.
For oss er modulen for datakvalitet integrert i arbeidsprosessene:
- Raske forventningsformuleringer fra kundene.
- Beslutninger om videre bruk av data.
- Mottak av foreløpige sett med problemområder i de tidlige fasene av arbeidet for å utvikle regelmessige kontroller av kvalitet.
Utan tvil er dette de første skrittene mot å bygge en fullverdig datastyringsprosess. Men vi er overbevist om at ved å målrettet jobbe med dette, og aktivt implementere DataGovernance-verktøy i arbeidsprosessen, vil vi sikre våre kunder informasjonsverdi, høy grad av datatroverdighet, transparens i datainnhentingen og øke hastigheten på lanseringen av ny funksjonalitet.
DataOffice-teamet
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish