

I forkynne for starten av kurset har forberedt oversettelsen av enda et nyttig materiale for deg.
Huffman-koding er en datakomprimeringsalgoritme som formulerer hovedideen om filkomprimering. I denne artikkelen skal vi snakke om koding med fast og variabel lengde, unikt dekodbare koder, prefiksregler og bygging av Huffman-treet.
Vi vet at hvert tegn lagres som en sekvens av 0 og 1 og tar 8 biter. Dette kalles fast lengdekoding, ettersom hvert tegn bruker et fast antall biter til lagring.
La oss si at vi har en tekst. Hvordan kan vi redusere plassen som kreves for å lagre ett tegn?
Hovedideen er å bruke variabel lengdekoding. Vi kan utnytte det faktum at noen tegn i teksten forekommer oftere enn andre (), for å utvikle en algoritme som representerer den samme sekvensen av tegn med færre biter. Ved variabel lengdekoding tildeler vi tegn variable antall biter avhengig av hvor ofte de forekommer i den aktuelle teksten. Til slutt kan noen tegn ta bare 1 bit, mens andre tar 2 biter, 3 eller mer. Problemet med variabel lengdekoding ligger bare i den påfølgende dekodingen av sekvensen.
Hvordan kan vi, ved å kjenne sekvensen av biter, dekode den entydig?
La oss se på strengen «aabacdab». Den inneholder 8 tegn, og ved fast lengdekoding vil lagringen kreve 64 biter. La oss merke oss at frekvensen av tegnene «a», «b», «c» og «d» er 4, 2, 1, 1 henholdsvis. La oss prøve å representere «aabacdab» med færre biter ved å bruke det faktum at «a» forekommer oftere enn «b»., men «b». forekommer oftere enn «c» og «d»Vi starter med å kode «a» med én bit, lik 0, «b». vi vil tildele en to-bits kode 11, og med tre biter 100 og 011 vil vi kode «c» og «d».
Til slutt får vi:
a
0
b
11
med
100
d
011
Dermed vil strengen «aabacdab» blir kodet som 00110100011011 (0|0|11|0|100|011|0|11), ved å bruke kodene nevnt ovenfor. Men hovedproblemet vil være dekodingen. Når vi prøver å dekode strengen 00110100011011, vil vi få et tvetydig resultat ettersom den kan representeres som:
0|011|0|100|011|0|11    adacdab
0|0|11|0|100|0|11|011   aabacabd
0|011|0|100|0|11|0|11   adacabab
…
osv.
For å unngå denne tvetydigheten, må vi sikre at kodingen vår oppfyller begrepet prefiksregel, som igjen innebærer at koder kan dekodes på kun én unik måte. Prefiksregelen sikrer at ingen kode er en prefiks av en annen. Med kode mener vi bitene som brukes til å representere et spesifikt symbol. I eksempelet ovenfor 0 – er en prefiks 011, noe som bryter prefiksregelen. Så hvis kodene våre oppfyller prefiksregelen, kan dekodingen utføres entydig (og omvendt).
La oss revidere eksemplet ovenfor. Denne gangen skal vi tildele symbolene «a», «b», «c» og «d» koder som oppfyller prefiksregelen.
a
0
b
10
med
110
d
111
Ved bruk av en slik koding vil strengen «aabacdab» bli kodet som 00100100011010 (0|0|10|0|100|011|0|10). Men en 00100100011010 vi vil allerede kunne dekode entydig og gå tilbake til vår opprinnelige streng «aabacdab».
Huffman-koding
Nå som vi har forstått koding med variabel lengde og prefiksregelen, la oss snakke om Huffman-koding.
Metoden er basert på å lage binære trær. I dette kan en node være enten en bladnode eller en indre node. Opprinnelig betraktes alle noder som blader (endlige) som representerer selve symbolet og vekten (altså forekomsten). Indre noder inneholder vekten av symbolet og peker på to etterkommere. I henhold til vanlig praksis representerer biten «0» følgelsen av den venstre grenen, og «1» den høyre. I et komplett tre er det N blader og N-1 indre noder. Det anbefales at når du bygger Huffman-treet, utelates ubrukt symboler for å få koder av optimal lengde.
Vi vil bruke en prioritetskø til å bygge Huffman-treet, der noden med lavest frekvens får høyest prioritet. Nedenfor beskrives trinnene for byggingen:
- Opprett en bladnode for hvert symbol og legg dem i prioritetskøen.
- Så lenge det er mer enn én bladnode i køen, gjør følgende:
- Fjern to noder med høyest prioritet (lavest frekvens) fra køen;
- Opprett en ny indre node der disse to nodene er etterkommere, og forekomsten vil være lik summen av forekomstene til de to nodene.
- Legg den nye noden til prioritetskøen.
- Den eineste attande noden vil være roten, på dette vil byggingen av treet avsluttes.
La oss anta at vi har en tekst som kun består av tegn «a», «b», «c», «d» og «e», og frekvensene for deres opptreden er henholdsvis 15, 7, 6, 6 og 5. Nedenfor er illustrasjoner som reflekterer trinnene i algoritmen.
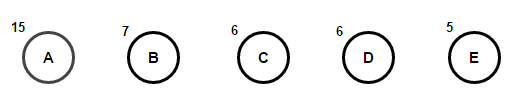
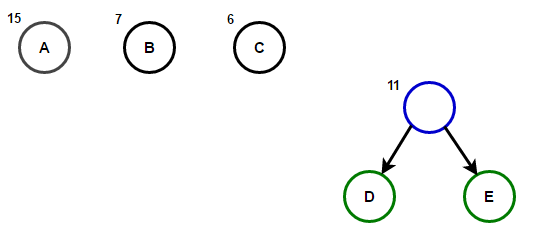
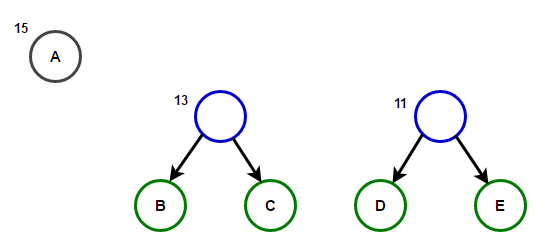
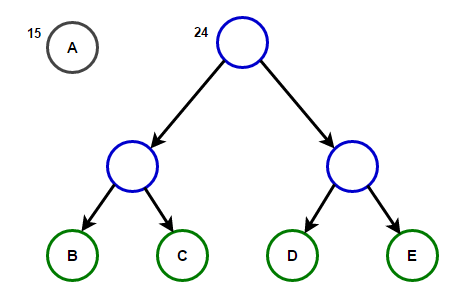
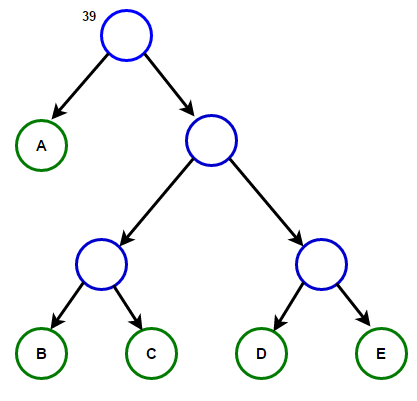
Veien fra roten til enhver slutt-nod vil lagre den optimale prefiks koden (også kjent som Huffman-koden) som tilsvarer tegnet knyttet til denne slutt-noden.
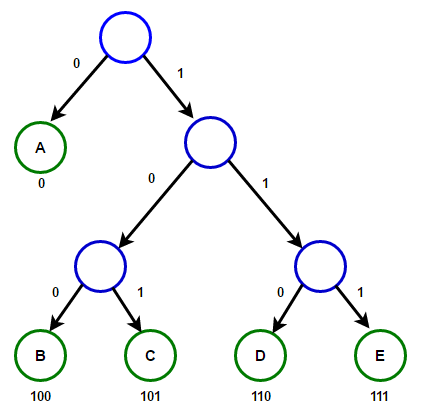
Huffman-tre
Nedenfor finner du implementeringen av Huffman-kompresjonsalgoritmen på C++ og Java:
#include <iostream>
#include <string>
#include <queue>
#include <unordered_map>
using namespace std;

// A Tree node
struct Node
{
	char ch;
	int freq;
	Node *left, *right;
};

// Function to allocate a new tree node
Node* getNode(char ch, int freq, Node* left, Node* right)
{
	Node* node = new Node();

	node->ch = ch;
	node->freq = freq;
	node->left = left;
	node->right = right;

	return node;
}

// Comparison object to be used to order the heap
struct comp
{
	bool operator()(Node* l, Node* r)
	{
		// highest priority item has lowest frequency
		return l->freq > r->freq;
	}
};

// traverse the Huffman Tree and store Huffman Codes
// in a map.
void encode(Node* root, string str,
			unordered_map<char, string> &huffmanCode)
{
	if (root == nullptr)
		return;

	// found a leaf node
	if (!root->left && !root->right) {
		huffmanCode[root->ch] = str;
	}

	encode(root->left, str + "0", huffmanCode);
	encode(root->right, str + "1", huffmanCode);
}

// traverse the Huffman Tree and decode the encoded string
void decode(Node* root, int &index, string str)
{
	if (root == nullptr) {
		return;
	}

	// found a leaf node
	if (!root->left && !root->right)
	{
		cout << root->ch;
		return;
	}

	index++;

	if (str[index] =='0')
		decode(root->left, index, str);
	else
		decode(root->right, index, str);
}

// Builds Huffman Tree and decode given input text
void buildHuffmanTree(string text)
{
	// count frequency of appearance of each character
	// and store it in a map
	unordered_map<char, int> freq;
	for (char ch: text) {
		freq[ch]++;
	}

	// Create a priority queue to store live nodes of
	// Huffman tree;
	priority_queue<Node*, vector<Node*>, comp> pq;

	// Create a leaf node for each character and add it
	// to the priority queue.
	for (auto pair: freq) {
		pq.push(getNode(pair.first, pair.second, nullptr, nullptr));
	}

	// do till there is more than one node in the queue
	while (pq.size() != 1)
	{
		// Remove the two nodes of highest priority
		// (lowest frequency) from the queue
		Node *left = pq.top(); pq.pop();
		Node *right = pq.top();	pq.pop();

		// Create a new internal node with these two nodes
		// as children and with frequency equal to the sum
		// of the two nodes' frequencies. Add the new node
		// to the priority queue.
		int sum = left->freq + right->freq;
		pq.push(getNode(' ', sum, left, right));
	}

	// root stores pointer to root of Huffman Tree
	Node* root = pq.top();

	// traverse the Huffman Tree and store Huffman Codes
	// in a map. Also prints them
	unordered_map<char, string> huffmanCode;
	encode(root, "", huffmanCode);

	cout << "Huffman Codes are :n" << 'n';
	for (auto pair: huffmanCode) {
		cout << pair.first << " " << pair.second << 'n';
	}

	cout << "nOriginal string was :n" << text << 'n';

	// print encoded string
	string str = "";
	for (char ch: text) {
		str += huffmanCode[ch];
	}

	cout << "nEncoded string is :n" << str << 'n';

	// traverse the Huffman Tree again and this time
	// decode the encoded string
	int index = -1;
	cout << "nDecoded string is: n";
	while (index < (int)str.size() - 2) {
		decode(root, index, str);
	}
}

// Huffman coding algorithm
int main()
{
	string text = "Huffman coding is a data compression algorithm.";

	buildHuffmanTree(text);

	return 0;
}
import java.util.HashMap;
import java.util.Map;
import java.util.PriorityQueue;
// A Tree node
class Node
{
char ch;
int freq;
Node left = null, right = null;
Node(char ch, int freq)
{
this.ch = ch;
this.freq = freq;
}
public Node(char ch, int freq, Node left, Node right) {
this.ch = ch;
this.freq = freq;
this.left = left;
this.right = right;
}
};
class Huffman
{
// traverse the Huffman Tree and store Huffman Codes
// in a map.
public static void encode(Node root, String str,
Map huffmanCode)
{
if (root == null)
return;
// found a leaf node
if (root.left == null && root.right == null) {
huffmanCode.put(root.ch, str);
}
encode(root.left, str + "0", huffmanCode);
encode(root.right, str + "1", huffmanCode);
}
// traverse the Huffman Tree and decode the encoded string
public static int decode(Node root, int index, StringBuilder sb)
{
if (root == null)
return index;
// found a leaf node
if (root.left == null && root.right == null)
{
System.out.print(root.ch);
return index;
}
index++;
if (sb.charAt(index) == '0')
index = decode(root.left, index, sb);
else
index = decode(root.right, index, sb);
return index;
}
// Builds Huffman Tree and huffmanCode and decode given input text
public static void buildHuffmanTree(String text)
{
// count frequency of appearance of each character
// and store it in a map
Map freq = new HashMap();
for (int i = 0 ; i < text.length(); i++) {
if (!freq.containsKey(text.charAt(i))) {
freq.put(text.charAt(i), 0);
}
freq.put(text.charAt(i), freq.get(text.charAt(i)) + 1);
}
// Create a priority queue to store live nodes of Huffman tree
// Notice that highest priority item has lowest frequency
PriorityQueue pq = new PriorityQueue (
(l, r) -> l.freq - r.freq);
// Create a leaf node for each character and add it
// to the priority queue.
for (Map.Entry entry : freq.entrySet()) {
pq.add(new Node(entry.getKey(), entry.getValue()));
}
// do till there is more than one node in the queue
while (pq.size() != 1)
{
// Remove the two nodes of highest priority
// (lowest frequency) from the queue
Node left = pq.poll();
Node right = pq.poll();
// Create a new internal node with these two nodes as children
// and with frequency equal to the sum of the two nodes
// frequencies. Add the new node to the priority queue.
int sum = left.freq + right.freq;
pq.add(new Node(' ', sum, left, right));
}
// root stores pointer to root of Huffman Tree
Node root = pq.peek();
// traverse the Huffman tree and store the Huffman codes in a map
Map huffmanCode = new HashMap();
encode(root, "", huffmanCode);
// print the Huffman codes
System.out.println("Huffman Codes are :\n");
for (Map.Entry entry : huffmanCode.entrySet()) {
System.out.println(entry.getKey() + " " + entry.getValue());
}
System.out.println("\nOriginal string was :\n" + text);
// print encoded string
StringBuilder sb = new StringBuilder();
for (int i = 0 ; i < text.length(); i++) {
sb.append(huffmanCode.get(text.charAt(i)));
}
System.out.println("\nEncoded string is :\n" + sb);
// traverse the Huffman Tree again and this time
// decode the encoded string
int index = -1;
System.out.println("\nDecoded string is: \n");
while (index < sb.length() - 2) {
index = decode(root, index, sb);
}
}
public static void main(String[] args)
{
String text = "Huffman coding is a data compression algorithm.";
buildHuffmanTree(text);
}
}Merk: Minne som brukes av inngangsstrengen er 47 * 8 = 376 biter, men den kodede strengen tar kun 194 biter, det vil si at dataene komprimeres med omtrent 48 %. I C++-programmet ovenfor bruker vi klassen string for å lagre den kodede strengen for å gjøre programmet lesbart.
Siden effektive datastrukturer for prioritetskøer krever O(log(N)) tid for innsetting, og i et komplett binært tre med N bladene er det 2N-1 noder, og Huffman-treet er et komplett binært tre, så algoritmen kjører på O(Nlog(N)) tid, hvor N er antallet symboler.
Kilder:
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish