

Nyleg fortalte jeg om hvordan man kan bruke standardoppskrifter fra PostgreSQL-database. I dag skal vi snakke om hvordan man kan gjøre skrivingen til DB mer effektiv uten å bruke noen "justeringer" i konfigurasjonen — bare ved å organisere datastreamene riktig.
#1. Секционирование
Artikkelen handler om hvordan og hvorfor man bør organisere har allerede vært, her skal vi snakke om praktisk anvendelse av noen metoder innenfor vår .
«Tider fra gamle dager…»
Opprinnelig, som enhver MVP, startet prosjektet vårt med en relativt liten belastning — overvåkningen ble bare utført for et titalls kritiske servere, alle tabeller var relativt kompakte… Men tiden gikk, antallet overvåkede verter økte, og da vi igjen prøvde å håndtere en av tabellene med en størrelse på 1,5 TB, innså vi at selv om det var mulig å leve slik, var det veldig ubeleilig.
Tidene var nesten legendariske, ulike versjoner av PostgreSQL 9.x var aktuelle, så all sekregering måtte gjøres "manuelt" — gjennom arv fra tabeller og triggere routing med dynamisk EXECUTE.
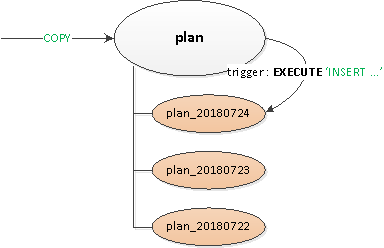
Den resulterende løsningen viste seg å være tilstrekkelig universell til at man kunne oversette den til alle tabeller:
- En tom "header"-foreldretabell ble erklært, der alle nødvendige indekser og triggere ble beskrevet.
- Skrivningen fra klientens synspunkt ble utført i "roottabellen", mens inne i tabellen ble det brukt routing-trigger
FØR SETTINGskrevningen "fysisk" ble satt inn i den nødvendige seksjonen. Hvis den ennå ikke eksisterte — fanget vi unntaket og … - … ved hjelp av ble det opprettet en seksjon med begrensning på den nødvendige datoen, slik at ved datainnhenting ble lesingen utført utelukkende i den.
PG10: første forsøk
Men sekregering via arv var historisk ikke spesielt tilpasset for arbeid med en aktiv skriving eller et stort antall sektioner-arvinger. For eksempel kan vi huske at algoritmen for valg av nødvendig seksjon hadde kvadratisk kompleksitet, hvilket med 100+ seksjoner fungerer, som man forstår...
I PG10 ble denne situasjonen sterkt optimalisert ved å implementere støtte for . Så vi prøvde umiddelbart å bruke det rett etter migreringen av lagringen, men…
Som det ble klart etter å ha grått i manualen, støtter en naturlig partisjonert tabell i denne versjonen:
- ikke beskrivelse av indekser
- støtter ikke triggere
- kan ikke være ingen 'etterkommer'
- støtter ikke
INSERT ... ON CONFLICT - kan ikke automatisk generere en seksjon
Vi fikk oss et skulderslag og innså at vi ikke kunne klare oss uten å modifisere applikasjonen, og utsetter videre forskning i et halvt år.
PG10: en ny sjanse
Så vi begynte å løse de oppståtte problemene en etter en:
- Siden triggere og
ON CONFLICTble vi å finne dem nødvendige noen steder, laget vi en mellomliggende proxy-tabell. - Vi fjernet 'routingen' i triggerne — det vil si
EXECUTE. - Vi tok ut mal-tabellen med alle indeksene, slik at de ikke engang var til stede i proxy-tabellen.
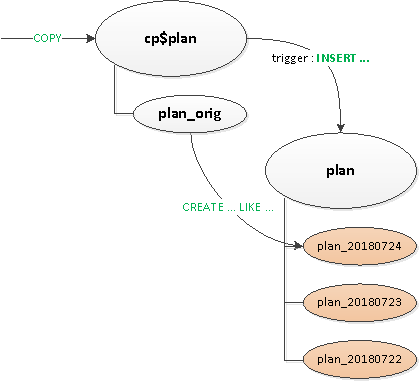
Til slutt, etter alt dette, ble hovedtabellen naturlig partisjonert. Opprettelsen av en ny seksjon forblir fortsatt på applikasjonens samvittighet.
Vi 'bearbeider' ordbøker
Som i ethvert analysesystem, hadde vi også fakta og skjæringspunkter (ordbøker). I vårt tilfelle, fungerte for eksempel av ensartede langsomme forespørselen eller teksten i selve forespørselen.
Faktaene våre hadde vært partisjonert etter dager lenge, så vi fjernet trygt utdaterte seksjoner, og de plaget oss ikke (loggene da!). Men ordbøker ble et problem…
Det kan ikke sies at de var veldig mange, men omtrent for 100TB 'fakta' fikk vi et ordbok på 2,5TB.. Fra en slik tabell er det praktisk talt umulig å slette noe, å komprimere den for rimelig tid, og skriving til den ble gradvis mer og mer tidkrevende.
Det virker som en ordbok… hver oppføring må være representert nøyaktig én gang… og det er riktig, men!.. Ingen hindrer oss i å ha en egen ordbok for hver dag! Ja, det gir en viss overflødighet, men tillater:
- å skrive/lese raskere på grunn av mindre størrelse på seksjonen
- å bruke mindre minne på grunn av arbeid med mer kompakte indekser
- å lagre mindre data på grunn av muligheten til raskt å slette utdaterte
Som et resultat av hele tiltaket falt CPU-belastningen med ~30%, og diskbelastningen med ~50%:
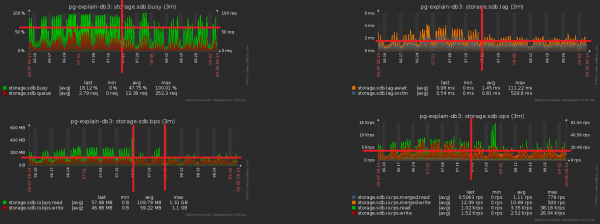
Samtidig fortsatte vi å skrive inn i databasen nøyaktig det samme, bare med mindre belastning.
#2. Эволюция и рефакторинг БД
Så vi stoppet på det punktet at vi har en seksjon for hver dag med data. Egenspeiset, CHECK (dt = '2018-10-12'::date) — og det er nøkkelen til partisjonering og betingelsen for at en post havner i en bestemt seksjon.
Siden alle rapporter i tjenesten vår er bygget på spesifikke datoer, har også indeksene fra "de ikke-partisjonerte tidene" alltid vært av typen (Server, Dato, Planmal), (Server, Dato, PlanNode), (Dato, Feilklasse, Server),…
Men nå lever hver av disse seksjonene med sine egne instanser av hver slik indeks… Og innen hver seksjondatoen er en konstant … Det viser seg at vi nå skriver inn konstanten som et av feltene, noe som øker både volumet og søketiden, men gir ingen resultater. Vi har lagt ut feller for oss selv, ups…
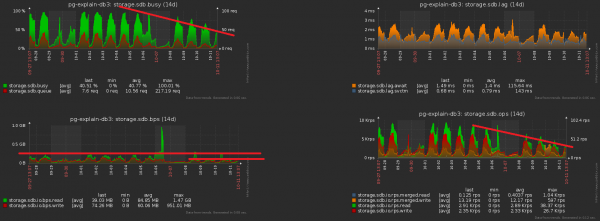
Retningen for optimalisering er åpenbar — bare fjerne dato-feltet fra alle indekser på partisjonerte tabeller. Med våre volumer er gevinsten rundt 1 TB/uke!
Og nå la oss merke at denne terabyte måtte også skrives på en eller annen måte. Det vil si at vi nå må belaste disken mindre! På dette bildet er effekten av rensingen vi viet en uke til godt synlig:
#3. «Размазываем» пиковую нагрузку
En av de store utfordringene med tunge systemer er overflødig synkronisering av operasjoner som ikke krever det. Noen ganger «fordi vi ikke la merke til det», noen ganger «fordi det var enklere», men før eller senere må vi bli kvitt det.
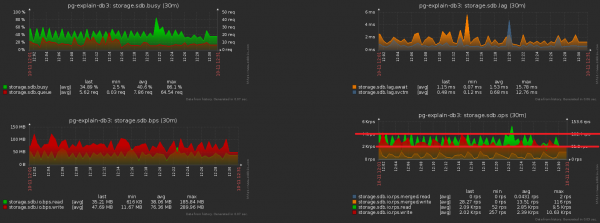
Vi forstørrer forrige bilde — og ser at disken vår «henter» med dobbel amplitude mellom nabomålingene, noe som åpenbart «statistisk» ikke burde være ved så mange operasjoner:
Det er ganske enkelt å oppnå. Vi hadde allerede nesten 1000 servere, hver behandles av en egen logisk strøm, og hver strøm slipper den akkumulerte informasjonen for å sende til databasen med en bestemt periode, omtrent sånn:
setInterval(sendToDB, interval)Problemet ligger nøyaktig i det at alle strømmer starter omtrent samtidig, derfor tidspunktet for sendingen deres nesten alltid sammenfaller «til punktet». Ups nr. 2…
Heldigvis er dette ganske lett å fikse, ved å legge til «tilfeldig» spredning over tid:
setInterval(sendToDB, interval * (1 + 0.1 * (Math.random() - 0.5)))#4. Кэшируем, что нужно можно
Det tredje tradisjonelle problemet med highload — mangel på cache der det skulle kunna må være.
For example, we have implemented the ability to analyze by nodes of the plan (all these Seq Scan on users), but to immediately think that they are, in bulk, the same — is a mistake.
No, of course, nothing is written back to the database, this filters the trigger with INSERT ... ON CONFLICT DO NOTHING. But still, this data reaches the database, and there’s also unnecessary reading for conflict checking that has to be done. Oops №3…
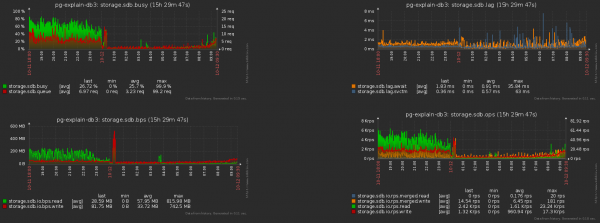
The difference in the number of records sent to the database before/after caching is enabled — is obvious:
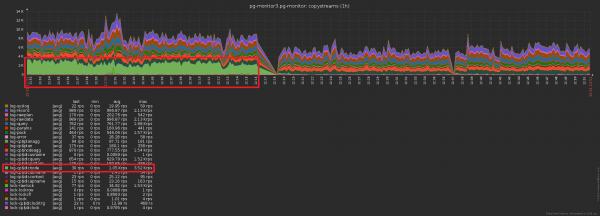
And this is the accompanying drop in storage load:
Totalt
"Terabyte-per-day" may sound frightening. If you do everything correctly, it's just 2^40 bytes / 86400 seconds = ~12.5MB/s, which even desktop IDE drives could handle. 🙂
And seriously, even with a tenfold "skew" in load over the day, you can easily stay within the capabilities of modern SSDs.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish