

Fortsett med temaet for registrering av store datastreamer, tatt opp , her ser vi på metodene for å redusere den «fysiske» størrelsen på lagret i PostgreSQL, og deres innvirkning på serverytelsen.
Det vil bli snakk om TOAST-innstillinger og datalignering. «I gjennomsnitt» vil disse metodene ikke spare så mye ressurser, men — helt uten modifikasjon av applikasjonskoden.
Likevel, vår erfaring har vist seg å være ganske produktiv på dette området, ettersom lagringsløsningen for nesten all overvåking i sin natur er for det meste append-only når det gjelder de innspilte dataene. Og hvis du er interessert i hvordan du kan lære databasen å skrive til disk i stedet for 200MB/s halvparten så mye — vennligst les videre.
Små hemmeligheter om store data
I profileringen av , får den regelmessig tekstpakker fra loggene.
Og siden , hvis databaser vi overvåker, er et flerfaglig produkt med komplekse datamodeller, er forespørslene for å oppnå maksimal ytelse helt klart . Så størrelsen på hver enkelt forespørsel eller den resulterende utførelsesplanen i loggene som kommer til oss viser seg å være «i gjennomsnitt» ganske stor.
La oss ta en titt på strukturen til en av tabellene hvor vi skriver «rå» data — det vil si, den originale teksten fra loggoppføringen:
CREATE TABLE rawdata_orig(
  pack -- PK
    uuid NOT NULL
, recno -- PK
    smallint NOT NULL
, dt -- partisjonsnøkkel
    date
, data -- det viktigste
    text
, PRIMARY KEY(pack, recno)
);
En typisk tabell (allerede partisjonert, selvfølgelig, så dette er en mal for partisjonen), der det viktigste er teksten. Noen ganger ganske omfattende.
La oss huske at den «fysiske» størrelsen på en post i PG ikke kan ta mer enn én datakilde, men den «logiske» størrelsen er helt forskjellig. For å skrive en stor verdi i et felt (varchar/text/bytea) brukes :
PostgreSQL bruker en fast side størrelse (vanligvis 8 KB), og tillater ikke at tuppler tar opp flere sider. Dermed er det ikke mulig å lagre veldig store felter direkte. For å overvinne denne begrensningen, blir store feltverdier komprimert og/eller delt opp i flere fysiske rader. Dette skjer usynlig for brukeren og påvirker i liten grad størstedelen av serverkoden. Denne metoden er kjent som TOAST ...
Faktisk, for hver tabell med "potensielt store" felt, opprettes automatisk av hver "stor" post i segmenter på 2KB:
TOAST(
  chunk_id
    integer
, chunk_seq
    integer
, chunk_data
    bytea
, PRIMARY KEY(chunk_id, chunk_seq)
);
Det vil si, hvis vi må skrive en rad med et "stort" verdi data, vil den faktiske innspillingen skje ikke bare i hovedtabellen og dens PK, men også i TOAST og dens PK.
Redusere TOAST-påvirkningen
Men de fleste postene våre er likevel ikke så store, de burde passe inn i 8KB — hvordan kan vi spare på dette?..
Her kommer attributtet til hjelp i tabellkolonnen:
- EXTENDED tillater både komprimering og separat lagring. Dette er standardalternativet for de fleste datatyper som er kompatible med TOAST. Først forsøkes det å komprimere, deretter - å lagre utenfor tabellen, hvis raden fortsatt er for stor.
- MAIN tillater komprimering, men ikke separat lagring. (Faktisk vil separat lagring likevel bli utført for slike kolonner, men bare som en siste utvei, når det ikke er andre måter å redusere raden så den får plass på siden.)
Faktisk er dette akkurat det vi trenger for tekst – komprimere maksimalt, og hvis det absolutt ikke får plass – flytte til TOAST. Dette kan gjøres direkte "on the fly", med én kommando:
ALTER TABLE rawdata_orig ALTER COLUMN data SET STORAGE MAIN;Hvordan vurdere effekten
Siden datatroppene endres hver dag, kan vi ikke sammenligne absolutte tall, men relativt jo mindre andel vi har skrevet til TOAST – jo bedre. Men det er en fare – jo større "fysisk" volum av hver enkelt post, jo "bredere" blir indeksen, fordi man må dekke flere datalagsider.
Seksjon før endringer:
heap  = 37GB (39%)
TOAST = 54GB (57%)
PK    =  4GB ( 4%)
Seksjon etter endringer:
heap  = 37GB (67%)
TOAST = 16GB (29%)
PK    =  2GB ( 4%)
Faktisk har vi begynt å skrive til TOAST 2 ganger sjeldnere, som lettet ikke bare disken, men også CPU-en:
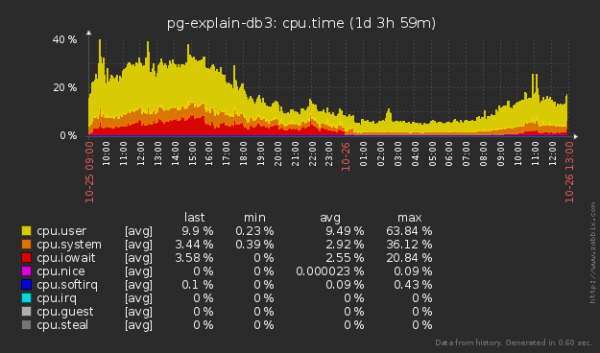
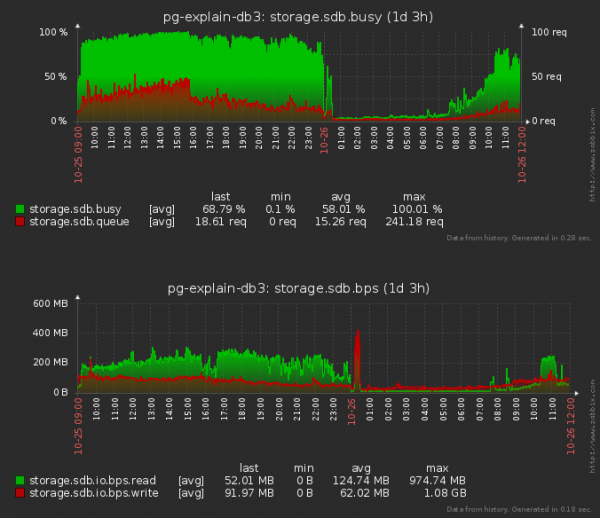
Jeg bemerker at vi også «leser» disken mindre, og ikke bare «skriver» — fordi når vi setter inn en post i en tabell, må vi «lese» også en del av treet til hver av indeksene for å fastslå dens fremtidige posisjon i dem.
Hvem har det bra med PostgreSQL 11
Etter oppdateringen til PG11 bestemte vi oss for å fortsette med «tuning» av TOAST og la merke til at fra denne versjonen er parameteren blitt tilgjengelig for innstilling :
TOAST-behandlingskoden aktiveres bare når verdien av raden som skal lagres i tabellen, er større enn TOAST_TUPLE_THRESHOLD byte (vanligvis 2 Kb). TOAST-koden vil komprimere og/eller flytte feltverdier utenfor tabellen inntil verdien av raden er mindre enn TOAST_TUPLE_TARGET byte (variabel størrelse, også vanligvis 2 Kb) eller reduksjon av volumet ikke lenger er mulig.
Vi konkluderte med at dataene våre vanligvis enten er «ganske korte» eller umiddelbart «veldig lange», så vi bestemte oss for å begrense oss til den minimal-mulige verdien:
ALTER TABLE rawplan_orig SET (toast_tuple_target = 128);La oss se hvordan de nye innstillingene påvirket diskbelastningen etter omkonfigurering:
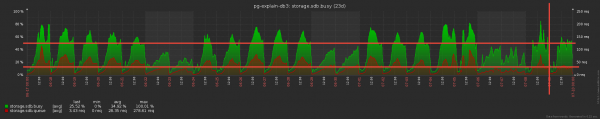
Ikke verst! Gjennomsnittlig diskkø redusert med omtrent 1,5 ganger, og «belegg» på disken har gått ned med 20%! Men kan det ha påvirket CPU-en på noen måte?
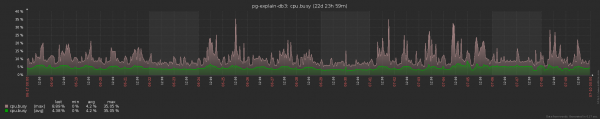
I det minste har det definitivt ikke blitt verre. Selv om det er vanskelig å bedømme, hvis selv slike volumer fortsatt ikke kan løfte den gjennomsnittlige CPU-belastningen over 5%.
Fra bytte av plass på leddene endres summen!
Som kjent sparer en kopeck en rubel, og med våre lagringsvolumer på omtrent 10TB/måned kan selv en liten optimalisering gi god profitt. Derfor la vi merke til den fysiske strukturen av våre data — hvordan spesifikt felt blir «pakket» inn i hver post i hver tabell.
Fordi på grunn av dette direkte :
Mange arkitekturer forutsetter justering av data ved grensen av registerstørrelser. For eksempel, på et 32-bits x86-system vil heltall (type integer, tar 4 byte) bli justert til en grense for 4-byte ord, så vel som dobbelt presisjon flyttall (type double precision, 8 byte). Og på et 64-bits system vil verdiene for double bli justert ved grensen for 8-byte ord. Dette er enda en grunn til inkompatibilitet.
På grunn av justeringen av tabellraden avhenger størrelsen av rekkefølgen på feltene. Vanligvis er denne effekten ikke så merkbar, men i noen tilfeller kan det føre til en betydelig økning i størrelsen. For eksempel, hvis man plasserer feltene av typene char(1) og integer om hverandre, vil det vanligvis mangle 3 byte mellom dem.
La oss starte med syntetiske modeller:
SELECT pg_column_size(ROW(
  '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
, '2019-01-01'::date
));
-- 48 byte

SELECT pg_column_size(ROW(
  '2019-01-01'::date
, '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
));
-- 46 byte
Hvor kom de ekstra byte fra i det første tilfellet? Det er enkelt – den 2-byte smallint justeres til en 4-byte grense før det neste feltet, og når det kommer sist, er det ingenting å justere.
I teorien er alt bra og man kan flytte på feltene som man vil. La oss teste med virkelige data med et eksempel fra en av tabellene, hvor den daglige seksjonen tar 10-15GB.
Den opprinnelige strukturen:
CREATE TABLE public.plan_20190220
(
-- Arvet fra tabell plan:  pack uuid NOT NULL,
-- Arvet fra tabell plan:  recno smallint NOT NULL,
-- Arvet fra tabell plan:  host uuid,
-- Arvet fra tabell plan:  ts timestamp with time zone,
-- Arvet fra tabell plan:  exectime numeric(32,3),
-- Arvet fra tabell plan:  duration numeric(32,3),
-- Arvet fra tabell plan:  bufint bigint,
-- Arvet fra tabell plan:  bufmem bigint,
-- Arvet fra tabell plan:  bufdsk bigint,
-- Arvet fra tabell plan:  apn uuid,
-- Arvet fra tabell plan:  ptr uuid,
-- Arvet fra tabell plan:  dt date,
  CONSTRAINT plan_20190220_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190220_dt_check CHECK (dt = '2019-02-20'::date)
)
INHERITS (public.plan)
Seksjonen etter endring av rekkefølgen på kolonnene – er akkurat de samme feltene, bare i en annen rekkefølge.:
CREATE TABLE public.plan_20190221
(
-- Arvet fra tabell plan:  dt date NOT NULL,
-- Arvet fra tabell plan:  ts timestamp with time zone,
-- Arvet fra tabell plan:  pack uuid NOT NULL,
-- Arvet fra tabell plan:  recno smallint NOT NULL,
-- Arvet fra tabell plan:  host uuid,
-- Arvet fra tabell plan:  apn uuid,
-- Arvet fra tabell plan:  ptr uuid,
-- Arvet fra tabell plan:  bufint bigint,
-- Arvet fra tabell plan:  bufmem bigint,
-- Arvet fra tabell plan:  bufdsk bigint,
-- Arvet fra tabell plan:  exectime numeric(32,3),
-- Arvet fra tabell plan:  duration numeric(32,3),
  CONSTRAINT plan_20190221_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190221_dt_check CHECK (dt = '2019-02-21'::date)
)
INHERITS (public.plan)
Den totale størrelsen på seksjonen bestemmes av antall «fakta» og avhenger kun av eksterne prosesser, så vi deler størrelsen på heap (pg_relation_size) for the number of entries in it — that is, we will get the average size of the actual stored record:
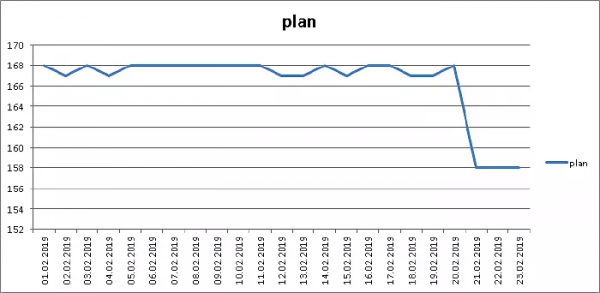
Minus 6% of the volume, excellent!
But not everything is so rosy — after all, we cannot change the order of fields in indexes, and therefore "in general" (pg_total_relation_size)…
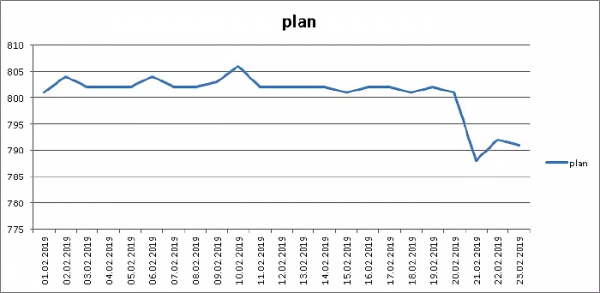
… yet here, too, we saved 1.5%, without changing a single line of code. Indeed!
I should note that the arrangement of fields given above is not necessarily the most optimal. Because some blocks of fields are not desirable to "tear apart" for aesthetic reasons — for example, a pair (pack, recno), which is the PK for this table.
In general, determining the "minimal" arrangement of fields is quite a simple "brute force" task. Therefore, you can achieve even better results on your data than we did — give it a try!
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish