

Jeg vil dele analysen av Vladimir Sitnikovs rapport fra begynnelsen av 2016 "PostgreSQL og JDBC, vi presser ut alt vi kan".
God dag! Jeg heter Vladimir Sitnikov. Jeg har jobbet i 10 år i NetCracker. Og jeg jobber hovedsakelig med ytelse. Alt som har med Java å gjøre, og alt som har med SQL å gjøre – det er det jeg elsker.
I dag vil jeg snakke om hva vi har støtt på i selskapet når vi begynte å bruke PostgreSQL som database-server. Og vi jobber hovedsakelig med Java. Men det jeg vil si i dag, gjelder ikke bare Java. Som praksisen har vist, oppstår det også i andre språk.
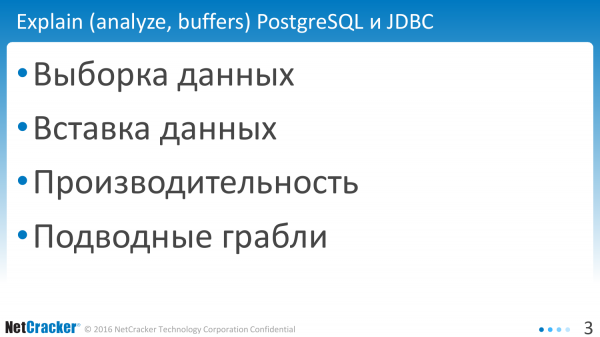
Vi skal snakke om:
- datauthenting.
- lagring av data.
- og ytelse.
- Og om feller som er der.
La oss starte med et enkelt spørsmål. Vi henter én rad fra tabellen basert på primærnøkkelen.
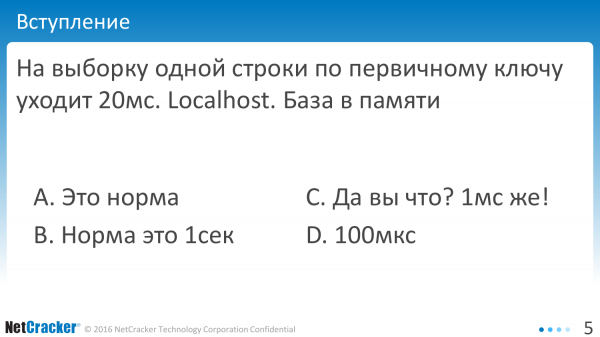
Databasen er på den samme verten. Og alt dette tar 20 millisekunder.
Disse 20 millisekundene er veldig mye. Hvis du har 100 slike forespørselere, bruker du tid i sekunder på å kjøre disse forespørselene, det vil si at du kaster bort tid.
Vi liker ikke å gjøre dette, og ser på hva databasen tilbyr oss for å gjøre det. Databasen gir oss to måter å utføre forespørselen på.
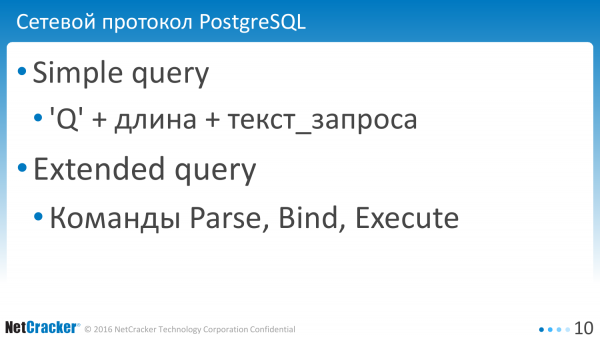
Den første måten – en enkel forespørsel. Hva er bra med dette? Jo, vi sender den og gjør ingenting mer.
Databasen har også en utvidet forespørsel, som er mer intelligent, men mer funksjonell. Du kan sende forespørselen på parsing, utførelse, binding av variabler osv. separat.
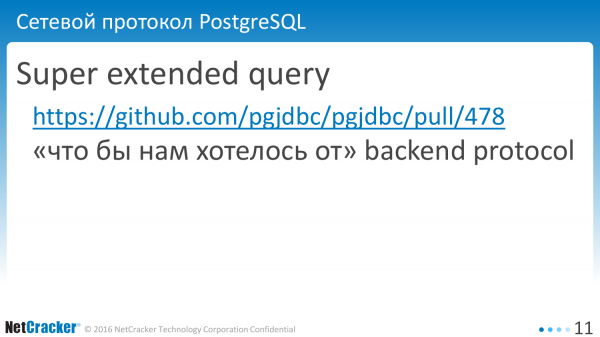
Super utvidet forespørsel – dette er noe vi ikke vil dekke i denne presentasjonen. Vi ønsker kanskje noen ting fra databasen, og det er en liste over ønsker som har blitt dannet på en eller annen måte, det vil si dette er det vi ønsker, men som ikke er mulig akkurat nå og i løpet av det nærmeste året. Så vi har bare skrevet det ned og vil gå for å skape oppstyr blant hovedpersonene.
Det vi kan gjøre, er enkel forespørsel og utvidet forespørsel.
Hva er spesialiteten til hver tilnærming?
En enkel forespørsel er godt egnet for engangsbruk. Du utfører den én gang og glemmer den. Problemet er at den ikke støtter binært dataformat, det vil si at den ikke er egnet for noen høyytelsessystemer.
Utvidet forespørsel – gir oss muligheten til å spare tid på parsing. Dette er noe vi har implementert og begynt å bruke. Det har hjulpet oss enormt. Det er ikke bare tidsbesparelsen fra parsing. Det er også besparelse på datatransmisjon, da det er mye mer effektivt å overføre data i binært format.
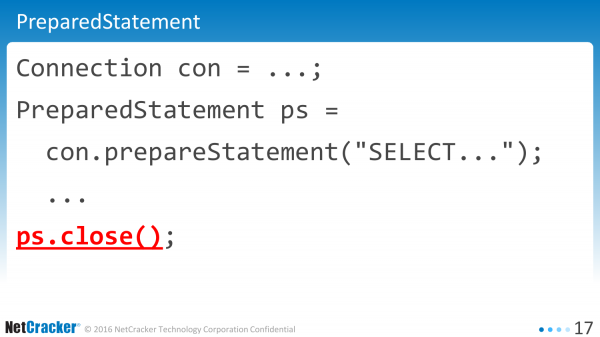
La oss gå over til praksis. Slik ser en typisk applikasjon ut. Det kan være Java osv.
Vi opprettet en statement. Vi utførte kommandoen. Vi opprettet en close. Hvor ligger feilen her? Hva er problemet? Det er ingen problemer. Dette står det i alle bøkene. Dette må man skrive. Hvis du ønsker maksimal ytelse, så skriv på denne måten.
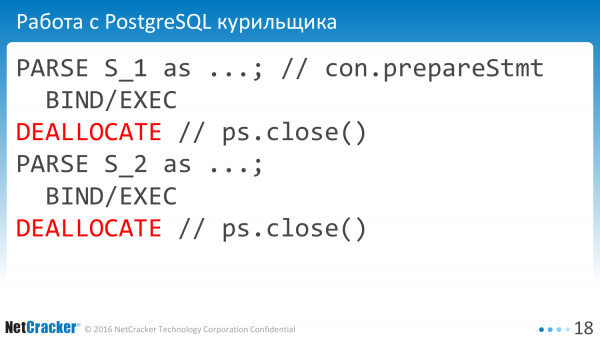
Men praksisen har vist at dette ikke fungerer. Hvorfor? Fordi vi har metoden «close». Og når vi gjør det slik, blir det fra databasen sett på som å være en røyker som jobber med databasen. Vi sa «PARSE EXECUTE DEALLOCATE».
Hvorfor disse unødvendige opprettelsene og utlastingene av statements? De er ingen til hjelp. Men vanligvis skjer det slik i PreparedStatement, at når vi stenger dem, så stenger de alt i databasen. Dette er ikke det vi ønsker.
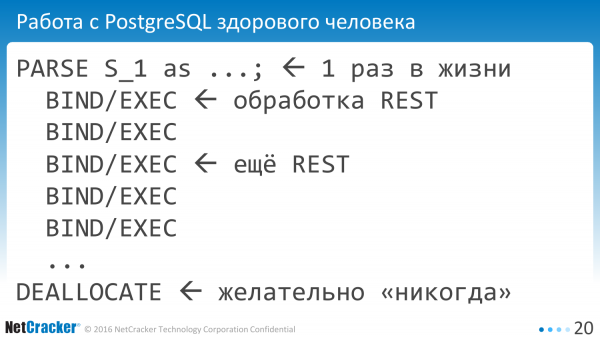
Vi ønsker å jobbe med databasen som friske mennesker. Vi forbereder statement én gang, og deretter bruker vi det mange ganger. Faktisk mange ganger – det er én gang i hele livssyklusen til applikasjonen at vi parser. Og på de forskjellige REST-ene bruker vi den samme statement ID-en. Det er vårt mål.
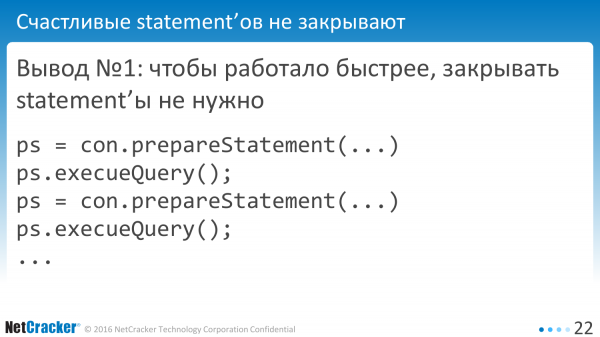
Hvordan kan vi oppnå dette?
Veldig enkelt – vi trenger ikke å lukke statements. Vi skriver slik: «prepare» «execute».
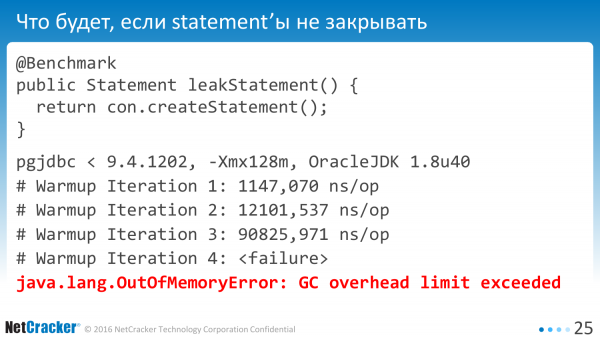
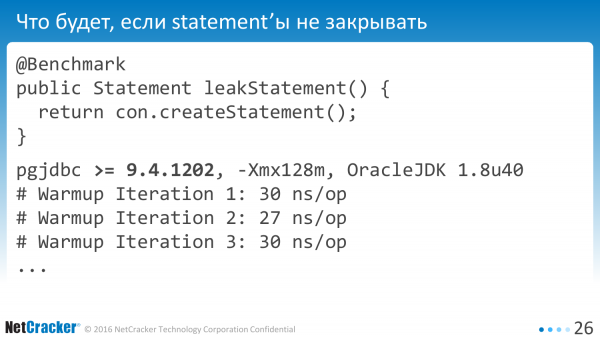
Hvis vi kjører dette, så er det klart at vi et sted vil oppleve noe som overfyller. Hvis ikke det er klart, kan vi måle. La oss lage en benchmark, hvor en så enkel metode er inkludert. Vi oppretter en statement. Kjør den på en viss versjon av driveren, og vi ser at den faller ganske raskt med tap av all minne som vi har tapt.
Det er klart at slike feil lett kan rettes. Jeg skal ikke snakke om dem. Men jeg vil si at i den nye versjonen fungerer det mye raskere. Metoden er ubrukelig, men likevel.
Hvordan arbeide på riktig måte? Hva må vi gjøre?
I virkeligheten lukker applikasjoner alltid statements. I alle bøker anbefales det å lukke dem, ellers vil minne lekke.
Og PostgreSQL kan ikke cache forespørslene. Hver sesjon må opprette denne cachen for seg selv.
Og vi ønsker heller ikke å kaste bort tid på parsing.
Og som vanlig har vi to alternativer.
Den første løsningen er at vi tar og sier at vi skal pakke alt inn i PgSQL. Der finnes det cache. Det cacher alt. Det vil bli strålende. Vi har sett på dette. Vi har 100500 forespørslene. Det fungerer ikke. Vi er ikke enige i å gjøre forespørslene om til prosedyrer for hånd. Nei-nei.
Vi har en andre løsning – ta og lage noe selv. Vi åpner kildene og begynner å kode. Koder-koder. Det viste seg at det ikke var så vanskelig å gjøre.
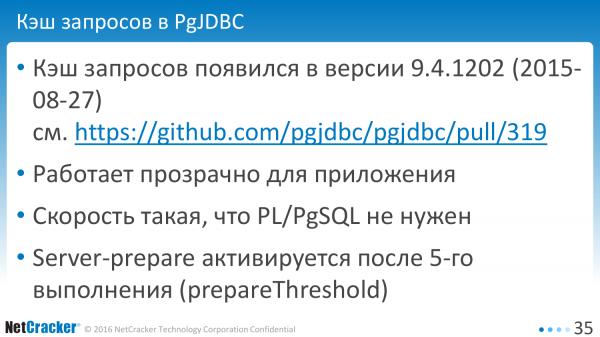
Dette dukket opp i august 2015. Nå finnes det allerede en mer moderne versjon. Og alt er flott. Det fungerer så bra at vi ikke endrer noe i applikasjonen. Vi har til og med sluttet å tenke på PgSQL, det vil si at dette var mer enn tilstrekkelig til å redusere alle driftskostnader praktisk talt til null.
Dermed aktiveres server-forberedte utsagn ved den femte kjøringen for å ikke kaste bort minne i databasen på hver enkelt engangsforespørsel.
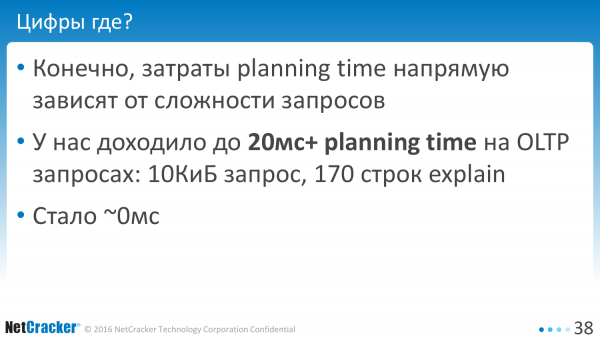
Man kan spørre – hvor er tallene? Hva får dere? Og her kan jeg ikke gi tall, for hver forespørsel har sine egne tall.
Våre forespørsel var slik at vi på OLTP-forespørslene brukte omtrent 20 millisekunder på parsing. Det var 0,5 millisekunder på kjøring, 20 millisekunder på parsing. Forespørselen var 10 KiB med tekst, 170 linjer med plan. Dette er en OLTP-forespørsel. Den ber om 1, 5, 10 linjer, av og til mer.
Men vi ønsket absolutt ikke å bruke 20 millisekunder. Vi klarte å redusere det til 0. Alt er flott.
Hva kan dere ta med dere herfra? Hvis dere bruker Java, så tar dere den moderne versjonen av driveren og er fornøyd.
Hvis dere bruker et annet språk, så tenk – kanskje dette også er noe dere trenger? Fordi fra perspektivet til det endelige språket, for eksempel hvis det er PL 8 eller har dere LibPQ, så er det ikke åpenbart at dere bruker tid ikke på kjøringen, men på parsing, og det er verdt å sjekke. Hvordan? Alt er gratis.
Unntatt at det er feil, noen spesielle forhold. Og om dem skal vi akkurat nå snakke. Størstedelen vil være om industriell arkeologi, om det vi har funnet, hva vi har støtt på.
Hvis forespørselen genereres dynamisk. Slike ting skjer. Noen limer sammen strenger, og det blir en SQL-forespørsel.
Hva er feil med det? Det er dårlig fordi vi hver gang ender opp med en annen streng.
Og denne varierte strengen må hashCode beregnes på nytt. Dette er virkelig en CPU-oppgave – å finne den lange forespørselsteksten er ikke så enkelt selv med eksisterende hash. Så konklusjonen er enkel – ikke generer forespørslene. Oppbevar dem i en enkelt variabel. Og vær glad.
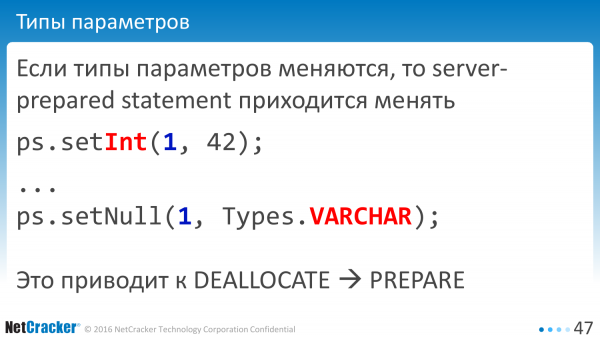
Neste problem. Datatyper er viktige. Det finnes ORM-er som sier at hvilken som helst NULL er greit. Hvis det er Int, sier vi setInt. Og hvis NULL, så skal det alltid være VARCHAR. Og hva gjør det vel til slutt hvilken NULL som er der? Databasen forstår dette selv.
I praksis er databasen fullstendig klar over dette. Hvis du først sa at dette er et tall, og etterpå sa at det er VARCHAR, så er det umulig å gjenbruke server-forberedte setninger. I så fall må vi opprette setningen vår på nytt.
Hvis du kjører den samme forespørselen, så vær oppmerksom på at datatype i kolonnene ikke er forvirret. Du må passe på NULL. Dette er en vanlig feil vi hadde etter at vi begynte å bruke PreparedStatements.
Greit, vi skrudde det på. Kanskje vi fikk driveren. Og ytelsen falt. Alt ble dårlig.
Hvordan kan dette skje? Er det en bug eller en funksjon? Dessverre er det ikke mulig å forstå – er dette en bug eller en funksjon. Men det finnes et ganske enkelt gjenskprehendingsscenario for dette problemet. Det angrep oss ganske uventet. Og det handler om en forespørsel fra bokstavelig talt én tabell. Vi hadde selvfølgelig flere slike forespørslene. De inkluderte som regel to-tre tabeller, men det finnes dette scenariet. Ta databasen din i hvilken som helst versjon og gjenskap.
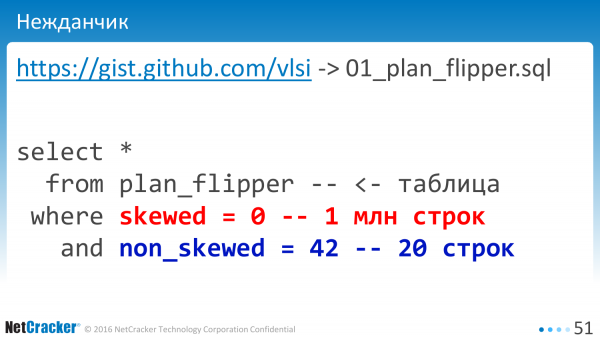
Poenget er at vi har to kolonner, hvor hver er indeksert. I den ene kolonnen finnes det en million rader med NULL-verdi. Og i den andre kolonnen ligger det bare 20 rader. Når vi kjører uten tilknyttede variabler, fungerer alt som det skal.
Hvis vi begynner å kjøre med tilknyttede variabler, det vil si vi bruker tegn som «?» eller «$1» i forespørselen, hva får vi da?
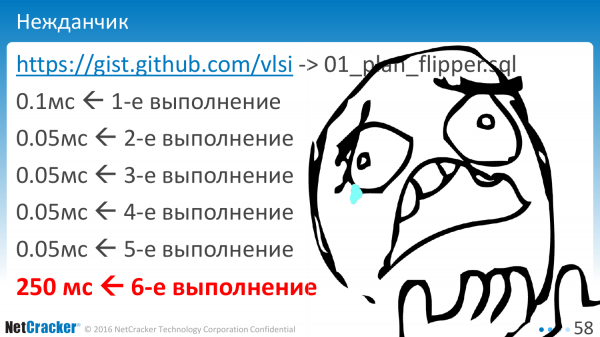
Første kjøring – som forventet. Andre – litt raskere. Noe ble cachet. Tredje-fjerde-femte. Så, bang – og på en eller annen måte sånn. Og det mest frustrerende er at dette skjer ved den sjette kjøringen. Hvem visste at man måtte gjøre akkurat seks kjøringer for å forstå hvilken utførelsesplan som faktisk gjelder?
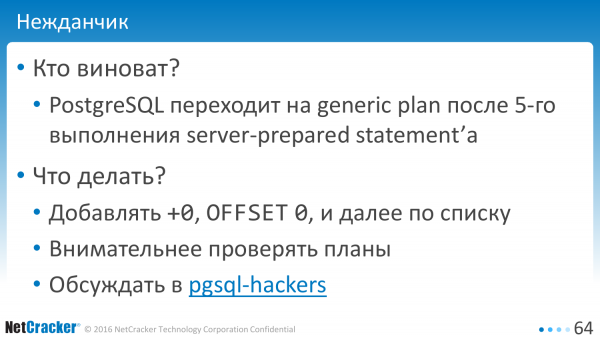
Hvem har skylden? Hva skjedde? Databasen inneholder optimalisering. Og den er på en måte optimalisert for et generisk tilfelle. Og, i så fall, fra et visst punkt overgår den til den generiske planen, som dessverre kan vise seg å være noe annet. Den kan være lik, men kan også være noe annet. Og det er et terskelverdi som fører til slik oppførsel.
Hva kan vi gjøre med dette? Her er det selvfølgelig mer komplisert å gjøre antakelser. Det er en enkel løsning som vi bruker. Det er +0, OFFSET 0. Du kjenner sikkert slike løsninger. Vi tar bare og legger til «+0» i forespørselen, og så går det bra. Jeg skal vise det senere.
Og det er en annen mulighet – se mer nøye på planene. Utvikleren må ikke bare skrive forespørselen, men også si «explain analyze» seks ganger. Hvis det er fem, er det ikke tilstrekkelig.
Og det er en tredje mulighet – å skrive et brev til pgsql-hackers. Jeg skrev det, men det er fortsatt uklart om det er en feil eller en funksjon.
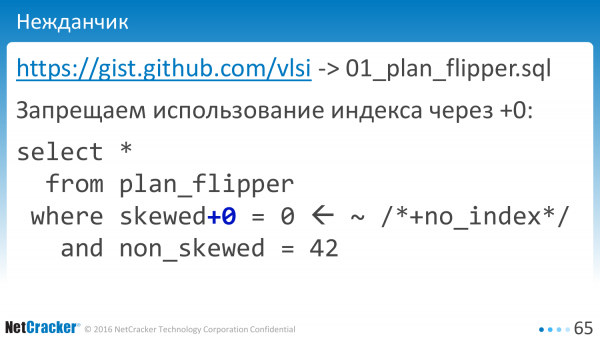
Mens vi tenker – er dette en feil eller en funksjon, la oss fikse det. Vi tar forespørselen vår og legger til «+0». Det går bra. To symboler og vi trenger ikke engang å tenke på hvordan det fungerer. Veldig enkelt. Vi har bare nektet databasen å bruke indeksen for denne kolonnen. Vi har ikke indeksen for kolonnen «+0» og alt er bra.
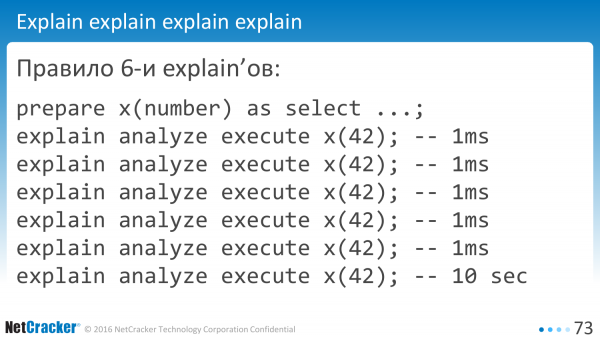
Det er regelen om seks forklaringer. Nå, i de nåværende versjonene må du gjøre det seks ganger hvis du har relaterte variabler. Hvis du ikke har relaterte variabler, gjør vi det slik. Og til slutt feiler akkurat denne forespørselen. Det er ikke så vanskelig.
Det kunne virke som om det er nok nå? Her er en feil, der en feil. Det er faktisk feil overalt.
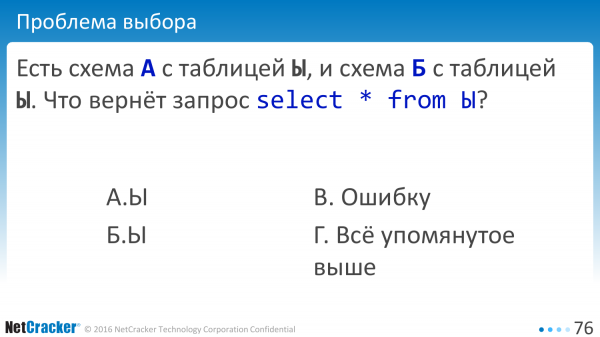
La oss se nærmere på det. For eksempel har vi to skjemaer. Skjema A med tabellen Y og skjema B med tabellen Y. Forespørselen – velg data fra tabellen. Hva skjer da? Vi får en feil. Vi får alt som er nevnt ovenfor. Regelen er – feil overalt, og vi får alt nevnt ovenfor.
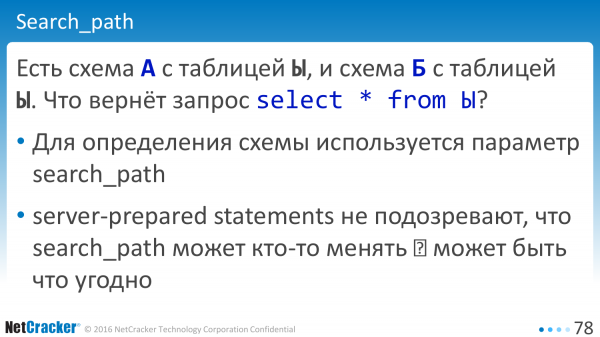
Nå er spørsmålet: «Hvorfor?». Det kunne virke som om det finnes dokumentasjon som sier at hvis vi har et skjema, så er det variabelen «search_path», som indikerer hvor vi skal lete etter tabellen. Det virker som om variabelen er der.
Hva er problemet? Problemet er at serverforberedte uttalelser ikke vet at «search_path» kan endres av noen. Denne verdien forblir som en konstant for databasen. Og noen deler kan kanskje ikke ta opp de nye verdiene.
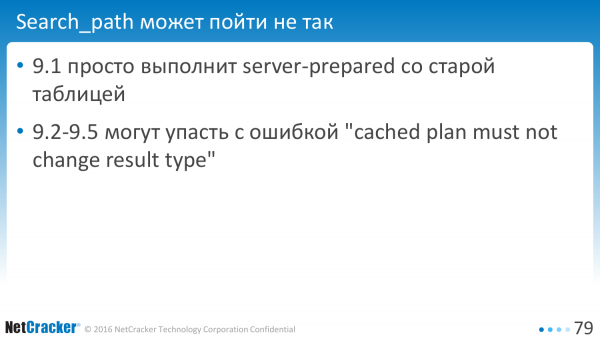
Selvfølgelig avhenger det av versjonen du tester på. Det kommer an på hvor mye tabellene dine varierer. Og versjon 9.1 vil bare utføre de gamle forespørslene. Nye versjoner kan oppdage fellen og si at du har en feil.
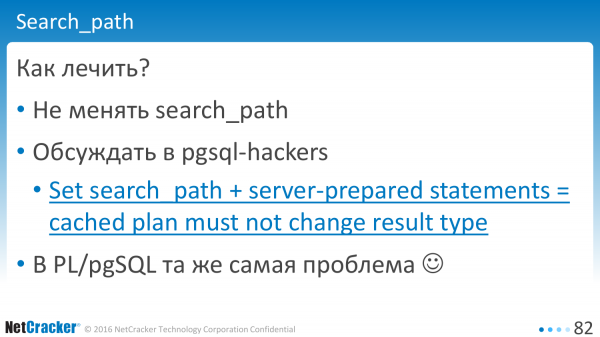
Hvordan fikser vi dette? Det er en enkel oppskrift – ikke gjør det. Ikke endre search_path i applikasjonens drift. Hvis du endrer det, er det bedre å opprette en ny tilkobling.
Vi kan diskutere, altså åpne, diskutere, skrive til. Kanskje vi kan overbevise databaseutviklerne om at når noen endrer verdien, bør databasen si til klienten: «Se, verdien din har blitt oppdatert. Kanskje du bør tilbakestille utsagnene, opprette dem på nytt?». Nå oppfører databasen seg skjult og informerer ikke om at det har skjedd endringer i utsagnene.
Og jeg vil igjen understreke – dette er ikke typisk for Java. Vi vil se det samme i PL/pgSQL en til en. Men der vil det bli gjenskapt.
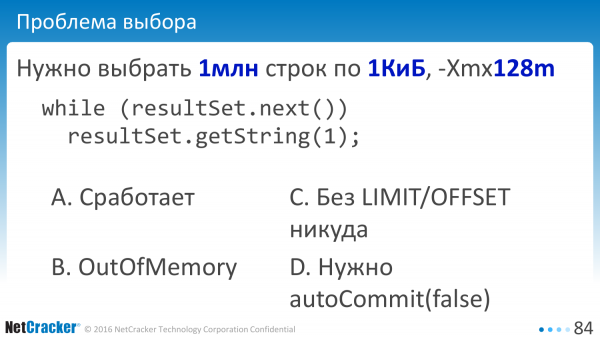
La oss prøve å velge mer data. Vi velger og velger. Vi har en tabell med en million rader. Hver rad er en kilobyte. Omtrent en gigabyte med data. Og vi har arbeidsminne på Java-maskinen på 128 megabyte.
Vi, som anbefalt i alle bøker, bruker strømming. Altså åpner vi resultSet og leser data derfra litt etter litt. Vil dette fungere? Vil det ikke gå tom for minne? Vil det lese litt og litt? La oss stole på databasen, la oss stole på Postgres. Nei, vi stoler ikke. Vil vi få OutOfMemory? Hvem har fått OutOfMemory? Og hvem klarte å fikse det etterpå? Noen klarte å fikse det.
Hvis du har en million rader, kan du ikke bare velge på den måten. Du må absolutt bruke OFFSET/LIMIT. Hvem er for denne varianten? Og hvem er for varianten der man må leke med autoCommit?
Her, som vanlig, viser det seg at det mest uventede alternativet er det rette. Og hvis du plutselig slår av autoCommit, vil det hjelpe. Hvorfor er det slik? Det er vitenskapen ukjent.
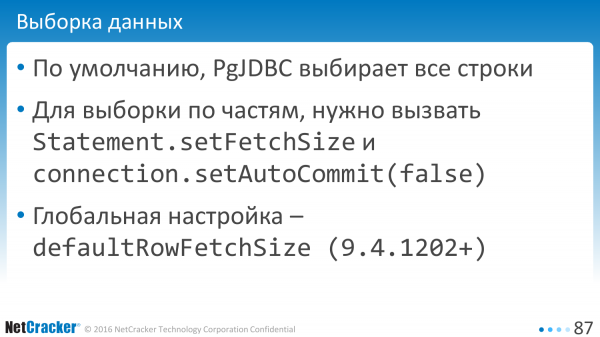
Men som standard velger alle klienter som kobler til Postgres-databasen dataene fullt ut. PgJDBC er ikke noe unntak i denne forbindelsen, den velger alle rader.
Det finnes en variant med FetchSize, altså kan du på nivået til et enkelt utsagn si at her, vær så snill, velg data med 10, 50. Men det fungerer ikke før du slår av autoCommit. Slått av autoCommit – det begynner å fungere.
Men det er upraktisk å gå gjennom koden og sette setFetchSize overalt. Derfor har vi laget en innstilling som angir standardverdien for hele forbindelsen.
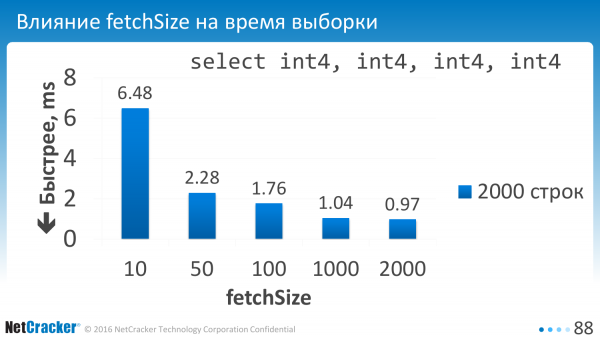
Så vi sa dette. Vi har konfigurert parameteren. Og hva fikk vi ut av det? Hvis vi velger et lite antall, for eksempel 10 rader, så har vi ganske store overhead-kostnader. Derfor må denne verdien settes til omtrent hundre.
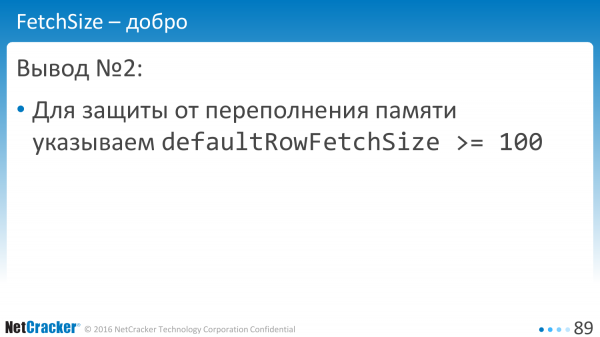
Ideelt sett skulle vi også lære å begrense i byte, men oppskriften er slik: sett defaultRowFetchSize til mer enn hundre og vær glad.
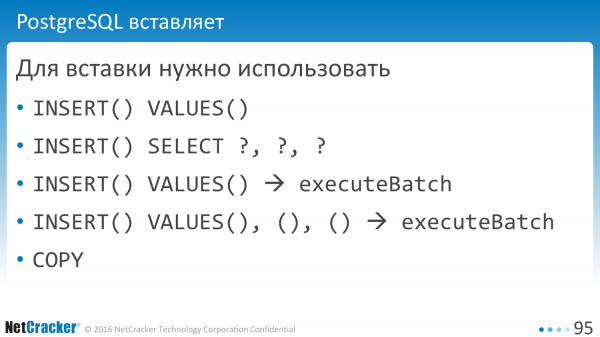
La oss gå videre til datainnsending. Innsending er enklere, det finnes forskjellige alternativer. For eksempel, INSERT, VALUES. Det er et godt alternativ. Man kan også si 'INSERT SELECT'. I praksis er det det samme. Det er ingen forskjell i ytelse.
Bøker sier at man må utføre Batch-statement, bøker sier at man kan utføre mer komplekse kommandoer med flere parenteser. Og i Postgres finnes det en fantastisk funksjon - man kan bruke COPY, det vil si å gjøre dette raskere.

Hvis man måler, kan man igjen gjøre noen interessante oppdagelser. Hvordan ønsker vi at dette skal fungere? Vi ønsker å unngå parsing og unødvendige kommandoer.
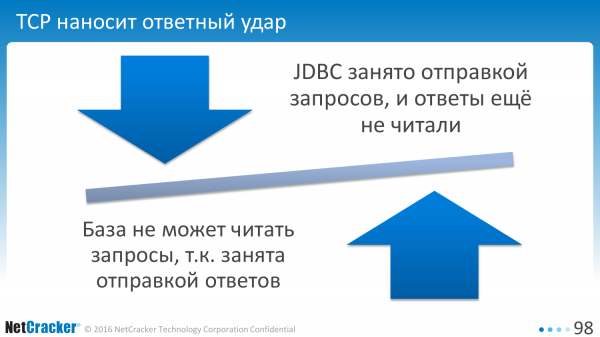
I praksis gir ikke TCP oss muligheten til dette. Hvis klienten er opptatt med å sende en forespørsel, leser ikke databasen forespørslene mens den prøver å sende oss svar. Resultatet er at klienten venter på databasen til den leser forespørselen, mens databasen venter på klienten til han leser svaret.
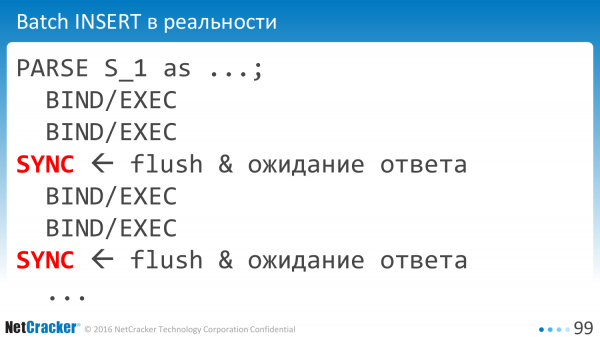
Derfor er klienten tvunget til å sende pakker for synkronisering med jevne mellomrom. Unødvendige nettverksinteraksjoner, unødvendig tap av tid.
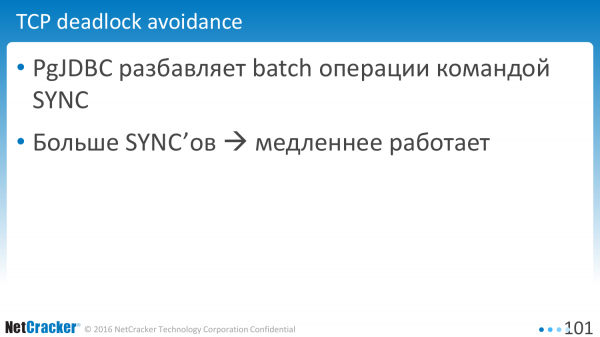 Og jo flere vi legger til, desto verre blir det. Driveren er ganske pessimistisk og legger dem til ganske ofte, omtrent hver 200. linje, avhengig av linjestørrelsen, osv.
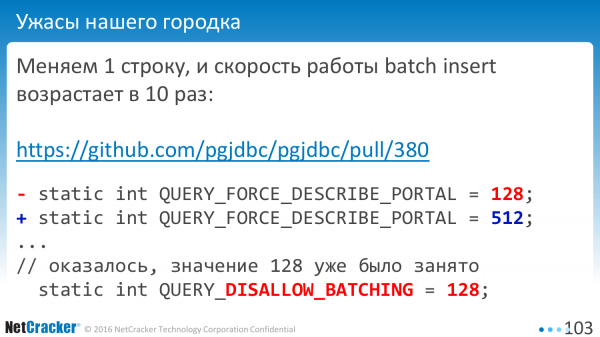
Noen ganger kan du justere bare én linje og få ti ganger raskere ytelse. Dette skjer. Hvorfor? Som vanlig, var en slik konstant allerede brukt. Og verdien '128' betydde - ikke bruke batching.
Det er bra at dette ikke kom med i den offisielle versjonen. Vi oppdaget det før vi begynte å utgi en ny versjon. Alle verdier jeg nevner, er basert på moderne versjoner.
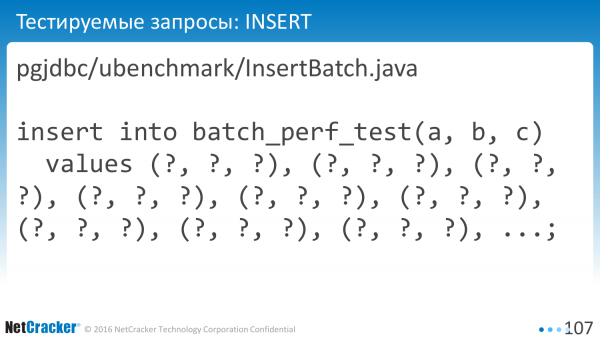
La oss måle. Vi måler enkel InsertBatch. Vi måler flere InsertBatch, det vil si det samme, men med mange values. En smart løsning. Ikke alle vet hvordan dette gjøres, men det er en enkel løsning, mye enklere enn COPY.
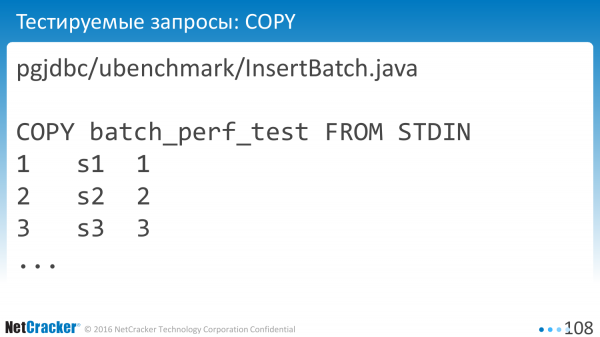
Man kan bruke COPY.
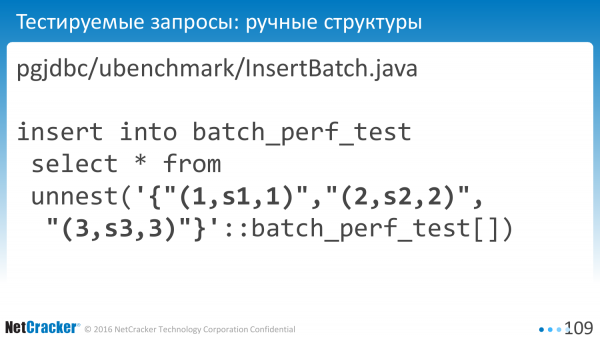
Og dette kan gjøres med strukturer. Deklarer User default type, send inn et array og INSERT direkte i tabellen.
Hvis du åpner linken: pgjdbc/ubenchmsrk/InsertBatch.java, så finnes denne koden på GitHub. Du kan se spesifikt hvilke forespørslser som genereres der. Det er ikke viktig.
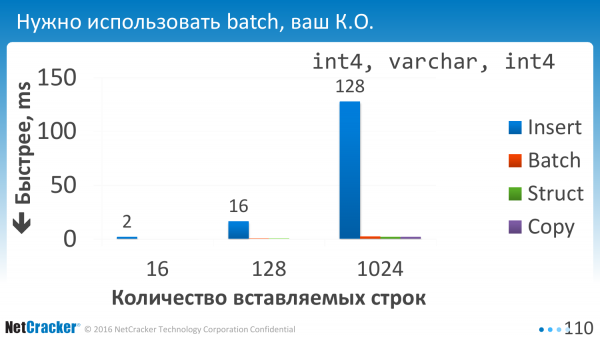
Vi har startet. Og det første vi forstod er at uten batch – det er rett og slett umulig. Alle batch-alternativer er lik null, dvs. kjøretiden er praktisk talt lik null sammenlignet med en enkelt utførelse.
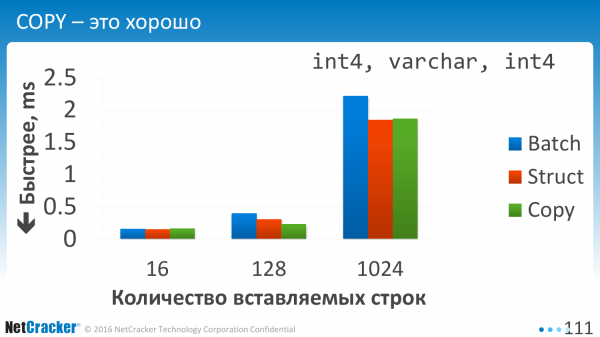
Vi setter inn data. Det er en ganske enkel tabell. Tre kolonner. Og hva ser vi her? Vi ser at alle disse tre alternativene er omtrent sammenlignbare. Og COPY er selvfølgelig best.
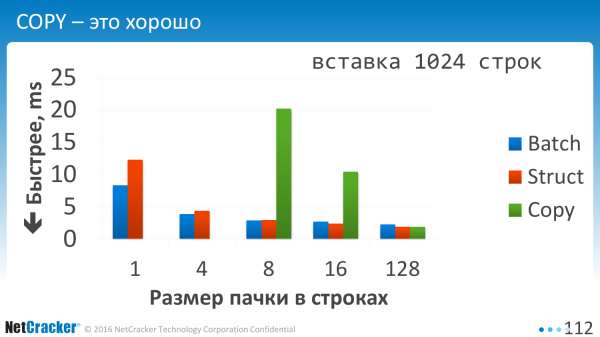
Dette er når vi setter inn i biter. Når vi sa ett VALUES-verdi, to VALUES-verdier, tre VALUES-verdier, eller vi oppga 10 med komma. Dette er akkurat nå horisontalt. 1, 2, 4, 128. Det er tydelig at Batch Insert, som er tegnet med blått, gjør det mye lettere. Det vil si, når du setter inn én om gangen eller til og med når du setter inn fire, så blir det dobbelt så bra, bare fordi vi klarte å stappe litt mer inn i VALUES. Færre EXECUTE-operasjoner.
Å bruke COPY på små volum er ekstremt lite lovende. Jeg tegnet ikke engang de første to. De går i skyene, dvs. disse grønne tallene for COPY.
COPY bør brukes når du har datamengder som minimum er større enn hundre rader. Overhead ved å åpne denne forbindelsen er stor. Og, ærlig talt, jeg har ikke gravd i denne retningen. Jeg optimaliserte batchen, men COPY gjorde jeg ikke.
Hva gjør vi videre? Vi har målt. Vi forstår at vi må bruke enten strukturer eller det smart batching som kombinerer flere verdier.
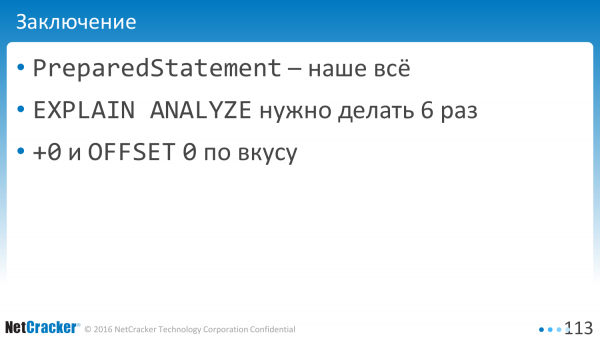
Hva må vi ta med oss fra dagens foredrag?
- PreparedStatement – det er vårt alt. Det gir oss mye for ytelsen. Det gir oss en stor krukke med tjære.
- Og vi må gjøre EXPLAIN ANALYZE 6 ganger.
- Og vi må blande inn OFFSET 0, og triks som +0 for å rette opp den gjenværende prosentandelen av våre problematiske spørringer.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish