

Obs. overs.: dette er en oversettelse av et offentlig postmortem fra ingeniørbloggen til selskapet . Den beskriver et problem med conntrack i Kubernetes-klyngen, som førte til delvis nedetid for noen produksjonstjenester.
Denne artikkelen kan være nyttig for dem som ønsker å lære litt mer om postmortem-er eller forhindre noen potensielle DNS-problemer i fremtiden.
Dette er ikke DNS
Det kan ikke være at det er DNS
Det var DNS
Litt om postmortem-er og prosessene i Preply
Postmortemet beskriver en feil i driften eller en hendelse i produksjonen. Postmortemet inkluderer en kronologi over hendelser, beskrivelse av brukerens påvirkning, årsaken, tiltakene og lærdommen.
På ukentlige møter med pizza, i kretsen av det tekniske teamet, deler vi ulike informasjoner. En av de viktigste delene av slike møter er postmortem-er, som oftast ledsages av en presentasjon med lysbilder og dypere analyse av den oppståtte hendelsen. Selv om vi ikke «klapper» etter postmortem-er, prøver vi å utvikle en kultur for «uten skyld» (). Vi tror at skriving og presentasjon av postmortem-er kan hjelpe oss (og ikke bare oss) med å forhindre lignende hendelser i fremtiden, derfor deler vi dem.
Personene involvert i hendelsen må føle at de kan forklare den i detalj uten å frykte straff eller represalier. Ingen forakt! Å skrive et postmortem er ikke straff, men en mulighet for læring for hele selskapet.
DNS-problemer i Kubernetes. Postmortem
Dato: 28.02.2020
Forfattere: Amet U., Andrey S., Igor K., Alexey P.
Status: Fullført
Kort oppsummert: Delvis utilgjengelighet av DNS (26 min) for noen tjenester i Kubernetes-klyngen
Innvirkning: 15000 hendelser tapt for tjenestene A, B og C
Årsak: Kube-proxy klarte ikke å fjerne den gamle posten fra conntrack-tabellen korrekt, så noen tjenester prøvde fortsatt å koble seg til ikke-eksisterende pods.
E0228 20:13:53.795782 1 proxier.go:610] Failed to delete kube-system/kube-dns:dns endpoint connections, error: error deleting conntrack entries for UDP peer {100.64.0.10, 100.110.33.231}, error: conntrack command returned: ...Utløser: På grunn av lav belastning i Kubernetes-klyngen, reduserte CoreDNS-autoscaler antallet pods i distribusjonen fra tre til to.
Løsning: En ny applikationsdisposition initierade skapandet av nya noder, CoreDNS-autoscaler lade till fler pods för att stödja klustret, vilket ledde till att conntrack-tabellen skrev över.
Upptäckts: Prometheus-övervakning upptäckte ett stort antal 5xx-fel för tjänsterna A, B och C och initierade ett samtal till jouringenjörerna.
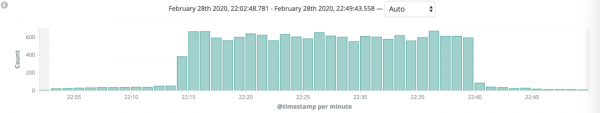
5xx-fel i Kibana
Handlinger
Handling
Type
Ansvarig
Oppgave
Inaktivera autoskalern för CoreDNS
förhindra.
Amet U.
DEVOPS-695
Installera caching DNS-server
minska.
Max V.
DEVOPS-665
Konfigurera övervakning av conntrack
förhindra.
Amet U.
DEVOPS-674
Lærte leksjoner
Vad gick bra:
- Övervakningen fungerade smidigt. Reaktionen var snabb och organiserad.
- Vi stötte inte mot några begränsningar på noderna.
Vad var fel:
- Den verkliga grundorsaken är fortfarande oklar, verkar som i conntrack.
- Alla åtgärder åtgärdar endast konsekvenserna, inte grundorsaken (buggen).
- Vi visste att vi förr eller senare skulle få problem med DNS, men prioriterade inte uppgifterna.
Där vi hade tur:
- En ny applikationsdisposition aktiverade CoreDNS-autoscalern som skrev över conntrack-tabellen.
- Denna bugg påverkade endast en del av tjänsterna.
Tidslinje (EET)
Tid
Handling
22:13
CoreDNS-autoscalern minskade antalet pods från tre till två.
22:18
Jouringenjörerna började få samtal från övervakningssystemet.
22:21
Jouringenjörerna började undersöka orsaken till felen.
22:39
Jouringenjörerna började rulla tillbaka en av de senaste tjänsterna till en tidigare version.
22:40
5xx-felen slutade dyka upp, situationen stabiliserades.
- Tid till upptäckten: 4 min
- Tid till åtgärder: 21 min
- Tid till fixering: 1 min
Ytterligere informasjon
- Loggar för CoreDNS:
I0228 20:13:53.507780 1 event.go:221] Event(v1.ObjectReference{Kind:"Deployment", Namespace:"kube-system", Name:"coredns", UID:"2493eb55-3dc0-11ea-b3a2-02bb48f8c230", APIVersion:"apps/v1", ResourceVersion:"132690686", FieldPath:""}): type: 'Normal' reason: 'ScalingReplicaSet' Skalade ner replika set coredns-6cbb6646c9 till 2. - Länkar till Kibana (redigerad), Grafana (redigerad)
För att minimera CPU-användningen använder Linux-kärnan något som kallas conntrack. Kort sagt, det är ett verktyg som har en lista över NAT-poster som lagras i en speciell tabell. När nästa paket kommer från samma pod till samma pod som tidigare kommer den slutliga IP-adressen inte att beräknas på nytt, utan hämtas från conntrack-tabellen.
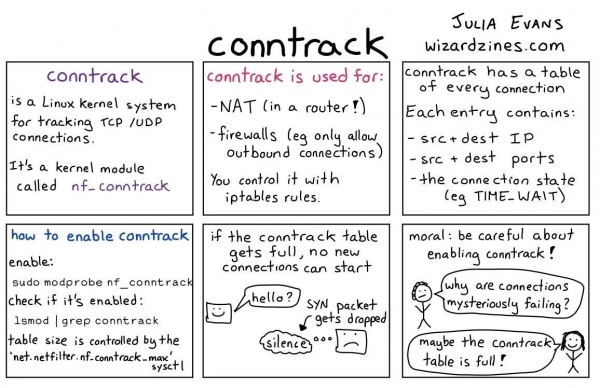
Hur conntrack fungerar.
Resultater
Dette var et eksempel på en av våre postmortemer med noen nyttige lenker. Spesielt i denne artikkelen deler vi informasjon som kan være nyttig for andre selskaper. Det er derfor vi ikke er redde for å gjøre feil, og derfor har vi gjort en av våre postmortemer offentlig. Her er noen flere interessante offentlige postmortemer:
- GitLab:
- Dropbox:
- Spotify:
- Mange andre fra og depotet
- Også offentlig postmortem med SRE-boken
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish