

Etter hvert som IPv4-adressene tar slutt, har mange telekommunikasjonsoperatører måttet organisere tilgangen til nettet for kundene sine ved hjelp av adresseoversettelse. I denne artikkelen vil jeg forklare hvordan man kan oppnå Carrier Grade NAT-ytelse på commodity-servere.
Litt historie
Temaet med utmattelse av IPv4-adresseområdet er ikke nytt. På et tidspunkt dukket det opp ventelister (waiting list) i RIPE, deretter oppstod det markedsplasser hvor adresseblokker ble handlet, og avtaler for utleie ble inngått. Gradvis begynte telekommunikasjonsoperatører å tilby internettjenester ved hjelp av adresse- og portoversettelse. Noen rakk ikke å skaffe nok adresser til å tildele en "hvit" adresse til hver abonnent, mens andre begynte å spare midler ved å unngå å kjøpe adresser på det sekundære markedet. Produsenter av nettverksutstyr støttet denne ideen, ettersom denne funksjonaliteten vanligvis krever ekstra utvidelseskort eller lisenser. For eksempel krever det å utføre NAPT på Junipers MX-rutere (bortsett fra de nyeste MX104 og MX204) et eget tjenestekort MS-MIC, på Cisco ASR1k kreves CGN-lisens, mens det på Cisco ASR9k kreves et eget modul A9K-ISM-100 og lisens A9K-CGN-LIC for dette. Generelt sett er det ikke billig.
IPTables
Å utføre NAT krever ikke spesialiserte beregningsressurser; prosessorer av generell utforming, som de som brukes i enhver hjemme-ruter, kan håndtere dette. På nivået til telekommunikasjonsoperatører kan denne oppgaven løses ved hjelp av commodity-servere drevet av FreeBSD (ipfw/pf) eller GNU/Linux (iptables). Vi vil ikke vurdere FreeBSD, da jeg for lengst har sluttet å bruke dette operativsystemet, så vi vil fokusere på GNU/Linux.
Det er ikke vanskelig å aktivere adresseoversettelse. Først må du skrive en regel i iptables til nat-tabellen:
iptables -t nat -A POSTROUTING -s 100.64.0.0/10 -j SNAT --to - --persistent
Operativsystemet vil laste modulen nf_conntrack, som vil overvåke alle aktive forbindelser og utføre de nødvendige transformasjonene. Det er noen nyanser. For det første, siden dette gjelder NAT på nivået til en teleoperatør, må timeout-verdiene justeres, fordi med standardverdier vil størrelsen på oversettelsestabellen raskt vokse til katastrofale nivåer. Nedenfor er et eksempel på innstillinger jeg brukte på mine servere:
net.ipv4.ip_forward = 1
net.ipv4.ip_local_port_range = 8192 65535

net.netfilter.nf_conntrack_generic_timeout = 300
net.netfilter.nf_conntrack_tcp_timeout_syn_sent = 60
net.netfilter.nf_conntrack_tcp_timeout_syn_recv = 60
net.netfilter.nf_conntrack_tcp_timeout_established = 600
net.netfilter.nf_conntrack_tcp_timeout_fin_wait = 60
net.netfilter.nf_conntrack_tcp_timeout_close_wait = 45
net.netfilter.nf_conntrack_tcp_timeout_last_ack = 30
net.netfilter.nf_conntrack_tcp_timeout_time_wait = 120
net.netfilter.nf_conntrack_tcp_timeout_close = 10
net.netfilter.nf_conntrack_tcp_timeout_max_retrans = 300
net.netfilter.nf_conntrack_tcp_timeout_unacknowledged = 300
net.netfilter.nf_conntrack_udp_timeout = 30
net.netfilter.nf_conntrack_udp_timeout_stream = 60
net.netfilter.nf_conntrack_icmpv6_timeout = 30
net.netfilter.nf_conntrack_icmp_timeout = 30
net.netfilter.nf_conntrack_events_retry_timeout = 15
net.netfilter.nf_conntrack_checksum=0
For det andre, siden størrelsen på oversettelsestabellen som standard ikke er beregnet for drift på teleoperatørnivå, må den økes:
net.netfilter.nf_conntrack_max = 3145728
Det er også nødvendig å øke antallet buckets for hash-tabellen som lagrer alle oversettelser (dette er en innstilling i modulen nf_conntrack):
options nf_conntrack hashsize=1572864
Etter disse enkle manipuleringene får man en fullt fungerende konstruksjon som kan oversette et stort antall klientadresser til en pool av eksterne. Imidlertid etterlater ytelsen til denne løsningen mye å ønske. I mine første forsøk på å bruke GNU/Linux for NAT (rundt 2013) klarte jeg å oppnå en ytelse på omtrent 7Gbit/s ved 0.8Mpps på én server (Xeon E5-1650v2). Siden den gang har det blitt gjort mange forskjellige optimaliseringer i nettverksstakken i GNU/Linux-kjernen, og ytelsen til én server med samme maskinvare har økt til nesten 18-19 Gbit/s ved 1.8-1.9 Mpps (dette var grenseverdiene), men behovet for mengden av trafikk som behandles av én server har vokst mye raskere. Til slutt ble det utviklet lastbalanseringsordninger på forskjellige servere, men alt dette har økt kompleksiteten i konfigurasjonene, vedlikeholdet og opprettholdelsen av kvaliteten på tjenestene som tilbys.
NFTables
Nå er den trendy retningen innen programmering av "pakkeoverføring" bruken av DPDK og XDP. Det er skrevet mange artikler om dette emnet, gjort mange forskjellige presentasjoner, og kommersielle produkter dukker opp (for eksempel SKAT fra VasExperts). Men med begrensede ressurser blant programmererne hos teleoperatører, er det ganske problematisk å utvikle et eller annet "prosjekt" basert på disse rammeverkene. Å drifte en slik løsning videre vil være mye vanskeligere, spesielt må man utvikle diagnoseverktøy. For eksempel, standard tcpdump vil ikke fungere med DPDK, og pakker som sendes tilbake i kablene ved hjelp av XDP, vil den ikke "se". I lys av alt snakket om nye teknologier for å flytte pakkeforvaltning til user-space, har og Pablo Neira Ayuso, vedlikeholderen av iptables, om utviklingen av flow offloading i nftables. La oss se nærmere på denne mekanismen.
Hovedideen er at hvis ruteren har sluppet gjennom pakker fra én økt i begge retninger av strømmen (TCP-økten har gått inn i ESTABLISHED-tilstand), er det ikke nødvendig å sende de påfølgende pakkene fra denne økten gjennom alle brannmurregler, ettersom alle disse kontrollene uansett vil ende med å sende pakken videre til ruting. I tillegg er det ikke nødvendig å bestemme ruten — vi vet allerede hvilken grensesnitt og hvilken vert vi skal sende pakkene til innenfor denne økten. Det er bare å lagre denne informasjonen og bruke den til ruting tidlig i prosesseringen av pakken. Når NAT utføres, må også informasjon om endringer i adresser og porter, som er omformet av modulen nf_conntrack, lagres. Ja, i dette tilfellet slutter ulike policy- og statistikkregler i iptables å fungere, men i konteksten av oppgaven til en enkeltstående NAT eller for eksempel en border — er dette ikke så viktig, fordi tjenestene er distribuert over enhetene.
Konfigurasjon
For å dra nytte av denne funksjonen må vi:
- Bruke et nytt kjerne. Selv om funksjonaliteten kom til kjernene fra versjon 4.16, var den ganske "rå" i lang tid og forårsaket regelmessig kernel panic. Alt stabiliserte seg omtrent i desember 2019, da LTS-kjernene 4.19.90 og 5.4.5 ble utgitt.
- Skrive om iptables-regler til nftables-format, ved å bruke en tilstrekkelig oppdatert versjon av nftables. Det fungerer perfekt i versjon 0.9.0.
Hvis det første punktet er forståelig, er det viktig å ikke glemme å aktivere modulen i konfigurasjonen under kompilering (CONFIG_NFT_FLOW_OFFLOAD=m), så krever det andre punktet forklaringer. Regler for nftables beskrives på en helt annen måte enn i iptables. dekker praktisk talt alle aspekter, det finnes også spesielle for regler fra iptables til nftables. Derfor vil jeg bare gi et eksempel på NAT-konfigurasjon og flow offload. En liten legende for eksemplet: <i_if>, <o_if> — dette er nettverksgrensesnitt som trafikk strømmer gjennom, det kan i virkeligheten være mer enn to. <pool_addr_start>,<pool_addr_end> — start- og sluttadresse for området med 'hvite' adresser.
NAT-konfigurasjonen er veldig enkel:
#! /usr/sbin/nft -f

table nat {
        chain postrouting {
                type nat hook postrouting priority 100;
                oif <o_if> snat to <pool_addr_start>-<pool_addr_end> persistent
        }
}
Flow offload er litt mer komplisert, men ganske forståelig:
#! /usr/sbin/nft -f

table inet filter {
        flowtable fastnat {
                hook ingress priority 0
                devices = { <i_if>, <o_if> }
        }

        chain forward {
                type filter hook forward priority 0; policy accept;
                ip protocol { tcp , udp } flow offload @fastnat;
        }
}
Det er derfor hele oppsettet. Nå vil all TCP/UDP-trafikk havne i fastnat-tabellen og bli behandlet mye raskere.
Resultater
For å gjøre det klart hvor mye 'mye raskere' er, vil jeg legge ved et skjermbilde av belastningen på to faktiske servere, med identisk maskinvare (Xeon E5-1650v2), med identisk konfigurasjon, som bruker samme Linux-kjerne, men som utfører NAT i iptables (NAT4) og i nftables (NAT5).
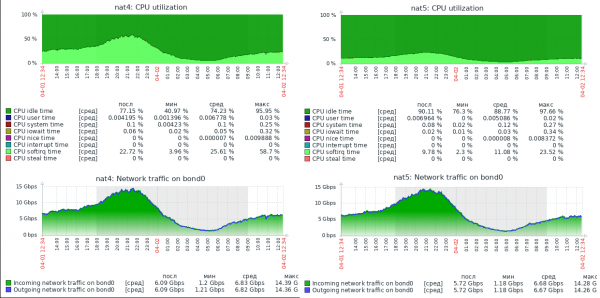
I skjermbildet er det ingen graf over pakker per sekund, men i belastningsprofilene til disse serverne er den gjennomsnittlige pakke størrelsen rundt 800 byte, så verdiene når opp til 1.5Mpps. Som vist, har serveren med nftables enorm ytelsesreserve. For øyeblikket behandler denne serveren opptil 30Gbit/s ved 3Mpps og er tydelig i stand til å nå det fysiske nettverksbegrensningen på 40Gbps, samtidig som den har ledige CPU-ressurser.
Jeg håper at dette materialet vil være nyttig for nettverksingeniører som prøver å forbedre ytelsen til serverne sine.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish