

Oversettelsen av artikkelen er forberedt spesielt for studentene i kurset .
— programvareutvikler, Go-entusiast og glad i å løse komplekse problemer. Han er også vedlikeholder av Prometheus og medgründer av Kubernetes SIG instrumentation. Tidligere var han produksjonsingeniør hos SoundCloud og ledet overvåkningsgruppen i CoreOS. Nå jobber han i Google.
— infrastrukturingeniør hos Improbable. Han interesserer seg for nye teknologier og utfordringer innen distribuerte systemer. Har erfaring med lavnivåprogrammering i Intel, erfaring som bidragsyter i Mesos og produksjonsopplevelse innen SRE i verdensklasse hos Improbable. Han jobber med å forbedre mikroserviceverdenen. Hans tre kjærligheter: Golang, open source og volleyball.
Ser man på vårt flaggskipprodukt SpatialOS, kan man gjette at Improbable trenger en høy-dynamisk skyinfrastruktur på global skala med titalls Kubernetes-klynger. Vi var blant de første til å begynne å bruke overvåkningssystemet . Prometheus kan spore millioner av metrikker i sanntid og leveres med et kraftig spørringsspråk som gjør det mulig å hente nødvendig informasjon.
Simplicity and reliability is one of Prometheus's main advantages. However, after reaching a certain scale, we faced several shortcomings. To solve these issues, we developed — et prosjekt med åpen kildekode utviklet av Improbable, for sømløs transformasjon av eksisterende Prometheus-klynger til et samlet overvåkingssystem med ubegrenset lagring av historiske data. Thanos er tilgjengelig på Github .
Våre mål med Thanos
Ved en viss skala oppstår problemer som overstiger evnene til vanilje-Prometheus. Hvordan lagre petabyte av historiske data på en trygg og kostnadseffektiv måte? Kan dette gjøres uten å gå på bekostning av responstiden på forespørselen? Kan man få tilgang til alle metrikker på forskjellige Prometheus-servere med én API-forespørsel? Er det mulig å på en eller annen måte kombinere dupliserte data samlet med Prometheus HA?
For å løse disse spørsmålene har vi laget Thanos. I de følgende avsnittene beskrives hvordan vi nærmet oss løsningene på disse problemene og de målene vi hadde.
Forespørsel om data fra flere Prometheus-installasjoner (global query)
Prometheus tilbyr en funksjonell tilnærming til sharding. Selv en enkelt Prometheus-server gir tilstrekkelig skalerbarhet til å frigjøre brukerne fra kompleksiteten av horisontal sharding i praktisk talt alle bruksområder.
Selv om dette er en utmerket distribusjonsmodell, er det ofte nødvendig å få tilgang til data på forskjellige Prometheus-servere via et enkelt API eller UI — global visning. Selvfølgelig kan flere forespørseler vises i en enkelt Grafana-panel, men hver forespørsel kan kun utføres på én Prometheus-server. På den annen side kan du med Thanos forespørre og aggregere data fra flere Prometheus-servere, siden alle er tilgjengelige fra ett endepunkt.
Tidligere, for å oppnå global visning i Improbable, organiserte vi våre Prometheus-installasjoner i en lagdelt . Dette innebar opprettelse av en meta-server for Prometheus som samler inn enkelte metrikker fra hver "blad"-server.
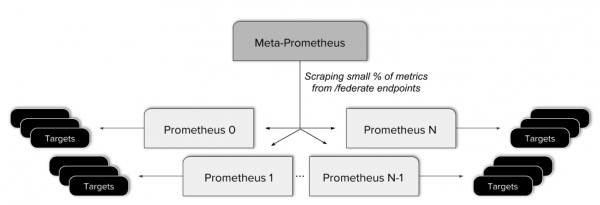
Denne tilnærmingen viste seg å være problematisk. Den førte til komplisert konfigurasjon, la til en ekstra potensiell feilkilde og påførte komplekse regler for å tilby den federerte endepunktet kun de nødvendige dataene. I tillegg tillater ikke slik federasjon virkelig å oppnå en global visning, ettersom ikke alle data er tilgjengelige fra én API-forespørsel.
Dette er nært knyttet til et enhetlig syn på data samlet på høytilgjengelige (high-availability, HA) Prometheus-servere. HA-modellen til Prometheus samler uavhengig data to ganger, noe som er så enkelt at det knapt kan bli enklere. Det ville imidlertid vært veldig praktisk å bruke et samlet og deduplisert syn på begge strømmer.
Selvfølgelig er det et behov for høytilgjengelige servere for Prometheus. I Improbable tar vi virkelig dataovervåking på minuttbasis alvorlig, men å ha en enkelt instans av Prometheus i klyngen er et enkelt feilpunkt. Enhver konfigurasjonsfeil eller maskinvarefeil kan potensielt føre til tap av viktig data. Selv en enkel distribusjon kan føre til små avbrudd i innsamlingen av metrikker, siden omstart kan ta betydelig lengre tid enn skrapetintervallet.
Pålitelige historiske data lagring
Billig, rask og langvarig lagring av metrikker er vår drøm (som deles av de fleste brukere av Prometheus). Hos Improbable måtte vi sette lagringsperioden for metrikker til ni dager (for Prometheus 1.8). Dette legger åpenbare begrensninger på hvor langt tilbake vi kan se.
Prometheus 2.0 har blitt bedre på dette området, ettersom antall tidsserier ikke lenger påvirker den totale ytelsen til serveren (se ). Likevel lagrer Prometheus data på lokal disk. Selv om høyeffektiv datakomprimering kan redusere bruken av lokal SSD betydelig, finnes det til slutt fortsatt en grense for mengden historiske data som kan lagres.
I tillegg bryr vi oss hos Improbable om pålitelighet, enkelhet og kostnad. Store lokale disker er vanskeligere å administrere og sikkerhetskopiere. De er dyrere og krever flere verktøy for sikkerhetskopiering, noe som fører til unødvendig kompleksitet.
Nedsampling
Da vi begynte å jobbe med historiske data, innså vi at det finnes fundamentale vanskeligheter med O-stor, som gjør at forespørslene blir tregere og tregere når vi jobber med data over uker, måneder og år.
Den standard løsningen på dette problemet vil være (downsampling) — redusere samplingfrekvensen av signalet. Ved å senke samplingfrekvensen kan vi "skalere ned" til et større tidsrom og opprettholde det samme antallet prøver, noe som vil bevare responsiviteten i forespørslene.
Nedsampling av eldre data er et uunngåelig krav for enhver løsning for langsiktig lagring og går utover vanilje-Prometheus.
Ytterligere mål
Et av de opprinnelige målene med Thanos-prosjektet var sømløs integrasjon med eksisterende Prometheus-installasjoner. Det andre målet var enkel drift med minimal inngangsbarriere. Eventuelle avhengigheter må kunne oppfylles enkelt for både små og store brukere, noe som også innebærer at den grunnleggende kostnaden er ubetydelig.
Thanos-arkitektur
Etter at vi har listet opp våre mål i avsnittet ovenfor, la oss jobbe med dem og se hvordan Thanos løser disse problemene.
Global visning
For a global view over existing Prometheus instances, we need to link a single entry point for requests to all servers. This is precisely what the Thanos component does. . It is deployed alongside each Prometheus server and acts as a proxy, serving local Prometheus data through the gRPC Store API interface, allowing for time series data selection by labels and time range.
On the other side is a horizontally scalable, stateless Querier component, which does a bit more than just answering PromQL queries via the standard Prometheus HTTP API. The Querier, Sidecar, and other Thanos components interact through .
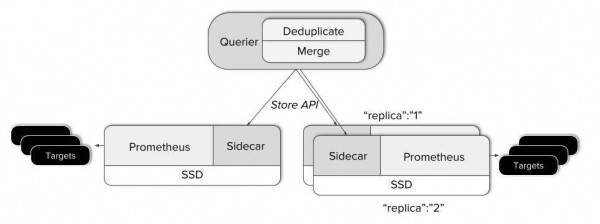
- When the Querier receives a request, it connects to the corresponding Store API server, namely our Sidecars, and retrieves time series data from the relevant Prometheus servers.
- It then combines the responses and executes the PromQL query on them. The Querier can merge both non-overlapping and duplicated data from HA Prometheus servers.
This solves the main part of our puzzle — merging data from isolated Prometheus servers into a single view. In fact, Thanos can be used solely for this capability. No modifications are needed on existing Prometheus servers!
Unlimited storage duration!
However, sooner or later we will want to retain data that goes beyond the usual retention period of Prometheus. For storing historical data, we chose object storage. It is widely available in any cloud and also in local data centers, and it's very cost-effective. Moreover, virtually any object storage is accessible via the well-known S3 API.
Prometheus writes data from memory to disk approximately every two hours. A block of stored data contains all data for a fixed time interval and is immutable. This is very convenient, as Thanos Sidecar can simply look at the Prometheus data directory and load new blocks into the object storage buckets as they appear.
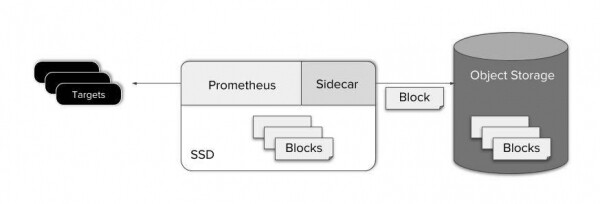
Uploading to object storage immediately after writing to disk also helps maintain the simplicity of the scraper (Prometheus and Thanos Sidecar), which simplifies system maintenance, cost, and design.
Som du kan se, er det veldig enkelt å ta sikkerhetskopi av data. Men hva med forespørselen til dataene i objektlagringen?
Thanos Store-komponenten fungerer som en proxy for å hente data fra objektlagringen. Akkurat som Thanos Sidecar deltar den i et gossip-kluster og implementerer Store API. Dermed kan eksisterende Querier behandle den som Sidecar, som en annen kilde til tidsseriedata — ingen spesialkonfigurasjon er nødvendig.
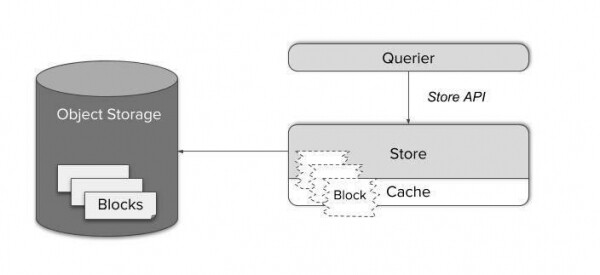
Tidsseriedataene består av flere store filer. Å laste dem på forespørsel ville vært ganske ineffektivt, og lokal caching ville krevd enorme ressurser for minne og lagringsplass.
I stedet vet Store Gateway hvordan man håndterer Prometheus lagringsformat. Takket være en smart forespørselplanlegger og caching av bare nødvendige indeksdeler av blokkene, er det mulig å redusere komplekse forespørsel til et minimum av HTTP-forespørsel til filer i objektlagringen. Dermed kan antallet forespørsel reduseres med fire til seks størrelsesordener og oppnå responstid som generelt er vanskelig å skille fra forespørsel til data på lokal SSD.
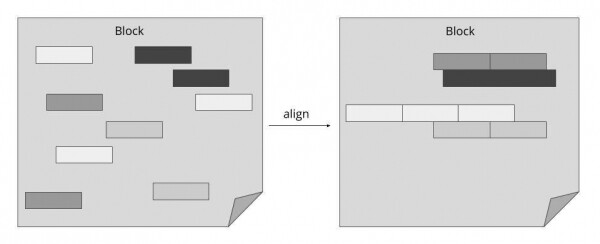
Som vist i diagrammet ovenfor, reduserer Thanos Querier kostnadene for en forespørsel til data i objektlagringen betydelig ved å bruke Prometheus lagringsformat og plassere relaterte data nær hverandre. Ved å bruke denne tilnærmingen kan vi sammenslå mange individuelle forespørsel til et minimum av bulk-operasjoner.
Kompresjon og nedsampling
Etter at en ny blokk med tidsseriedata har blitt lastet opp til objektlagringen, betrakter vi den som "historiske" data som umiddelbart blir tilgjengelige via Store Gateway.
Imidlertid, etter en stund, akkumuleres blokkene fra en kilde (Prometheus med Sidecar) og utnytter ikke lenger hele indekseringspotensialet. For å løse dette problemet har vi introdusert en annen komponent kalt Compactor. Den bruker ganske enkelt den lokale kompresjonsmekanismen til Prometheus på de historiske dataene i objektlagringen og kan kjøres som en enkel periodisk batchjobb.
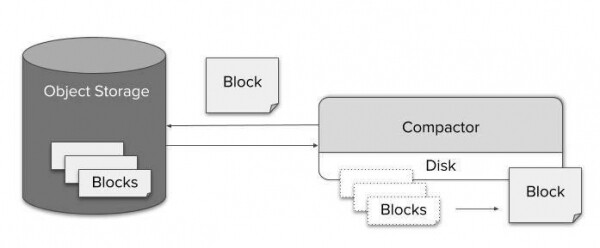
Takk vere effektiv komprimering, utgjer ikkje forespørselen i lagringssystemet eit problem sjølv over lengre tid frå eit datastørrelsesynspunkt. Men den potensielle kostnaden ved å pakke ut milliardar av verdiar og køyre dei gjennom forespørselbehandlaren vil uunngåeleg føre til ein markant auke i behandlingstida for forespørselen. På den andre sida, sidan kvar skjermpiksel har hundrevis av datapunkt, blir det umogleg å visualisere data i full oppløysing. Såleis er nedoverprøving ikkje berre mogleg, men fører heller ikkje til merkbar tap av presisjon.
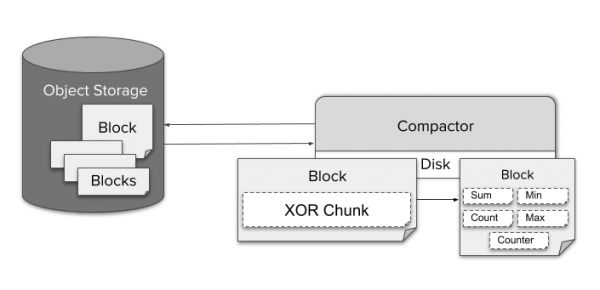
For nedoverprøving av data aggregerer Compactor kontinuerleg data med ei oppløysing på fem minutt og ein time. For kvar rådel av data koda med TSDB XOR-komprimering, blir ulike typar aggregerte data lagra, som min, max eller sum for ei blokk. Dette gjer at Querier automatisk kan velje aggreget som passar for den aktuelle PromQL-forespørselen.
For å bruke data med redusert presisjon treng brukaren ingen spesialkonfigurasjon. Querier vekslar automatisk mellom ulike oppløysingar og rådata etter kvart som brukaren zoomar inn og ut. Om ønskelig kan brukaren styre dette direkte via parameteren “step” i forespørselen.
Sidan kostnaden for lagring av ein GB er låg, lagrar Thanos som standard rådata, data med ei oppløysing på fem minutt og på ein time. Det er ikkje behov for å slette raw data.
Opptakreglar
Sjølv utan Thanos er opptakreglar ein viktig del av overvåkingsstakken. Dei reduserer kompleksitet, latency og kostnad ved forespørslene. Dei er også nyttige for brukarar når det gjeld å få aggregerte data om metrikkar. Thanos bygger på vanlige instansar av Prometheus, så det er heilt akseptabelt å lagre opptakreglar og varslingsreglar på den eksisterande Prometheus-serveren. Men i nokre tilfelle kan dette vere utilstrekkeleg:
- Globale varslar og reglar (for eksempel varsling når tenesta ikkje fungerer på meir enn to av tre klynger).
- Regel for data utanfor det lokale lagringssystemet.
- Ønsket om å lagre alle reglar og varslar på eitt staden.
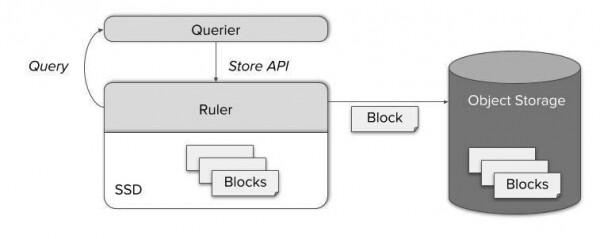
For all these cases, Thanos includes a separate component called Ruler, which computes rules and alerts through Thanos Queries. By providing the well-known StoreAPI, the Query node can access freshly computed metrics. Later, they are also stored in object storage and made available through Store Gateway.
The Power of Thanos
Thanos is flexible enough to be tailored to your needs. This is especially useful when migrating from a simple Prometheus. Let’s quickly recall what we learned about Thanos components with a small example. Here’s how to transition your vanilla Prometheus into the world of ‘unlimited metric storage’:
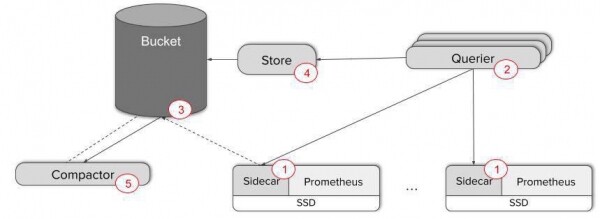
- Add Thanos Sidecar to your Prometheus servers — for instance, as an adjacent container in a Kubernetes pod.
- Deploy multiple replicas of Thanos Querier for data viewing capabilities. At this stage, it's easy to set up gossip between Scraper and Querier. To verify component interaction, use the ‘thanos_cluster_members’ metric.
These two steps alone are enough to ensure a global view and seamless deduplication of data from potential HA replicas of Prometheus! Simply connect your dashboards to the HTTP endpoint of Querier or use the Thanos UI directly.
However, if you require metric backup and long-term storage, you will need to complete three more steps:
- Create an AWS S3 or GCS bucket. Configure the Sidecar to copy data into these buckets. You can now minimize local data storage.
- Deploy Store Gateway and connect it to the existing gossip cluster. You can now send queries to the backup data!
- Deploy Compactor to enhance query efficiency for longer time intervals using compaction and downsampling.
If you want to learn more, feel free to check out our og !
In just five steps, we transformed Prometheus into a reliable monitoring system with a global view, unlimited retention time, and potential high availability of metrics.
Pull request: we need you!
has been an open-source project from the very beginning. Seamless integration with Prometheus and the ability to use only part of Thanos makes it a great choice for scaling the monitoring system without unnecessary effort.
Vi er alltid glade for GitHub Pull Requests og Issues. Samtidig, ikke nøl med å kontakte oss via Github Issues eller slack, hvis du har spørsmål eller tilbakemeldinger, eller hvis du ønsker å dele din erfaring med oss! Hvis du liker det vi gjør i Improbable, ikke nøl med å ta kontakt med oss — !
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish