

Hva ville du følt hvis datasenteret med utstyret ditt en vakker sommerdag så slik ut?
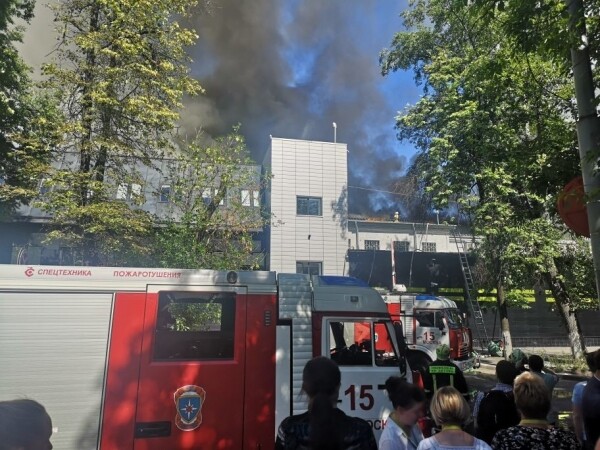
Hei alle sammen! Jeg heter Dmitrij Samsonov, og jeg jobber som ledende systemadministrator i «». På bildet ser vi et av de fire datasentrene hvor utstyret som støtter prosjektet vårt er installert. Bak disse veggene finnes det omtrent 4000 enheter: servere, lagringssystemer, nettverksutstyr osv. — nesten ⅓ av alt utstyret vårt.
De fleste serverne kjører Linux. Det er også noen titalls servere som kjører Windows (MS SQL) — vårt arv som vi gradvis har kvittet oss med over mange år.
Så, den 5. juni 2019 kl. 14:35 rapporterte ingeniører fra et av datasentrene våre om brannalarm.
Benektelse
14:45. Små hendelser med røyk i datasentrene skjer oftere enn man skulle tro. Målingene inne i hallene var normale, så vår første reaksjon var relativt avslappet: vi innførte forbud mot arbeid med produksjonen, det vil si noen endringer i konfigurasjoner, utrulling av nye versjoner, osv., unntatt arbeid relatert til reparasjoner.
Raseri
Har du noen gang prøvd å spørre brannfolkene hvor på taket brannen oppsto, eller å komme deg opp på det brennende taket selv for å vurdere situasjonen? Hva vil være tilliten til informasjonen som er mottatt gjennom fem personer?
14:50. Det har kommet informasjon om at flammene nærmer seg kjølesystemet. Men vil det nå frem? Den vaktsomme systemadministratoren rutet utgående trafikk fra frontene til dette datasenteret.
Per nå er frontene til alle tjenestene våre duplisert i tre datasentre, med lastbalansering på DNS-nivå som gjør det mulig å fjerne adressene til ett datasenter fra DNS, og dermed beskytte brukerne mot potensielle tilgangsproblemer til tjenestene. I tilfelle problemer i datasenteret allerede har oppstått, fjernes det automatisk fra rotasjonen. Du kan lese mer her:
Brannen har så langt ikke påvirket oss — verken brukerne eller utstyret har lidd. Er dette en nødssituasjon? Første del av dokumentet «Handlingsplan for nødsituasjoner» gir en definisjon av begrepet «Nødsituasjon», og avsluttes med:
«Hvis det er tvil om det er en nødssituasjon eller ikke, så er det en nødssituasjon!»
14:53. Ein krisekoordinator blir tilsett.
Koordinatoren er en person som kontrollerer kommunikasjonen mellom alle deltakere, vurderer omfanget av krisen, bruker «Handlingsplan ved krise», engasjerer nødvendig personale, overvåker fullføringen av reparasjoner, og viktigst av alt — delegerer oppgaver. Med andre ord, det er personen som leder hele prosessen med å håndtere krisen.
Auksjon
15:01. Vi begynner å slå av serverne som ikke er knyttet til produksjon.
15:03. Vi slår av alle reserverte tjenester på en korrekt måte.
Dette inkluderer ikke bare frontene (som brukerne allerede ikke får tilgang til på dette tidspunktet) og deres støttetjenester (forretningslogikk, cacher, osv.), men også ulike databaser med et replikasjonsfaktor på 2 eller mer (, , , og så videre).
15:06. Det har kommet informasjon om at en brann truer et av rommene i datasenteret. I dette rommet har vi ikke utstyr, men det at flammen kan spre seg fra taket til rommene endrer kraftig situasjonen.
(Senere viste det seg at det ikke var noen fysisk trussel mot rommet, siden det er hermetisk isolert fra taket. Trusselen var bare for kjølesystemet i dette rommet.)
15:07. Vi tillater kommandoer på serverne å bli utført i akselerert modus uten ytterligere kontroller ().
15:08. Temperaturen i rommene er innenfor normalen.
15:12. Det er registrert en temperaturøkning i rommene.
15:13. Mer enn halvparten av serverne i datasenteret er slått av. Vi fortsetter.
15:16. Det er tatt beslutning om å slå av alt utstyr.
15:21. Vi begynner å kutte strømmen til stateless-serverne uten korrekt nedstenging av applikasjonen og operativsystemet.
15:23. Det blir utpekt en gruppe ansvarlige for MS SQL (det er få, avhengigheten av tjenestene deres er ikke stor, men prosedyren for å gjennopprette funksjonalitet tar lengre tid og er mer komplisert enn for eksempel Cassandra).
Depresjon
15:25. Det har kommet informasjon om avstengning av strøm i fire rom av 16 (nr. 6, 7, 8, 9). I rom 7 og 8 har vi vårt utstyr. Det er ingen informasjon om de to andre rommene våre (nr. 1 og 3).
Vanligvis slår man av strømmen umiddelbart ved branner, men i dette tilfellet, takket være koordinert arbeid fra brannmenn og teknisk personell i datasenteret, ble det ikke slått av overalt og ikke med en gang, men etter behov.
(Senere viste det seg at strømmen i salene 8 og 9 ikke ble slått av.)
15:28. Vi begynner å gjenopprette MS SQL-databaser fra sikkerhetskopier i andre datasentre.
Hvor lang tid vil dette ta? Er båndbredden i nettverket tilstrekkelig gjennom hele ruten?
15:37. Det er registrert avbrudd i enkelte nettverkssegmenter.
Management- og produksjonsnettverket er fysisk isolert fra hverandre. Hvis produksjonsnettverket er tilgjengelig, kan du logge inn på serveren, stoppe applikasjonen og slå av operativsystemet. Hvis det ikke er tilgjengelig, kan du logge inn via IPMI, stoppe applikasjonen og slå av operativsystemet. Hvis ingen av nettverkene er tilgjengelige, kan du ikke gjøre noe. "Takk, kaptein!", vil du kanskje tenke.
"Og generelt, det er litt mye styr," vil du kanskje også tenke.
Saken er at servere, selv uten brann, genererer enormt mye varme. Mer presist, når det er kjøling, genererer de varme, og når det ikke er noe kjøling, skaper de helvetes hete, som i beste fall smelter deler av utstyret og slår av andre deler, og i verste fall... forårsaker brann inne i salen, som praktisk talt garantert vil ødelegge alt.
15:39. Vi registrerer problemer med conf-databasen.
Conf-databasen er backend for den navngitte tjenesten som brukes av alle produksjonsapplikasjoner for å justere innstillinger i sanntid. Uten denne databasen kan vi ikke styre portalen, men portalen kan fortsatt fungere.
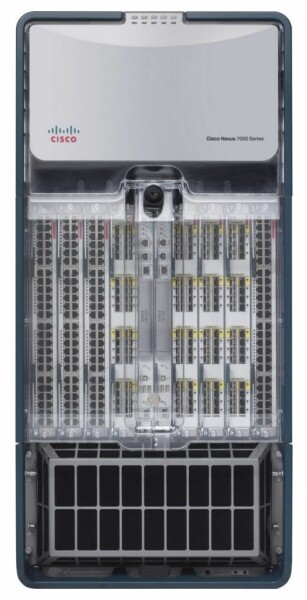
15:41. Temperaturfølerne på Core-nettverksutstyret registrerer verdier nær de maksimalt tillatte nivåene. Dette er en boks som tar opp en hel rack og sørger for drift av alle nettverk inne i datasenteret.
15:42. Issue tracker og wiki er utilgjengelige, vi går over til standby.
Dette er ikke produksjon, men ved en nødsituasjon kan tilgjengeligheten av hvilken som helst kunnskapsbase være kritisk.
15:50. Ett av overvåkingssystemene har stoppet.
Det er flere av dem, og de er ansvarlige for forskjellige aspekter ved servicearbeid. Noen av dem er konfigurert for autonom drift inne i hvert datasenter (det vil si at de bare overvåker sitt eget datasenter), mens andre består av distribuerte komponenter som greier å håndtere tapet av et hvilket som helst datasenter.
I dette tilfellet har , som fungerer i master-standby-modus, stoppet. Vi har byttet til standby.
Godkjenning
15:51. Via IPMI slukket vi alle serverne uten korrekt avslutning, unntatt MS SQL.
Er du klar for masseadministrasjon av servere via IPMI om nødvendig?
Det øyeblikket når redningen av utstyret i datasenteret er fullført. Alt som kunne gjøres, er gjort. Noen kolleger kan ta en pause.
16:13. Det har kommet informasjon om at kjøleanleggene på taket har fått lekkasje i kondensorrørene – det vil forsinke oppstarten av datasenteret etter brannslukking.
16:19. Ifølge data fra det tekniske personalet i datasenteret har temperaturen i rommene sluttet å stige.
17:10. Vi har gjenopprettet jobben til conf-databasen. Nå kan vi endre innstillingene til applikasjonene.
Hvorfor er dette så viktig, hvis alt er redundante og fungerer selv uten ett datasenter?
For det første er ikke alt redundante. Det finnes forskjellige sekundære tjenester som fortsatt ikke takler nedetid i datasenteret veldig godt, og det er databaser i master-standby-modus. Muligheten til å administrere innstillingene gjør at vi kan gjennomføre de nødvendige tiltakene for å minimere virkningen av en nødsituasjon på brukerne, selv under vanskelige forhold.
For det andre ble det klart at i løpet av de nærmeste timene vil ikke driften av datasenteret bli gjenopprettet helt, derfor var det nødvendig å iverksette tiltak for å unngå langvarig utilgjengelighet av replikkene, som kan føre til ytterligere problemer som diskfylling i de gjenværende datasentrene.
17:29. Tid for pizza! Vi har folk som jobber, ikke roboter.
Rehabilitering
18:02. Temperaturen i rommene nr. 8 (vårt), 9, 10 og 11 har stabilisert seg. I ett av rommene som fortsatt er avstengt (nr. 7) har vi vårt utstyr, og temperaturen der fortsetter å stige.
18:31. Vi har fått klarsignal for oppstart av utstyret i rom nr. 1 og 3 – disse rommene ble ikke berørt av brannen.
For øyeblikket blir serverne i rom nr. 1, 3 og 8 startet opp, med fokus på de mest kritiske. Vi sjekker at alle igangsatte tjenester fungerer korrekt. Det er fortsatt problemer med rom nr. 7.
18:44. Det tekniske personalet i datasenteret har funnet ut at mange servere i rom nr. 7 (hvor vårt utstyr står) ikke ble slått av. Ifølge våre data er 26 servere fortsatt på. Ved ny sjekk finner vi 58 servere.
20:18. Det tekniske personalet i datasenteret blåser luft i rommet uten klimaanlegg gjennom mobile luftkanaler som er lagt gjennom gangene.
23:08. Den første administratoren er sendt hjem. Noen må få sove om natten for å kunne fortsette arbeidet i morgen. Vi slipper nå også noen flere administratorer og utviklere.
02:56. Vi har startet alt som kan startes. Vi gjør en grundig sjekk av alle tjenester med autotester.
03:02. Klimaanlegget i det siste, 7. rom, er gjenopprettet.
03:36. Vi har fått frontene i datasenteret inn i rotasjon i DNS. Fra dette tidspunktet begynner å komme brukertrafikk.
Vi slipper ned store deler av administratorteamet hjem. Men vi beholder noen personer.
En liten FAQ:
Q: Hva skjedde mellom 18:31 og 02:56?
A: I henhold til «Handlingsplan ved feil» starter vi alle tjenester, begynner med de viktigste. Samtidig gir koordinatoren i chatten en tjeneste til den ledige administratoren, som sjekker om OS og applikasjonen har startet, om det er noen feil, og om alt fungerer som det skal. Etter at oppstarten er fullført, informerer han chatten om at han er ledig, og får en ny tjeneste fra koordinatoren.
Prosessen blir ytterligere forsinket av sviktende maskinvare. Selv om nedstengingen av OS og avslutningen av serverne har gått korrekt, returnerer ikke en del servere på grunn av plutselige feil på disker, minne eller chassis. Ved strømmangel øker prosentandelen av brudd.
Q: Hvorfor kan vi ikke bare starte alt samtidig, og deretter fikse det som dukker opp i overvåkingen?
A: Alt må gjøres gradvis, fordi det er avhengigheter mellom tjenestene. Og vi må sjekke alt med en gang, uten å vente på overvåkingen — fordi det er best å håndtere problemer med en gang, uten å vente på at de blir verre.
7:40. Den siste administratoren (koordinatoren) har gått til sengs. Arbeidet første dag er avsluttet.
8:09. De første utviklerne, ingeniørene i datasentrene og administratorene (inkludert den nye koordinatoren) har begynt gjenopprettingsarbeidet.
09:37. Vi har begynt å heve rom nr. 7 (det siste).
Samtidig fortsetter vi å gjenopprette det vi ikke har fått gjort ferdig i de andre rommene: bytte disker/minne/servere, fikse alt som «brenner» i overvåkingen, reversere roller i master-standby skjemaene og andre småting, som likevel er ganske mange.
17:08. Vi tillater alle ordinære arbeider med produksjonen.
21:45. Arbeidet den andre dagen er avsluttet.
09:45. I dag er det fredag. Det er fortsatt en del småproblemer i overvåkingen. Helgen nærmer seg, og alle ønsker å slappe av. Vi fortsetter å fikse alt som kan fikses. Administrative oppgaver som kunne utsettes, blir utsatt. Den nye koordinatoren.
15:40. Plutselig restartet halvparten av Core-nettverksutstyret i EN ANNEN datasentral. Vi tok frontene ut av rotasjonen for å minimere risikoene. Ingen effekt for brukerne. Senere ble det klart at det var en defekt chassis. Koordinatoren jobber med å reparere to hendelser samtidig.
17:17. Nettverksarbeidet i den andre datasentralen er gjenopprettet, alt er sjekket. Datasentralen er tilbake i rotasjon.
18:29. Arbeidet med tredje dagen og generelt gjenopprettingen etter hendelsen er fullført.
Etterord
04.04.2013, «VKontakte», —portalen var helt eller delvis utilgjengelig i løpet av tre dager. I løpet av denne tiden var over 100 personer fra ulike byer og selskaper (takk igjen!), som jobbet både eksternt og direkte i datasentrene, inne og ute, manuelt og automatisk, i gang med å fikse tusenvis av servere.
Vi har lært leksjonene. For å unngå slike hendelser igjen har vi utført og fortsetter å utføre omfattende arbeider.
Hva er de viktigste forskjellene fra den nåværende krasjen sammenlignet med 404?
- Vi har fått en «Håndlingsplan for nødsituasjoner». Hver kvartal gjennomfører vi øvelser — simulerer en nødsituasjon som en gruppe administratorer (alle på tur) må løse ved hjelp av «Håndlingsplan for nødsituasjoner». Ledende systemadministratorer roterer i rollen som koordinator.
- Kvartalsvis isolerer vi datasentrene (alle på tur) fra LAN og WAN nettet i testmodus, noe som gjør oss i stand til å identifisere flaskehalser i tide.
- Færre feilaktige disker, fordi vi har skjerpet standardene: mindre arbeidstimer, strengere terskelverdier for S.M.A.R.T.,
- Vi har helt forkastet BerkeleyDB — den gamle og ustabile databasen som krevde mye tid for gjenoppretting etter omstart av serveren.
- Vi har redusert antallet servere med MS SQL og minsket avhengigheten fra de som er igjen.
- Vi har vårt eget hvor vi aktivt har migrert alle tjenester i over to år. Skyen forenkler hele arbeidsprosessen med applikasjonen, og i tilfelle av en nødsituasjon gir den unike verktøy som:
- korrekt stopp av alle applikasjoner med ett klikk;
- enkel migrering av applikasjoner fra failed servere;
- automatisk rangert (i prioritert rekkefølge av tjenester) oppstart av et helt datasenter.
Ulykken beskrevet i denne artikkelen ble den største siden den 404. Selvfølgelig gikk ikke alt helt glatt. For eksempel, under nedetiden til det brente datasenteret, sviktet en disk på en av serverne i et annet datasenter, noe som innebar at kun en av tre replikker i Cassandra-klyngen var tilgjengelig, og dermed kunne 4,2 % av brukerne av mobilapplikasjonene ikke logge inn. Samtidig fortsatte allerede tilkoblede brukere å arbeide. Totalt ble det avdekket mer enn 30 problemer etter ulykken - fra banale feil til mangler i arkitekturen til tjenestene.
Men den viktigste forskjellen mellom den nåværende ulykken og 404-eren er at mens vi håndterte konsekvensene av brannen, fortsatte brukerne å chatte og foreta videosamtaler i , spille spill, høre på musikk, gi hverandre gaver, se videoer, serier og TV-kanaler i , samt streame i .
Hvordan håndterer dere deres uhell?
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish