

For et halvt år siden — en offentlig for PostgreSQL.
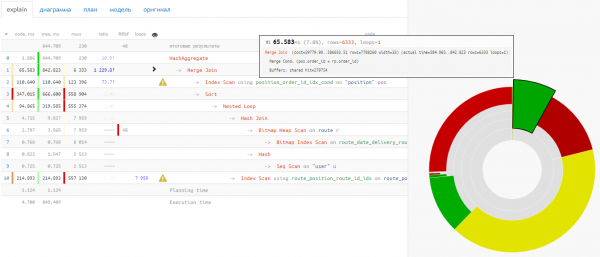
I løpet av de siste månedene har vi laget en rapport om det , forberedt en oppsummerende basert på anbefalingene det gir... men viktigst av alt – vi har samlet tilbakemeldingene deres og sett på reelle bruksområder.
Og nå er vi klare til å fortelle om de nye mulighetene som dere kan dra nytte av.
Støtte for ulike planformater
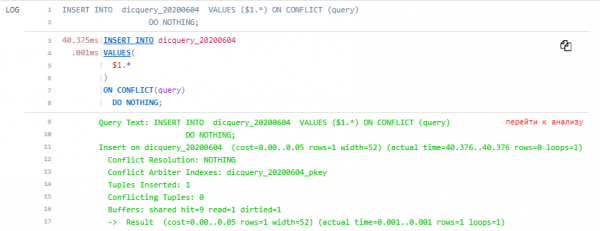
Planen fra loggen, sammen med spørringen
Vi markerer hele blokken fra konsollen, og begynner med linjen som inneholder Query Text, med alle ledende mellomrom:
        Query Text: INSERT INTO dicquery_20200604 VALUES ($1.*) ON CONFLICT (query)
                           DO NOTHING;
        Insert on dicquery_20200604  (cost=0.00..0.05 rows=1 width=52) (actual time=40.376..40.376 rows=0 loops=1)
          Conflict Resolution: NOTHING
          Conflict Arbiter Indexes: dicquery_20200604_pkey
          Tuples Inserted: 1
          Conflicting Tuples: 0
          Buffers: shared hit=9 read=1 dirtied=1
          ->  Result  (cost=0.00..0.05 rows=1 width=52) (actual time=0.001..0.001 rows=1 loops=1)
… og vi limer alt det kopierte rett inn i feltet for planen, uten å dele noe:
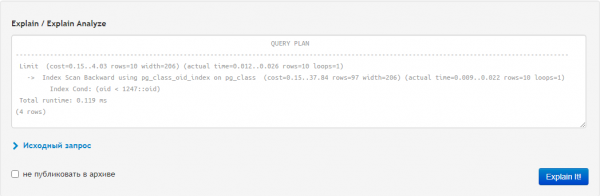
På utgangen får vi i tillegg til den analyserte planen også fanen «kontekst», hvor spørringen vår er vist i all sin prakt:
JSON og YAML
EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON)
SELECT * FROM pg_class;
"[
{
"Plan": {
"Node Type": "Seq Scan",
"Parallel Aware": false,
"Relation Name": "pg_class",
"Alias": "pg_class",
"Startup Cost": 0.00,
"Total Cost": 1336.20,
"Plan Rows": 13804,
"Plan Width": 539,
"Actual Startup Time": 0.006,
"Actual Total Time": 1.838,
"Actual Rows": 10266,
"Actual Loops": 1,
"Shared Hit Blocks": 646,
"Shared Read Blocks": 0,
"Shared Dirtied Blocks": 0,
"Shared Written Blocks": 0,
"Local Hit Blocks": 0,
"Local Read Blocks": 0,
"Local Dirtied Blocks": 0,
"Local Written Blocks": 0,
"Temp Read Blocks": 0,
"Temp Written Blocks": 0
},
"Planning Time": 5.135,
"Triggers": [
],
"Execution Time": 2.389
}
]"Enten med ytre anførselstegn, som pgAdmin kopierer, eller uten – vi kaster det i det samme feltet, og utgangen blir vakker:
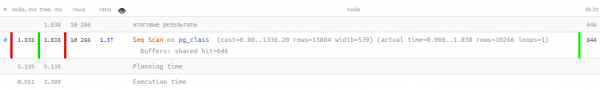
Utvidet visualisering
Planleggingstid / Utførelsestid
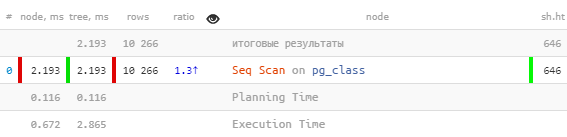
Nå er det bedre å se hvor det ekstra tiden gikk under utførelsen av spørringen:
I/O-tid
Noen ganger må man stå overfor situasjonen hvor planen ikke ser ut til å ha lest- eller skrevet for mange ressurser, men utførelsestiden er likevel uforholdsmessig lang.
Her må vi si: "Åh, sannsynligvis var disken på serveren overbelastet på det tidspunktet, så det tok så lang tid å lese!" Men det er ikke så veldig presist ...
Men dette kan bestemmes helt sikkert. Saken er at blant alternativene for PG-serverkonfigurasjonen finnes det :
Inkluderer måling av inn-/utdataoperasjoner. Denne parameteren er som standard deaktivert, ettersom det krever konstant forespørsel om nåværende tid fra operativsystemet, noe som kan betydelig redusere ytelsen på enkelte plattformer. For å vurdere kostnadene ved tidtaking på din plattform, kan du bruke verktøyet pg_test_timing. Statistikk over inn-/utdata kan hentes gjennom visningen pg_stat_database, i utskriften EXPLAIN (når parameteren BUFFERS brukes) og gjennom visningen pg_stat_statements.
Denne parameteren kan også aktiveres innenfor en lokal økt:
SET track_io_timing = TRUE;Nå, det mest interessante – vi har lært å forstå og vise disse dataene med hensyn til alle transformasjoner i kjøreoppsettet:
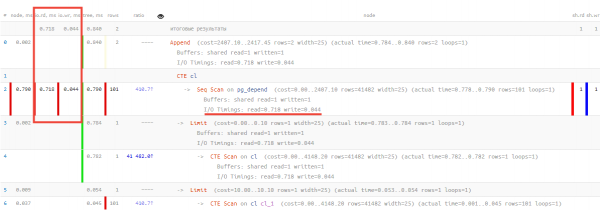
Her kan man merke seg at av 0.790 ms totalt kjøretid, tok 0.718 ms å lese én datasesjon, 0.044 ms – å skrive den samme, mens hele den øvrige nyttige aktiviteten kun tok 0.028 ms!
Fremtiden med PostgreSQL 13
Du kan lese den fullstendige oversikten over nyhetene , og vi vil spesifikt gå inn på endringene i planene.
Planleggingsbuffere
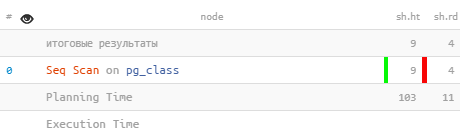
Regnskapet av ressursene tildelt planleggeren har også blitt reflektert i en annen patch, som ikke er relatert til pg_stat_statements. EXPLAIN med BUFFERS-alternativet vil rapportere antallet buffere brukt i planleggingsfasen:
 Seq Scan på pg_class (faktiske rader=386 sløyfer=1)
   Buffers: delt treff=9 lest=4
 Planleggingstid: 0.782 ms
   Buffers: delt treff=103 lest=11
 Kjøringstid: 0.219 ms
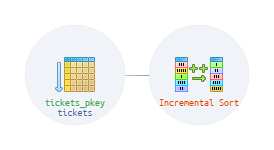
Inkrementell sortering
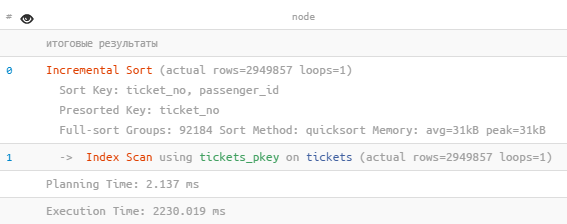
I tilfeller der det er nødvendig å sortere etter mange nøkler (k1, k2, k3…), kan planleggeren nå benytte seg av kunnskap om at dataene allerede er sortert etter noen av de første nøklene (for eksempel k1 og k2). I så fall er det ikke nødvendig å sortere alle dataene på nytt, men de kan deles inn i sekvensielle grupper med like verdier for k1 og k2, og “sorteres” etter nøkkelen k3.
Dermed brytes hele sorteringen ned til flere sekvensielle sorteringer av mindre størrelse. Dette reduserer den nødvendige minnebruken, og gjør det også mulig å levere de første dataene før hele sorteringen er fullført.
 Inkrementell Sort (faktiske rader=2949857 sløyfer=1)
   Sorteringsnøkkel: ticket_no, passenger_id
   Forhåndsortert nøkkel: ticket_no
   Fullsorteringsgrupper: 92184 Sorteringsmetode: hurtigsortering Minne: gj.snitt=31kB topp=31kB
   ->  Indeksfinn på tickets_pkey på billetter (faktiske rader=2949857 sløyfer=1)
 Planleggingstid: 2.137 ms
 Kjøringstid: 2230.019 ms
Forbedringer av UI/UX
Skjermbilder, de er overalt!
Nå er det mulig å raskt ta et skjermbilde av fanen til utklippstavlen i full bredde og dybde av fanen — «sikte» øverst til høyre:
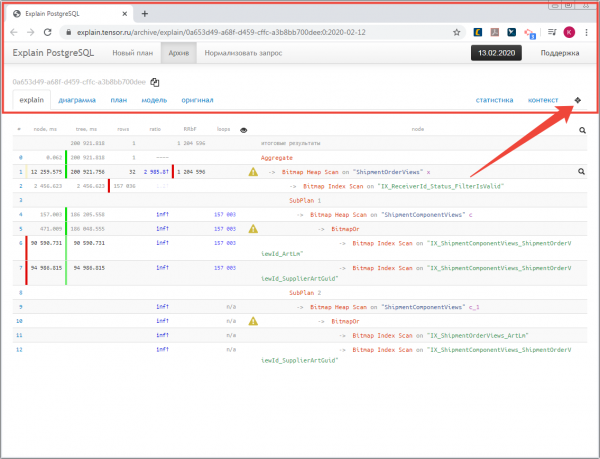
Faktisk er de fleste bildene for denne publikasjonen hentet nettopp slik.
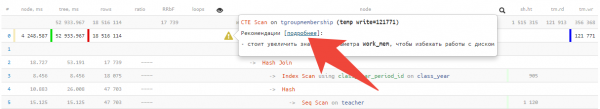
Anbefalinger på noder
De har ikke bare blitt flere, men man kan også , ved å klikke på lenken:
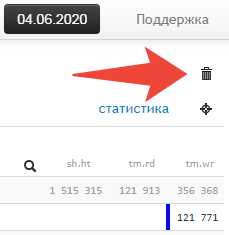
Fjerning fra arkivet
Noen har bedt om å legge til muligheten å slette «helt» selv om planer som ikke publiseres i arkivet — vær så snill, klikk på den tilsvarende ikonen:
Og glem ikke at vi har , hvor man kan sende inn sine merknader og forslag.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish