

Tolkning av Aleksej Lesovskijs foredrag fra 2015 "Dybdeanalyse av PostgreSQLs interne statistikker"
Ansvarsfraskrivelse fra forfatteren av foredraget: Jeg vil bemerke at dette foredraget er datert november 2015 — det har gått mer enn 4 år og mye har endret seg. Versjonen som diskuteres i foredraget, 9.4, støttes ikke lenger. I løpet av de siste 4 årene har det blitt utgitt 5 nye versjoner med mange nyheter, forbedringer og endringer angående statistikken, og en del av materialet er utdatert og ikke lenger relevant. Under gjennomgangen har jeg prøvd å merke disse punktene for ikke å villede deg, leser. Jeg har imidlertid ikke omskrevet disse delene, det er for mange til at det vil resultere i et helt annet foredrag.
PostgreSQL-database er en kjempemekanisme, og mekanismen består av mange subsystemer, hvor den koordinerte driften direkte påvirker ytelsen til databasen. Under driften samles statistikk og informasjon om komponentenes arbeid, noe som gjør det mulig å vurdere effektiviteten til PostgreSQL og iverksette tiltak for å forbedre ytelsen. Imidlertid er det mye informasjon, og den presenteres på en ganske forenklet måte. Å behandle denne informasjonen og tolke den er ofte en ganske komplisert oppgave, og "zoologisk hage" av verktøy og hjelpemidler kan lett sette selv en avansert DBA på prøve.
God dag! Jeg heter Aleksej. Som Ilja sa, skal jeg snakke om statistikken til PostgreSQL.
Statistikk over aktivitet i PostgreSQL. PostgreSQL har to typer statistikker. Aktivitetens statistikk, som vil bli diskutert. Og planleggerens statistikk om datadistribusjonen. Jeg skal spesifikt snakke om aktivitetens statistikk i PostgreSQL, som lar oss vurderer ytelsen og hvordan vi kan forbedre den.
Jeg vil forklare hvordan man effektivt kan bruke statistikk for å løse de ulike problemene du har eller kan komme til å ha.
Hva vil ikke bli dekket i foredraget? Jeg kommer ikke til å berøre planleggerens statistikk, da dette er et eget tema for et eget foredrag om hvordan data lagres i databasen og hvordan spørringsplanleggeren får en forståelse av de kvalitetsmessige og kvantitative egenskapene til disse dataene.
Og det vil ikke bli noen verktøysgjennomganger, jeg vil ikke sammenligne ett produkt med et annet. Det vil ikke bli noen reklame. La oss legge det til side.
Eg vil vise deg at det er nyttig å bruke statistikk. Det er nødvendig. Å bruke den er ikke skummelt. Vi trenger bare vanlig SQL og grunnleggende kunnskap om SQL.
Og vi skal snakke om hvilken statistikk vi bør velge for å løse problemer.
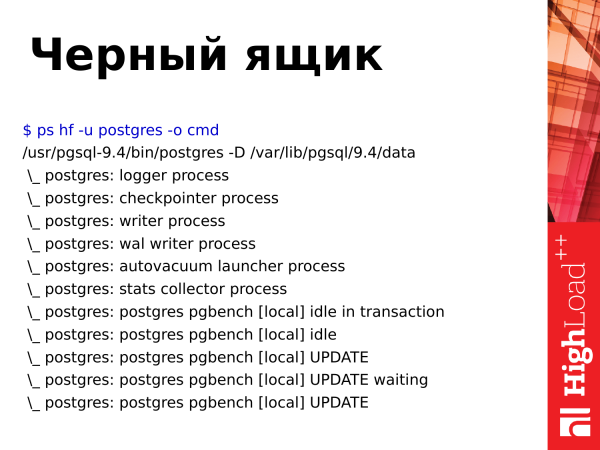
Hvis vi ser på PostgreSQL og kjører en kommando i operativsystemet for å se prosessene, vil vi se en "svart boks". Vi ser noen prosesser som gjør noe, og vi kan omtrent gjette hva de gjør ut fra navnene. Men i bunn og grunn er dette en svart boks, vi kan ikke se inn i den.
Vi kan se belastningen på prosessoren i top, vi kan se minneutnyttelsen med noen systemverktøy, men vi kan ikke se inn i PostgreSQL. For dette trenger vi andre verktøy.
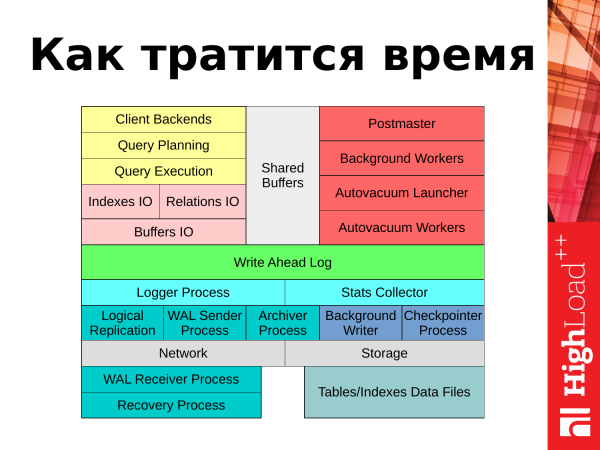
Og videre vil jeg fortelle hvor tiden går. Hvis vi forestiller oss PostgreSQL som et slikt skjema, kan vi svare på hvor tiden går. Det er to ting: det er behandling av klientforespørselene fra applikasjoner og bakgrunnsoppgaver som PostgreSQL utfører for å opprettholde sin drift.
Hvis vi begynner å se fra øverste venstre hjørne, kan vi følge hvordan klientforespørselene behandles. Forespørselen kommer fra applikasjonen, og for videre arbeid åpnes en klientøkt. Forespørselen sendes til planleggeren. Planleggeren bygger en forespørselplan. Den sendes videre for utførelse. Det skjer en viss blokkinn- og utdata knyttet til tabeller og indekser. Nødvendige data leses fra diskene inn i minnet i et spesialområde kalt "shared buffers". Resultatene av forespørselen, hvis det er oppdateringer, slettinger, blir registrert i transaksjonsloggen i WAL. Noe statistisk informasjon havner i loggen eller i statistikkinnsamleren. Og resultatet av forespørselen returneres til klienten. Etterpå kan klienten gjenta alt på nytt med en ny forespørsel.
Hva skjer med bakgrunnsoppgavene og bakgrunnsprosessene? Vi har flere prosesser som sørger for funksjonaliteten og opprettholder databasen i normal drift. Disse prosessene vil også bli berørt i presentasjonen: det er autovacuum, checkpointer, prosesser relatert til replikering, bakgrunnsskriver. Jeg vil ta for meg hver av dem etter hvert som presentasjonen skrider frem.
Hvilke problemer finnes med statistikken?
- Det er mye informasjon. PostgreSQL 9.4 gir 109 metrikker for innsamling av statistikkdata. Men hvis det er mange tabeller, skjemaer eller databaser lagret i databasen, må alle disse metrikkene multipliseres med det gjeldende antallet tabeller eller databaser. Det vil si at informasjonen blir enda mer omfattende, og det er enkelt å drukne i den.
- Det neste problemet er at statistikken presenteres som tellere. Hvis vi ser på denne statistikken, vil vi se at tellerne konstant øker. Og hvis det har gått lang tid siden statistikken ble nullstilt, vil vi se milliarder av verdier. Disse gir oss ikke noe nyttig informasjon.
- Det finnes ingen historie. Hvis du opplever et feil eller et krasj 15–30 minutter tilbake, vil du ikke kunne bruke statistikken til å se hva som skjedde i løpet av de siste 15–30 minuttene. Dette er et problem.
- Mangelen på et innebygd verktøy i PostgreSQL er et problem. Utviklerne av kjernen gir ingen verktøy. De har ikke noe slikt. De gir ganske enkelt statistikk i databasen. Bruk det, gjør forespørslene du vil.
- Siden det ikke finnes noe innebygd verktøy i PostgreSQL, fører dette til et annet problem. Mange tredjepartsverktøy. Hver bedrift med noenlunde dyktige utviklere prøver å lage sitt eget program. Og til slutt er det mange verktøy i fellesskapet som kan brukes til arbeid med statistikk. Noen verktøy har noen funksjoner, mens andre verktøy ikke har disse, eller så har de nye funksjoner. Det oppstår en situasjon der du må bruke to, tre eller fire verktøy som overlapper hverandre og har forskjellige funksjoner. Dette er svært plagsomt.
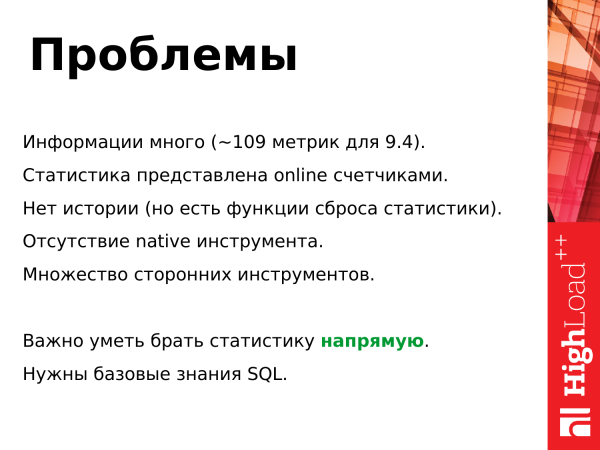
Hva følger av dette? Det er viktig å kunne hente statistikk direkte, slik at man ikke er avhengig av programmer, eller på en eller annen måte forbedre disse programmene: legge til funksjoner for å oppnå egne fordeler.
Og grunnleggende SQL-kunnskaper er nødvendig. For å hente ut data fra statistikken må du lage SQL-spørsmål, nemlig du må vite hvordan du setter sammen select, join.
Statistikken tilbyr oss flere ting. Disse kan deles inn i kategorier.
- Den første kategorien er hendelser som skjer i databasen. Dette er når det skjer en hendelse i databasen: en forespørsel, tilgang til en tabell, auto-vakuum, committer, så alle disse er hendelser. Telleapparater som tilsvarer disse hendelsene blir inkrementert. Og vi kan spore disse hendelsene.
- Den andre kategorien er egenskaper ved objektene som tabeller og databaser. De har egenskaper. Dette er størrelsen på tabellene. Vi kan spore veksten av tabeller, veksten av indekser. Vi kan se endringer i dynamikken.
- Og den tredje kategorien er tiden brukt på en hendelse. En forespørsel er en hendelse. Den har sitt eget spesifikke mål for varighet. Her startet det, her ble det avsluttet. Vi kan spore dette. Enten tiden brukt på å lese en blokk fra disken eller skrive. Slike ting blir også sporet.
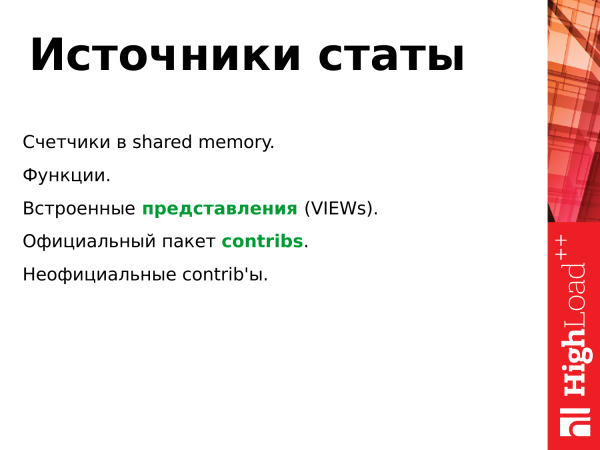
Kildene til statistikk er presentert på følgende måte:
- I delt minne (shared buffers) er det et segment for å plassere der statiske data, der er også de samme telleapparatene, som kontinuerlig inkrementeres når det skjer ulike hendelser, eller det oppstår øyeblikk i databasens drift.
- Alle disse telleapparatene er ikke tilgjengelige for brukeren og er heller ikke tilgjengelige for administratoren. Dette er lavnivåelementer. For å få tilgang til dem gir PostgreSQL et grensesnitt i form av SQL-funksjoner. Vi kan lage select-spørringer ved hjelp av disse funksjonene og få noen metrikker (eller et sett med metrikker).
- Imidlertid er det ikke alltid praktisk å bruke disse funksjonene, så funksjonene er grunnlaget for visninger (VIEWs). Dette er virtuelle tabeller som gir statistikk over et spesifikt undersystem, eller over et sett med hendelser i databasen.
- Disse innebygde visningene (VIEWs) er hovedgrensesnittet for brukeren for å arbeide med statistikk. De er tilgjengelige som standard uten noen ekstra konfigurasjon, så du kan bruke dem umiddelbart, se og hente informasjon derfra. Det er også bidrag. Bidragene er offisielle. Du kan installere pakken postgresql-contrib (for eksempel postgresql94-contrib), laste inn den nødvendige modulen i konfigurasjonen, angi parametere for den, starte PostgreSQL på nytt, og så kan den brukes. (Merk. Avhengig av distribusjonen, er i de nyeste versjonene bidragspakken en del av hovedpakken.).
- Det finnes uoffisielle contrib. De følger ikke med i standardleveransen av PostgreSQL. De må enten kompileres eller installeres som et bibliotek. Alternativene kan være mange, avhengig av hva utvikleren av denne uoffisielle contrib'en har funnet på.
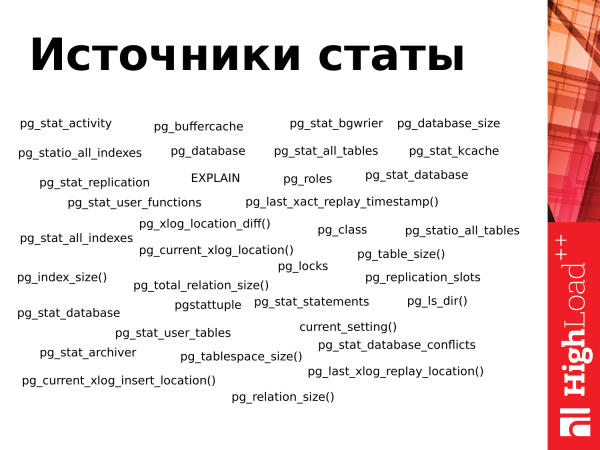
På dette lysbildet presenteres alle de visningene (VIEWs) og noen av de funksjonene som er tilgjengelige i PostgreSQL 9.4. Som vi ser, er de veldig mange. Det kan være ganske lett å bli forvirret hvis man møter dette for første gang.
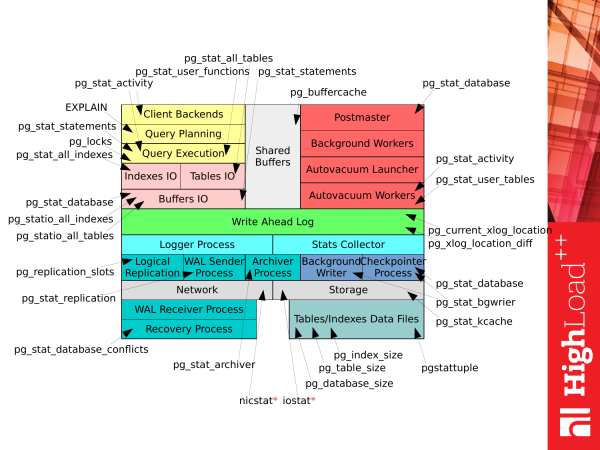
Men hvis vi tar det forrige bildet Hvordan tiden brukes på PostgreSQL og sammenligner med denne listen, får vi et slikt bilde. Hver visning (VIEWs), eller hver funksjon, kan brukes til forskjellige formål for å få relevant statistikk når vi jobber med PostgreSQL. Vi kan allerede få viss informasjon om systemets drift.
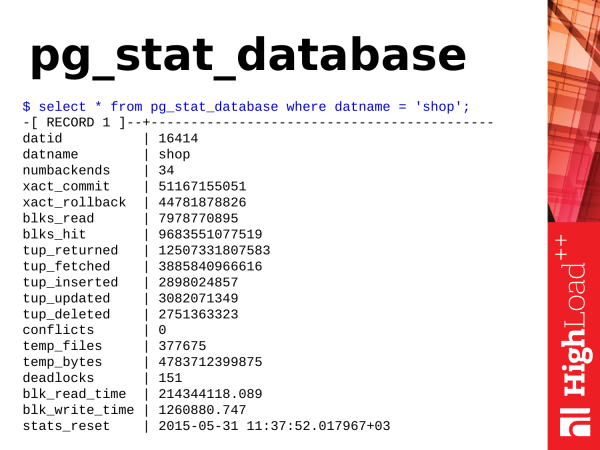
Det første vi skal se på, er pg_stat_database. Som vi ser, er dette en visning. Den inneholder veldig mye informasjon. Den mest varierte informasjonen. Og den gir oss nyttig innsikt i hva som skjer i databasen.
Hva kan vi nyttig ta derfra? Vi begynner med de enkleste tingene.
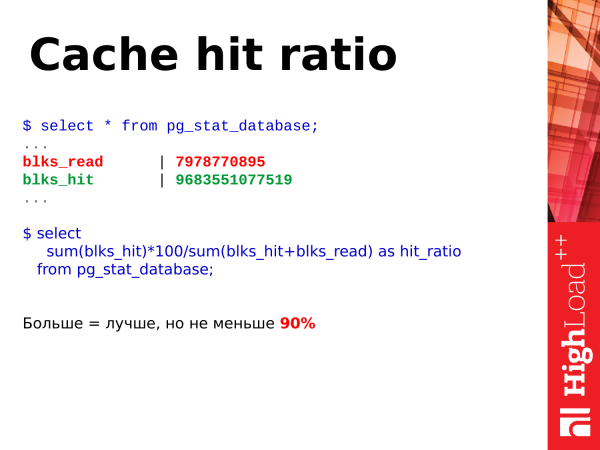
select
sum(blks_hit)*100/sum(blks_hit+blks_read) as hit_ratio
from pg_stat_database;
Det første vi kan se på er prosentandelen av treff i hurtigminnet. Prosentandelen av treff i hurtigminnet er en nyttig metrikk. Den lar oss vurdere hvor mye data som hentes fra hurtigminnet i delte buffere, og hvor mye som leses fra disken.
Selvfølgelig er det jo høyere treffprosent vi har, jo bedre. Vi vurderer denne metrikken som en prosent. For eksempel, hvis prosentandelen av treffene i hurtigminnet er over 90 %, er det bra. Hvis den faller under 90 %, betyr det at vi ikke har nok minne til å holde den «hete» delen av dataene i minnet. For å bruke disse dataene må PostgreSQL ty til disken, og det er tregere enn å lese data fra minnet. Da må man vurdere å øke minnet: enten øke de delte bufferne eller oppgradere den fysiske minnen (RAM).
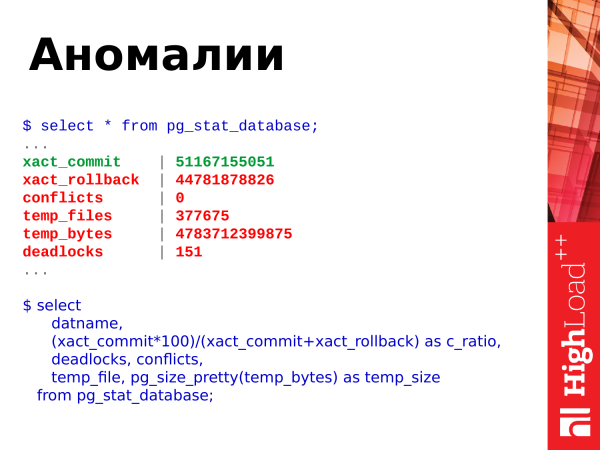
select
datname,
(xact_commit*100)/(xact_commit+xact_rollback) as c_ratio,
deadlocks, conflicts,
temp_file, pg_size_pretty(temp_bytes) as temp_size
from pg_stat_database;
Hva mer kan vi ta fra denne visningen? Vi kan se på anomalier som skjer i databasen. Hva vises her? Her er commits, rollbacks, opprettelse av midlertidige filer, deres størrelse, deadlocks og konflikter.
Vi kan bruke denne forespørselen. Denne SQL-en er ganske enkel. Og vi kan se på disse dataene hos oss selv.
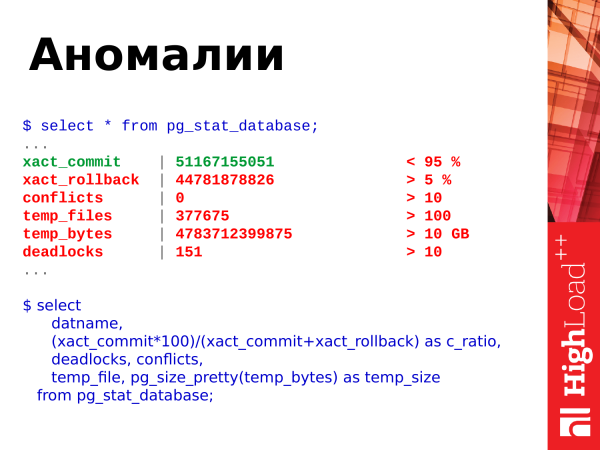
Og her er terskelverdiene. Vi ser på forholdet mellom commits og rollbacks. Commits er vellykkede bekreftelser av transaksjoner. Rollbacks er tilbakerullinger, det vil si at transaksjonen har utført arbeid, belastet databasen, gjort noen beregninger, men så skjedde det en feil, og resultatene av transaksjonen blir forkastet. Det vil si, antallet rollbacks som stadig øker, er dårlig. Og man bør på en eller annen måte unngå dem og rette koden for å hindre slike situasjoner.
Konflikter (conflicts) er relatert til replikering. Og disse bør også unngås. Hvis du har forespørslene som kjører på replikatet og det oppstår konflikter, må du håndtere disse konfliktene, se hva som skjer. Detaljer kan finnes i loggene. Og eliminere konfliktfylte situasjoner, slik at applikasjonsforespørslene fungerer uten feil.
Deadlocks er også en dårlig situasjon. Når forespørslene kjemper om ressurser, og en forespørsel får lås på en ressurs, mens en annen forespørsel får lås på en annen ressurs, og deretter begge forespørslene prøver å få tilgang til hverandres ressurser og blir låst i påvente av at nabobrukeren slipper låsen. Dette er også et problem. De må løses på nivået med omprogrammering av applikasjoner og serialisering av tilgang til ressurser. Og hvis du ser at deadlocks øker konstant, må du sjekke detaljene i loggene, håndtere oppståtte situasjoner og se hva problemet er.
Midlertidige filer (temp_files) er også dårlige. Når en brukers forespørsel mangler minne til å plassere midlertidige data, oppretter den en fil på disken. Og alle operasjoner som den kunne utført i et midlertidig buffer i minnet, begynner å bli utført på disken. Dette er tregt. Dette øker tiden det tar å utføre forespørselen. Og klienten som sendte forespørselen til PostgreSQL vil motta svaret litt senere. Hvis alle disse operasjonene blir utført i minnet, vil Postgres svare mye raskere, og klienten vil vente mindre.
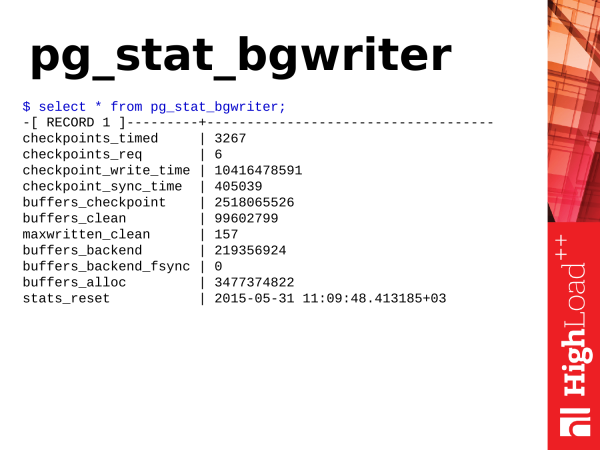
Pg_stat_bgwriter er en visning som beskriver arbeidet til to bakgrunnssystemer i PostgreSQL: det er checkpointer og background writer.
For å begynne med, skal vi se på kontrollpunktene, såkalte checkpoints. Hva er kontrollpunkter? Et kontrollpunkt er en posisjon i transaksjonsloggen som indikerer at alle dataendringer som er registrert i loggen, har blitt vellykket synkronisert med dataene på disken. Prosessen kan, avhengig av arbeidsbelastningen og innstillinger, være tidkrevende og innebærer for det meste synkronisering av skitne sider i delte buffer med datafiler på disken. Hva er hensikten med dette? Hvis PostgreSQL alltid skulle kontakte disken for å hente data og skrive data ved hver forespørsel, ville det vært sakte. Derfor har PostgreSQL et minnesegment, størrelsen på dette avhenger av konfigurasjonsparameterne. Postgres lagrer de operative dataene i dette minnet for senere behandling eller uttak etter forespørsel. I tilfelle av forespørsel om dataendringer skjer deres modifikasjon. Og vi får to versjoner av dataene. Den ene har vi i minnet, den andre på disken. Og vi må periodisk synkronisere disse dataene. Vi må synkronisere det som er endret i minnet til disken. For dette trenger vi kontrollpunkt.
Kontrollpunktet går gjennom delte buffere, merker de skitne sidene som nødvendige for kontrollpunktet. Deretter starter det en annen runde gjennom delte buffere. Og sidene som er merket for kontrollpunktet, synkroniseres allerede. Slik utføres synkroniseringen av dataene med disken.
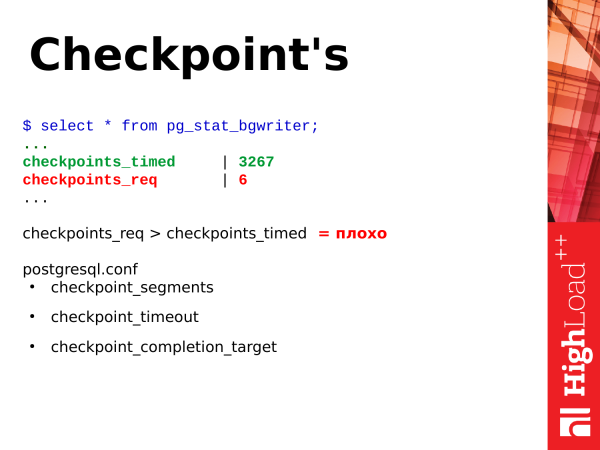
Det finnes to typer kontrollpunkter. Et kontrollpunkt utføres etter en tidsavbrudd. Dette er et nyttig og godt kontrollpunkt – checkpoint_timed. Og det finnes kontrollpunkter på forespørsel – checkpoint required. Et slikt kontrollpunkt skjer når vi har en veldig stor dataskriving. Vi har skrevet veldig mange transaksjonslogger. Og PostgreSQL mener at det er nødvendig å synkronisere alt dette så raskt som mulig, lage et kontrollpunkt og fortsette.
Og hvis du har sett på statistikken pg_stat_bgwriter og sett at du har checkpoint_req mye høyere enn checkpoint_timed, så er det dårlig. Hvorfor er det dårlig? Dette betyr at PostgreSQL befinner seg i en konstant stressende situasjon der det må skrive data til disken. Kontrollpunktet etter tidsavbrudd er mindre stressende og utføres i henhold til en intern timeplan, og strekkes over tid. PostgreSQL har mulighet til å ta pauser i arbeidet og ikke belaste disk-systemet. Dette er gunstig for PostgreSQL. Og forespørslene som kjøres under kontrollpunktet, vil ikke oppleve stress fra at disk-systemet er opptatt.
Og for å justere checkpoint finnes det tre parametere:
checkpoint_segments.checkpoint_timeout.checkpoint_competion_target.
Disse lar deg regulere funksjonen til kontrollpunktene. Men jeg skal ikke dvele ved dem. Deres påvirkning er et eget emne.
Vær oppmerksom: Versjonen som diskuteres i rapporten, 9.4, er allerede foreldet. I moderne versjoner av PostgreSQL er parameteren checkpoint_segments erstattet av parameterne min_wal_size og max_wal_size.
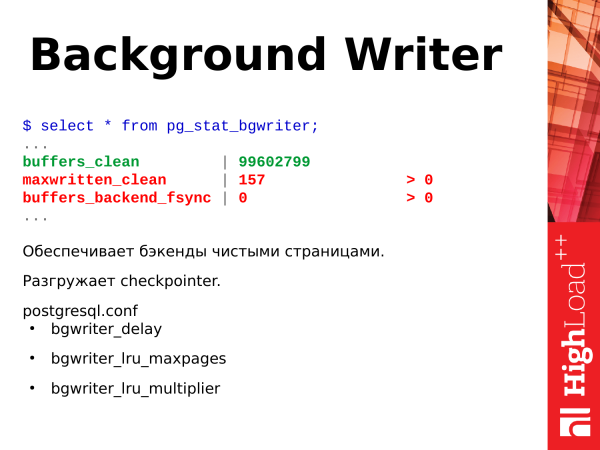
Den neste delsystemet er bakgrunnsskriveren — background writer. Hva gjør han? Han jobber kontinuerlig i en evig sløyfe. Han skanner sider i delte buffere og skriver skitne sider han finner til disken. På denne måten hjelper han checkpointeren med å redusere arbeidsmengden under utførelsen av kontrollpunktene.
Hvorfor er han også nødvendig? Han sikrer behovet for rene sider i delte buffere dersom de kreves (i store mengder og samtidig) for å lagre data. La oss anta at det oppstår en situasjon hvor det for en forespørsel kreves rene sider, og de allerede finnes i delte buffere. Postgres backend tar dem bare og bruker dem, han trenger ikke å rydde noe selv. Men hvis slike sider ikke finnes, stanser backend arbeidet og begynner å lete etter sider for å skrive dem til disken og ta dem i bruk — noe som negativt påvirker tiden for den pågående forespørselen. Hvis du ser at parameteren din maxwritten_clean er høy, betyr det at bakgrunnsskriveren ikke klarer å utføre arbeidet sitt, og du må øke parameterne bgwriter_lru_maxpages, slik at han kan utføre mer arbeid på en syklus og rense flere sider.
En annen veldig nyttig indikator er buffers_backend_fsync. Backends utfører ikke fsync, fordi det er tregt. De videresender fsync oppover IO-stakken til checkpointeren. Checkpointeren har sin egen kø, han behandler fsync periodisk og synkroniserer sider i minnet med filer på disken. Hvis køen til checkpointeren er stor og fylt, må backend selv utføre fsync, og dette reduserer backends ytelse,det vil si at klienten får svar senere enn nødvendig. Hvis du ser at denne verdien er større enn null, er det allerede et problem, og du må se nærmere på innstillingene for bakgrunnsskriveren og vurdere ytelsen til disk subsystemet.
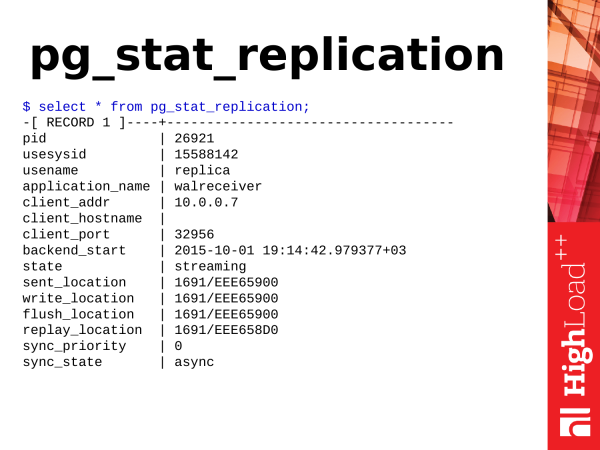
Vær oppmerksom: _Følgende tekst beskriver statistiske visninger relatert til replikering. De fleste av navnene på visninger og funksjoner ble omdøpt i Postgres 10. Hovedpoenget med omdøpingen var å erstatte xlog En funksjon har blitt wal og plassering En funksjon har blitt lsn i navnene på funksjoner/visninger osv. Et spesifikt eksempel, funksjonen pg_xlog_location_diff() ble omdøpt til pg_wal_lsn_diff()._
Her har vi også mye. Men vi trenger bare punktene som er relatert til plassering.
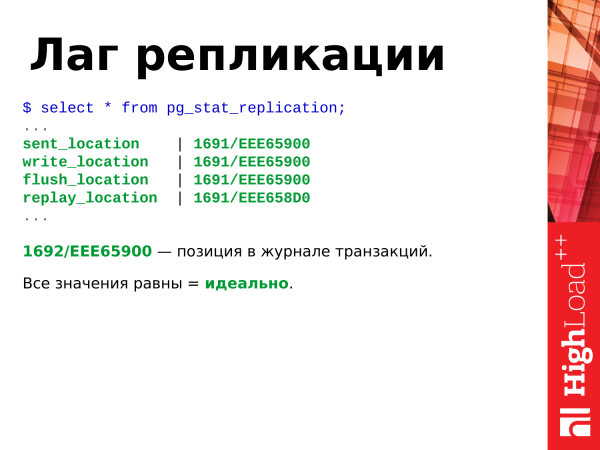
Hvis vi ser at alle verdiene er like, så er det en ideell situasjon og replikeringen ligger ikke etter masteren.
Denne heksadesimale posisjonen – det er posisjonen i transaksjonsloggen. Den øker kontinuerlig, hvis det er noe aktivitet i databasen: innsendinger, slettinger osv.
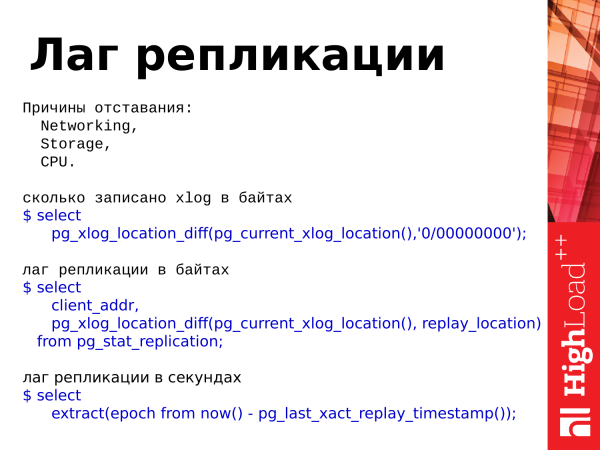
hvor mye xlog er skrevet i byte
$ select
pg_xlog_location_diff(pg_current_xlog_location(),'0/00000000');
replikas lag i byte
$ select
client_addr,
pg_xlog_location_diff(pg_current_xlog_location(), replay_location)
from pg_stat_replication;
replikas lag i sekunder
$ select
extract(epoch from now() - pg_last_xact_replay_timestamp());
Hvis disse tingene er forskjellige, betyr det at det er et lag. Lag – det er forsinkelsen til replikasjonen bak masteren, altså at dataene er forskjellige mellom serverne.
Det er tre årsaker til forsinkelse:
- Det er diskundersystemet som ikke klarer å håndtere synkronisering av filer.
- Det er mulige nettverksfeil, eller nettverksbelastning, når dataene ikke rekker fram til replikasjonen, og den ikke klarer å reprodusere dem.
- Og prosessoren. Prosessoren – det er et veldig sjeldent tilfelle. Jeg har sett dette to eller tre ganger, men det kan også skje.
Og her er tre spørsmål som tillater oss å bruke statistikk. Vi kan vurdere hvor mye vi har skrevet i transaksjonsloggen. Det finnes en funksjon pg_xlog_location_diff og vi kan vurdere replikas lag i byte og sekunder. Vi bruker også verdien fra denne visningen (VIEWs) for dette.
Merk: _I stedet for pg_xlog_locationdiff() kan man bruke subtraksjonsoperatøren for å trekke en plassering fra en annen. Praktisk.
Når det gjelder lag som er i sekunder, er det et moment. Hvis det ikke er noen aktivitet på masteren, transaksjonen skjedde for omtrent 15 minutter siden og det er ingen aktivitet, og hvis vi ser på replikas lag, så vil vi se et lag på 15 minutter. Dette er noe å huske på. Og det kan være forvirrende når du ser dette laget.
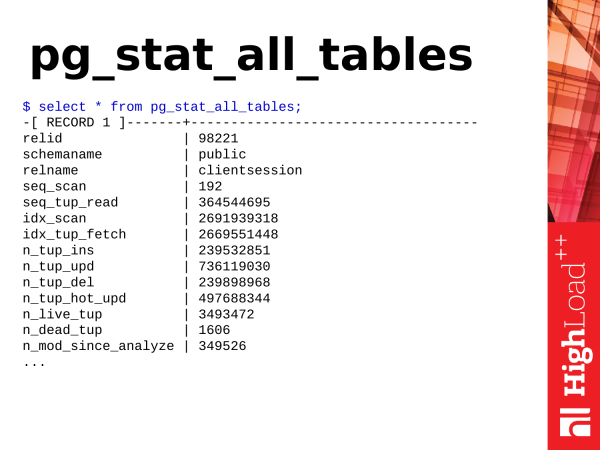
Pg_stat_all_tables – en nyttig visning. Den viser statistikk for tabeller. Når vi har tabeller i databasen, med noe aktivitet eller handlinger, kan vi få denne informasjonen fra visningen.
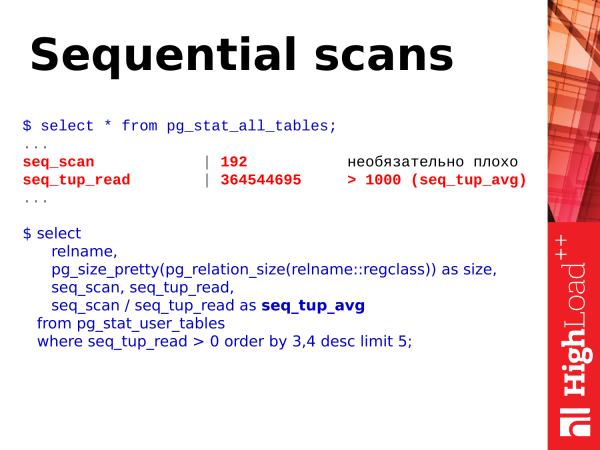
select
relname,
pg_size_pretty(pg_relation_size(relname::regclass)) as size,
seq_scan, seq_tup_read,
seq_scan / seq_tup_read as seq_tup_avg
from pg_stat_user_tables
where seq_tup_read > 0 order by 3, 4 desc limit 5;
Det første vi kan se på, er de sekvensielle skanningene for tabellen. Selve tallet etter disse passeringene signaliserer ikke nødvendigvis et problem, og er ikke noe bevis på at vi trenger å ta noen tiltak.
Imidlertid er det en annen metrikk – seq_tup_read. Dette er antallet rader som returneres som resultat av sekvensiell skanning. Hvis det gjennomsnittlige tallet overstiger 1 000, 10 000, 50 000, 100 000, så er dette et tegn på at du kanskje trenger å opprette et indeks, slik at tilgangene går via indeksen, eller kanskje optimalisere forespørslene som bruker slike sekvensielle skanninger, for å unngå dette.
Et enkelt eksempel – anta at en forespørsel med stort OFFSET og LIMIT er utfordrende. For eksempel når 100 000 rader skannes i tabellen og deretter 50 000 relevante rader hentes, mens de foregående skannede radene forkastes. Dette er også et dårlig tilfelle. Slike forespørsler må optimaliseres. Og her er det en enkel SQL-forespørsel som vi kan se på for å evaluere de oppnådde tallene.
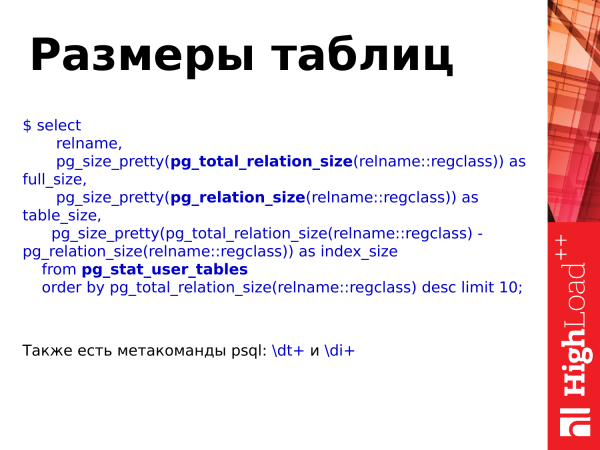
select
relname,
pg_size_pretty(pg_total_relation_size(relname::regclass)) as
full_size,
pg_size_pretty(pg_relation_size(relname::regclass)) as
table_size,
pg_size_pretty(pg_total_relation_size(relname::regclass) -
pg_relation_size(relname::regclass)) as index_size
from pg_stat_user_tables
order by pg_total_relation_size(relname::regclass) desc limit 10;
Størrelsene på tabellene kan også fås med denne tabellen og også med tilleggfunksjoner pg_total_relation_size(), pg_relation_size().
Generelt er det metakommander dt og di, som kan brukes i PSQL for å se størrelsene på tabeller og indekser.
Imidlertid hjelper det å bruke funksjoner oss med å se størrelsene på tabeller med eller uten indekser, og dermed vurdere veksten av databasen, dvs. hvordan den vokser, med hvilken intensitet og trekke konklusjoner angående optimalisering av størrelser.
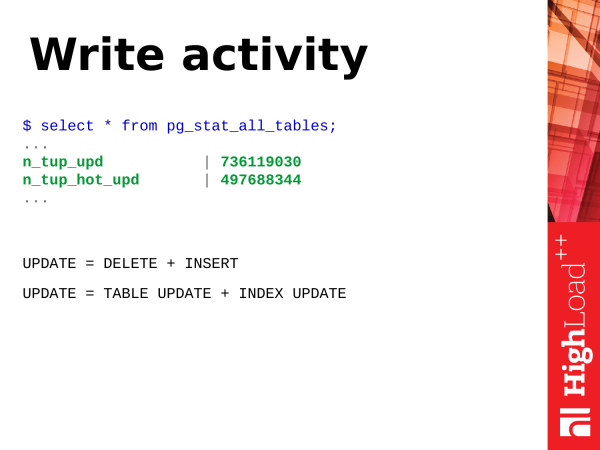
Skriveaktivitet. Hva er skriving? La oss se på operasjonen UPDATE – oppdatering av rader i tabellen. I bunn og grunn er update to operasjoner (eller flere). Det er innsetting av en ny versjon av raden og merking av den gamle versjonen som foreldet. Senere vil autovacuum fjerne disse foreldede versjonene av radene og merke dette stedet som tilgjengelig for gjenbruk.
I tillegg er update ikke bare oppdatering av tabellen. Det er også oppdatering av indekser. Hvis du har mange indekser på tabellen, må alle indekser som involverer feltene som oppdateres i spørringen, også oppdateres. Disse indeksene vil også ha foreldede versjoner av radene som må ryddes opp.
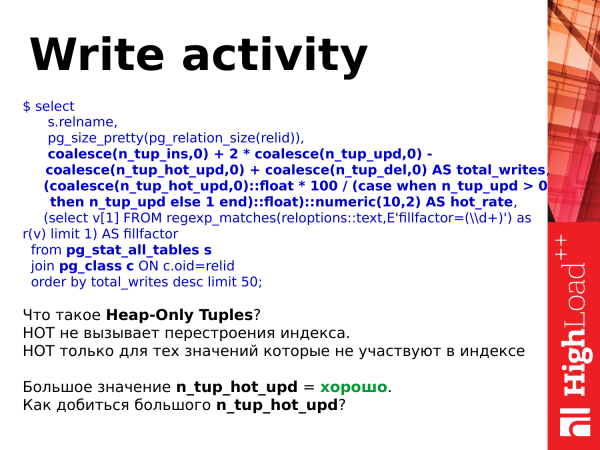
select
s.relname,
pg_size_pretty(pg_relation_size(relid)),
coalesce(n_tup_ins,0) + 2 * coalesce(n_tup_upd,0) -
coalesce(n_tup_hot_upd,0) + coalesce(n_tup_del,0) AS total_writes,
(coalesce(n_tup_hot_upd,0)::float * 100 / (case when n_tup_upd > 0
then n_tup_upd else 1 end)::float)::numeric(10,2) AS hot_rate,
(select v[1] FROM regexp_matches(reloptions::text,E'fillfactor=(\d+)') as
r(v) limit 1) AS fillfactor
from pg_stat_all_tables s
join pg_class c ON c.oid=relid
order by total_writes desc limit 50;
Og på grunn av sitt design, er UPDATE tunge operasjoner. Men de kan gjøres lettere. Det er hot updates. De ble innført i PostgreSQL versjon 8.3. Og hva er dette? Det er en lettvekts update som ikke forårsaker ombygging av indekser. Det vil si, vi oppdaterte posten, men kun posten i siden (som tilhører tabellen) ble oppdatert, mens indekser fortsatt peker på den samme posten i siden. Det er litt interessant logikk her, når vacuum kommer, så omstrukturerer den disse kjedene hot og alt fortsetter å fungere uten oppdatering av indekser, og alt skjer med mindre ressursforbruk.
Og når du har n_tup_hot_upd stort, så er det veldig bra. Det betyr at lettvekts updates dominerer og det blir billigere ressursmessig, og alt er flott.
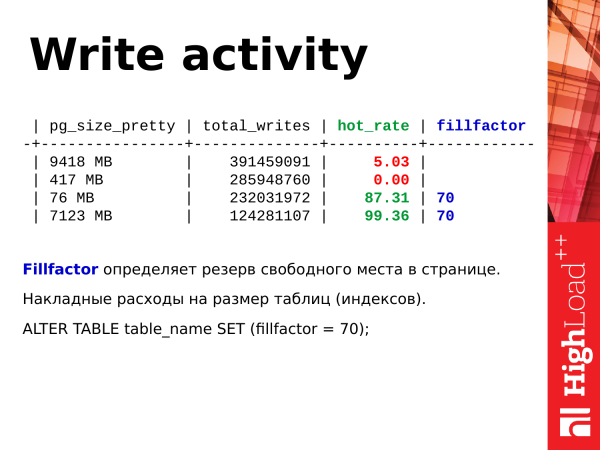
ALTER TABLE table_name SET (fillfactor = 70);Hvordan øke volumet av hot updateer? Vi kan bruke fillfactor. Det bestemmer størrelsen på det reserverte ledige plass når siden i tabellen fylles med INSERT-er. Når det kommer INSERT-er i tabellen, fyller de helt siden, og etterlater ikke tom plass. Så tildeles en ny side. Igjen fylles dataene. Og denne oppførselen er standard, fillfactor = 100 %.
Vi kan sette fillfactor til 70 %. Det vil si at når det settes inn nye poster, vil bare 70 % av siden fylles. Og 30 % er igjen som reserve. Når vi trenger å gjøre oppdateringer, vil de mest sannsynlig skje på den samme siden, og den nye versjonen av raden vil plasseres på den samme siden. Det vil bli gjort en hot_update. Dermed forenkles skrivingen på tabellene.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
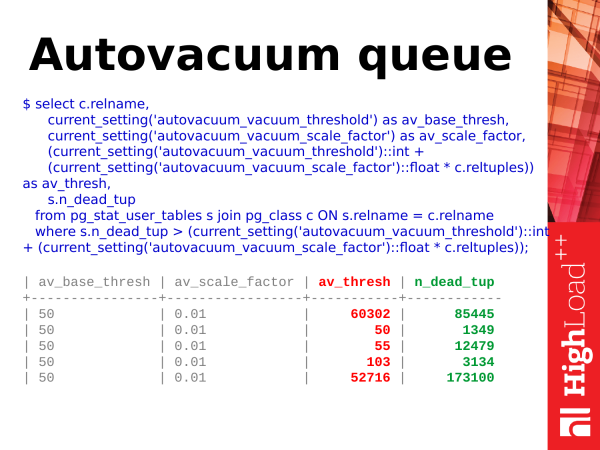
Køen for avfallsrensing. Avfallsrensing er et slikt subsystem der det er svært lite statistikk i PostgreSQL. Vi kan i tabellene bare i pg_stat_activity se hvor mange avfall som pågår akkurat nå. Men det er veldig vanskelig å forstå hvor mange tabeller som er i kø hos det.
Merk: Fra og med versjon Postgres 10 har situasjonen rundt sporing av avfall blitt betydelig bedre — visningen pg_stat_progress har blitt tilgjengelig.vacuum, som gjør overvåkningen av avfallsrensing betydelig enklere.
Vi kan bruke en slik forenklet forespørsel. Og vi kan se når avfallsrensing må gjøres. Men hvordan og når skal avfallsrensing starte? Det er disse utdaterte versjonene av radene jeg nevnte tidligere. Oppdatering skjedde, den nye versjonen av raden ble satt inn. Den utdaterte versjonen av raden dukket opp. I tabellen pg_stat_user_tables finnes det en parameter n_dead_tup. Den viser hvor mange "døde" rader det er. Og så snart antallet døde rader blir større enn en viss terskel, vil avfallsrensing komme til tabellen.
Og hvordan beregnes denne terskelen? Det er et ganske bestemt prosentforhold av det totale antallet rader i tabellen. Det finnes en parameter autovacuum_vacuum_scale_factor. Den bestemmer prosentforholdet. Si at det er 10 % + en ekstra basis terskel på 50 rader. Og hva skjer? Når vi har flere døde rader enn "10 % + 50" av alle radene i tabellen, setter vi tabellen på avfallet.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
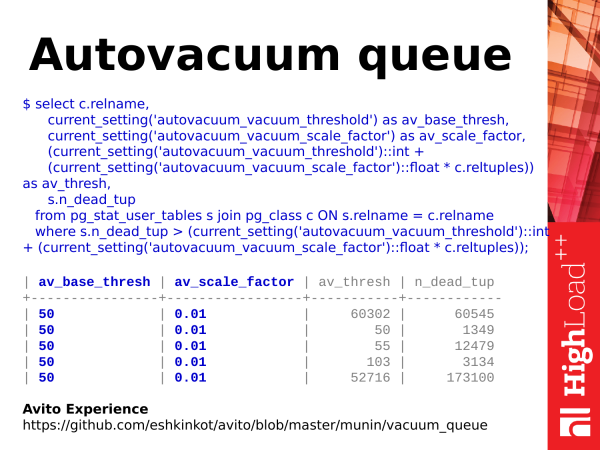
Det er imidlertid ett punkt her. De grunnleggende tersklene for parameterne av_base_thresh og av_scale_factor kan bli tildelt individuelt. Og dermed vil terskelen ikke være global, men individuell for tabellen. Derfor for å beregne det, må man bruke knep og triks. Og hvis du er interessert, kan du se på erfaringene til våre kolleger fra Avito (lenken på lysbildet er ugyldig og oppdatert i teksten).
De skrev for , som tar hensyn til disse tingene. Det er et dokument på to sider. Men den beregner korrekt, og gjør det ganske effektivt mulig å vurdere hvor mye vakuum som trengs for tabellene, hvor lite.
Hva kan vi gjøre med dette? Hvis vi har en stor kø og autovakuumet ikke klarer jobben, kan vi heve antallet vakuumarbeidere, eller rett og slett gjøre vakuumet mer aggressivt, slik at det trigges tidligere og behandler tabellen i små biter. Og dermed vil køen bli redusert. — Det viktigste her er å overvåke belastningen på diskene, siden vakuum er ikke gratis, selv om med fremveksten av SSD/NVMe-enheter er problemet blitt mindre merkbart.
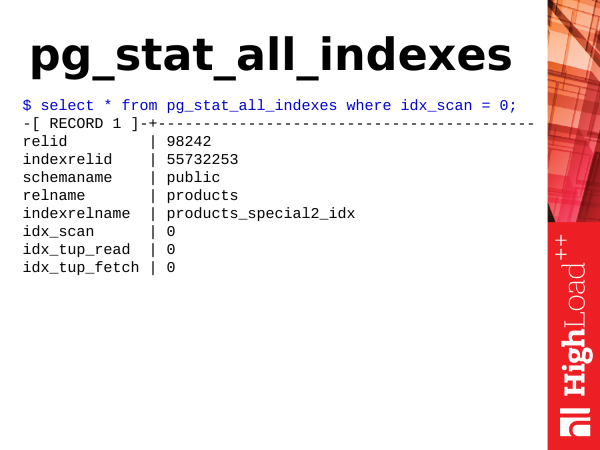
Pg_stat_all_indexes – dette er statistikk over indeksene. Den er liten. Og vi kan få informasjon om bruken av indeksene ved hjelp av den. Og for eksempel kan vi bestemme hvilke indekser som er overflødige.
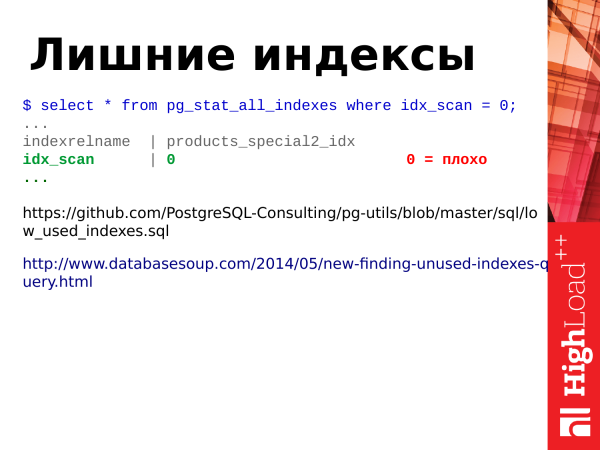
Som jeg allerede har sagt, oppdatering – det er ikke bare oppdatering av tabeller, men også oppdatering av indekser. Derfor, hvis vi har mange indekser på tabellen, må også indeksene av de indekserte feltene oppdateres ved oppdatering av rader i tabellen, og hvis vi har ubrukte indekser som det ikke er noen indeks-søk på, så er de en byrde for oss. Og vi må kvitte oss med dem. For dette trenger vi feltet idx_scan. Vi ser bare på antallet indeks-søk. Hvis indekser har null søk over en relativt lang periode med oppbevaring av statistikken (mindst 2–3 uker), er dette mest sannsynlig dårlige indekser, og vi må kvitte oss med dem.
Merk: Når vi leter etter ubrukt indekser i tilfelle av klyngereplika må vi sjekke alle noder i klyngen, siden statistikken ikke er global, og hvis indekset ikke brukes på masteren, kan det brukes på replikaene (hvis det er belastning der).
To lenker:
Dette er mer avanserte eksempler på forespørslene for hvordan man finner ubrukt indekser.
Den andre lenken er en ganske interessant forespørsel. Det ligger en ganske ukonvensjonell logikk bak. Jeg anbefaler å se nærmere på den.
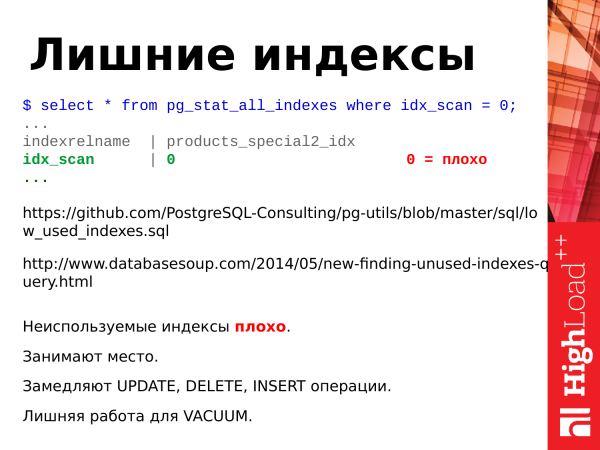
Hva mer bør oppsummeres om indeksene?
Ubrukte indekser er dårlige.
De tar opp plass.
De bremser oppdateringsoperasjoner.
Det er unødvendig arbeid for vakuumet.
Hvis vi fjerner de ubrukte indeksene, vil vi bare forbedre databasen.
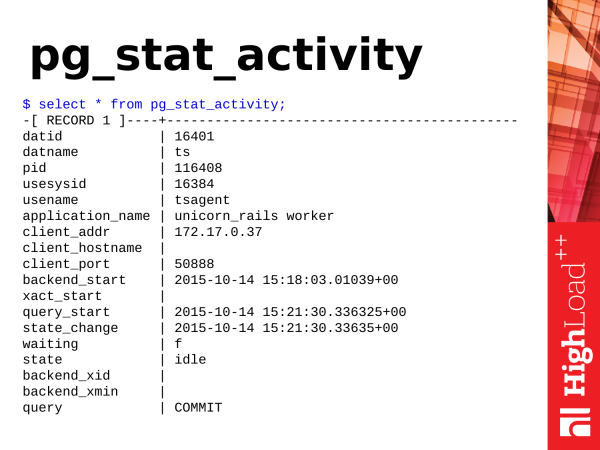
Den neste visningen er pg_stat_activity. Dette er et analogt verktøy til ps, bare i PostgreSQL. Hvis psdu ser prosessene i operativsystemet, vil pg_stat_activity det vise aktiviteten inne i PostgreSQL.
Hva kan vi dra nytte av der?
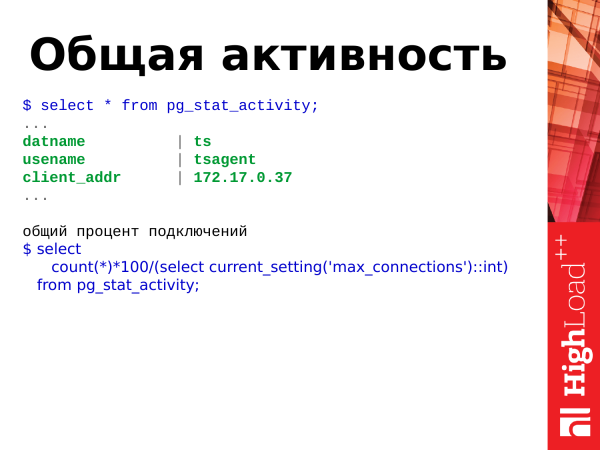
select
count(*)*100/(select current_setting('max_connections')::int)
from pg_stat_activity;
Vi kan se den totale aktiviteten, hva som skjer i databasen. Vi kan gjøre en ny distribusjon. Det har gått galt der, nye tilkoblinger blir ikke akseptert, feil regner ned i applikasjonen.
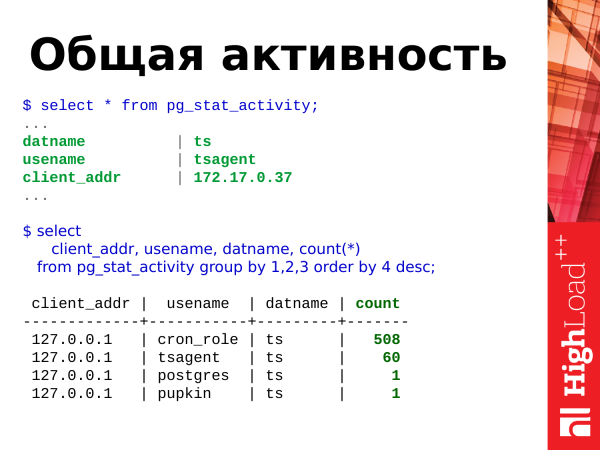
select
client_addr, usename, datname, count(*)
from pg_stat_activity group by 1,2,3 order by 4 desc;
Vi kan utføre en slik forespørsel og se på den totale prosentandelen av tilkoblinger i forhold til maksgrensen for tilkoblinger, og se hvem som har flest tilkoblinger. I det gitte tilfellet ser vi at brukeren cron_role har åpnet 508 tilkoblinger. Det er noe som har skjedd der. Vi må ta tak i det og se nærmere på det. Det kan helt klart være et unormalt antall tilkoblinger.
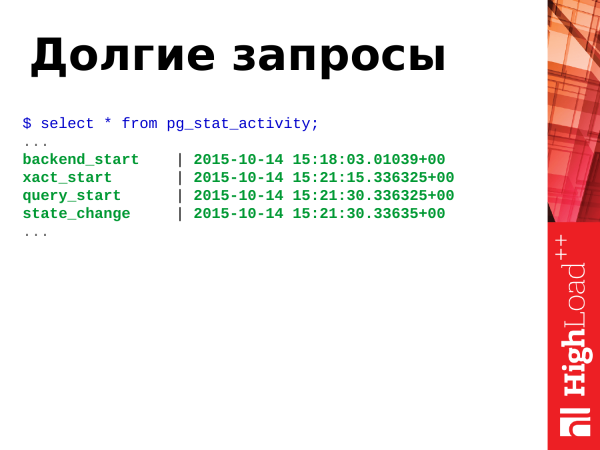
Hvis vi har OLTP-belastning, skal forespørslene utføres raskt, veldig raskt, og det skal ikke være lange forespørslene. Men hvis det oppstår lange forespørslene, er det på kort sikt ikke noe stort problem, men på lang sikt skader lange forespørslene databasen, de øker bloat-effekten i tabeller, når tabellene fragmenteres. Både bloat og lange forespørselene må vi bli kvitt.
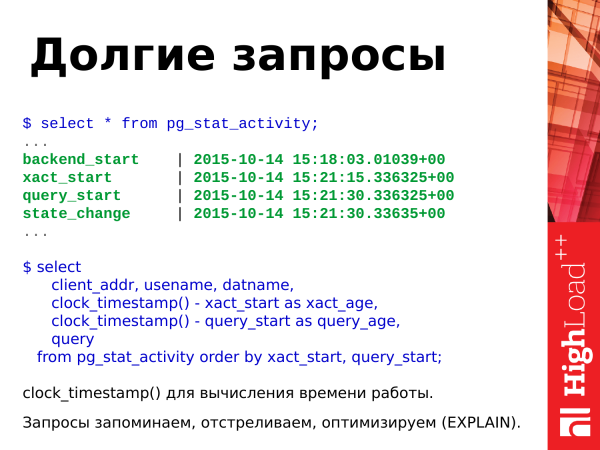
select
client_addr, usename, datname,
clock_timestamp() - xact_start as xact_age,
clock_timestamp() - query_start as query_age,
query
from pg_stat_activity order by xact_start, query_start;
Merk: med en slik forespørsel kan vi identifisere lange forespørselen og transaksjonene. Vi bruker funksjonen clock_timestamp() for å bestemme hvor lenge de har vært aktive. De lange forespørslene vi har funnet, kan vi huske, utføre explain, se planene og optimalisere dem på en eller annen måte. Vi avbryter de nåværende lange forespørslene og fortsetter deretter.
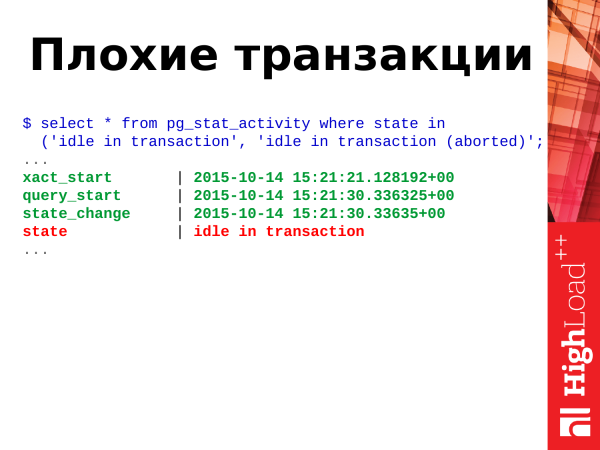
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
Dårlige transaksjoner er transaksjoner som er i tilstanden idle in transaction og idle in transaction (aborted).
Hva betyr dette? Transaksjoner har flere tilstander. Og en av disse tilstandene kan inntreffe når som helst. For å bestemme tilstandene finnes det et felt state i denne visningen. Og vi bruker det for å bestemme tilstanden.
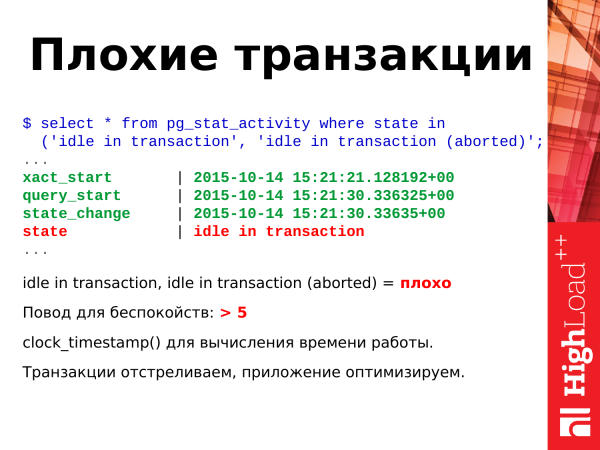
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
Og, som jeg nevnte tidligere, disse to tilstandene idle in transaction og idle in transaction (aborted) – dette er dårlig. Hva er dette? Det er når applikasjonen har åpnet en transaksjon, gjort noen handlinger og så dratt videre. Transaksjonen forblir åpen. Den henger, ingenting skjer, den tar opp en tilkobling, blokkerer endrede rader og kan potensielt øke bloat i andre tabeller, på grunn av arkitekturen til transaksjonsmotoren til PostgreSQL. Og slike transaksjoner bør også avbrytes, fordi de er skadelige, uansett omstendigheter.
Hvis du ser at de er mer enn 5-10-20 i databasen din, så bør du begynne å bekymre deg og gjøre noe med dem.
Her bruker vi også for beregning av tid clock_timestamp(). Vi avbryter transaksjoner, optimaliserer applikasjonen.
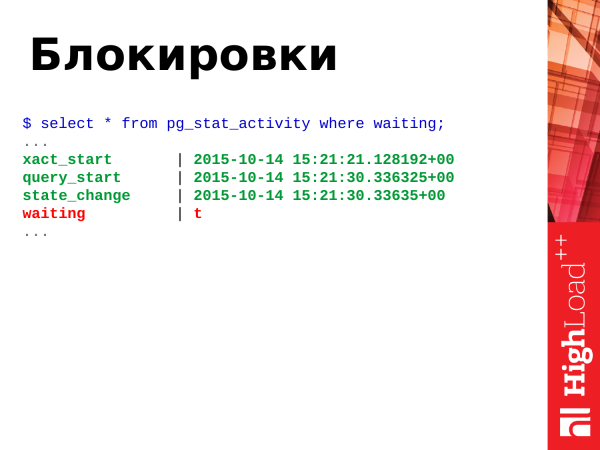
Som jeg nevnte tidligere, blokkeringer – det er når to eller flere transaksjoner kjemper om én eller flere ressurser. For dette har vi et felt waiting med en boolsk verdi true eller false.
True – det betyr at prosessen venter, noe må gjøres. Når prosessen venter, betyr det at klienten som initierte denne prosessen også venter. Klienten i nettleseren sitter og venter.
Vær oppmerksom: _Fra og med versjon Postgres 9.6 ble feltet waiting fjernet og i stedet lagt til to mer informative felt wait_event_type og wait_event._
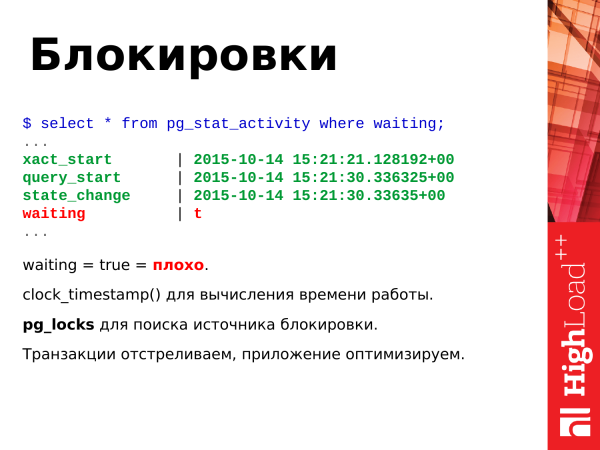
Hva skal man gjøre? Hvis du ser true over lengre tid, betyr det at man må kvitte seg med slike forespørsel. Vi avbryter bare slike transaksjoner. Vi skriver til utviklerne at de må optimalisere for å unngå ressurskonkurranse. Og deretter optimaliserer utviklerne applikasjonen, slik at dette ikke skjer.
Og det siste, men samtidig potensielt ikke fatale tilfellet – er oppståelse av deadlocks. To transaksjoner oppdaterte to ressurser, deretter prøver de å få tilgang til dem igjen, men til de motsatte ressursene. PostgreSQL avbryter automatisk transaksjonen, slik at den andre kan fortsette å arbeide. Det er en fastlåsning, og den løses ikke automatisk. Derfor må PostgreSQL ta drastiske tiltak.
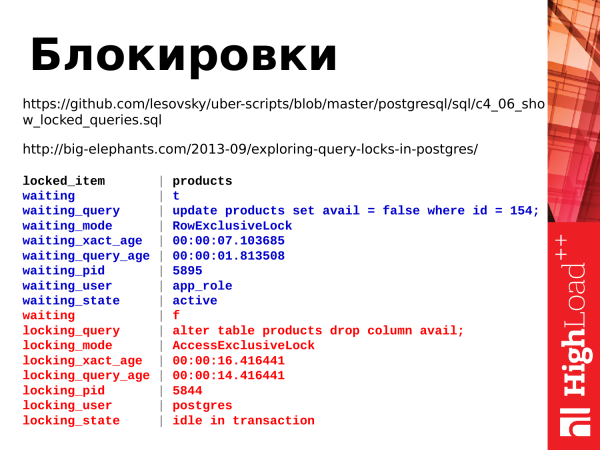
Og her er to forespørsel som lar oss overvåke blokkeringer. Vi bruker visningen pg_locks, som gjør det mulig å spore tunge låser.
Og den første lenken er selve forespørselsteksten. Den er ganske lang.
Og den andre lenken er en artikkel om låser. Den er nyttig å lese, den er veldig interessant.
Så, hva ser vi? Vi ser to forespørseler. Transaksjonen med ALTER TABLE – er en låsende transaksjon. Den har startet, men ikke fullført, og applikasjonen som initierte denne transaksjonen er et sted og gjør andre ting. Og den andre forespørselen – oppdatering. Den venter på at alter table skal fullføres, for å fortsette sitt arbeid.
Slik kan vi finne ut hvem som låste hvem, holde oversikt og vi kan jobbe videre med dette.
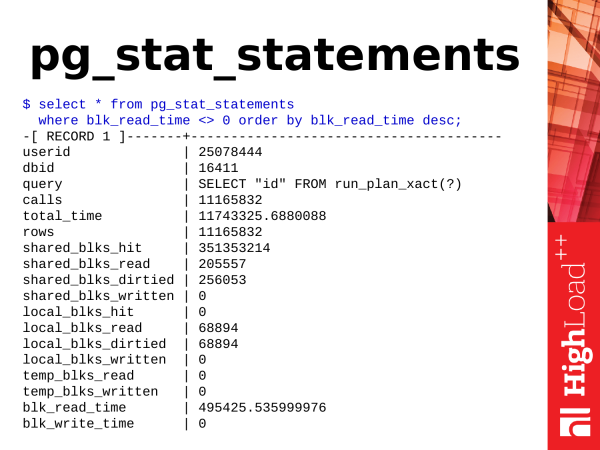
Neste modul – det er pg_stat_statements. Som jeg allerede har sagt, er dette en modul. For å bruke den må du laste inn biblioteket i konfigurasjonen, starte PostgreSQL på nytt, installere modulen (med én kommando), og deretter får vi en ny visning.
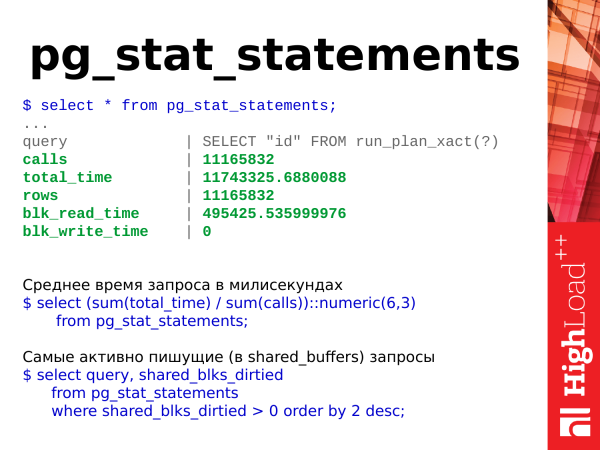
Gjennomsnittlig forespørselstid i millisekunder
$ select (sum(total_time) / sum(calls))::numeric(6,3)
from pg_stat_statements;

De mest aktive skriveforespørslene (i shared_buffers)
$ select query, shared_blks_dirtied
from pg_stat_statements
where shared_blks_dirtied > 0 order by 2 desc;
Hva kan vi hente derfra? Hvis vi snakker om enkle ting, kan vi ta gjennomsnittlig forespørselstid. Hvis tiden øker, betyr det at PostgreSQL svarer sakte og noe må gjøres.
Vi kan se på de mest aktive skrivetransaksjonene i databasen, som endrer data i shared buffers. Se hvem som oppdaterer eller sletter data.
Og vi kan bare se på forskjellige statistikker for disse forespørslene.
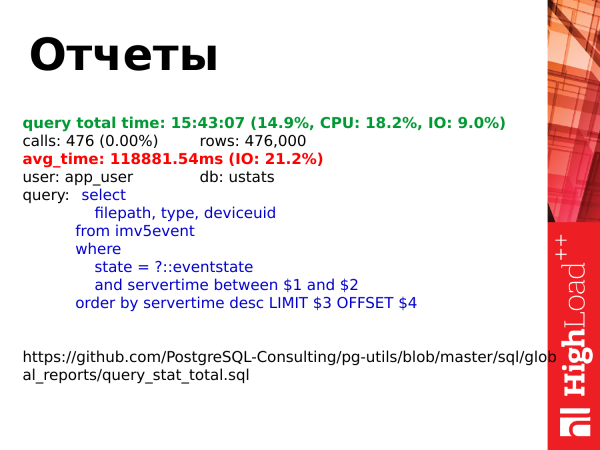
Vi pg_stat_statements bruker til å lage rapporter. Vi nullstiller statistikken hver dag. Vi samler den. Før vi nullstiller statistikken neste gang, lager vi rapporten. Her er lenken til rapporten. Du kan se den.
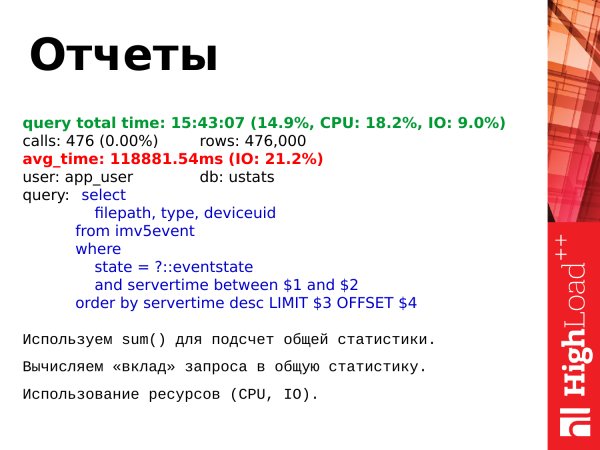
Hva gjør vi? Vi beregner den totale statistikken for alle forespørslene. Deretter for hver forespørsel beregner vi dens individuelle bidrag til denne totale statistikken.
Og hva kan vi se på? Vi kan se den totale tiden for utførelsen av alle forespørslene av en bestemt type i forhold til alle andre forespørseler. Vi kan se ressursbruken for CPU og I/O i forhold til det totale bildet. Og så kan vi optimalisere disse forespørslene. Vi lager toppforespørslene basert på denne rapporten, og vi får allerede tanker om hva som kan optimaliseres.
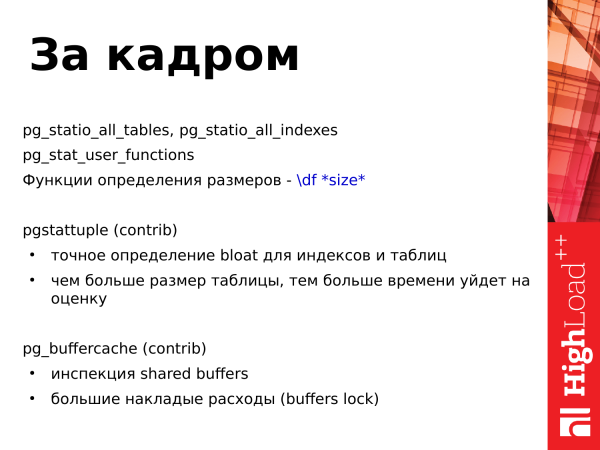
Hva har vi etterlatt oss utenfor? Det er flere presentasjoner som jeg ikke har vurdert fordi tiden er begrenset.
Ja pgstattuple – dette er også et ekstra modul fra standardpakken contribs. Det lar deg vurdere bloat i tabeller, såkalt tabellfragmentering. Og hvis fragmenteringen er høy, må den fjernes, ved bruk av forskjellige verktøy. Og funksjonen pgstattuple tar tid. Jo flere tabeller, jo lengre tid vil den ta.
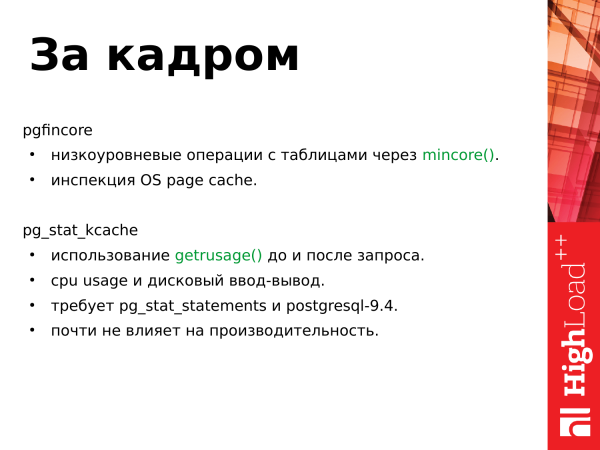
Den neste contrib-en er pg_buffercache. Den lar deg inspisere delte buffere: hvor intenst og til hvilke tabeller sidene av bufferen brukes. Og lar deg bare se inn i delte buffere og vurdere hva som skjer der.
Neste modul – det er pgfincore. Den lar deg utføre lavnivåoperasjoner med tabeller via systemkallet mincore(), det vil si den lar deg laste en tabell inn i delte buffere, eller tømme den. Og den lar deg i tillegg inspisere sideloggen til operativsystemet, det vil si hvor mye plass tabellen opptar i sidecachen, i delte buffere og vurderer bare belastningen på tabellen.
Den neste modulen er pg_stat_kcache. Den bruker også systemkallet getrusage(). Og utfører det før og etter at forespørselen kjører. Og i den fremskaffede statistikken lar den deg vurdere hvor mye tid forespørselen vår brukte på disk-I/O, det vil si operasjoner med filsystemet og ser på prosessbruk. Imidlertid er modulen ung (khem-khem) og for å fungere krever den PostgreSQL 9.4 og pg_stat_statements, som jeg nevnte tidligere.
Å vite hvordan man bruker statistikk er nyttig. Du trenger ikke tredjepartsprogrammer. Du kan selv se inn, sjekke, gjøre noe, utføre.
Det er ikke vanskelig å bruke statistikk, det er vanlig SQL. Du samlede forespørselen, lagde den, sendte den, så.
Statistikk hjelper deg med å svare på spørsmål. Hvis du har spørsmål, går du til statistikken – ser, trekker konklusjoner, analyserer resultatene.
Og eksperimenter. Det er mange forespørslene, mange data. Man kan alltid optimalisere en eksisterende forespørsel. Man kan lage sin egen versjon av forespørselen, som passer deg bedre enn originalen, og bruke den.
Lenker
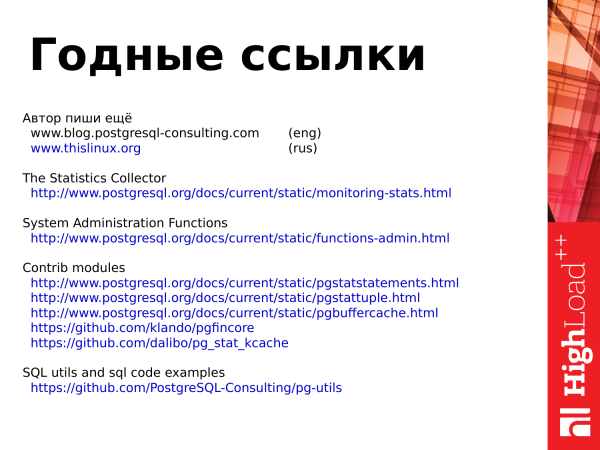
Nyttige lenker som ble nevnt i artikkelen som var i presentasjonen.
Forfatteren skriver igjen
(eng)
Statistikkinnsamleren
Systemadministrasjonsfunksjoner
Contrib-moduler
SQL-verktøy og SQL-kodeeksempler
Takk til alle for oppmerksomheten!
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish