

I 2018 oppstod begrepet MLOps i profesjonelle kretser og på temakonferanser relatert til AI, som raskt ble etablert i bransjen og nå utvikler seg som et selvstendig felt. På sikt kan MLOps bli et av de mest ettertraktede områdene innen IT. Hva er dette, og hvordan fungerer det, la oss se nærmere på.
Hva er MLOps
MLOps (en kombinasjon av teknologier og prosesser for maskinlæring og tilnærminger til implementering av utviklede modeller i forretningsprosesser) — er en ny samarbeidsmetode mellom representanter for virksomheter, forskere, matematikere, spesialister innen maskinlæring og IT-ingeniører ved opprettelse av kunstig intelligens-systemer.
Med andre ord, det er en måte å omdanne metoder og teknologier for maskinlæring til et nyttig verktøy for å løse forretningsutfordringer.
Det er viktig å forstå at produktiviseringens kjede begynner lenge før utviklingen av modellen. Det første trinnet er å definere forretningsoppgaven, hypotesene om verdien som kan utvinnes fra dataene, og forretningsideen for anvendelsen.
Selve begrepet MLOps oppstod som en analogi til begrepet DevOps anvendt på modeller og teknologier for maskinlæring. DevOps er en tilnærming til programvareutvikling som gjør det mulig å øke hastigheten på implementeringen av endringer, samtidig som man opprettholder fleksibilitet og pålitelighet gjennom ulike metoder, inkludert kontinuerlig utvikling, oppdeling av funksjoner i uavhengige mikrotjenester, automatisert testing og distribusjon av endringer, global overvåking av drift, en operativ respons på oppdagede feil, og mer.
DevOps definerte livssyklusen til programvare, og i spesialistfellesskapet oppstod ideen om å bruke samme metode for big data. DataOps forsøker å tilpasse og utvide metodikken med tanke på egenskapene ved lagring, overføring og behandling av store datamengder på varierte og gjensidig interagerende plattformer.
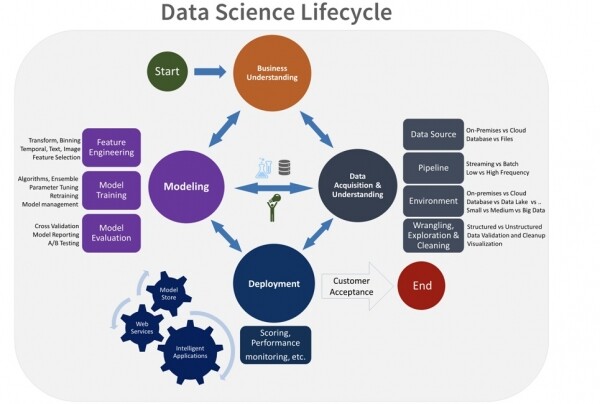
Med framveksten av en viss kritisk masse av maskinlæringsmodeller implementert i forretningsprosessene til selskaper, har man lagt merke til en sterk likhet mellom livssyklusen til matematiske modeller for maskinlæring og livssyklusen til programvare. Forskjellen er bare at algoritmene for modellene blir laget ved hjelp av verktøy og metoder for maskinlæring. Derfor oppsto det naturlig idéen om å bruke og tilpasse kjente tilnærminger innen programvareutvikling for maskinlæringsmodeller. Slik kan man skille ut følgende nøkkeltrinn i livssyklusen til maskinlæringsmodeller:
- definere forretningsidéen;
- trene modellen;
- teste og implementere modellen i forretningsprosessen;
- drifte modellen.
Når det under driftsprosessen oppstår behov for å endre eller videreutvikle modellen med nye data, starter syklusen på nytt - modellen forbedres, testes, og en ny versjon distribueres.
Avvik. Hvorfor videreutvikle, og ikke omtrene? Begrepet «omtrening av modellen» har en dobbel betydning: blant spesialister betyr det en feil i modellen, når modellen predikerer godt og faktisk gjentar den forutsagte parameteren i treningssettet, men fungerer mye dårligere på eksterne datakilder. Naturligvis er en slik modell defekt, ettersom denne feilen hindrer dens bruk.
I denne livssyklusen virker det logisk å bruke DevOps-verktøy: automatisert testing, distribusjon og overvåking, og å utforme beregningene av modellene som separate mikrotjenester. Men det finnes også flere særtrekk som hindrer direkte anvendelse av disse verktøyene uten ytterligere ML-tilknytning.
Hvordan få modellene til å fungere og generere profitt
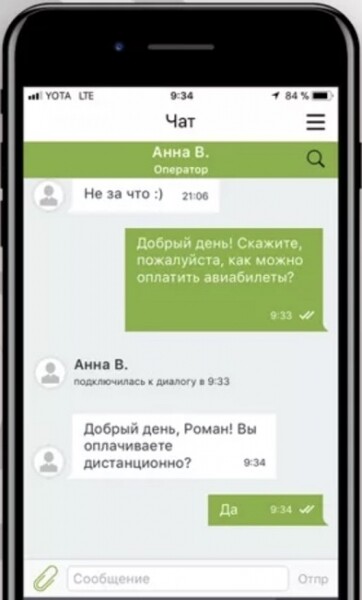
Som eksempel på, hvordan vi vil demonstrere anvendelsen af MLOps, tager vi den klassiske opgave med at automatisere chatsupporten for bankprodukter (eller andre produkter). Businessprocessen ved chatbaseret support ser typisk således ud: Kunden indtaster en besked med et spørgsmål i chatten og modtager et svar fra en specialist inden for et foruddefineret dialogtræ. Opgaven med at automatisere sådan en chat løses typisk ved hjælp af ekspertbestemte regelsæt, som er meget tidskrævende at udvikle og vedligeholde. Effektiviteten af denne automatisering kan, afhængigt af opgavens kompleksitet, udgøre 20–30%. Det er derfor nærliggende at overveje, at det ville være mere fordelagtigt at implementere en kunstig intelligens-modul — en model udviklet ved hjælp af maskinlæring, som:
- kan behandle et større antal forespørgsler uden operatørens deltagelse (afhængigt af emnet kan effektiviteten i nogle tilfælde nå 70–80%);
- bedre tilpasser sig usædvanlige formuleringer i dialogen — kan identificere intentioner og den reelle ønsked fra brugeren ud fra uklart formulerede forespørgsler;
- kan afgøre, hvornår modellens svar er passende, og hvornår der er tvivl om svarets 'bevidsthed', og der derfor skal stilles et ekstra præciserende spørgsmål eller skiftes til en operatør;
- kan blive automatisk videreuddannet (i stedet for en gruppe udviklere, der konstant tilpasser og justerer svarscenarierne, videreuddanner en Data Science-specialist modellen ved at anvende relevante maskinlæringsbiblioteker).
Hvordan får man en så avanceret model til at fungere?
Som med enhver anden opgave, før man udvikler et sådant modul, er det nødvendigt at definere businessprocessen og formelt beskrive den specifikke opgave, vi skal løse ved hjælp af maskinlæringsmetoden. Her begynder processen med operationalisering, som er angivet med forkortelsen Ops.
Neste steget samarbeider data science-spesialisten med datateknikeren for å vurdere tilgjengeligheten og tilstrekkeligheten av dataene, samt forretningshypotesen om levedyktigheten av forretningsideen, ved å utvikle en prototype av modellen og teste dens faktiske effektivitet. Først etter bekreftelse fra virksomheten, kan overgangen fra utvikling av modellen til integreringen av den i systemer som utfører spesifikke forretningsprosesser begynne. En helhetlig planlegging av implementeringen, en dyp forståelse av hvert trinn for hvordan modellen vil bli brukt og hvilken økonomisk effekt den vil ha, er en grunnleggende del av prosessene for implementering av MLOps i selskapets teknologiske landskap.
Med utviklingen av AI-teknologier øker antallet og mangfoldet av oppgaver som kan løses ved hjelp av maskinlæring eksplosivt. Hver slik forretningsprosess representerer en besparelse for selskapet gjennom automatisering av arbeidet til ansatte i masseposisjoner (call center, kontroll og sortering av dokumenter osv.), utvidelse av kundebasen ved å legge til nye attraktive og brukervennlige funksjoner, besparelser gjennom optimal bruk av ressurser og omfordeling av ressurser, og mye mer. I siste instans er enhver prosess rettet mot å skape verdi og, som en konsekvens, bør den gi en viss økonomisk effekt. Her er det svært viktig å formulere forretningsideen klart og beregne forventet gevinst fra implementeringen av modellen i den samlede verdiskapingsstrukturen i selskapet. Det skjer situasjoner der implementeringen av modellen ikke gir ønsket resultat, og tiden som er brukt av maskinlæringsspesialister, ender opp med å koste mye mer enn en operatørs arbeidsplass som utfører oppgaven. Derfor er det nødvendig å forsøke å avdekke slike tilfeller på et tidlig stadium av opprettelsen av AI-systemer.
Derfor begynner modellen å generere inntekter først når forretningsoppgaven er riktig formulert i MLOps-prosessen, prioriteringene er satt, og prosessen for implementering av modellen i systemet er formulert i de tidlige utviklingsfaser.
Ny prosess – nye utfordringer
Et omfattende svar på det grunnleggende spørsmålet for virksomheter om hvorvidt ML-modeller er anvendbare for å løse oppgaver, og det generelle spørsmålet om tillit til AI — dette er en av de viktigste utfordringene i utviklingen og implementeringen av MLOps-tilnærminger. I utgangspunktet er virksomheter skeptiske til å implementere maskinlæring i prosessene — det er vanskelig å stole på modeller der mennesker tidligere vanligvis har jobbet. For virksomheter fremstår programmene som en «sort boks», hvor relevansen av svarene må bevises. I tillegg er det strenge krav fra statlige reguleringsorganer innen bankvirksomhet, telekom og andre sektorer. Alle systemer og algoritmer som er implementert i bankprosesser, er gjenstand for revisjon. For å løse dette problemet, bevise for virksomheten og reguleringsmyndigheter berettigelsen og korrektheten av AI-svar, implementeres overvåkningsverktøy sammen med modellen. Videre finnes det en uavhengig valideringsprosess, obligatorisk for regulatoriske modeller, som oppfyller kravene fra sentralbanken. En uavhengig ekspertgruppe gjennomfører revisjoner av resultatene oppnådd av modellen basert på inndataene.
Den andre utfordringen er vurdering og håndtering av modellrisiko ved implementering av maskinlæringsmodeller. Selv om mennesker ikke kan svare med hundre prosent sikkerhet på spørsmålet om kjolen var hvit eller blå, har også kunstig intelligens rett til å gjøre feil. Det er også viktig å ta høyde for at data kan endre seg over tid, og modellene må oppdateres for å gi tilstrekkelig nøyaktige resultater. For å unngå at forretningsprosessen lider, er det nødvendig å håndtere modellrisiko og overvåke modellens ytelse, og jevnlig oppdatere den med nye data.
Men etter den første fasen av mistillit begynner en motsatt effekt å manifestere seg. Jo flere modeller som blir vellykket implementert i prosessene, desto større blir virksomhetens appetitt for å bruke kunstig intelligens — nye oppgaver oppdages stadig som kan løses med metoder for maskinlæring. Hver oppgave setter i gang en hel prosess som krever ulike ferdigheter:
- dataingeniører forbereder og behandler data;
- datascientister bruker maskinlæringsverktøy og utvikler modellen;
- IT implementerer modellen i systemet;
- ML-ingeniøren bestemmer hvordan denne modellen korrekt kan integreres i prosessen, hvilke IT-verktøy som skal brukes basert på kravene til bruken av modellen med hensyn til forespørselstrøm, responstid osv.
- ML-arkitekten designer hvordan programvaren fysisk kan implementeres i det industrielle systemet.
Hele syklusen krever et stort antall høyt kvalifiserte spesialister. På et bestemt punkt i utviklingen og graden av integrering av ML-modeller i forretningsprosessene, viser det seg at det blir kostbart og ineffektivt å lineært skalere antallet spesialister i takt med mengden oppgaver. Derfor oppstår spørsmålet om automatisering av MLOps-prosessen — å definere noen standard klasser av maskinlæringsoppgaver, utvikle standardiserte datapipelines for behandling og finjustering av modeller. I en ideell situasjon for å løse slike oppgaver kreves fagfolk som er like godt kjent i kompetanser på skjæringspunktet mellom BigData, Data Science, DevOps og IT. Derfor er det største problemet i Data Science-industrien og den største utfordringen i organiseringen av MLOps-prosesser — mangelen på slik kompetanse i det eksisterende utdanningsmarkedet. Spesialister som oppfyller slike krav er for øyeblikket en sjeldenhet på arbeidsmarkedet og er svært verdifulle.
Om kompetanser
I teorien kan alle MLOps-oppgaver løses med klassiske DevOps-verktøy uten å måtte ty til spesialiserte utvidelser av rollemodellen. Som vi har nevnt tidligere, må dataforsker være ikke bare matematiker og ekspert på dataanalyse, men en guru av hele pipeline — det er han eller hun som må utvikle arkitekturen, programmere modeller på flere språk avhengig av arkitekturen, forberede datadashboards og implementere selve applikasjonen. Imidlertid tar opprettelsen av den teknologiske infrastrukturen, som implementeres i den sammenhengende MLOps-prosessen, opptil 80% av arbeidsinnsatsen, noe som betyr at en kvalifisert matematiker, som er en god Data Scientist, kun vil bruke 20% av tiden sin på sitt fagfelt. Derfor blir det å skille mellom rollene til spesialister som utfører prosessen med å implementere maskinlæringsmodeller, livsviktig.
Hvor detaljert rollene skal defineres, avhenger av størrelsen på bedriften. Det er én ting når en spesialist i en oppstart er en altmuligmann som både er ingeniør, arkitekt og DevOps. Det er noe helt annet når alle utviklingsprosessene for modeller i en stor bedrift er konsentrert om et fåtall høyt kvalifiserte Data Science-spesialister, mens programmerere eller databasespesialister — som er mer vanlige og mindre kostbare kompetanser i arbeidsmarkedet — kan ta seg av store deler av de rutinemessige oppgavene.
Dermed er det direkte knyttet til hvor grensen går for valg av spesialister for å sikre MLOps-prosessen og hvordan prosessen med operasjonalisering av modeller er organisert, som avgjør hastigheten og kvaliteten på modellene som utvikles, teamets produktivitet og mikroklimaet i teamet.
Hva som allerede er gjort av teamet vårt
Vi har ikke så lenge siden begynt å bygge kompetansestrukturen og MLOps-prosessene. Men allerede nå er våre prosjekter for livssyklusstyring av modeller og for anvendelse av modeller som tjeneste i fase med testing av MVP.
Vi har også definert en optimal kompetansestruktur og organisatorisk struktur for samhandling mellom alle deltakere i prosessen for en stor bedrift. Agile-team har blitt organisert for å løse oppgaver for hele spekteret av forretningskunder, og prosessen for samarbeid med prosjektteam for oppretting av plattformer og infrastruktur, som danner grunnlaget for den byggende MLOps-strukturen, har blitt etablert.
Spørsmål for fremtiden
MLOps er et voksende felt som mangler kompetanse og vil ta fart i fremtiden. Mens vi bedre kan ta utgangspunkt i DevOps-praksiser og erfaringer. Hovedmålet med MLOps er en mer effektiv bruk av ML-modeller for å løse forretningsoppgaver. Men det oppstår mange spørsmål:
- Hvordan redusere tiden for å sette modeller i produksjon?
- Hvordan redusere byråkratiske hindringer mellom team med forskjellige kompetanser og øke fokus på samarbeid?
- Hvordan spore modeller, administrere versjoner og organisere effektiv overvåking?
- Hvordan lage en virkelig sirkulær livssyklus for moderne ML-modeller?
- Hvordan standardisere prosessen for maskinlæring?
Svarene på disse spørsmålene vil i stor grad avgjøre hvor raskt MLOps vil kunne realisere sitt fulle potensial.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish