

CAP-teoremet er hjørnesteinen i teorien om distribuerte systemer. Selvfølgelig gir debatten rundt den ingen tegn til å bli stille: definisjonene er ikke kanoniske, og det finnes ikke noe strengt bevis... Likevel, fast forankret i sunn fornuft™, forstår vi intuitivt at teoremet er korrekt.
Det eneste som ikke er åpenbart, er betydningen av bokstaven «P». Når en klynge splittes, bestemmer den – om den skal ikke svare før det er oppnådd kvorum, eller om den skal gi de dataene den har. Avhengig av resultatene av dette valget klassifiseres systemet enten som CP eller AP. Cassandra, for eksempel, kan oppføre seg både slik og slik, avhengig ikke engang av klyngeinnstillingene, men av spesifikasjonene til hver enkelt forespørsel. Men hvis systemet ikke er «P», og det har delt seg, hva skjer da?
Svaret på dette spørsmålet er noe uventet: en CA-klynge kan ikke splitte.
Hva slags klynge er dette som ikke kan splitte?
Et uunngåelig kjennetegn ved en slik klynge er et felles datalagringssystem. I det overveldende flertallet av tilfellene betyr dette tilkobling via SAN, noe som begrenser bruken av CA-løsninger til store selskaper som kan opprettholde SAN-infrastruktur. For at flere servere kan jobbe med de samme dataene, er en klyngefilessystem nødvendig. Slike filessystemer finnes i porteføljene til HPE (CFS), Veritas (VxCFS) og IBM (GPFS).
Oracle RAC
Alternativet Real Application Cluster dukket først opp i 2001 med utgivelsen av Oracle 9i. I en slik klynge jobber flere instanser serveren med samme database.
Oracle kan jobbe både med klyngefilessystem og med sin egen løsning – ASM, Automatic Storage Management.
Hver instans fører sin egen logg. En transaksjon blir utført og registrert av én instans. Ved feil på en instans leser en av de overlevende nodene i klyngen (instansene) loggen dens og gjenoppretter de tapte dataene – dette sikrer tilgjengelighet.
Alle instanser støtter sin egen cache, og de samme sidene (blokkene) kan befinne seg samtidig i cachen til flere instanser. Dessuten, hvis en instans trenger en side, og den finnes i cachen til en annen instans, kan den hente den fra «naboen» ved hjelp av mekanismen cache fusion, i stedet for å lese fra disken.
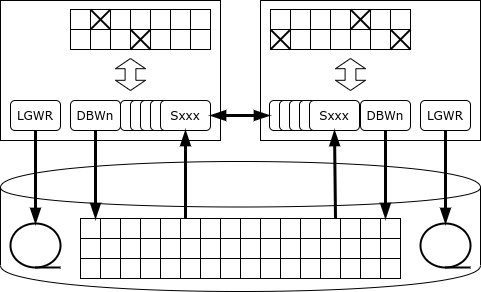
Men hva skjer hvis en av instansene trenger å endre dataene?
Særegenheten til Oracle er at det ikke finnes noen dedikert låsetjeneste: hvis serveren ønsker å låse en rad, blir informasjon om låsen plassert direkte på den siden av minnet hvor den låste raden ligger. Takket være denne tilnærmingen er Oracle en mester i ytelse blant monolittiske databaser: låsetjenesten blir aldri en flaskehals. Men i en klyngekonfigurasjon kan en slik arkitektur føre til intensiv nettverksutveksling og gjensidige låser.
Så snart en rad blir låst, varsler instansen alle de andre instansene om at siden som inneholder denne raden, er blitt tatt i monopolmodus. Hvis en annen instans trenger å endre raden på den samme siden, må den vente til endringene på siden er blitt bekreftet, det vil si at informasjonen om endringen ikke er blitt skrevet til loggen på disken (transaksjonen kan imidlertid fortsette). Det kan også skje at siden ble endret sekvensielt av flere instanser, og når siden skrives til disken, må man finne ut hvem som har den gjeldende versjonen av siden.
Uforutsigbare oppdateringer av de samme sidene gjennom forskjellige RAC-noder fører til en dramatisk reduksjon i databasens ytelse – til og med så mye at ytelsen til klyngen kan være lavere enn ytelsen til en enkelt instans.
Riktig bruk av Oracle RAC er fysisk deling av data (for eksempel ved hjelp av mekanismen for partisjonerte tabeller) og tilgang til hvert sett med partisjoner gjennom en dedikert node. Hovedformålet med RAC har blitt ikke horisontal skalerbarhet, men å sikre feilfri drift.
Hvis en node slutter å svare på heartbeat, starter den noden som oppdager dette først, en stemmeprosess på disken. Hvis den tapte noden heller ikke registrerer seg her, tar en av nodene over ansvaret for datagjenopprettelse:
- «fryser» alle sidene som var i hurtigbufferen til den tapte noden;
- leser loggene (redo) fra den tapte noden og anvender endringene som er registrert i disse loggene, samtidig som den sjekker om andre noder har nyere versjoner av de endrede sidene.
- ruller ufullførte transaksjoner.
For å forenkle overgangen mellom noder, har Oracle et konsept om tjeneste – en virtuell instans. En instans kan betjene flere tjenester, og en tjeneste kan flytte mellom noder. En applikasjonsinstans som betjener en bestemt del av databasen (for eksempel en gruppe kunder) arbeider med én tjeneste, og tjenesten som er ansvarlig for denne delen av databasen flytter til en annen node ved nodefeil.
IBM Pure Data Systems for Transactions
Klynge-løsningen for DBMS kom inn i porteføljen til Den blå kjempen i 2009. Ideologisk er den en arv etter klyngen Parallel Sysplex, bygget på 'vanlig' utstyr. I 2009 ble produktet DB2 pureScale lansert, som er en programvarepakke, og i 2012 tilbød IBM et programvare-hardware sett (appliance) kalt Pure Data Systems for Transactions. Det må ikke forveksles med Pure Data Systems for Analytics, som er intet annet enn det omdøpte Netezza.
Architekturen til pureScale ligner ved første blikk på Oracle RAC: på samme måte som flere noder er koblet til et felles datasystem, kjører hver node sin egen DBMS-instans med sine egne minneområder og transaksjonslogger. Men i motsetning til Oracle, har DB2 en dedikert lånetjeneste, representert av en samling prosesser db2LLM*. I klyngekongfigurasjonen er denne tjenesten plassert på en egen node, som i Parallel Sysplex kalles coupling facility (CF), og i Pure Data – PowerHA.
PowerHA tilbyr følgende tjenester:
- låneadministrator;
- global buffer-cache;
- område for mellomprosesskommunikasjon.
For å overføre data fra PowerHA til DB-noder og tilbake brukes fjernminnetilgang, så klyngeinterconnecten må støtte RDMA-protokollen. PureScale kan bruke både Infiniband og RDMA over Ethernet.
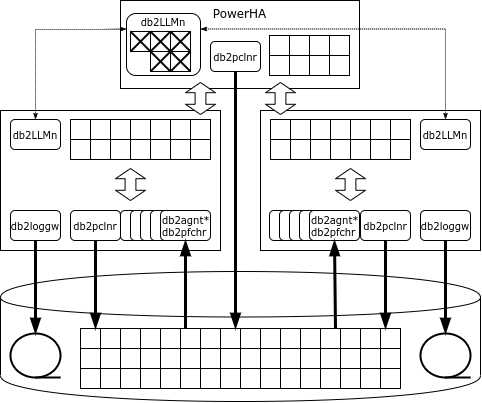
Hvis en node trenger en side, og denne siden ikke finnes i cachen, vil noden be om siden i den globale cachen, og bare hvis den heller ikke finnes der, leses den fra disken. I motsetning til Oracle, går forespørselen kun til PowerHA og ikke til nabonoder.
Når en instans skal endre en rad, blokkerer den den i eksklusiv modus, og siden der raden finnes, i delt modus. Alle låser registreres i den globale låsestyreren. Når transaksjonen er avsluttet, sender noden en melding til låsestyreren, som kopierer den endrede siden til den globale cachen, fjerner låsene og invalidere den endrede siden i cachene til de andre nodene.
Hvis siden som inneholder den endrede raden allerede er blokkert, vil låsestyreren lese den endrede siden fra minnet til noden som foretok endringene, fjerne låsen, invalidere den endrede siden i cachene til de andre nodene og gi låsen tilbake til noden som ba om den.
«Skitne», altså endrede, sider kan skrives til disk både fra en vanlig node og fra PowerHA (castout).
Ved svikt på en av nodene er gjenopprettingen begrenset til de transaksjonene som på tidspunktet for feilen ikke var avsluttet: sider endret av denne noden i avsluttede transaksjoner finnes i den globale cachen på PowerHA. Noden restartes i en redusert konfigurasjon på en av serverne i klyngen, ruller tilbake påbegynte transaksjoner og frigjør låser.
PowerHA opererer på to servere, og hovednoden synkroniserer tilstanden sin. Ved svikt på hovednoden fortsetter PowerHA-klyngen å fungere med reservnoden.
Selvfølgelig, hvis man får tilgang til datasettet gjennom én node, vil den totale ytelsen til klyngen være høyere. PureScale kan til og med merke at et bestemt datområde blir behandlet av én node, og da vil alle låsene knyttet til dette området bli håndtert lokalt av noden uten kommunikasjon med PowerHA. Men så snart applikasjonen prøver å få tilgang til disse dataene gjennom en annen node, vil den sentraliserte behandling av låser bli gjenopptatt.
IBM's interne belastningstester, som bestod av 90% lesing og 10% skriving, noe som ligner på reell industriell belastning, viser nesten lineær skalering opp til 128 noder. Testingens betingelser avsløres dessverre ikke.
HPE NonStop SQL
Den egenhøye tilgjengelighetsplattformen finnes også i Hewlett-Packard Enterprise sin portefølje. Dette er NonStop-plattformen, som ble lansert på markedet i 1976 av Tandem Computers. I 1997 ble selskapet oppkjøpt av Compaq, som igjen ble en del av Hewlett-Packard i 2002.
NonStop brukes til å bygge kritiske applikasjoner – for eksempel HLR eller behandling av bankkort. Plattformen leveres som en programvare-hardware-enhet (appliance), som inkluderer beregningsnoder, datalagringssystem og kommunikasjonsutstyr. ServerNet-nettverket (i moderne systemer – Infiniband) brukes både for kommunikasjon mellom noder og for tilgang til datalagringssystemet.
I de tidlige versjonene av systemet ble det brukt proprietære prosessorer som var synkronisert med hverandre: alle operasjoner ble utført synkront av flere prosessorer, og så snart en av prosessorene feilet, ble den deaktivert, mens den andre fortsatte arbeidet. Senere overgikk systemet til vanlige prosessorer (først MIPS, deretter Itanium og til slutt x86), og for synkronisering ble det brukt andre mekanismer:
- meldinger: hver systemprosess har en tvilling-"skygge" som den aktive prosessen periodisk sender meldinger om sin tilstand; ved svikt av hovedprosessen begynner skyggeprosessen arbeidet fra siste meldte punkt;
- stemmegivning: datalagringssystemet har en spesifikk maskinvarekomponent som tar imot flere identiske forespørselene og utfører dem kun dersom forespørslene samsvarer; i stedet for fysisk synkronisering arbeider prosessorene asynkront, og resultatene av arbeidet deres sammenlignes kun ved inndata/utdata.
Siden 1987 har den relasjonsbaserte databasen SQL-Databases (DBMS) fungert på NonStop-plattformen – først SQL/MP, og senere SQL/MX.
Heile databasen deles inn i deler, og hver del håndteres av sin egen Data Access Manager (DAM). Den sikrer dataskriving, caching og en låsemekanisme. Databehandling utføres av executor prosesser (Executor Server Process) som kjører på de samme nodene som de tilknyttede datamanagerne. SQL/MX-scheduler deler oppgaver mellom utførere og slår sammen resultater. For å gjøre koordinerte endringer benyttes en to-fase commitsprotokoll, tilveiebrakt av TMF-biblioteket (Transaction Management Facility).
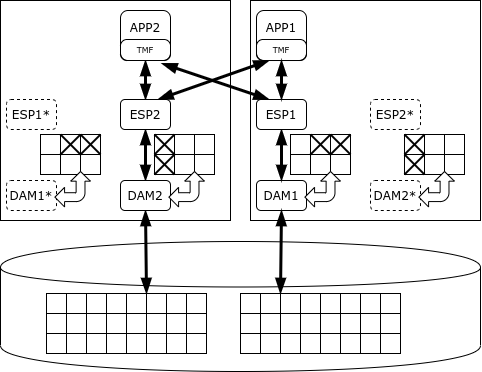
NonStop SQL kan prioritere prosesser slik at lange analytiske forespørselene ikke forstyrrer transaksjonsbehandling. Dens formål er imidlertid - nemlig behandling av korte transaksjoner, og ikke analyser. Utvikleren garanterer tilgjengeligheten til NonStop-klusteret på nivå fem «niner», noe som betyr at nedetiden er bare 5 minutter i året.
SAP HANA
Den første stabile utgaven av databasen HANA (1.0) ble lansert i november 2010, og SAP ERP-pakken ble overført til HANA fra mai 2013. Plattformen er basert på kjøpte teknologier: TREX søkemotor (for søk i kolonne-lagring), P*TIME database og MAX DB.
Selve ordet «HANA» er et akronym for High performance ANalytical Appliance. Denne databasen leveres i form av kode som kan kjøre på enhver x86-server, men industrielle installasjoner er kun tillatt på sertifisert utstyr. Det finnes løsninger fra HP, Lenovo, Cisco, Dell, Fujitsu, Hitachi, NEC. Noen konfigurasjoner fra Lenovo tillater til og med drift uten SAN - der GPFS-klusteret på lokale disker fungerer som delt lagringssystem.
I motsetning til de nevnte plattformene, er HANA en minne-database, det vil si at den primære datamodellen lagres i RAM, og bare logger og periodiske snapshots skrives til disk - for gjenoppretting i tilfelle krasj.
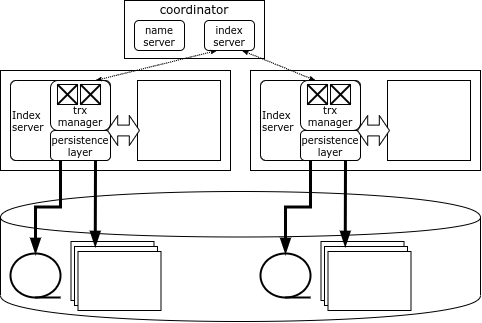
Hver node i HANA-klyngen er ansvarlig for sin del av dataene, og datakartet lagres i en spesialkomponent - Name Server, som ligger på koordinator-noden. Dataene mellom nodene dupliseres ikke. Informasjonen om låsene lagres også på hver node, men det finnes en global deadlock-detektor i systemet.
HANA-klienten laster opp topologien til klyngen ved tilkobling, og kan deretter henvende seg direkte til hvilken som helst node avhengig av hvilke data han trenger. Hvis transaksjonen berører data fra en enkelt node, kan den utføres lokalt av denne noden, men hvis data fra flere noder endres, kontakter initiator-noden koordinator-noden, som åpner og koordinerer den distribuerte transaksjonen, og forplikter den ved hjelp av en optimalisert to-fase forpliktelsesprotokoll.
Koordinator-noden er duplisert, så hvis koordinatoren svikter, trer en reserve-node umiddelbart inn. Men hvis en node med data svikter, er den eneste måten å få tilgang til dataene dens, å starte noden på nytt. Vanligvis holder HANA-klynger en reserve-server for raskt å kunne starte den tapte noden på nytt.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish