

Obs. overs.Forfatteren av denne artikkelen (Luc Perkins) er utviklingsadvokat i organisasjonen CNCF, som er hjemmet til åpne kildeprosjekter som Linkerd, SMI (Service Mesh Interface) og Kuma (for øvrig, har du også lurt på hvorfor Istio ikke er på denne listen ...?). Ved å prøve å bringe bedre forståelse av den motehype som kalles «service mesh» til DevOps-samfunnet, presenterer han 16 karakteristiske funksjoner som slike løsninger gir.
I dag Det er et av de varmeste emnene innen programvareutvikling (og med rette!). Jeg synes denne teknologien er utrolig lovende og drømmer om å bli vitne til dens utbredelse (selvfølgelig, når det gir mening). Likevel er det fortsatt omgitt av en aura av hemmelighet for de fleste. Selv de som er godt kjent med det, har ofte vanskeligheter med å formulere fordelene og hva det egentlig innebærer (inkludert meg selv). I denne artikkelen vil jeg prøve å gjøre situasjonen bedre ved å liste opp forskjellige bruksscenarier for «service mesh»*.
* Merk: i denne artikkelen vil termen «service mesh» bli oversatt som «tjenestenett».
Men først vil jeg gjerne gjøre noen bemerkninger:
- Jeg har aldri jobbet med tjenestenett og har ikke brukt dem utenfor prosjekter jeg har satset på for egen læring. På den annen side, det var jeg som skrev en masse dokumentasjon for det interne tjenestenettet i selskapet Twitter i 2015 (da ble det fortsatt ikke kalt «tjenestenett») og deltok i utviklingen av nettstedet og dokumentasjonen for , så det betyr noe.
- Listen min er eksemplarisk og ikke uttømmende. Det kan finnes bruksscenarier jeg ikke kjenner til, og det vil utvilsomt fremstå nye alternativer etter hvert som teknologien utvikler seg og blir mer populær.
- Samtidig støtter ikke alle eksisterende implementeringer av tjenestenett alle de oppførte bruksområdene. Derfor bør uttrykk som «tjenestenett kan ...» leses som «individuelle, og kanskje alle populære implementeringer av tjenestenett kan ...».
- Rekkefølgen på eksemplene har ingen betydning.
Kort liste:
- tjenesteoppdagelse;
- encryption;
- autentisering og autorisering;
- lastbalansering;
- circuit breaking;
- autoskalering;
- canary-deployeringer;
- blå-grønne deployeringer;
- helsekontroll;
- lastreduksjon;
- trafikkspeiling;
- isolering;
- begrensning av forespørselshyppighet, gjentatte forsøk og tidsavbrudd;
- telemetri;
- revisjon;
- visualisering.
1. Oppdagelse av tjenester
TL;DR: Koble til andre tjenester i nettverket med enkle navn.
Tjenester må kunne «finne» hverandre automatisk med passende navn — for eksempel, service.api.production, pets/staging eller cassandra. Skytjenester kjennetegnes av sin elastisitet, og bak ett navn kan det skjule seg mange instanser av tjenesten. Det er åpenbart at det i en slik situasjon er fysisk umulig å hardkode alle IP-adresser.
I tillegg, når én tjeneste finner en annen, må den kunne sende forespørsel til denne tjenesten uten å frykte at de havner hos en ikke-fungerende instans. Med andre ord, service mesh må overvåke tilgjengeligheten av alle instanser av tjenestene og holde listen over verter så oppdatert som mulig.
Hver service mesh implementerer en mekanisme for tjenesteoppdagelse på sin egen måte. Per nå er den mest utbredte metoden å delegere til eksterne prosesser som DNS Kubernetes. Tidligere brukte vi i Twitter et navnesystem . I tillegg gjør teknologien bak service mesh det mulig å få tilpassede navngivningsmekanismer (selv om jeg ennå ikke har sett noe implementering av SM med denne funksjonaliteten).
2. Kryptering
TL;DR: Bli kvitt ukryptert trafikk mellom tjenester, og sørg for at denne prosessen er automatisert og skalerbar.
Det er betryggende å vite at ondsinnede aktører ikke kan trenge inn i nettverket ditt. Brannmurer håndterer dette veldig bra. Men hva skjer hvis en hacker likevel kommer inn? Vil han kunne gjøre akkurat hva han vil med intern tjenestetrafikk? La oss håpe det ikke skjer. For å forhindre et slikt scenario, bør man implementere et null tillit-nettverk (zero-trust), der all trafikk mellom tjenester er kryptert. De fleste moderne tjenestenettverk oppnår dette med gjensidig (mutual TLS, mTLS). I noen tilfeller fungerer mTLS i hele skyer og klynger (jeg tror til og med interplanetarisk kommunikasjon en gang vil være organisert på lignende måte).
Selvfølgelig er ikke mTLS for service mesh valgfritt. Hver teneste kan ta vare på sin egen TLS, men det betyr at man må finne en måte å generere sertifikater, distribuere dem til tjenestene, og inkludere kode i applikasjonen som laster opp disse sertifikatene fra filer. Ja, husk også å oppdatere disse sertifikatene med jevne mellomrom. Tjenestenettverk automatiserer mTLS ved hjelp av systemer som , som igjen automatiserer prosessen med utstedelse og rotasjon av sertifikater.
3. Autentisering og autorisering
TL;DR: Sett hvem som er initiativtaker for forespørselen, og definer hva de har lov til å gjøre før forespørselen når tjenesten.
Tjenester ønsker ofte å vite hvem hvordan forespørselen gjennomføres (autentisering), og ved å bruke denne informasjonen bestemmer de vil om vedkommende har tillatelse til å gjøre (autorization). I dette tilfellet kan pronomenet «hvem» referere til:
- Andre tjenester. Dette kalles «autentisering av peeren». For eksempel vil en tjeneste
webha tilgang til en tjenestedb. Tjenestenettverk løser ofte slike problemer med mTLS: sertifikater fungerer som nødvendig identifikasjon. - Visse brukere. Dette kalles «autentisering av forespørselen». For eksempel vil brukeren
haxor69ønske å kjøpe en ny lampe. Tjenestenettverk gir forskjellige mekanismer, som .Mange av oss har gjort dette i applikasjonskoden. En forespørsel kommer inn, vi sjekker tabellen
users, finner brukeren og sammenligner passordet, så sjekker vi kolonnenpermissionsosv. I tilfelle av service mesh skjer dette før forespørselen når tjenesten.
Etter at vi har fastslått hvem forespørselen kom fra, må vi bestemme hva vedkommende har lov til å gjøre. Noen service mesh-er lar deg definere grunnleggende retningslinjer (for hvem og hva som kan gjøres) i YAML-filer eller fra kommandolinjen, mens andre tilbyr integrasjon med rammeverk som . Den endelige målet er å sikre at tjenestene dine tar imot forespørslene, og med trygghet antar at de stammer fra en pålitelig kilde og og at dette er tillatt.
4. Lastbalansering
TL;DR: Fordel lasten over tjenestekopier etter et bestemt mønster.
«Tjenesten» i en tjenestesektor består ofte av mange identiske instanser. For eksempel, i dag består tjenesten cache av 5 kopier, men i morgen kan antallet stige til 11. Forespørslene som sendes til cache, må fordeles i henhold til et bestemt mål. For eksempel, minimere ventetiden eller maksimere sannsynligheten for å treffe en fungerende instans. Vanligvis brukes rundrobin-algoritmen, men det finnes også mange andre — for eksempel, metoden med veide (weighted) forespørselen (kan velge foretrukne mål), ring (ring) hashing (bruk av konsistent hashing for upstream-verter) eller metoden med færrest antall forespørsel (prioritering av instansen med færrest forespørsel).
Klassiske lastbalanserere har også andre funksjoner, som HTTP-cache og DDoS-beskyttelse, men de er ikke så relevante for east-west trafikk (dvs. trafikk som går innen datasenteret — merkn. oversetter) (typisk bruksområde for service mesh). Selvfølgelig er det ikke nødvendig å bruke service mesh for lastbalansering, men det lar deg definere og kontrollere balansepolitikk for hver tjeneste fra et sentralisert kontrollplan, noe som eliminerer behovet for å kjøre og konfigurere separate balanseverktøy i nettverksstakken.
5. Kretsbryting (circuit breaking)
TL;DR: Stopp trafikken til den problematiske tjenesten og kontroller skaden ved worst-case scenarier.
Hvis tjenesten av en eller annen grunn ikke klarer å håndtere trafikken, gir service mesh flere løsninger på dette problemet (andre vil bli diskutert i de relevante seksjonene). Kretsbryting er den strengeste måten å frakoble tjenesten fra trafikken. Men i seg selv gir det ikke mening — en backup-plan er nødvendig. Det kan være nødvendig med mottrykk () til tjenestene som utfører forespørslene (bare husk å konfigurere din service mesh for dette!), eller for eksempel, å farge status-siden rød og omdirigere brukerne til en alternativ side med en «fallende hval» («Twitter er nede»).
Service mesh lar deg ikke bare definere når frakoblingen skal skje og vil Dette etterfølges. I dette tilfellet kan «når» inkludere enhver kombinasjon av de angitte parameterne: totalt antall forespørseler over en viss periode, antall parallelle tilkoblinger, ventende forespørseler, aktive gjentakelser, osv.
Du vil sannsynligvis ikke misbruke circuit breaking, men det er betryggende å vite at det finnes en reserveplan som en siste utvei.
6. Automatisk skalering
TL;DR: Øk eller reduser antallet instanser av tjenesten avhengig av de angitte kriteriene.
Service mesh-er er ikke planleggere, så de utfører ikke skalering på egen hånd. De kan imidlertid levere informasjon som planleggere kan bruke til å ta beslutninger. Siden service mesh-er har tilgang til all trafikk mellom tjenester, har de omfattende informasjon om hva som skjer: hvilke tjenester som har problemer, hvilke som er lite belastet (ressursene deres brukes unødvendig) osv.
For eksempel skalerer Kubernetes tjenester basert på CPU- og minneforbruk av pod-er. (se vår rapport «» – merkn. omsettar.), men hvis du bestemmer deg for å skalere basert på andre metrikker (i vårt tilfelle - relatert til trafikk), vil det være behov for spesielle målinger. Veiledningen viser hvordan du kan gjøre det ved hjelp av , og , men prosessen er ganske komplisert. Vi skulle ønske at service mesh kunne forenkle det, slik at man bare kan sette betingelser som «øke antallet instanser av tjenesten auth, hvis antallet ventende forespørseler overstiger terskelen i løpet av et minutt».
7. Kanarifugl utrullinger
TL;DR: Test nye funksjoner eller versjoner av tjenesten på en delmengde av brukerne.
La oss si at du utvikler et SaaS-produkt og planlegger å lansere en ny, flott versjon. Du har testet det i staging, og det fungerte glimrende. Men likevel gnager noen bekymringer om hvordan den vil oppføre seg under virkelige forhold. Med andre ord, du må teste den nye versjonen med reelle oppgaver, uten å riskere tilliten til brukerne. Kanarifugleutrullinger er utmerket for dette. De lar deg vise den nye funksjonen til et utvalgt antall brukere. Dette utvalget kan bestå av de mest lojale brukerne, de som bruker gratisversjonen av produktet, eller brukere som har uttrykt ønsket om å være «testkaniner».
Service mesh-er implementerer dette, ved å angi kriterier som definerer hvem og hvilken versjon av applikasjonen som blir sett, og rute trafikken deretter. For tjenestene som sådan endres ingenting. Versjon 1.0 av tjenesten antar at alle forespørslene kommer fra brukere som faktisk skal se nettopp den, mens versjon 1.1 antar det samme om sine brukere. Samtidig kan du justere prosentandelen av trafikken mellom den gamle og den nye versjonen, og omdirigere et voksende antall brukere til den nye hvis den fungerer stabilt og «testkaninene» dine gir tommel opp.
8. Blå-grønne utrullinger
TL;DR: Rull ut en ny, flott funksjon, men vær klar til å rulle alt tilbake umiddelbart.
Betydningen er å lansere den nye «blå» tjenesten parallelt med den gamle, «grønne». Hvis alt går bra og den nye tjenesten gjør det godt, kan den gamle gradvis stenges ned. (Dessverre, en dag vil også den nye «blå» tjenesten oppleve skjebnen til den «grønne» og forsvinne…) Blå-grønne utrullinger skiller seg fra kanarifugleutrullinger ved at den nye funksjonen dekker alle brukere (ikke bare en del); poenget er å ha en «reservet havn» klar, hvis noe skulle gå galt.
Service mesh gir ein svært brukervennlig måte å teste den "blå" tjenesten og umiddelbart bytte til den operasjonelle "grønne" tjenesten i tilfelle feil. For ikke å nevne at de samtidig gir masse informasjon (se punktet «Telemetri» nedenfor) om hvordan den «blå» tjenesten fungerer, noe som hjelper deg å forstå om den er klar for fullt drift.
Obs. overs.: Mer om ulike distribusjonsstrategier i Kubernetes (inkludert de nevnte kanarifugler, blå/grønn og andre) kan leses i .
9. Helsekontroll
TL;DR: Hold øye med hvilke tjenesteinstanser som er operative, og reager på dem som ikke lenger er det.
Helsekontroll (health check) hjelper deg med å avgjøre om tjenesteinstansene er klare til å motta og behandle trafikk. For eksempel, i tilfelle av HTTP-tjenester, kan helseklienten se ut som en GET-forespørsel til en endpoint /health. Svaret 200 OK vil bety at instansen er sunn, mens noe annet betyr at den ikke er klar til å ta imot trafikk. Service mesh gir deg muligheten til å spesifisere både måten helsekontrollen vil bli utført på, samt frekvensen av disse testene. Denne informasjonen kan deretter brukes til andre formål — for eksempel for belastningsbalansering og circuit breaking.
Dermed er helsekontrollen ikke et selvstendig bruksområde, men brukes vanligvis for å oppnå andre mål. Avhengig av resultatene fra helsecheckene, kan det være nødvendig med eksterne handlinger (i forhold til andre mål for tjenestenettverkene): for eksempel oppdatere status-siden, opprette et issue på GitHub eller fylle ut en JIRA-billett. Og service mesh tilbyr en praktisk mekanisme for å automatisere alt dette.
10. Belastningsreduksjon (load shedding)
TL;DR: Omfordel trafikk som svar på kortvarige bølger av bruk.
Hvis en tjeneste blir overbelastet med trafikk, kan du midlertidig omdirigere en del av denne trafikken til et annet sted (det vil si "slippe", "helle" (shed) den dit). For eksempel, til en sekundær tjeneste eller datasenter, eller til den permanente Tema. Som følge av dette vil tjenesten fortsette å behandle en del forespørseler i stedet for å krasje og slutte å håndtere alle. Å tilbakestille belastningen er å foretrekke fremfor å bryte kjeden, men det er fortsatt uønsket å misbruke det. Det bidrar til å forhindre kaskadekrasj som fører til at downstream-tjenester går ned.
11. Parallellisering/speiling av trafikk
TL;DR: Send én forespørsel til flere steder samtidig.
Noen ganger er det nødvendig å sende en forespørsel (eller et utvalg av forespørselene) til flere tjenester samtidig. Et typisk eksempel er å sende en del av produksjonstrafikken til staging-tjenesten. Hovednettserveren i produksjonen sender forespørselen til den underliggende tjenesten products.production , og bare til den. Og service mesh kopierer intelligent denne forespørselen og sender den til products.staging, noe som nettserveren ikke engang er klar over.
En annen relatert bruksscenario for service mesh som kan realiseres over parallellisering av trafikk, er . Det innebærer å sende de samme forespørslene til forskjellige versjoner av tjenesten og sjekke om alle versjoner oppfører seg likt. Jeg har ikke kommet over noen implementering av service mesh med et integrert regresjonstestingssystem som , men selve ideen virker lovende.
12. Isolasjon
TL;DR: Del service mesh-en din opp i mini-nettverk.
Også kjent som segmentering, isolasjon er kunsten å dele service mesh-en opp i logisk adskilte segmenter som ikke kjenner til hverandre. Isolasjon ligner litt på å opprette virtuelle private nettverk. Den prinsipielle forskjellen er at du fortsatt kan dra nytte av alle fordelene med service mesh (som tjenesteoppdagelse), men med ekstra sikkerhet. For eksempel, hvis en angriper klarer å trenge inn i en tjeneste i ett av delnettene, vil de ikke kunne se hvilke tjenester som kjører i andre delnett, eller avlytte trafikken deres.
I tillegg kan fordelene være organisatoriske. Du ønsker kanskje å dele opp tjenester i delnett avhengig av selskapets struktur og frigjøre utviklerne fra den kognitive belastningen av å måtte holde hele service mesh i tankene.
13. Begrensning av forespørseler, gjenopptakelser og tidsavbrudd
TL;DR: Du trenger ikke lenger å inkludere presserende forespørselshåndteringsoppgaver i kodebasen.
Alle disse tingene kunne vært vurdert som separate bruksområder, men jeg valgte å kombinere dem på grunn av en felles egenskap: de påtar seg oppgaver relatert til livssyklushåndtering av forespørselene, som vanligvis håndteres av applikasjonsbiblioteker. Hvis du utvikler en webserver på Ruby on Rails (ikke integrert med service mesh), som gjør forespørsel til backend-tjenester gjennom , applikasjonen må selv avgjøre hva den skal gjøre hvis N forespørsel ender med feil. Du må også finne ut hvor mye trafikk disse tjenestene kan håndtere og 'hardcode' disse parametrene med et spesialbibliotek. I tillegg må applikasjonen avgjøre når det er på tide å gi opp og la forespørselen gå ut av tiden (timeout). Og for å endre noen av de ovennevnte parametrene, må webserveren stanses, omkonfigureres og startes på nytt.
Å overføre disse oppgavene til service-mesh betyr ikke bare at utviklerne av tjenestene ikke lenger trenger å tenke på dem, men også at de kan vurderes på en mer global måte. Hvis det brukes en kompleks kjede av tjenester, si A –> B –> C –> D –> E, må man ta hensyn til hele livssyklusen av forespørselen. Hvis oppgaven er å forlenge timeoutene i tjeneste C, er det logisk å gjøre dette alt på en gang, ikke del for del: ved å oppdatere koden i tjenesten og vente på at pull-forespørselen blir akseptert og CI-systemet deployer det oppdaterte tjenestene.
14. Telemetri
TL;DR: Samle all nødvendig (og ikke nødvendigvis) informasjon fra tjenestene.
Telemetri er et generelt begrep som inkluderer målinger, distribuert sporing og logger. Service-mesh tilbyr mekanismer for å samle og behandle alle tre typer data. Her blir ting litt uklare, da antall mulige varianter er for stort. For innsamling av målinger finnes det og andre verktøy, for innsamling av logger kan man bruke , , og andre. (for eksempel ClickHouse med vår for K8s – anm. oversetter.), for distribuert sporing finnes det og så videre. Hver service-mesh kan støtte visse verktøy og ikke støtte andre. Det vil være interessant å se om prosjektet kan sikre en viss konvergens.
I dette tilfellet er fordelen med service mesh-teknologi at sidecar-containerne i prinsippet kan samle all den ovennevnte informasjonen fra tjenestene sine. Med andre ord, får du et samlet system for innsamling av telemetri, og service mesh kan håndtere all denne informasjonen på forskjellige måter. For eksempel:
- føre logger fra en bestemt tjeneste i CLI;
- overvåke forespørselvolumet fra overvåkingspanelet for service mesh;
- samle distribuerte sporinger og videresende dem til et system som Jaeger.
Merk: subjektiv vurdering: Generelt sett er telemetri det området hvor en sterk innblanding fra service mesh er uønsket. Å samle grunnleggende informasjon og overvåke noen 'gullmetrikker' på farten, som prosentandel av vellykkede forespørsel og forsinkelser, er greit, men la oss håpe at vi ikke kommer til å være vitne til opprettelsen av slike Frankenstein-stabler som forsøker å erstatte spesialiserte systemer, hvorav noen allerede har vist seg å være utmerkede og godt studert.
15. Revisjon
TL;DR: Den som glemmer historielæren, er dømt til å gjenta den.
Revisjon er kunsten å observere viktige hendelser i systemet. Når det gjelder service mesh, kan dette bety å spore hvem som har gjort forespørsel til bestemte endepunkter av spesifikke tjenester eller hvor mange ganger i løpet av den siste måneden en bestemt hendelse med sikkerhetsmessig relevans har skjedd.
Det er klart at revisjon er veldig nært knyttet til telemetri. Forskjellen er at telemetri vanligvis er assosiert med ting som ytelse og teknisk motstandskraft, mens revisjon kan ha forhold til juridiske og andre spørsmål som går utover det strengt tekniske området (for eksempel overholdelse av GDPR - EUs generelle personvernforordning).
16. Visualisering
TL;DR: Leve React.js - en uendelig kilde til bisarre grensesnitt.
Det kan være en mer passende betegnelse, men jeg kjenner den ikke. Jeg mener bare grafisk representasjon av service mesh eller noen av dens komponenter. Disse visualiseringene kan inkludere indikatorer som gjennomsnittlige forsinkelser, informasjon om konfigurasjonen av sidecar-containerne, helse-sjekkresultater og varsler.
Å jobbe i en tjenesteorientert miljø innebærer en langt større kognitiv belastning sammenlignet med Hennes Majestet Monolitten. Derfor bør kognitivt press reduseres for enhver pris. Et banalt grafisk grensesnitt for service mesh, med muligheten til å klikke på en knapp og få ønsket resultat, kan være avgjørende for veksten av denne teknologien.
Ikke inkludert i listen
Opprinnelig hadde jeg til hensikt å inkludere flere bruksområder i listen, men bestemte meg senere for å ikke gjøre det. Her er de, sammen med årsakene til avgjørelsen min:
- Multi-datacenter. Etter min oppfatning er dette ikke så mye et bruksområde, men en smal og spesifikk anvendelse av tjenestenett eller et sett med funksjoner som serviceoppdagelse.
- Ingress og egress. Dette er et relatert område, men jeg begrenset meg (kanskje kunstig) til bruksområdet «trafikk øst-vest». Ingress og egress fortjener en egen artikkel.
Konklusjon
Det var alt for nå! Igjen, denne listen er ganske betinget og sannsynligvis ufullstendig. Hvis du føler at jeg har utelatt noe, eller at jeg har gjort en feil, kontakt meg på Twitter (). Vennligst respekter regler for anstendighet.
P.S. from the translator
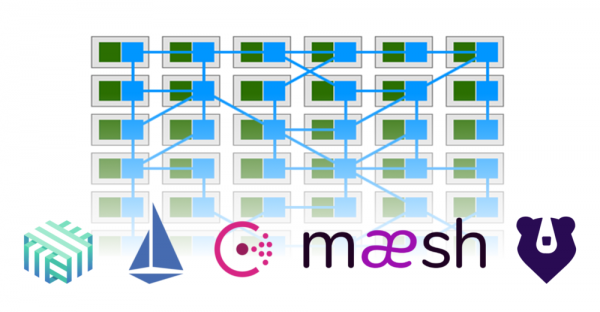
Som grunnlag for hovedillustrasjonen til artikkelen er det brukt et bilde fra artikkelen «» (forfatter — Gregory MacKinnon). Det viser hvordan en del av funksjonaliteten fra applikasjonene (grønn farge) har gått til service mesh, som sørger for forbindelsene mellom dem (blått).
Also read in our blog:
- «»;
- «»;
- «».
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish