

I det siste har kollegaer i "bransjen" uavhengig av hverandre begynt å spørre meg: hvordan får man fra én SDR-mottaker alle Bluetooth-kanaler samtidig? Båndbredden tillater det, det finnes SDR-er med utgangsbånd på 80 MHz eller mer. Man kan selvfølgelig gjøre dette med FPGA, men tiden det tar å utvikle dette vil være ganske lang. Jeg har lenge visst at det er ganske enkelt å gjøre dette på GPU, men sånn!
Bluetooth-standarden definerer det fysiske laget i to versjoner: Classic og Low Energy. Spesifikasjonen finnes . Dokumentet er veldig stort, å lese det i sin helhet er skadelig for hjernen. Heldigvis har store selskaper som produserer måleutstyr ressurser til å lage illustrative dokumenter om emnet. og , for eksempel. Jeg har absolutt ingen sjanse i konkurransen med dem når det gjelder kvaliteten på presentasjonen. De som er interesserte, ber jeg om å studere etter lenkene.
Alt jeg trenger å vite om det fysiske laget for å lage en flerkanalsfilter, er frekvensgittertrinnet og moduleringshastigheten. De er samlet i en tabell i ett av de angitte dokumentene:
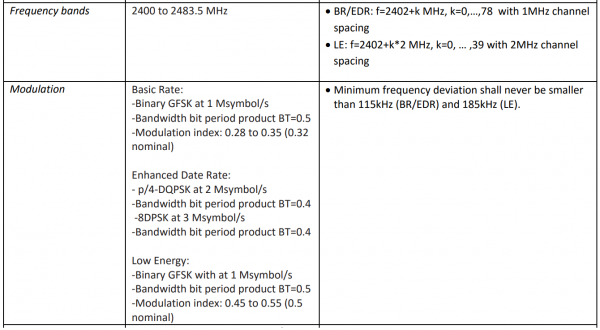
Dermed må vi dele båndbredden på 80 MHz inn i 79 filtre med en innstillingsskritt på 1 MHz og, samtidig, i 40 filtre med en innstillingsskritt på 2 MHz. Utgangsfrekvensene fra filtrene må være 1 MHz og 2 MHz, henholdsvis.
Derfor trenger vi to filtergitter.
For å begynne med, la oss velge parametrene for disse filtrene basert på båndene for Bluetooth Classic og Bluetooth Low Energy. Vi trenger deres impulsrespons for å beregne belastningen på det beregnende filterutstyret. Her må det umiddelbart presiseres at lengden på impulsresponsene ble valgt ut fra kravene til en "rask" filtreringsalgoritme. Essensen endres ikke. Og antall koeffisienter i impulsresponsen må ikke være for stort, slik at filteret kan implementeres på rimelig beregningsmaskinvare.
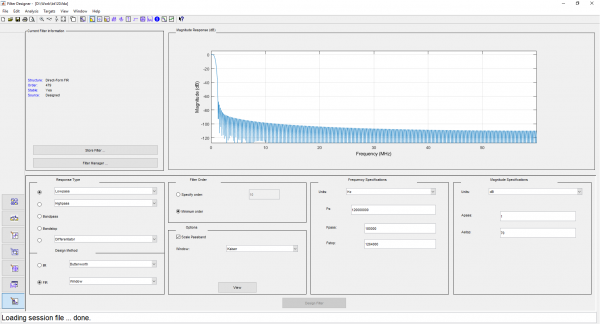
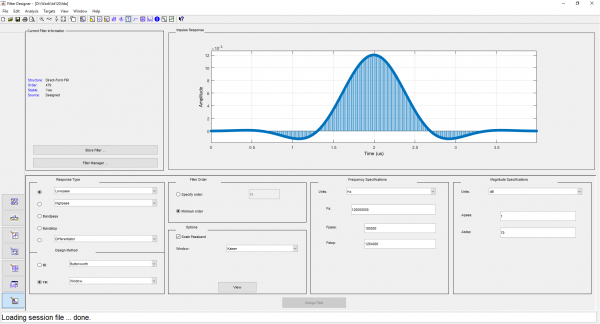
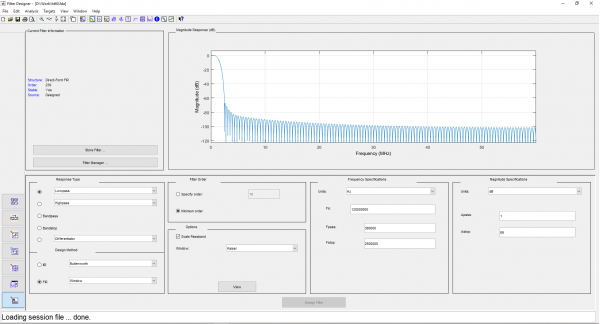
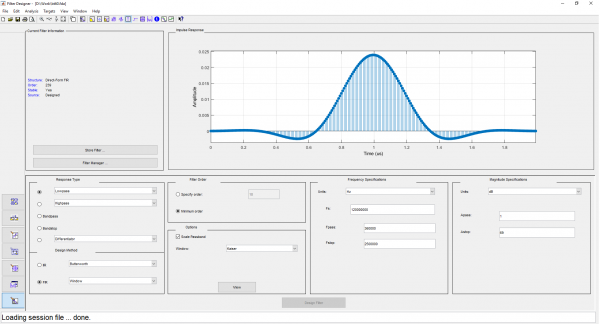
For filtre med 1 MHz skritt velger vi båndbredden til LPF (halvparten av båndbredden til båndfilteret) til 500 kHz, og lengden på impulsresponsen skal tilpasses til 480 avledninger. For filtre med 2 MHz skritt velger vi disse parameterne til 1 MHz og 240 avledninger, henholdsvis. Vi velger Kaiser-vinduet. Vi vil beregne impulsresponsene i filterDesigner og eksportere dem i C-header-format:
Skjermbilder fra filterDesigner
Man kan løse oppgaven direkte ved å bygge et DDC-array som svarer til antallet filtre (). Denne tilnærmingen er god for FPGA-er, hvor man kan oppnå besparelser ved å redusere bitdybden på beregnerne i de første trinnene. Også FPGA-er er den mest energizeffektive måten å implementere dette på. Men arbeidsinnsatsen med denne metoden er høyest.
Når man bruker filterkammer på dagens populære GPU-er, åpner det seg muligheter for å implementere en mer intelligent algoritme: en polyfaset filterkam basert på FFT, som er tilgjengelig fra biblioteket på CUDA. I utenlandsk litteratur kalles algoritmen Polyphase or WOLA (Weight, Overlap and Add) FFT Filterbank. Min motvilje til å tegne hindrer meg fra å gi en visuell forklaring selv. Det finnes mange ressurser om emnet på nettet, spesielt en tydelig graf utført på side 11 (takk til de respektable forfatterne), her er den:
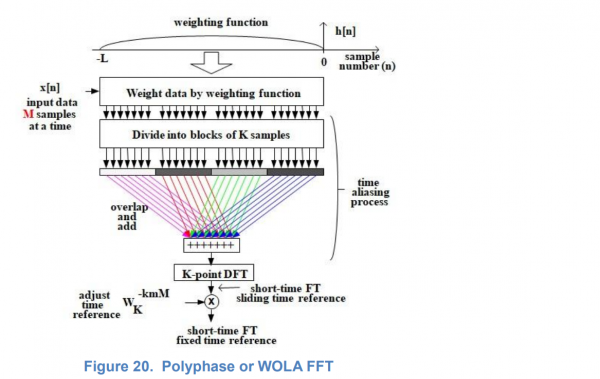
Jeg vil prøve å forklare behandlingsskjemaet med mine egne ord. De med svake nerver bes om å ikke lese.
Jeg vil prøve å forklare behandlingsskjemaet med mine egne ord innenfor rammen av mine metodiske ferdigheter. FFT er en konvolusjon av inngangssignalet med hele spekteret av komplekse ortogonale harmoniske, som tilpasses innenfor intervallene til impulsresponsen. Impulsresponsen til filteret, som signalet blir multiplisert med før inngangen til FFT, er modulert av dette spekteret av harmoniske. Med andre ord, omrisset av impulsresponsene til de resulterende filtrene i kammen bringes utenfor. Deretter blir spekteret av harmoniske forhåndsbehandlet med en viss faktor, på grunn av den utvidede båndbredden av filteret i forhold til filteret i det rektangulære vinduet. På diagrammet ser vi at det er en nedskjæring av fire. Med andre ord, etter at båndbredden er utvidet med et Kaiser-vindu (samtidig med økt demping i båndet av forsinkelse), trenger vi ikke alle filtrene, men bare en fjerdedel av dem. De øvrige er overflødige, deres frekvenskarakteristikker overlapper hverandre. Av de fire påfølgende FFT-punktene velger vi bare det første, hvis beregning er summen av de fire
inngangspunktene, tatt over en periode lik en fjerdedel av varigheten av den originale FFT.
Vi velger utstyret som er tilgjengelig. Dette er inngangskortet fra selskapet "Instrument Systems" FMC126P. Jeg har allerede skrevet om dette i en tidligere . I pluggede et submodul fra samme virksomhed med en AD9371 transceiver i FMC-porten med en båndbredde på 100 MHz. Hele strømmen fra transceiveren kan kontinuerligt overføres til computeren til behandling.
Lad os vælge et grafikkort med GPU GTX 1050. (Jeg lyver, det var det, der valgte os: det var alt, hvad der var til rådighed; det blev revet ud af computeren til antenneberegning, men desto mere overraskende var det at se en fungerende grib.) Lad os gå videre til softwaredelen.
Desværre kan vi på grund af licenser ikke offentliggøre hele koden. Vi kan kun vise GPU-kernene. Resten af koden er heller ikke særlig interessant.
Her er kernen, der udfører signalmultiplikation med vindue og addition, samt omslaget til dens opkald:
__global__ void cuComplexMultiplyWindowKernel(const cuComplex *data, const float *window, size_t windowSize, cuComplex *result) {
    __shared__ cuComplex multiplicationResult[480];
    multiplicationResult[threadIdx.x] = cuComplexMultiplyFloat(data[threadIdx.x + windowSize / 4 * blockIdx.x], window[threadIdx.x]);
    __syncthreads();
    cuComplex sum;
    sum.x = sum.y = 0;
    if (threadIdx.x < windowSize / 4) {
        for(int i = 0; i < 4; i++) {
            sum = cuComplexAdd(sum, multiplicationResult[threadIdx.x + i * windowSize / 4]);
        }
        result[threadIdx.x + windowSize / 4 * blockIdx.x] = sum;
    }
}

cudaError_t cuComplexMultiplyWindow(const cuComplex *data, const float *window, size_t windowSize, cuComplex *result, size_t dataSize, cudaStream_t stream) {
    size_t windowStep = windowSize / 4;
    cuComplexMultiplyWindowKernel<<>>(data, window, windowSize, result);
    return cudaGetLastError();
}
Koden til signalbehandling, der kalder denne kerne, gentager nøjagtigt skemaet for algoritmen vist i det tidligere billede, så jeg ser ikke behovet for at inkludere den her.
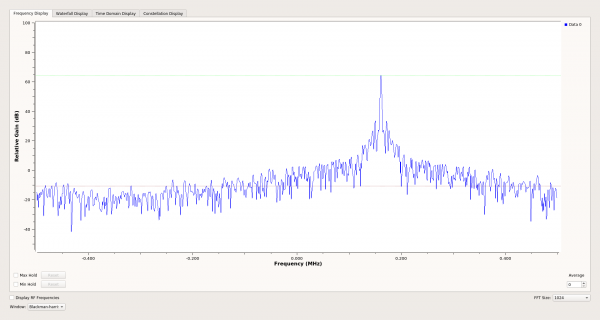
Gribene blev testet på det udgående spektrum af kanaler i realtid. Et signal fra signalgeneratoren på 2450 MHz blev sendt til AD9371, og filtrenes selektivitet svarede til de beregnede værdier.
Planerne er: tilpasning af softwaren til XRTX-kortet og implementering af pakkesøgning, hvis nogen har brug for det, eller hvis der er noget fritid.
Alt arbejdet med softwaren blev udført af , ære være ham!
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish