

I SQL beskriver du «hva» du ønsker å oppnå, ikke «hvordan» det skal utføres. Derfor har problemet med å utvikle SQL-spørsmål i stilen «som høres ut, så skrives det» sin hederlige plass ved siden av .
I dag skal vi se på ekstremt enkle eksempler på hva dette kan føre til i konteksten av å bruke GROUP/DISTINCT og LIMIT sammen med dem.
Så hvis du skrev i forespørselen «først koble disse tabellene, og deretter kaste ut alle duplikater, det skal bare være én forekomst for hver nøkkel» — vil det fungere akkurat slik, selv om koblingen ikke var nødvendig.
Og noen ganger har man flaks og det «bare fungerer», noen ganger påvirker det ytelsen negativt, og noen ganger gir det helt uventede effekter sett fra utviklerens synspunkt.
Vel, kanskje ikke så spektakulære, men...
«Det søte paret»: JOIN + DISTINCT
SELECT DISTINCT
  X.*
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
WHERE
  Y.bool_condition;
Det er ganske klart hva de ønsket å velge slike poster X, for hvilke det finnes tilknyttede Y med den aktuelle betingelsen.De skrev forespørselen gjennom JOIN — og fikk noen pk-verdier flere ganger (akkurat så mange som det fantes passende poster i Y). Hvordan fjerne? Selvfølgelig DISTINCT!
Det er spesielt «oppmuntrende» når det for hver X-post finnes flere hundre tilknyttede Y-poster, og duplikatene må fjernes heroisk...
Hvordan fikse dette? Først og fremst må man innse at oppgaven kan modifiseres til «å velge slike poster X, for hvilke det finnes MINST ÉN tilknyttet med den aktuelle betingelsen» — for fra selve Y-posten trenger vi ingenting.
Innebygd EXISTS
SELECT
  *
FROM
  X
WHERE
  EXISTS(
    SELECT
      NULL
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  );
Noen versjoner av PostgreSQL forstår at det i EXISTS er nok å finne den første tilgjengelige posten, eldre versjoner gjør ikke det. Derfor foretrekker jeg alltid å angi LIMIT 1 inside EXISTS.
LATERAL JOIN
SELECT
  X.*
FROM
  X
, LATERAL (
    SELECT
      Y.*
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  ) Y
WHERE
  Y IS DISTINCT FROM NULL;
Denne varianten gjør det også mulig å returnere noen data fra den tilknyttede Y-posten som er funnet, hvis nødvendig. En lignende variant er beskrevet i artikkelen .
«Hvorfor betale mer»: DISTINCT [ON] + LIMIT 1
En ekstra fordel med slike forespørselstransformasjoner er muligheten til enkelt å begrense gjennomgangen av poster, hvis man bare trenger én/flere av dem, som i følgende tilfelle:
SELECT DISTINCT ON(X.pk)
  *
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
Nå leser vi forespørselen og prøver å forstå hva som tilbys av DBMS:
- vi kobler sammen tabellene
- vi unikegjør etter X.pk
- fra de gjenværende postene velger vi en eller annen
Så hva fikk vi? «En eller annen post» fra de unike — og hvis vi tar denne ene fra de ikke-unike, vil ikke resultatet da endres på noen måte? .. «Og hvis det ikke er forskjell, hvorfor betale mer?»
SELECT
  *
FROM
  (
    SELECT
      *
    FROM
      X
    -- her kan vi legge til passende betingelser
    LIMIT 1 -- +1 Limit
  ) X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
Og samme tema med GROUP BY + LIMIT 1.
«Jeg må bare spørre»: implisitt GROUP + LIMIT
Slike ting skjer ved forskjellige sjekker av ikke-tomhet tabellen eller CTE under utførelsen av forespørselen:
...
CASE
  WHEN (
    SELECT
      count(*),
    FROM
      X
    LIMIT 1
  ) = 0 THEN ...
Aggregatfunksjoner (count/min/max/sum/...) utføres med hell på hele settet, selv uten eksplisitt angivelse GROUP BY. Men de LIMIT de samarbeider ikke veldig godt.
Utvikleren kan tro «hvis det finnes poster der, så trenger jeg ikke mer enn LIMIT».Men ikke gjør det! Fordi for databasen er det:
- tell hva de ønsker gi så mange rader som de ber om
- Avhengig av målsettingene her er det passende å gjøre en av erstatningene:
(count + LIMIT 1) = 0
NOT EXISTS(LIMIT 1)En funksjon har blitt(count + LIMIT 1) > 0EXISTS(LIMIT 1)En funksjon har blittcount >= N(SELECT count(*) FROM (... LIMIT N))En funksjon har blitt«Hvor mye veier det i gram»: DISTINCT + LIMIT
SELECT DISTINCT pk FROM X LIMIT $1
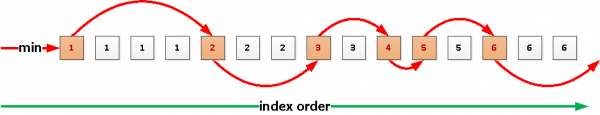
En naiv utvikler kan oppriktig tro at forespørselen stopper når vi finner de $1 første tilfeldige forskjellige verdiene.En gang i fremtiden kan det slik fungere takket være den nye noden Index Skip Scan.
, implementeringen av hvilken nå blir utviklet, men frem til nå — det gjør det ikke. Så langt vil alle poster først bli hentet,, unikegjort, og bare fra dem vil det returneres så mange som bedt om. Det er spesielt trist hvis vi ønsket noe som
, og antall poster i tabellen er hundretusener… For ikke å gråte forgjeves, la oss bruke den rekursive forespørselen«DISTINCT for de fattige» fra PostgreSQL Wiki $1 = 4I SQL beskriver du «hva» du ønsker å få, ikke «hvordan» det skal utføres.
🥇PostgreSQL Antipatterns: «Det skal bare være én igjen!» | ProHoster :
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish