

Når man jobber med et produkt som har utviklet seg i over ti år, er det ikke overraskende å finne utdaterte teknologier i det. Men hva skjer hvis du om seks måneder må håndtere en belastning som er ti ganger høyere, og kostnaden ved nedetid øker hundre ganger? I så fall trenger du en dyktig Highload Engineer. Men siden vi ikke hadde en slik tilgjengelig, ble problemet overlatt til meg. I del én av artikkelen vil jeg fortelle om overgangen fra Redis til Redis-cluster, og i del to vil jeg gi råd om hvordan man begynner å bruke clusteren og hva man bør være oppmerksom på under driften.
Valg av teknologi
Er det så ille med en egen Redis (standalone redis) i en konfigurasjon med 1 master og N slaver? Hvorfor kaller jeg det en utdatert teknologi?
Nei, Redis er ikke så ille... Men det er noen ulemper som ikke kan ignoreres.
For det første støtter ikke Redis mekanismer for gjenoppretting etter feil på masteren. For å løse dette problemet brukte vi en konfigurasjon med automatisk overføring av VIP-er til den nye masteren, endring av rollen til en av slavene og bytting av de andre. Denne mekanismen fungerte, men man kunne ikke kalle det en pålitelig løsning. For det første oppsto det falske positive varsler, og for det andre var det engangsbruk, og etter en utløsing var det behov for manuell håndtering for å få det tilbake til normal.
For det andre førte det å ha bare én master til problemer med sharding. Man måtte opprette flere uavhengige klynger med '1 master og N slaver', deretter manuelt fordele databasene på disse maskinene og håpe at en av databasene ikke ble så stor at den måtte flyttes til en egen instans.
Hva er alternativene?
- Den dyreste og mest omfattende løsningen er Redis-Enterprise. Dette er en pakkeløsning med full teknisk støtte. Selv om det ser perfekt ut fra et teknisk synspunkt, passet det ikke for oss av ideologiske grunner.
- Redis-cluster. Ut av boksen har det støtte for automatisk failover av masteren og sharding. Grensesnittet er nesten identisk med den vanlige versjonen. Det ser lovende ut, og vi vil diskutere mulige fallgruver senere.
- Tarantool, Memcache, Aerospike og andre. Alle disse verktøyene gjør omtrent det samme. Men hver av dem har sine egne ulemper. Vi har bestemt oss for ikke å legge alle eggene i en kurv. Memcache og Tarantool bruker vi til andre oppgaver, og for å være før vi kommer til poenget, skal jeg si at vi har hatt flere problemer med dem i vår praksis.
Spesifikasjonen for bruk
La oss se på hvilke oppgaver vi historisk har løst med Redis og hvilken funksjonalitet vi har brukt:
- Cache før forespørselen til eksterne tjenester som 2GIS | Golang
GET SET MGET MSET "SELECT DB"
- Cache før MYSQL | PHP
GET SET MGET MSET SCAN "KEY BY PATTERN" "SELECT DB"
- Hovedlagring for tjenesten som arbeider med økter og koordinater til sjåfører | Golang
GET SET MGET MSET "SELECT DB" "ADD GEO KEY" "GET GEO KEY" SCAN
Som du ser, ingen høyere matematikk. Hva er så kompleksiteten? La oss se nærmere på hver metode.
Metode
Description
Egenskaper ved Redis-kluster
Solution
GET SET
Skrive/lese nøkkel
MGET MSET
Skrive/lese flere nøkler
Nøklene vil ligge på forskjellige noder. Ferdige biblioteker kan kun gjøre Multi-operasjoner innenfor en node.
Erstatt MGET med en pipeline av N GET-operasjoner
SELECT DB
Velge databasen vi skal bruke
Støtter ikke flere databaser
Oppbevar alt i én database. Legg til prefikser til nøklene
SCAN
Gå gjennom alle nøklene i databasen
Siden vi har én database, er det for kostbart å gå gjennom alle nøklene i klusteret.
Opprettholde invariant innenfor en nøkkel og gjøre HSCAN på denne nøkkelen. Eller avstå helt.
GEO
Operasjoner med geonøkkel
Geonøkkelen deles ikke opp.
KEY BY PATTERN
Søke etter nøkkel basert på mønster
Siden vi har én database, skal vi søke gjennom alle nøklene i klusteret. For kostbart.
Avstå eller opprettholde invariant, som i tilfellet med SCAN.
Redis vs Redis-kluster
Hva mister vi og hva får vi ved å gå over til kluster?
- Ulemper: vi mister funksjonaliteten til flere databaser.
- Hvis vi vil lagre logisk usammenhengende data i ett kluster, må vi lage løsninger med prefikser.
- Vi mister alle operasjoner "per database", som SCAN, DBSIZE, CLEAR DB osv.
- Multi-operasjoner har blitt betydelig vanskeligere å implementere, fordi det kan kreve tilgang til flere noder.
- Fordeler:
- Feiltoleranse i form av nødskifting av hovedserver.
- Shardingside på Redis.
- Overføring av data mellom noder atomisk og uten nedetid.
- Legge til og omfordele kapasitet og belastninger uten nedetid.
Jeg vil konkludere med at si at hvis du ikke trenger å sikre et høyt nivå av tilgjengelighet, så er det ikke verdt å flytte til en klynge, da dette kan være en krevende oppgave. Men hvis man først velger mellom en separat versjon og en klynge, bør man velge klyngen, da den ikke er dårligere, og i tillegg vil den ta bort noe av bekymringen.
Forberedelse til flytting
Vi begynner med kravene til flyttingen:
- Den må være sømløs. En total stopp av tjenesten i 5 minutter er uakseptabelt for oss.
- Den bør være så sikker og gradvis som mulig. Vi ønsker å ha kontroll over situasjonen. Å kaste alt på en gang og stole på nedgraderingsknappen er ikke noe vi ønsker.
- Minimale datatap under flyttingen. Vi forstår at det vil være svært vanskelig å flytte atomært, så vi aksepterer en viss desynkronisering mellom dataene i vanlig og klynge Redis.
Vedlikehold av klyngen
Før selve flyttingen, bør vi vurdere om vi kan vedlikeholde klyngen:
- Grafikk. Vi bruker Prometheus og Grafana for grafikk over CPU-bruk, minnebruk, antall klienter, antall GET, SET, AUTH-operasjoner, osv.
- Ekspertise. Tenk deg at i morgen vil du ha ansvaret for en enorm klynge. Hvis den krasjer, så er det ingen andre enn deg som kan fikse den. Hvis den begynner å fungere sakte - vil alle komme til deg. Hvis ressurser må legges til eller belastning må omfordeles - igjen til deg. For å unngå å bli gråhåret i en alder av 25, bør man forutse disse situasjonene og teste på forhånd hvordan teknologien vil oppføre seg under ulike handlinger. Vi vil diskutere dette nærmere i delen om 'Ekspertise'.
- Overvåkning og varsler. Når klyngen krasjer, ønsker vi å bli informert først. Her har vi begrenset oss til varsler om at alle noder returnerer den samme informasjonen om klyngens tilstand (ja, det kan være annerledes). Andre problemer blir raskere oppdaget gjennom varsler fra Redis-klienttjenester.
Flytting
Hvordan vi skal flytte:
- Først må vi forberede biblioteket for å arbeide med klyngen. Som grunnlag for versjonen i Go har vi tatt go-redis og tilpasset det litt. Vi implementerte Multi-metoder gjennom pipelines og justerte reglene for gjentakelse av forespørslene. Med PHP-versjonen oppsto det flere problemer, men til slutt har vi landet på php-redis. Nylig har de introdusert støtte for klynger, og etter vårt syn ser det bra ut.
- Deretter må vi sette opp selve klyngen. Dette gjøres bokstavelig talt med to kommandoer basert på konfigurasjonsfilen. Vi vil diskutere innstillingene mer detaljert nedenfor.
- For en gradvis overgang bruker vi dry-mode. Siden vi har to versjoner av biblioteket med identisk grensesnitt (en for vanlig versjon og en for klynge), er det enkelt å lage en wrapper som jobber med den separate versjonen og samtidig dupliserer alle forespørslene til klyngen, sammenligner svarene og skriver avvikene i loggene (i vårt tilfelle i NewRelic). Dermed, selv om klyngeversjonen bryter ved utrullingen, vil produksjonen vår ikke bli berørt.
- Når vi lanserer klyngen i dry-modus, kan vi rolig se på diagrammet over avvik i svarene. Hvis andelen feil sakte men sikkert beveger seg mot en liten konstant, betyr det at alt er i orden. Hvorfor er det fortsatt avvik? Fordi opptak i den separate versjonen skjer litt tidligere enn i klyngen, og på grunn av mikrologgene kan dataene avvike. Det gjenstår bare å se på avviksloggene, og hvis alle er forklarlige med hensyn til ikke-atomaritet i opptakene, kan vi gå videre.
- Nå kan vi skifte dry-mode tilbake. Vi vil skrive og lese fra klyngen, samtidig som vi dupliserer til den separate versjonen. Hvorfor? I løpet av den neste uken ønsker vi å observere hvordan klyngen fungerer. Hvis det viser seg at det er problemer under høy belastning, eller vi har oversett noe, har vi alltid en nødprosess for å gå tilbake til gammel kode og aktuelle data takket være dry-mode.
- Det gjenstår bare å deaktivere dry-mode og demontere den separate versjonen.
Ekspertise
Først en kort oversikt over hvordan klyngen er strukturert.
Først og fremst er Redis et key-value lagringssystem. Vilkårlige strenger brukes som nøkler. Verdiene kan være tall, strenger og komplekse strukturer. Det finnes et stort antall av de siste, men for å forstå den generelle strukturen er dette ikke viktig.
Det neste nivået av abstraksjon etter nøklene er slottene (SLOTS). Hver nøkkel tilhører en av 16 383 slots. Inne i hver slot kan det være så mange nøkler som ønskes. Dermed deles alle nøkler opp i 16 383 ikke-overlappende mengder.
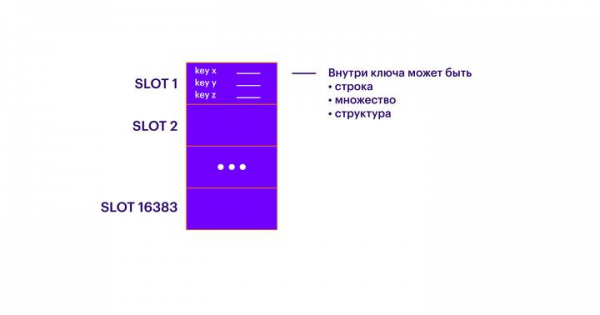
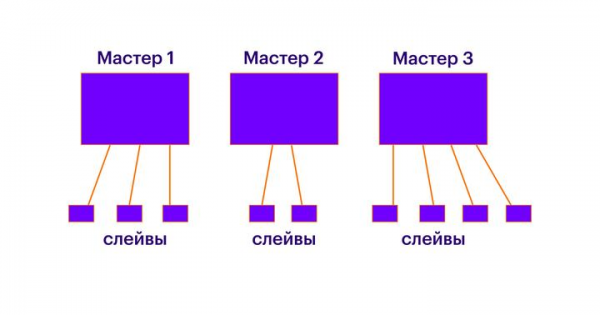
Videre må det være N master-noder i klyngen. Hver node kan betraktes som en separat Redis-instans som vet alt om de andre nodene inne i klyngen. Hver master-node inneholder et visst antall slots. Hver slot tilhører bare én master-node. Alle slots må fordeles mellom nodene. Hvis noen slots ikke er fordelt, vil nøklene som lagres i dem være utilgjengelige. Hver master-node gir mening å kjøre på en separat logisk eller fysisk maskin. Det er også viktig å huske at hver node kun kjører på én kjerne, og hvis du ønsker å kjøre flere Redis-instanserer på en logisk maskin, må du sørge for at de kjører på forskjellige kjerner (vi har ikke prøvd dette, men i teorien skal det fungere). I hovedsak gir master-nodene vanlig sharding, og flere master-noder gjør det mulig å skalere både skrive- og leseforespørslene.
Etter at alle nøkler er fordelt på slots, og slots er fordelt på master-nodene, kan det legges til et vilkårlig antall slave-noder til hver master-node. Inne i hver «master-slave» kobling vil vanlig replikering fungere. Slaver er nødvendige for å skalere leseforespørslene og for failover i tilfelle masteren svikter.
La oss nå snakke om operasjonene vi helst bør kunne utføre.
Vi vil kontakte systemet via Redis-CLI. Siden Redis ikke har et enkelt tilgangspunkt, kan de følgende operasjonene utføres på hvilken som helst av nodene. Jeg vil spesifisere hver enkelt operasjon med tanke på muligheten for å utføre den under belastning.
- Det første og viktigste vi trenger: operasjonen cluster nodes. Den returnerer tilstanden til klyngen, viser listen over noder, deres roller, fordelingen av slots osv. Ytterligere informasjon kan fås ved hjelp av cluster info og cluster slots.
- Det ville være bra å kunne legge til og fjerne noder. For dette finnes operasjonene cluster meet og cluster forget. Vær oppmerksom på at cluster forget må brukes på HVER node, både på mastere og replikaer. Og cluster meet trenger kun kalles på én node. Denne forskjellen kan være forvirrende, så det er best å bli klar over den før man setter klusteret i drift. Å legge til en node gjøres trygt i drift og påvirker ikke arbeidet til klusteret (noe som er logisk). Hvis du imidlertid planlegger å fjerne en node fra klusteret, bør du forsikre deg om at det ikke er noen slots igjen (ellers risikerer du å miste tilgang til alle nøklene på denne noden). Fjern heller ikke masteren hvis den har slaver, ellers vil det bli unødvendig avstemning for en ny master. Hvis det ikke er noen slots igjen på nodene, er det et lite problem, men hvorfor velge det unødvendige, hvis man kan fjerne slavene først.
- Hvis du må tvinge bytte mellom master og slave, kan kommandoen cluster failover brukes. Når du kaller denne i drift, må du forstå at masteren vil være utilgjengelig under operasjonen. Vanligvis skjer byttet på mindre enn et sekund, men det er ikke atomisk. Du kan forvente at deler av forespørslene til masteren vil feile i løpet av denne tiden.
- Før du fjerner en node fra klyngen, bør det ikke være noen slots igjen på den. Det er best å omfordele dem med kommandoen cluster reshard. Slots vil bli overført fra en master til en annen. Hele operasjonen kan ta flere minutter, avhengig av mengden data som overføres, men prosessen er trygg og påvirker ikke driften av klyngen. Dermed kan alle data overføres fra en node til en annen selv under belastning, uten å bekymre seg for tilgjengeligheten. Imidlertid er det visse nyanser. For det første er dataoverføring forbundet med en viss belastning på både mottaker- og avsender-noden. Hvis mottakeren allerede er sterkt belastet på prosessoren, bør du ikke belaste den med mottak av nye data. For det andre, så snart det ikke er noen slots igjen på master-avsenderen, vil alle dens slaves umiddelbart gå over til den masteren hvor disse slotsene ble flyttet. Problemet er at alle disse slave-nodene vil ønske å synkronisere dataene samtidig. Og du er heldig hvis dette er delvis, og ikke full synkronisering. Ta hensyn til dette, og kombiner operasjoner med flytting av slots med å frakoble/flytte slaves. Eller håp at du har tilstrekkelig kapasitet.
- Hva gjør du hvis du oppdager at du har mistet slots under overføringen? Jeg håper dette problemet ikke vil berøre deg, men hvis det skjer, finnes det en operasjon kalt cluster fix. Den vil tilfeldigvis fordele slotsene på nodene. Jeg anbefaler å sjekke hvordan den fungerer ved å fjerne en node med fordelte slots fra klyngen først. Siden data i ufordelte slots allerede er utilgjengelige, er det for sent å bekymre seg for tilgangen til disse slotsene. På sin side vil operasjonen ikke påvirke de fordelte slotsene.
- En annen nyttig operasjon er monitor. Den lar deg se hele listen over forespørslene som kommer til noden i sanntid. Dessuten kan du bruke grep på den for å finne ut om det er ønsket trafikk.
Det er også viktig å nevne prosedyren for nødovergang til master. Kort sagt er det en prosedyre, og etter min mening fungerer den utmerket. Men man skal ikke tro at hvis man trekker ut stikkontakten fra maskinen med master-noden, vil Redis umiddelbart overta og kundene ikke vil merke noen avbrudd. Etter min erfaring tar det flere sekunder før overgangen skjer. I løpet av denne tiden vil deler av dataene være utilgjengelige: masterens utilgjengelighet oppdages, nodene stemmer over ny, slaver byttes over, og data synkroniseres. Den beste måten å sikre seg om at systemet fungerer, er å gjennomføre lokale øvelser. Sett opp en klynge på din bærbare PC, gi minimal last, simuler et nedbrudd (for eksempel ved å blokkere porter), og evaluer overgangen. Etter min mening kan man først være sikker på teknologiens funksjonalitet etter å ha lekt med det i en dag eller to. Eller håpe på at programvaren som brukes av halve internett, fungerer som den skal.
Konfigurasjon
Som regel er konfigurasjonen det første man trenger for å begynne å bruke verktøyet. Og når alt er oppe og går, ønsker man ikke å røre konfigurasjonen. Det kreves spesifikke anstrengelser for å tvinge seg selv tilbake til innstillingene og gå dem grundig igjennom. Etter min erfaring har vi hatt minst to alvorlige feil på grunn av uoppmerksomhet mot konfigurasjonen. Vær spesielt oppmerksom på følgende punkter:
- timeout 0
Tiden det tar før inaktive forbindelser lukkes (i sekunder). 0 — lukkes ikke
Ikke alle våre biblioteker var i stand til å lukke forbindelser riktig. Ved å deaktivere denne innstillingen risikerer vi å nå grensen for antall klienter. På den annen side, hvis et slikt problem eksisterer, vil automatisk brudd av tapte forbindelser maskere det, og vi kan gå glipp av det. Videre bør man ikke aktivere denne innstillingen når man bruker persist-forbindelser. - Save x y & appendonly yes
Lagring av RDB-snapshot.
Problemer knyttet til RDB/AOF vil vi diskutere i detalj nedenfor. - stop-writes-on-bgsave-error no & slave-serve-stale-data yes
Hvis aktivert, vil master slutte å ta imot endringsforespørsel ved et RDB-snapshot-feil. Hvis forbindelsen til master er tapt, kan slaven fortsette å svare på forespørsel (yes). Eller slutte å svare (no)
Vi er ikke komfortable med situasjonen der Redis blir til en gresskar. - repl-ping-slave-period 5
I løpet av denne tidsperioden vil vi begynne å bekymre oss for at masteren er brutt sammen og at vi bør utføre en failover-prosedyre.
Vi må manuelt finne balansen mellom falske alarmer og utløsing av failover. I vår erfaring tar dette 5 sekunder. - repl-backlog-size 1024mb & epl-backlog-ttl 0
Slik mengde data kan vi lagre i bufferet for en avvikende replika. Hvis bufferet fylles opp, må vi synkronisere helt.
Erfaringen tilsier at det er bedre å sette verdien litt høyere. Det finnes flere grunner til at en replika kan begynne å henge etter. Hvis den henger etter, er det sannsynlig at masteren din allerede sliter, og full synkronisering vil bli dråpen som får begeret til å renne over. - maxclients 10000
Det maksimale antallet samtidige klienter.
Ifølge vår erfaring er det bedre å sette verdien høyere. Redis klarer seg fint med 10 000 tilkoblinger. Bare sørg for at systemet har nok sokler. - maxmemory-policy volatile-ttl
Reglene for hvordan nøkler blir fjernet når grensen for tilgjengelig minne nås.
Her er det viktigere ikke selve regelen, men forståelsen av hvordan dette vil skje. Redis kan roses for dets evne til å fungere godt når minnegrensen nås.
Problemer med RDB og AOF
Selv om Redis lagrer all informasjon i RAM, finnes det også mekanismer for å lagre data på disk. Nærmere bestemt finnes det tre mekanismer:
- RDB-snapshot — et fullt snapshot av all data. Settes opp med konfigurasjonen SAVE X Y og leses som "Lagre et fullstendig snapshot av alle data hvert X sekunder, hvis minst Y nøkler har blitt endret."
- Append-only file — en liste over operasjoner i rekkefølge etter utførelse. Legger til nye ankomne operasjoner til filen hvert X sekunder eller hver Y operasjoner.
- RDB og AOF — en kombinasjon av de to forrige.
Alle metodene har sine fordeler og ulemper, jeg vil ikke liste dem alle, men vil bare påpeke det som, etter min mening, ikke er så åpenbare punkter.
For det første, for å lagre en RDB-snapshot kreves det å kalle FORK. Hvis det er mye data, kan dette hengslet hele Redis i en periode fra noen millisekunder til ett sekund. I tillegg må systemet allokere minne til et slikt snapshot, noe som fører til behovet for å ha en dobbel reserve av RAM på den logiske maskinen: hvis 8 GB er tildelt Redis, må det være tilgjengelig 16 GB på den virtuelle maskinen.
For det andre er det problemer med delvis synkronisering. I AOF-modus kan det, ved gjenoppretting av slave, utføres en fullstendig synkronisering i stedet for delvis. Hvorfor dette skjer, klarte jeg ikke å forstå. Men det er verdt å huske på.
Disse to punktene får oss allerede til å tenke på om vi virkelig trenger disse dataene på disk, når de allerede er duplisert av slavene. Data kan bare gå tapt dersom alle slavene svikter, og det er et problem av "brann i datasenteret"-nivå. Som et kompromiss kan man foreslå å lagre data kun på slavene, men i så fall må man sørge for at disse slavene aldri blir master ved nødgjenoppretting (det finnes en innstilling for prioritering av slaver i deres konfigurasjon). I hvert enkelt tilfelle vurderer vi om vi skal lagre data på disk, og vi svarer oftest "nei".
Konklusjon
Avslutningsvis håper jeg jeg har gitt en generell oversikt over hvordan redis-cluster fungerer til de som aldri har hørt om det, og også påpekt noen ikke-åpenbare punkter for de som allerede har brukt det en stund.
Takk for tiden din, og som alltid er kommentarer om emnet velkomne.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish