

Forfattar: Serhij Luk'jančikov, ingeniørkonsulent for InterSystems
Utfordringar med AI/ML-realtidsberegningar
La oss starte med eksempler fra erfaringer med Data Science-praksis i InterSystems:
- Den «belasta» kundeporalen er kopla til eit online anbefalingssystem. Det er planlagt omstrukturering av kampanjer i den butikkjeden (til dømes, i staden for ei «flat» rekkje av kampanjer, vil det no bli brukt ei matrise av «segment-strategi»). Kva skjer med anbefalingsmekanismane? Kva skjer med innlevering og oppdatering av data i anbefalingsmekanismen (volumet av inngangsdata har auka med 25000 ganger)? Kva skjer med generering av anbefalingar (behovet for tusenfalt reduksjon av terskelen for filtrering av anbefalingsregler på grunn av tusenfoldig auke i deira tal og «utval»)?
- Det er ein overvåkningssystem for sannsynlighet for utvikling av feil i utstyrselement. Det ble knyttet til et sentralisert styringssystem (ASUTP), som overfører tusenvis av prosessparametre hvert sekund. Kva skjer med overvåkningssystemet som tidlegare arbeidde med «manuelle utval» (er det i stand til å sørge for overvåking av sannsynlighet hvert sekund)? Kva vil skje dersom det kjem ei ny blokk i inngangsdataene med hundrevis av kolonner med sensoravlesingar, som nettopp er lagt til i ASUTP (vil det vere nødvendig og kor lenge vil overvåkningssystemet må stansast for å inkludere dataanalysen frå dei nye sensorane)?
- Det er oppretta eit kompleks av AI/ML-mekanismar (anbefalande, overvåkande, prognostiske), som nyttar resultata frå kvarandre. Kor mange mennesketimar er det behov for kvar månad for å tilpasse dette komplekset til endringar i inngangsdataene? Kva er den totale «forsinkinga» ved å støtte komplekset for å ta styringsavgjerder (frekvensen av ny støttande informasjon i forhold til frekvensen av nye inngangsdata)?
Samanfattande desse og mange andre eksempel har vi kome til formuleringar av desse utfordringane som oppstår når me går over til bruk av maskinlærings- og kunstig intelligensmekanismar i sanntid:
- Er vi nøgde med hastigheita av oppretting og tilpasning (til den skiftande situasjonen) av AI/ML-løysingar i vår bedrift?
- Hvor godt støtter AI/ML-løsningene våre sanntid forretningsledelse?
- Er AI/ML-løsningene våre i stand til å tilpasse seg endringer i data og forretningspraksis uten utviklere?
Artikkelen vår er en grundig gjennomgang av mulighetene til InterSystems IRIS-plattformen for universell støtte til implementering av AI/ML-mekanismer, integrering av AI/ML-løsninger og opplæring/testing av AI/ML-løsninger på intensive datastreams. Vi vil se på markedsundersøkelser, praktiske eksempler på AI/ML-løsninger og de konseptuelle aspektene av hva vi kaller en AI/ML-plattform for sanntid i denne artikkelen.
Hva vi lærte fra undersøkelser: sanntidsapplikasjoner
Resultater , utført blant omtrent 800 IT-fagfolk i 2019 av Lightbend, taler for seg selv:
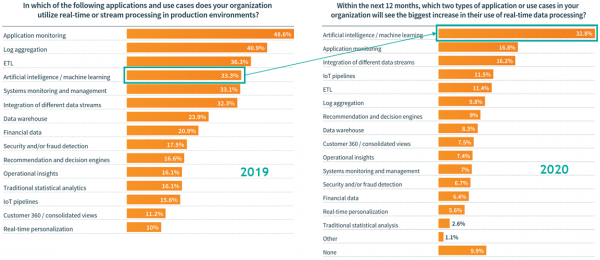
Figur 1 Ledende forbrukere av sanntidsdata
La oss sitere viktige utdrag fra rapporten om resultatene av denne undersøkelsen i vår oversettelse:
«… Tendensene i populariteten til verktøy for datastream-integrasjon og samtidig støtte for beregninger i containere gir en synergistisk respons på forespørselen fra markedet om en mer operativ, rasjonell, dynamisk tilnærming til effektive løsninger. Datastreams tillater raskere informasjonsformidling enn tradisjonelle batch-data. I tillegg kommer muligheten for å bruke beregningsmetoder raskt, som AI/ML-baserte anbefalinger, som skaper konkurransefortrinn gjennom økt kundetilfredshet. Løpet etter hastighet påvirker også alle roller i DevOps-paradigmet – det øker utviklings- og distribusjonseffektiviteten for applikasjoner. … Åtte hundre og fire IT-spesialister ga informasjon om bruken av datastreams i organisasjonene deres. Respondentene var hovedsakelig fra vestlige land (41 % i Europa og 37 % i Nord-Amerika) og var praktisk talt jevnt fordelt mellom små, mellomstore og store selskaper. …
Kunstig intelligens er ikke bare hype. Femtiåtte prosent av de som allerede bruker datastreaming i produktive AI/ML-applikasjoner bekrefter at bruken i AI/ML vil oppnå den største veksten det kommende året (sammenlignet med andre applikasjoner).
- Ifølge flertallet av de spurte vil bruken av datastreaming i AI/ML-scenarier oppnå den største veksten det kommende året.
- Bruken i AI/ML vil vokse ikke bare på grunn av relativt nye typer scenarier, men også på grunn av tradisjonelle scenarier, der sanntidsdata brukes stadig mer intensivt.
- I tillegg til AI/ML er entusiasmen blant brukerne av IoT-datastreaming imponerende — 48 % av de som allerede har integrert IoT-data, hevder at implementeringen av scenarier basert på disse dataene vil oppnå betydelig vekst i nær fremtid. … »
Denne ganske interessante undersøkelsen viser at oppfatningen av maskinlæring og kunstig intelligens som toppbrukere av datastreaming er allerede «på vei». Men et ikke mindre viktig observasjon er oppfatningen av AI/ML i sanntid gjennom linsen av DevOps: her kan vi allerede begynne å snakke om transformasjonen fra den dominerende kulturen av ‘engangs AI/ML med fullt tilgjengelige datamengder’.
Konseptet av en AI/ML-plattform for sanntid
Et typisk anvendelsesområde for AI/ML i sanntid er styring av teknologiske prosesser i produksjon. La oss formulere konseptet for en AI/ML-plattform for sanntid basert på dette eksemplet og de tidligere betraktningene.
Bruken av kunstig intelligens og maskinlæring i styring av teknologiske prosesser har en rekke særegenheter:
- Data om tilstanden til den teknologiske prosessen kommer inn intensivt: med høy frekvens og over et bredt spekter av parametere (opp til titusenvis av parametere sendt per sekund fra automatiserte systemer).
- Data om identifikasjon av feil, for ikke å nevne data om deres utvikling, er derimot knappe og uregelmessige, preget av utilstrekkelig typisering av feilene og deres tidslokalisering (ofte presentert på papirdokumenter).
- Fra et praktisk perspektiv er det kun «aktualitetsvinduet» for de opprinnelige dataene som er tilgjengelig for trening og anvendelse av modeller, som reflekterer dynamikken i den teknologiske prosessen over et rimelig glidende intervall, som avsluttes med de siste innleste verdiene av prosessparametrene.
Disse egenskapene tvinger oss, i tillegg til å motta og grunnleggende behandle den intensive «bredbåndsinngangssignalet» fra den teknologiske prosessen i sanntid, også å utføre (parallelt) anvendelse, trening og kvalitetskontroll av resultatene fra AI/ML-modellene – også i sanntid. Det «bilde» som modellene våre «ser» i det glidende aktualitetsvinduet, endres kontinuerlig – og sammen med det endres også kvaliteten på resultatene fra AI/ML-modellene som er trent på ett av «bildene» i fortiden. Ved forverring av kvaliteten på resultatene fra AI/ML-modellene (for eksempel: klassifiseringsfeilverdien «alarm-norm» har kommet utenfor de grensene vi har definert) bør det automatisk starte en ny trening av modellene på et mer aktuelt «bilde» — og tidspunktene for innsettelse av ny trening av modellene må ta hensyn til både varigheten av selve treningen og dynamikken i forverringen av kvaliteten på arbeidet til den nåværende versjonen av modellene (siden de nåværende versjonene av modellene fortsetter å bli brukt, mens modellene trenes, og før deres «nytrente» versjoner er dannet).
InterSystems IRIS har kjernemuligheter for å støtte drift av AI/ML-løsninger for styring av teknologiske prosesser i sanntid. Disse mulighetene kan deles inn i tre hovedgrupper:
- Kontinuerlig utrulling (Continuous Deployment/Delivery, CD) av nye eller tilpassede eksisterende AI/ML-mekanismer inn i et produktivt løsning som opererer i sanntid på plattformen InterSystems IRIS.
- Kontinuerlig integrasjon (Continuous Integration, CI) av inngående datastreamer fra den teknologiske prosessen, datakøer for anvendelse/trening/kvalitetskontroll av AI/ML-mekanismer og data/kode/kontrollinteraksjoner med miljøer for matematisk modellering, som orkestreres i sanntid av plattformen InterSystems IRIS.
- Kontinuerlig (selv-)læring (Continuous Training, CT) av AI/ML-mekanismer, som utføres i matematiske simuleringsmiljøer ved hjelp av data, kode og styringseffekter («traff beslutninger»), overført av InterSystems IRIS-plattformen.
Klassifiseringen av plattformmuligheter i forhold til maskinlæring og kunstig intelligens er ikke tilfeldig. La oss sitere metodologien fra Google, som danner den konseptuelle basen for denne klassifiseringen, i vår oversettelse:
«… Den populære DevOps-konsepten i dag dekker utvikling og drift av storskalainformasjonsystemer. Fordelene ved å implementere dette konseptet er reduksjon av varigheten av utviklingssykluser, akselerasjon av distribusjonene, fleksibilitet i utgivelsesplanlegging. For å oppnå disse fordelene forutsetter DevOps implementering av minst to praksiser:
- Continuous Integration (CI)
- Continuous Delivery (CD)
Disse praksisene gjelder også for AI/ML-plattformer – for å sikre en pålitelig og effektiv bygging av produktive AI/ML-løsninger.
AI/ML-plattformer skiller seg fra andre informasjonssystemer i følgende aspekter:
- Teamets kompetanse: Når man lager en AI/ML-løsning, inkluderer teamet vanligvis dataforskere eller akademiske eksperter innen datavitenskap, som utfører dataanalyse, utvikling og testing av modeller. Disse teammedlemmene trenger ikke nødvendigvis å være profesjonelle utviklere av produktiv programvarekode.
- Utvikling: AI/ML-mekanismer er eksperimentelle av natur. For å løse oppgaven på den mest effektive måten, er det nødvendig å prøve ulike kombinasjoner av inngangsvariabler, algoritmer, modelleringsmetoder og modellparametere. Kompleksiteten ved slik prøving ligger i sporingen av «hva som fungerte/ikke fungerte», sikring av reproduksjon av episoder, generalisering av utviklingen for gjentatte implementeringer.
- Testing: testing av AI/ML-mekanismer krever et bredere spekter av tester enn de fleste andre utviklinger. I tillegg til standard modul- og integrasjonstester, testes datavaliditet og kvaliteten på resultatene av modellens anvendelse på trenings- og kontrollprøver.
- Utrulling: Utrulling av AI/ML-løsninger handler ikke bare om prediktive tjenester som bruker en en gang opplært modell. AI/ML-løsninger er bygget rundt flertrinns pipeline som utfører automatisert opplæring og anvendelse av modeller. Utrulling av slike pipeliner innebærer automatisering av komplekse handlinger som tradisjonelt utføres manuelt av dataforskere for å kunne trene og teste modeller.
- Produktivitet: AI/ML-mekanismer kan mangle ytelse ikke bare på grunn av ineffektiv programmering, men også på grunn av den stadig skiftende naturen til inngangsdataene. Med andre ord kan ytelsen til AI/ML-mekanismer degraderes på grunn av et bredere spekter av årsaker enn det som gjelder for vanlig utvikling. Dette fører til behovet for overvåking (i sanntid) av ytelsen til våre AI/ML-mekanismer, samt utsendelse av varsler eller utelukkelse av resultater hvis ytelsesindikatorene ikke møter forventningene.
AI/ML-plattformer ligner andre informasjonssystemer ved at de begge krever kontinuerlig kodeintegrasjon med versjonskontroll, modulær testing, integrasjonstesting og kontinuerlig utrulling av utvikling. Imidlertid er det noen viktige forskjeller med AI/ML:
- CI (Continuous Integration, kontinuerlig integrasjon) er ikke lenger begrenset til testing og validering av koden til utrullede komponenter – det inkluderer også testing og validering av data og AI/ML-modeller.
- CD (Continuous Delivery/Deployment, kontinuerlig utrulling) handler ikke bare om å skrive og gi ut pakker eller tjenester, men innebærer en plattform for komposisjon, opplæring og anvendelse av AI/ML-løsninger.
- CT (Continuous Training, kontinuerlig opplæring) – et nytt element [forf. merknad: et nytt element i forhold til den tradisjonelle DevOps-konseptet, der CT vanligvis er Continuous Testing], som er karakteristisk for AI/ML-plattformer, ansvarlig for autonom håndtering av mekanismene for opplæring og anvendelse av AI/ML-modeller. ...
Vi kan konstatere at maskinlæring og kunstig intelligens som arbeider med sanntidsdata, krever et bredere sett av verktøy og kompetanser (fra utvikling av kode til orkestrering av matematiske modeller), tettere integrasjon mellom alle funksjonelle og faglige områder, samt en mer effektiv organisering av menneskelige og maskinelle ressurser.
Sanntidsscenario: gjenkjenning av utviklingen av defekter i næringspumper
Når vi fortsetter å bruke området for styring av teknologiske prosesser som eksempel, vurderer vi en konkret oppgave (som allerede er nevnt tidligere): det er nødvendig å sikre sanntidsovervåking av utviklingen av defekter i pumpene basert på strømmen av parameterverdier for teknologiske prosesser og rapporter fra reparasjonspersonell om avdekkede defekter.
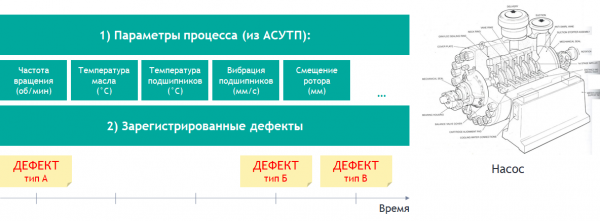
Figur 2 Formulering av oppgaven for overvåking av utviklingen av defekter
En spesiell egenskap ved de fleste oppgaver stilt på denne måten i praksis er at regelmessigheten og hastigheten med hvilke data (DCS) mottas, må vurderes i lys av episodisk og uregelmessig oppståelse (og registrering) av defekter av ulike typer. Med andre ord: data fra DCS kommer med en sekunds frekvens nøyaktige, mens defekter blir registrert med kjemisk blyant med dato i en felles notatbok i verkstedet (for eksempel: «12.01 - lekkasje i toppen fra den 3. lageret»).
Dermed kan vi supplere formuleringen av oppgaven med denne viktige restriksjonen: «merket» på defekten av en bestemt type har vi bare én (dvs. eksempel på en defekt av en spesifikk type er representert av data fra DCS på en bestemt dato – og flere eksempler på nettopp denne typen defekt har vi ikke). Denne restriksjonen tar oss umiddelbart utenfor rammen av klassisk maskinlæring (supervised learning) som krever mange «merker».
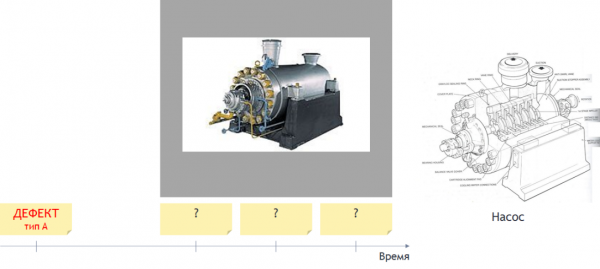
Figur 3 Presisering av oppgaven for overvåking av utviklingen av defekter
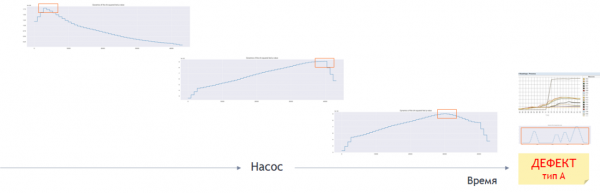
Kan vi på en eller annen måte «duplikere» den eneste «merket» vi har tilgjengelig? Ja, vi kan det. Den nåværende tilstanden til pumpen kjennetegnes av graden av likhet med registrerte feil. Selv uten å bruke kvantitative metoder, bare ved å observere data fra overvåkningssystemet, kan vi allerede hente ut mye informasjon ved visuell vurdering av dataene.
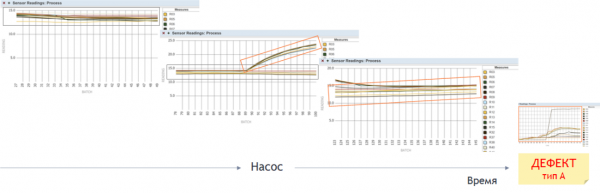
Figur 4 Dynamikken til pumpens tilstand i sammenheng med «merking» av en bestemt feiltype
Men visuell vurdering (i hvert fall for nå) er ikke den mest passende generatoren for «merking» i vårt raskt skiftende scenario. Vi skal vurdere likheten mellom pumpens nåværende tilstand og registrerte feil ved hjelp av statistisk testing.
Figur 5 Bruk av statistisk test på dataene i sammenheng med «merking» av en bestemt feiltype
Den statistiske testen bestemmer sannsynligheten for at dataposter med verdier av prosessparametere i «datastream-pakken» fra overvåkningssystemet ligner på oppføringene for «merking» av en bestemt feiltype. Den beregnede sannsynligheten (indeks for statistisk likhet) konverteres til en verdi mellom 0 og 1, og blir en «merking» for maskinlæring i hver enkelt oppføring i den undersøkende pakken. Det vil si, etter at den nyankomne pakken med pumpens tilstand er behandlet med statistisk testen, får vi muligheten til (a) å legge denne pakken til treningsdatasettet for AI/ML-modellen og (b) kontrollere kvaliteten på den nåværende versjonen av modellen når den brukes på denne pakken.
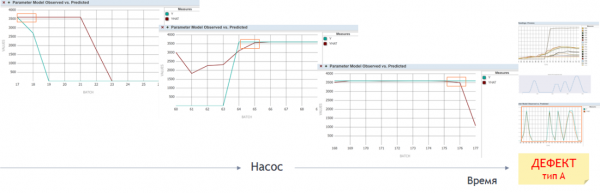
Figur 6 Bruk av maskinlæringsmodellen på dataene i sammenheng med «merking» av en bestemt feiltype
I et av våre tidligere Vi viser og forklarer hvordan InterSystems IRIS-plattformen gjør det mulig å realisere enhver AI/ML-mekanisme som kontinuerlig kjørende forretningsprosesser, som overvåker nøyaktigheten av simuleringsresultatene og tilpasser modellens parametere. Når vi implementerer prototypene av vårt scenario med pumpene, bruker vi all funksjonaliteten til InterSystems IRIS som ble presentert i løpet av webinaret – ved å implementere i prosessanalysatoren, ikke klassisk supervised learning, men snarere reinforcement learning, som automatisk styrer utvalget for modelltrening. I treningssettet plasseres poster der «konsensusdeteksjon» oppstår etter anvendelse av både den statistiske testen og den nåværende versjonen av modellen – det vil si at både den statistiske testen (etter transformeringen av likhet-indeksen til 0 eller 1) og modellen gir resultat 1 på slike poster. Ved ny modelltrening, under valideringen (den nyutdannede modellen brukes på sitt eget treningssett, med forhåndsbruk av den statistiske testen), fjernes poster som «ikke beholdt» resultat 1 etter behandling med den statistiske testen (på grunn av konstant tilstedeværelse av poster fra den opprinnelige «merkelappen» avfeilen) fra treningssettet, og den nye modellen lærer på «feilmerkelappen» pluss på de «beholdte» postene fra strømmen.
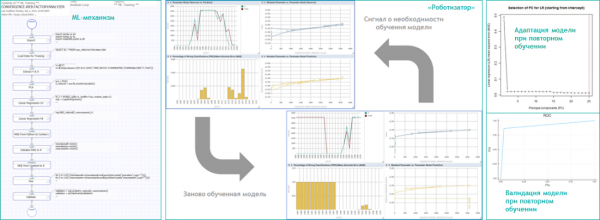
Figur 7 Robotisering av AI/ML-beregninger i InterSystems IRIS
Dersom det skulle oppstå et behov for en slags «andre mening» om kvaliteten på detekteringen som oppnås ved lokale beregninger i InterSystems IRIS, opprettes det en prosess-rådgiver for å utføre trening-anvendelsesser på et kontrolldatasett ved hjelp av skytjenester (for eksempel Microsoft Azure, Amazon Web Services, Google Cloud Platform osv.):
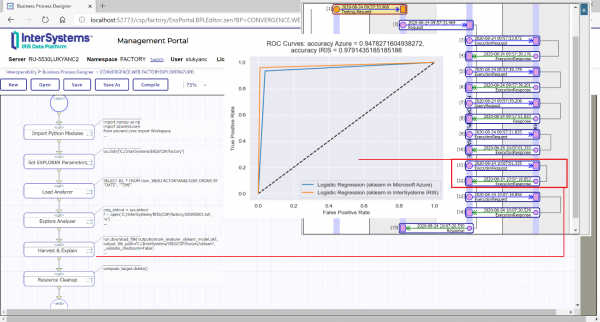
Figur 8 «Andre mening» fra Microsoft Azure under orkestrering av InterSystems IRIS
Prototypen av vårt scenario i InterSystems IRIS er utført som et agentbasert system av analytiske prosesser som interagerer med utstyr (pumpen), matematiske modelleringsmiljøer (Python, R og Julia), og sikrer selvopplæring av alle involverte AI/ML-mekanismer – på sanntidsdata.
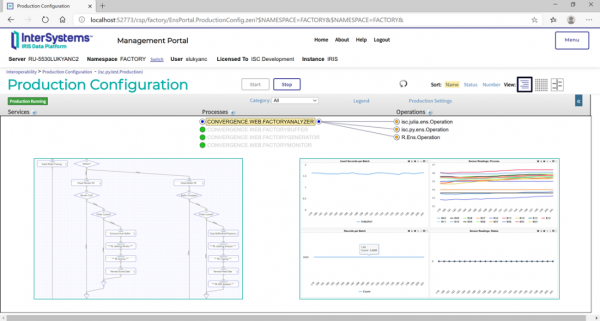
Figur 9 Hovedfunksjonaliteten til AI/ML-løsningen for sanntid i InterSystems IRIS
Det praktiske resultatet av arbeidet med prototypen vår:
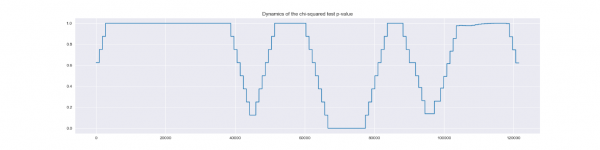
- Detektert defektmønster av modellen (12. januar):
- Detektert utviklende defekt av modellen, som ikke var inkludert i prøven (11. september; selve defekten ble konstatert av reparasjonslaget først etter to dager – 13. september):
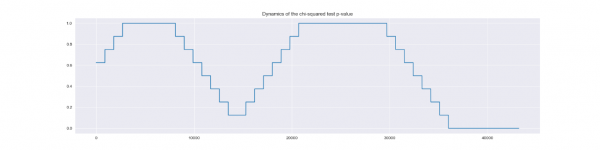
Simulering på ekte data som inneholder flere episoder av den samme defekten viste at løsningen vår, implementert på InterSystems IRIS-plattformen, gjør det mulig å avsløre utviklingen av defekter av denne typen flere dager før reparasjonslaget oppdager dem.
InterSystems IRIS – en universell plattform for AI/ML-beregninger i sanntid.
InterSystems IRIS-plattformen forenkler utviklingen, distribusjonen og driften av løsninger basert på sanntidsdata. InterSystems IRIS kan samtidig utføre transaksjons- og analytisk databehandling; støtte synkroniserte datavisninger i samsvar med flere modeller (inkludert relasjons-, hierarkiske, objekt- og dokumentmodeller); være en integrasjonsplattform for et bredt spekter av datakilder og individuelle applikasjoner; og gi avansert sanntidsanalyse på strukturerte og ustrukturerte data. InterSystems IRIS tilbyr også mekanismer for å anvende eksternt analytiske verktøy og gjør det mulig å kombinere skybasert og lokal serverplassering fleksibelt.
Applikasjoner bygget på InterSystems IRIS-plattformen er implementert i ulike bransjer, og hjelper selskaper med å oppnå betydelig økonomisk effekt både strategisk og operasjonelt, fremmer beslutningsinformasjon og fjerner 'gap' mellom hendelse, analyse og handling.
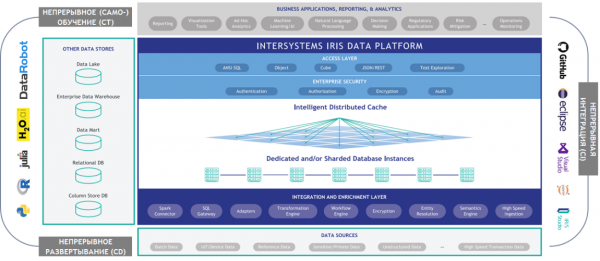
Figur 10 Arkitektur av InterSystems IRIS i konteksten av AI/ML i sanntid.
I likhet med det forrige diagrammet, kombinerer diagrammet nedenfor det nye 'koordinatsystemet' (CD/CI/CT) med informasjonsflytskjemaet mellom plattformens arbeidskomponenter. Visualiseringen starter med makromekanismen CD og fortsetter med makromekanismene CI og CT.
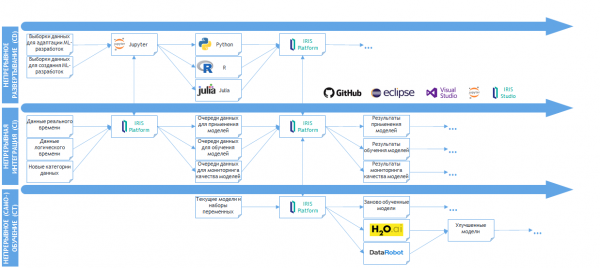
Figur 11 Informasjonsflytskjema mellom AI/ML-elementene på InterSystems IRIS-plattformen.
Essensen av CD-mekanismen i InterSystems IRIS: Brukere av plattformen (utviklere av AI-/ML-løsninger) tilpasser eksisterende og/eller lager nye AI-/ML-utviklinger ved hjelp av en spesialisert programkode-editor for AI-/ML-mekanismer: Jupyter (fullt navn: Jupyter Notebook; for enkelhets skyld refereres noen ganger til dokumentene som er laget i denne editoren på kort). I Jupyter har utvikleren muligheten til å skrive, feilsøke og bekrefte funksjonaliteten (inkludert bruk av grafikk) av en spesifikk AI-/ML-utvikling før den blir implementert («distribuert») i InterSystems IRIS. Det er tydelig at den nye utviklingen som skapes på denne måten, bare vil få grunnleggende feilsøking (blant annet fordi Jupyter ikke fungerer med sanntidsdatastreams) – dette er helt normalt, ettersom hovedresultatet av utviklingen i Jupyter blir en bekreftelse på den teoretiske funksjonaliteten til den enkelte AI-/ML-mekanismen («viser forventet resultat på dataprøven»). På samme måte kan en allerede plassert mekanisme i plattformen (se de følgende makromekanismene) før feilretting i Jupyter kreve et «tilbakefall» til en «før-plattform» tilstand (som lesing av data fra filer, arbeid med data via xDBC i stedet for tabeller, direkte interaksjon med globale variabler – flerdimensjonale datamatriser i InterSystems IRIS – osv.).
Et viktig aspekt ved implementeringen av CD nettopp i InterSystems IRIS: Det er etablert en toveis integrasjon mellom plattformen og Jupyter, som gjør det mulig å overføre innhold til plattformen (og deretter behandle det i plattformen) på språkene Python, R og Julia (alle tre er programmeringsspråk i de ledende open-source miljøene for matematisk modellering). Dermed har utviklere av AI-/ML-innhold muligheten til å utføre «kontinuerlig distribusjon» av dette innholdet i plattformen, mens de arbeider i sin kjente Jupyter-editor, med de vanlige bibliotekene tilgjengelig i Python, R, Julia, og utfører grunnleggende feilsøking (ved behov) utenfor plattformen.
Vi går videre til makromekanismen CI i InterSystems IRIS. Diagrammet viser makroprosessen av "realtidsroboten" (et kompleks av datastrukturer, forretningsprosesser og koden som orkestreres av dem, skrevet på matrise-språk og ObjectScript – det native utviklingsspråket til InterSystems IRIS). Oppgaven til denne makroprosessen er å opprettholde nødvendige datakøer for AI/ML-mekanismene (basert på datastreams som overføres til plattformen i sanntid), ta beslutninger om rekkefølgen av bruk og "sortimentet" av AI/ML-mekanismer (de kalles også "matematiske algoritmer", "modeller" osv. – kan ha ulike navn avhengig av spesifikasjonen av implementeringen og terminologiske preferanser), samt holde datastrukturene for analysen av resultatene av AI/ML-mekanismene (kubene, tabellene, flerdimensjonale datamasser osv. – for rapporter, dashbord, osv.) oppdatert.
Et viktig aspekt ved implementeringen av CI spesielt i InterSystems IRIS: mellom plattformen og miljøene for matematisk modellering er det etablert en toveis integrasjon, som gjør det mulig å kjøre innhold plassert i plattformen på språkene Python, R og Julia i deres respektive miljøer og få tilbake resultater av kjøringen. Denne integrasjonen er implementert både i "terminalmodus" (dvs. AI/ML-innholdet formuleres som kode i ObjectScript som kaller på matematiske miljøer), samt i "forretningsprosessmodus" (dvs. AI/ML-innholdet formuleres som en forretningsprosess ved hjelp av et grafisk redigeringsverktøy, noen ganger ved hjelp av Jupyter, eller ved hjelp av IDE – IRIS Studio, Eclipse, Visual Studio Code). Tilgjengeligheten av forretningsprosesser for redigering i Jupyter gjenspeiles ved hjelp av forbindelsen mellom IRIS på CI-nivå og Jupyter på CD-nivå. En mer detaljert oversikt over integrasjonen med miljøene for matematisk modellering vil bli gitt senere. På dette stadiet er det vår mening at det er alle grunnlag for å bekrefte at plattformen inneholder alle nødvendige verktøy for å implementere "kontinuerlig integrering" av AI/ML-utviklinger (som kommer fra "kontinuerlig distribusjon") i AI/ML-løsninger i sanntid.
Og hovudmakromekanismen: CT. Uten det kan ikkje AI/ML-plattformer fungere (sjølv om «sanntid» vil bli implementert gjennom CD/CI). Kjernen i CT er arbeidet til plattformen med «artefakter» for maskinlæring og kunstig intelligens direkte i arbeidsøkter av matematiske modelleringsmiljøer: modeller, fordelingstabeller, vektormatriser, lag av nevrale nettverk, osv. Dette «arbeidet» består i dei fleste tilfeller av å lage nemnde artefakter i miljø (i tilfellet modeller, for eksempel, «opprettinga» består av å spesifisere modellen og deretter justere parameterverdiene – den såkalte «treninga» av modellen), anvendelsen deira (for modeller: beregning av «modellverdier» for målvariablane – prognoser, kategorikrins, sannsynlighet for hendingar, osv.) og forbedring av allereie oppretta og brukte artefakter (for eksempel omdefinering av settet av inngangsvariabler for modellen basert på resultata frå bruken – for å auke presisjonen i prognosene, som eit alternativ). Nokre av dei viktigaste punkta for å forstå rolla til CT er dens «abstraksjon» frå realitetane til CD og CI: CT vil implementere alle artefakter med utgangspunkt i den databehandlings- og matematiske spesifikasjonen av AI/ML-løysinga innanfor moglegheitene som spesifikke miljø gir. Ansvar for «tilførsel av innganger» og «levering av resultater» vil ligge på CD og CI.
En viktig aspekt av implementeringen av CT i InterSystems IRIS: ved å bruke den nevnte integrasjonen med matematiske modelleringsmiljøer, har plattformen muligheten til å hente ut de artefakter som oppstår i arbeidsøktene som kjøres under dens ledelse i matematiske miljøer, og (det viktigste) omdanne dem til plattformens dataobjekter. For eksempel kan en distribusjonstabell som nettopp er opprettet i en Python-økt (uten å stoppe økten i Python) overføres til plattformen som en global (multidimensjonal datamatrise i InterSystems IRIS) – og brukes til beregninger i en annen AI/ML-mekanisme (implementert allerede på språk fra et annet miljø – for eksempel R) – eller som en virtuell tabell. Et annet eksempel: parallelt med «normalmodus» for modellens arbeid (i Python-økten) utføres det på dens inndata «auto-ML»: automatisk valg av optimale inndatavariabler og parameterverdier. Og sammen med «normal» trening får den produktive modellen i sanntid også «forslag til optimalisering» av sin spesifikasjon – der settet med inndatavariabler endres, parameterverdiene endres (ikke lenger som resultat av trening i Python, men som resultat av trening av en «alternativ» versjon av seg selv, for eksempel i H2O-stakken), noe som lar den totale AI/ML-løsningen autonomt håndtere uventede endringer i karakteren på inndataene og de simulerte fenomenene.
La oss se nærmere på plattformens AI/ML-funksjonalitet i InterSystems IRIS, med eksempelet av en faktisk eksisterende prototype.
I den nedenstående diagram, til venstre på slidshowet, vises en del af forretningsprocessen, der implementerer udførelsen af scripts i Python og R. I midten vises visuelle logs over udførelsen af nogle af disse scripts, henholdsvis i Python og R. Umiddelbart efter dem vises eksempler på indhold på begge sprog, der sendes til udførelse i de respektive miljøer. Til højre i slutningen vises visualiseringer baseret på resultaterne af scriptudførelsen. Visualiseringerne på toppen er lavet i IRIS Analytics (data hentet fra Python til InterSystems IRIS dataplatform og sendt til dashboardet ved hjælp af platformens værktøjer), mens visualiseringerne nederst er lavet direkte i R arbejdssessionen og gemt som grafiske filer. Et vigtigt aspekt: det præsenterede fragment i prototypen er ansvarligt for træningen af modellen (klassificering af tilstandsdata for udstyr) baseret på data, der strømmer ind i realtid fra udstyrs-simulatoren, efter anmodning fra kvalitetsmonitoren, som observerer klassificeringen under anvendelsen af modellen. Implementeringen af AI/ML-løsningen som et sæt af interagerende processer („agenter“) vil blive diskuteret senere.
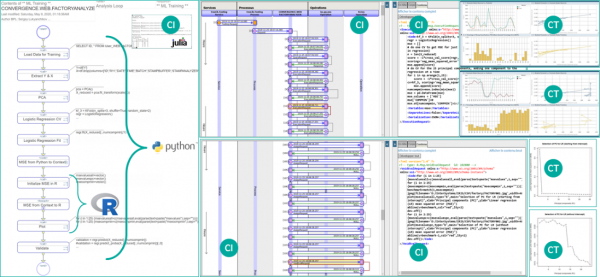
Figur 12 Interaktion med Python, R og Julia i InterSystems IRIS
Platformprocesserne (også kaldet "forretningsprocesser", "analytiske processer", "pipelines" osv. – afhængig af konteksten) redigeres primært i den grafiske forretningsproceseditor i selve platformen, således at der samtidig skabes både dens blokdiagram og den tilsvarende AI/ML-mekanisme (programkode). Når vi siger, at "der opnås en AI/ML-mekanisme", menes der oprindeligt hybriditet (inden for en enkelt proces): indholdet på sprog for matematiske modeller lever side om side med indholdet på SQL (inklusive udvidelser fra ), på InterSystems ObjectScript, med andre støttede språk. Dessuten gir plattformsprosessen svært brede muligheter for «tegning» i form av hierarkisk innlagte fragmenter (som vist i eksemplet i diagrammet nedenfor), noe som gjør det mulig å organisere selv svært kompleks innhold effektivt, uten å «falle ut» av det grafiske formatet (i «ikke-grafiske» metoder/kategorier/prosedyrer osv.). Det vil si at om nødvendig (og det forventes i de fleste prosjekter) kan absolutt alle AI/ML-løsninger implementeres i et grafisk selvkommenterende format. Vi oppfordrer til å merke seg at i den sentrale delen av diagrammet nedenfor, som presenterer et høyere «nivå av innbygging», er det synlig at i tillegg til selve arbeidet med å trene modellen (ved hjelp av Python og R), legges det også til analyse av den såkalte ROC-kurven til den trente modellen, som lar oss visuelt (og beregningsmessig også) vurdere kvaliteten på treningen – og denne analysen er implementert på språket Julia (kjøres i henhold til det, i matmiljøet Julia).
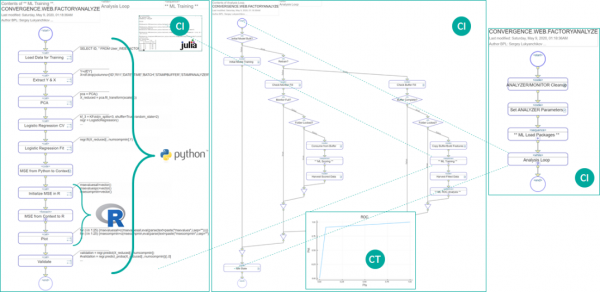
Figur 13 Visuell komposisjonsmiljø for AI/ML-løsninger i InterSystems IRIS
Som allerede nevnt, vil den innledende utviklingen og (i noen tilfeller) tilpasningen av allerede implementerte AI/ML-mekanismer på plattformen bli/kanskje bli utført utenfor plattformen i Jupyter-redigereren. I diagrammet nedenfor ser vi et eksempel på tilpasning av eksisterende plattformprosess (den samme som i diagrammet ovenfor) – slik ser den delen ut i Jupyter som er ansvarlig for å trene modellen. Innholdet i Python-språket er tilgjengelig for redigering, debugging, samt utskrift av grafikk direkte i Jupyter. Endringer (om nødvendig) kan gjøres med øyeblikkelig synkronisering til plattformprosessen, inkludert dens produksjonsversjon. Tilsvarende kan nytt innhold overføres til plattformen (en ny plattformprosess opprettes automatisk).
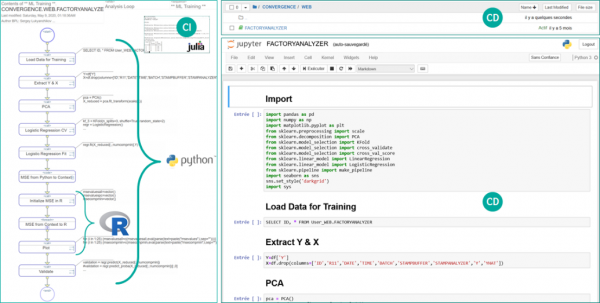
Figur 14 Bruk av Jupyter Notebook for redigering av AI/ML-mekanismen i InterSystems IRIS
Plattformprosessens tilpasning kan utføres ikke bare i grafisk eller bærbar format, men også i en «total» IDE (Integrated Development Environment) format. IDE-er som IRIS Studio (den native IRIS-studioen), Visual Studio Code (InterSystems IRIS-utvidelsen for VSCode) og Eclipse (Atelier-pluginen) fungerer som slike IDE-er. I en rekke tilfeller kan utviklerteamet bruke alle tre IDE-er samtidig. Diagrammet nedenfor viser et eksempel på redigering av den samme prosessen i IRIS-studio, Visual Studio Code, og Eclipse. All innhold er tilgjengelig for redigering: både Python/R/Julia/SQL, ObjectScript, og forretningsprosessen.
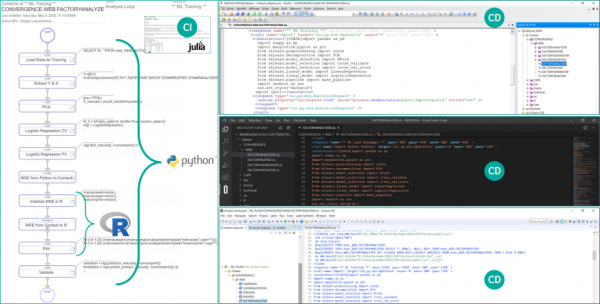
Figur 15 Utvikling av InterSystems IRIS forretningsprosess i forskjellige IDE-er
De verktøyene som beskriver og utfører forretningsprosesser i InterSystems IRIS på språket Business Process Language (BPL) fortjener spesiell omtale. BPL gir muligheter for bruk av «klare integrasjonskomponenter» (activities) i forretningsprosessene – noe som gir fullstendig grunn til å påstå at InterSystems IRIS har implementert «kontinuerlig integrasjon». De klare forretningsprosesskomponentene (aktiviteter og relasjoner mellom dem) fungerer som en kraftig akselerator for utviklingen av AI/ML-løsninger. Og ikke bare utvikling: takket være aktivitetene og relasjonene mellom dem oppstår det et «autonomt ledelseslag» over de fragmenterte AI/ML-utviklingene og mekanismene, som kan ta beslutninger i henhold til situasjonen, i sanntid.
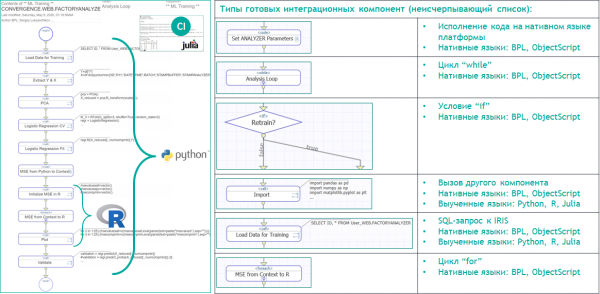
Figur 16 Klare forretningsprosesskomponenter for kontinuerlig integrasjon (CI) på InterSystems IRIS-plattformen
Konseptet med agent-systemer (også kjent som «multi-agent-systemer») har sterke posisjoner innen robotisering, og InterSystems IRIS-plattformen støtter det organisk gjennom konstruktet «produkt-prosess». I tillegg til de ubegrensede mulighetene for å «fylle» hver prosess med nødvendig funksjonalitet for den generelle løsningen, gir det å gi plattformprosessystemet egenskapen «agentlighet» muligheten til å lage effektive løsninger for svært ustabile simulerte fenomener (atferd av sosiale/biosystemer, delvis observerbare teknologiske prosesser, osv.).
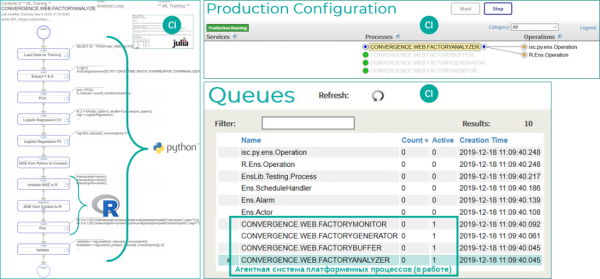
Figur 16 Drift av AI/ML-løsning som et agent-system for forretningsprosesser i InterSystems IRIS
Vi fortsetter vår gjennomgang av InterSystems IRIS med en diskusjon om den praktiske bruken av plattformen for å løse hele klasser av sanntidsoppgaver (en ganske detaljert introduksjon til noen av de beste praksisene for plattformbasert AI/ML på InterSystems IRIS finnes i en av våre tidligere artikler. ).
I kjølvannet av den forrige diagrammet følger en mer detaljert oversikt over agentsystemet. Diagrammet viser den samme prototypen, og alle fire agentprosessene er skjematisk tegnet, med relasjonene mellom dem: GENERATOR – som håndterer datagenerering fra utstyrs sensorer, BUFFER – som administrerer datakøer, ANALYZER – som utfører selve maskinlæringen, MONITOR – som overvåker kvaliteten på maskinlæringen og gir signal om behovet for gjenopplæring av modellen.
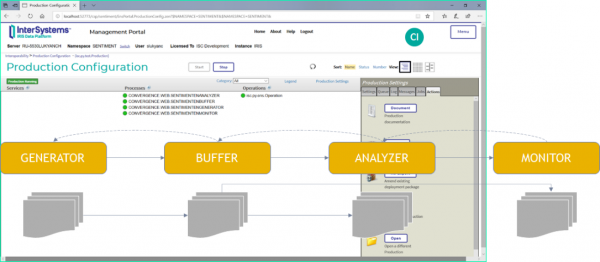
Figur 17 Komposisjon av AI/ML-løsningen som et agentsystem for forretningsprosesser i InterSystems IRIS
I diagrammet nedenfor er det illustrert den autonome funksjonen til en annen robotprototyp (gjenkjenning av den emosjonelle tonen i tekster) over en viss tidsperiode. Øverst vises utviklingen av kvaliteten på modellens læring (kvaliteten øker), nederst er dynamikken i kvaliteten på modellens anvendelse og fakta om gjenopplæring (røde striper). Som det fremgår, har løsningen effektivt og autonomt lært seg selv, og fungerer på et angitt kvalitetsnivå (kvalitetsmålet faller ikke under 80 %).
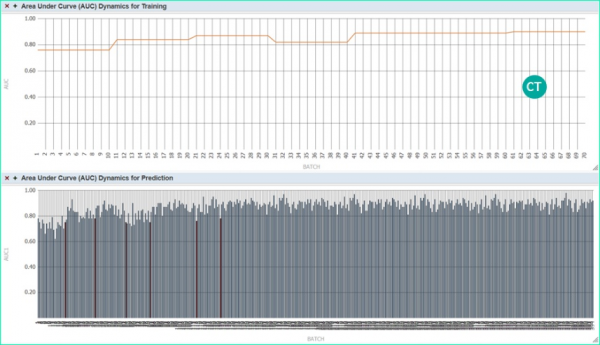
Figur 18 Kontinuerlig (selv-)læring (CT) på InterSystems IRIS-plattformen
Vi har også nevnt «auto-ML» tidligere, men på diagrammet nedenfor vises bruken av denne funksjonen i detalj, med et annet prototypeeksempel. I det grafiske diagrammet av forretningsprosessfragmentet vises aktiviteten som initierer modelleringen i H2O-stakken, samt resultatene av denne modelleringen (den klare dominansen av den oppnådde modellen over «håndlagde» modeller, ifølge den sammenlignende ROC-kurven, samt automatisert identifisering av «de mest innflytelsesrike variablene» fra de tilgjengelige i den opprinnelige datamengden). Et viktig poeng her er tids- og ekspertressursbesparelsen som oppnås gjennom «auto-ML»: det som vår plattformprosess oppnår på et halvt minutt (å finne og trene den optimale modellen), kan ta en ekspert fra en uke til en måned.
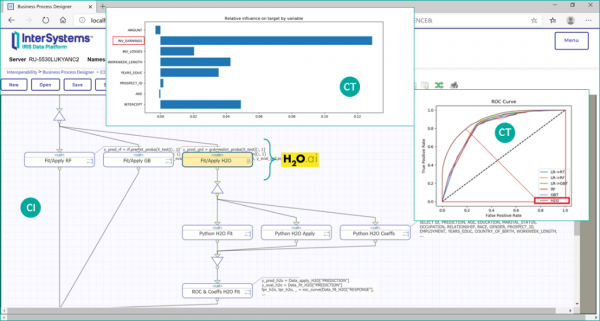
Figur 19 Integrasjon av «auto-ML» i AI/ML-løsningen på InterSystems IRIS-plattformen
Diagrammet under forstyrrer litt klimakset, men det er et godt alternativ for å avslutte fortellingen om klassene av oppgaver som kan løses i sanntid: vi minner om at til tross for alle mulighetene til InterSystems IRIS-plattformen, er det ikke obligatorisk å trene modeller under dens ledelse. Plattformen kan motta en såkalt PMML-spesifikasjon for en modell som er trent i et verktøy som ikke er under plattformens kontroll – og bruke denne modellen i sanntid fra øyeblikket den importeres. . Det er viktig å merke seg at langt fra alle AI/ML-artifakter kan reduseres til PMML-spesifikasjoner, selv om de fleste av de vanligste artifaktene lar seg gjøre. Dermed har InterSystems IRIS-plattformen en «åpen kontur» og betyr ikke «plattformslaveri» for brukerne.
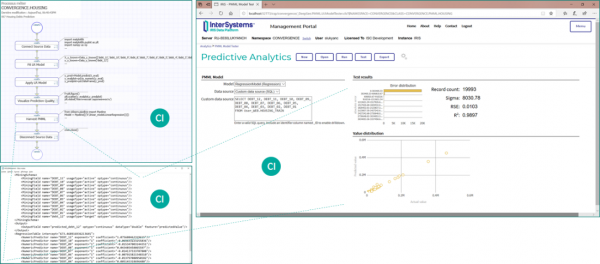
Figur 20 Integrasjon av «auto-ML» i AI/ML-løsningen på InterSystems IRIS-plattformen
La oss liste opp flere plattformfordeler ved InterSystems IRIS (for klarhet, relatert til styring av teknologiske prosesser), som er svært viktige ved automatisering av kunstig intelligens og maskinlæring i sanntid:
- Avanserte integrasjonsverktøy med alle kilder og forbrukere av data (DCS/SCADA, utstyr, vedlikehold, ERP osv.)
- Innebygd for high-performance hybrid transaction/analytical processing (HTAP) of any volume of technological process data
- Development tools for continuous deployment of AI/ML real-time solutions based on Python, R, Julia
- Adaptive business processes for continuous integration and (self-)learning of AI/ML real-time solutions
- Embedded Business Intelligence tools for data visualization of technological processes and results of AI/ML solutions
- to deliver the results of AI/ML solutions to automated control systems/SCADA, information-analytical systems, alert distributions, etc.
AI/ML solutions on the InterSystems IRIS platform easily integrate into existing IT infrastructures. The InterSystems IRIS platform ensures high reliability for AI/ML solutions by supporting fault-tolerant and disaster-resistant configurations and flexible deployment in virtual environments, physical servers, private and public clouds, and Docker containers.
Thus, InterSystems IRIS is a universal platform for real-time AI/ML computing. The versatility of our platform is practically confirmed by the absence of de facto limits on the complexity of implementable computations, with InterSystems IRIS able to concurrently (in real-time) process scenarios from various industries, and its exceptional adaptability to any functions and mechanisms of the platform to meet specific user needs.
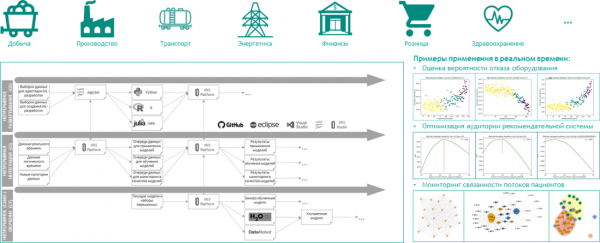
Figure 21 InterSystems IRIS — a universal platform for real-time AI/ML computing
For a more substantive interaction with those among our readers who are interested in the material presented here, we recommend not to limit yourself to just reading it and to continue the dialogue in person. We are ready to assist in formulating real-time AI/ML scenarios specific to your company, conduct joint prototyping on the InterSystems IRIS platform, and create and implement a roadmap for integrating artificial intelligence and machine learning into your production and management processes. The contact email address of our AI/ML expert group is .
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish