

Obs. overs.: tilpassingen av Kubernetes i GitLab anses for å være en av to hovedfaktorer som bidrar til selskapets vekst. Likevel, frem til nylig var infrastrukturen for nettjenesten GitLab.com bygget på virtuelle maskiner, og migreringen til K8s begynte først for omtrent ett år siden og er fortsatt ikke fullført. Vi er glade for å presentere oversettelsen av en nylig artikkel fra SRE-ingeniøren i GitLab om hvordan dette foregår og hvilke konklusjoner ingeniørene som deltar i prosjektet gjør.
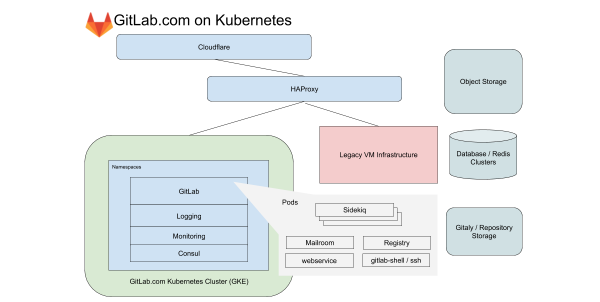
I omtrent ett år har vår infrastrukturavdeling arbeidet med å migrere alle tjenestene som kjører på GitLab.com til Kubernetes. I løpet av denne tiden har vi stiftet bekjentskap med problemer knyttet til ikke bare flyttingen av tjenestene til Kubernetes, men også til å administrere hybrid deployment under overgangen. Dette innlegget handler om de verdifulle lærdommene vi har fått.
Fra starten av har serverne på GitLab.com jobbet i skyen på virtuelle maskiner. Disse virtuelle maskinene administreres av Chef, og installasjonen skjer ved hjelp av vår . i tilfelle oppdateringer av applikasjonen, består i å oppdatere serverparken på en koordinert, sekvensiell måte ved hjelp av CI-pipeline. Denne metoden — selv om den er litt treigere og kanskje — garanterer at GitLab.com bruker de samme installasjons- og konfigureringsmetodene som brukerne av selvadministrerte (self-managed) GitLab-installasjoner bruker våre Linux-pakker for dette.
Vi bruker denne metoden fordi det er ekstremt viktig å oppleve alle gledene og utfordringene som vanlige medlemmer av fellesskapet opplever når de installerer og konfigurerer sine versjoner av GitLab. Denne tilnærmingen har fungert godt en stund, men da antallet prosjekter på GitLab passerte 10 millioner, innså vi at den ikke lenger tilfredsstilte våre behov for skalering og utrulling.
Første skritt mot Kubernetes og cloud-native GitLab
I 2017 ble prosjektet for preparing GitLab for deployment in the cloud, as well as to give users the ability to install GitLab in Kubernetes clusters. At that time, we knew that migrating GitLab to Kubernetes would enhance the scalability of our SaaS platform, simplify deployments, and improve the efficiency of resource utilization. At the same time, many features of our application relied on mounted NFS partitions, which slowed the transition from virtual machines.
The push towards cloud native and Kubernetes enabled our engineers to plan a gradual transition, during which we eliminated some of the application's dependencies on network storage, all while continuing to develop new features. Since we began planning the migration in the summer of 2019, many of these constraints have been removed, and the process of moving GitLab.com to Kubernetes is now in full swing!
Features of GitLab.com operating in Kubernetes
For GitLab.com, we use a single regional GKE cluster that handles all application traffic. To minimize the complexity of the already intricate migration, we focus on services that are not dependent on local storage or NFS. GitLab.com primarily uses a monolithic Rails codebase, and we direct traffic based on workload characteristics to various endpoints, isolated into their own node pools.
In the case of the frontend, these types are divided into requests to web, API, Git SSH/HTTPS, and Registry. For the backend, we break down jobs in the queues based on various characteristics depending on , allowing us to set Service-Level Objectives (SLOs) for different loads.
All these services on GitLab.com are configured using the unmodified GitLab Helm chart. Configuration is done in subcharts, which can be selectively included as we gradually move services into the cluster. Even considering the decision not to include some of our stateful services, such as Redis, Postgres, GitLab Pages, and Gitaly, using Kubernetes allows for a radical reduction in the number of VMs currently managed by Chef.
Transparency and configuration management of Kubernetes
Alle innstillinger styres av GitLab selv. For dette benyttes tre konfigurasjonsprosjekter basert på Terraform og Helm. Vi prøver overalt å bruke GitLab for å kjøre GitLab, men for driftsoppgaver har vi en separat GitLab-installasjon. Denne er nødvendig for å unngå avhengighet av tilgjengeligheten til GitLab.com ved distribusjoner og oppdateringer av GitLab.com.
Selv om våre pipelines for Kubernetes-klyngen kjører på en separat GitLab-installasjon, finnes det speil av kode-repoene, offentlig tilgjengelig på følgende adresser:
- — konfigurasjonsinnpakning for GitLab.com for Helm-diagrammet til GitLab;
- — inneholder konfigurasjoner for tjenester som ikke er direkte relatert til applikasjonen GitLab. Blant disse er konfigurasjoner for loggføring og overvåking av klyngen, samt for integrerte verktøy som PlantUML;
- — Terraform-konfigurasjon for Kubernetes og gammel (legacy) VM-infrastruktur. Her konfigureres alle ressursene som trengs for å kjøre klyngen, inkludert selve klyngen, nodepuljer, tjenestekontoer, reservasjon av IP-adresser.

Ved endringer vises et offentlig med en lenke til en detaljert diff, som SRE analyserer før endringer gjøres i klyngen.
For SRE fører lenken til en detaljert diff i GitLab-installasjonen som brukes til drift, og tilgangen til denne er begrenset. Dette gjør at ansatte og samfunnet uten tilgang til det driftsprosjektet (som kun er åpent for SRE) kan se de foreslåtte endringene i konfigurasjonen. Ved å kombinere en offentlig GitLab-instans for kode med en lukket instans for CI-pipelines, opprettholder vi en enhetlig arbeidsflyt, samtidig som vi garanterer uavhengighet fra GitLab.com ved oppdateringer av konfigurasjonen.
Hva vi har lært under migreringen
I løpet av flyttingen har vi samlet erfaring som vi bruker på nye migreringer og distribusjoner i Kubernetes.
1. Økte kostnader på grunn av trafikk mellom tilgjengelighetssoner
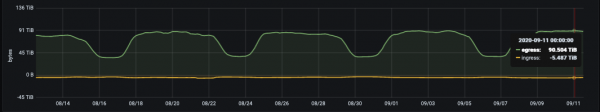
Daglig egress-statistikk (bytes per dag) for Git-repositorier på GitLab.com
Google deler sitt nettverk i regioner. Disse deler seg videre inn i tilgjengelighetssoner (AZ). Git-hosting er forbundet med store datamengder, så det er viktig for oss å kontrollere nettverks egress. I tilfelle intern trafikk er egress gratis bare hvis det forblir innenfor en enkelt tilgjengelighetssone. På tidspunktet for skrivingen av denne artikkelen gir vi bort omtrent 100 TB data på en vanlig arbeidsdag (og dette er kun for Git-repositorier). Tjenester som i vår gamle VM-baserte topologi var lokalisert på de samme virtuelle maskinene, kjører nå på forskjellige pod’er i Kubernetes. Dette betyr at noe av trafikken som tidligere var lokal for VM, potensielt kan gå utenfor tilgjengelighetssonene.
Regionale GKE-klynger tillater dekning i flere tilgjengelighetssoner for redundans. Vi vurderer muligheten for tjenester som genererer store mengder trafikk. Dette vil redusere kostnader for egress samtidig som vi opprettholder redundans på klyngenivå.
2. Begrensninger, ressursforespørsel og skalering
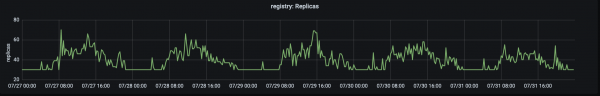
Antall replikater som håndterer produksjonstrafikk på registry.gitlab.com. Trafikken når sitt høydepunkt rundt kl. 15:00 UTC.
Vår historie med migrering startet i august 2019, da vi flyttet den første tjenesten — GitLab Container Registry — til Kubernetes. Denne kritisk viktige tjenesten med høy trafikk var godt egnet for den første migreringen, ettersom den er en stateless-applikasjon med få eksterne avhengigheter. Det første problemet vi møtte var det høye antallet utslåtte pod’er på grunn av minnemangel på nodene. Dette førte til at vi måtte justere forespørslene og begrensningene.
Det ble oppdaget at i tilfelle av en applikasjon hvis minneforbruk voks over tid, førte lave verdier for forespørslene (som reserverer minne for hver pod) i kombinasjon med en "sjenerøs" hard begrensning på bruken til å føre til metning (saturation) på nodene og høy utslutningsrate. For å håndtere dette problemet ble det Dette lettet presset på nodene og sikret en levetid for pod'er som ikke la for stort press på noden. Nå begynner vi migrasjoner med sjenerøse (og nesten like) verdier for forespørslene og begrensningene, og justerer dem etter behov.
3. Metrier og logger
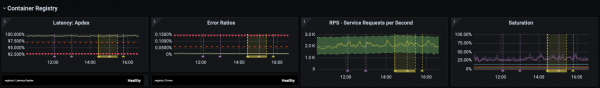
Infrastrukturavdelingen fokuserer på forsinkelser, feilprosent og metning i forhold til satte (SLO), knyttet til .
Det siste året har en av de viktigste hendelsene i infrastrukturavdelingen vært forbedringer i overvåking og håndtering av SLO. SLO har gjort det mulig for oss å sette mål for individuelle tjenester, som vi fulgte nøye med på under migrasjonen. Men selv med denne forbedrede observabiliteten er det ikke alltid mulig å umiddelbart se problemer, ved hjelp av metrier og alarmer. For eksempel, ved å fokusere på forsinkelser og feilprosent, dekker vi ikke alltid alle bruks-scenariene for tjenesten som migrerer.
Dette problemet ble oppdaget nesten umiddelbart etter overføringen av deler av arbeidsbelastningen til klyngen. Det kom særlig tydelig frem når vi måtte teste funksjoner, der antallet forespørselene er lite, men hvor konfigurasjonsavhengighetene er svært spesifikke. En av hovedlære fra migrasjonen ble nødvendigheten av å ta hensyn til både metrier og logger samt den «lange halen» (det handler om på grafen – anm. oversetter) av feil. Nå for hver migrasjon inkluderer vi en detaljert liste over forespørslene til logger (log queries) og planlegger klare tilbaketrekningsprosedyrer som i tilfelle problemer kan overføres fra en vakt til en annen.
Parallelt vedlikehold av de samme forespørslene på den gamle VM-infrastrukturen og den nye, basert på Kubernetes, utgjorde en unik utfordring. I motsetning til lift-and-shift-migrasjon (rask overføring av applikasjoner «som de er» til ny infrastruktur; mer informasjon kan leses om for eksempel, – obs. overs.), parallell drift på «gamle» VM-er og Kubernetes krever at overvåkingsverktøyene er kompatible med begge miljøene og kan samle metrikker i én visning. Det er viktig at vi bruker de samme dashbordene og loggforespørslene for å oppnå konsistent observabilitet i overgangsperioden.
4. Bytte av trafikk til ny klynge
For GitLab.com er deler av serverne dedikert til . Kanariparken betjener våre interne prosjekter, men kan også . Men først og fremst er den ment for å teste endringer som gjøres i infrastrukturen og applikasjonen. Den første overførte tjenesten begynte med å motta et begrenset volum internt trafikk, og vi fortsetter å bruke denne metoden for å sikre at SLO-en overholdes før vi sender all trafikk til klyngen.
I tilfelle av migrering betyr dette at forespørslene først sendes til interne prosjekter i Kubernetes, og deretter gradvis omdirigerer vi resten av trafikken til klyngen ved å endre vekten for backend-en via HAProxy. I prosessen med å gå fra VM til Kubernetes ble det klart at det er veldig fordelaktig å ha en enkel metode for å omdirigere trafikken mellom det gamle og det nye infrastrukturen, og dermed holde den gamle infrastrukturen klar for tilbaketrekking de første dagene etter migreringen.
5. Reservekapasitet for pod-er og deres bruk
Nesten umiddelbart ble følgende problem identifisert: pod-er for Registry-tjenesten startet raskt, men oppstart av pod-er for Sidekiq tok opptil . Den langvarige oppstarten av pod-er for Sidekiq ble et problem da vi begynte migreringen av arbeidsbelastninger for arbeidere i Kubernetes som må behandle jobber raskt og skalere raskt.
I dette tilfellet var lærdommen at selv om Horizontal Pod Autoscaler (HPA) i Kubernetes håndterer økningen i trafikken godt, er det viktig å ta hensyn til egenskapene til arbeidsbelastningene og fordele reservekapasiteten for pod-er (spesielt under forhold med ujevn etterspørsel). I vårt tilfelle var det en plutselig bølge av jobber som førte til rask skalering, noe som resulterte i at CPU-ressursene ble mettet før vi kunne skalere node-poolen.
Det er alltid fristende å «presse» så mye som mulig ut av klyngen, men vi, som først ble konfrontert med ytelsesproblemer, begynner nå med et sjenerøst pod-budsjett og reduserer det etter hvert, mens vi nøye følger med på SLO. Oppstart av pod-er for Sidekiq-tjenesten har blitt betydelig raskere og tar nå i gjennomsnitt rundt 40 sekunder. har både GitLab.com og våre brukere av selvadministrerte installasjoner, som bruker den offisielle Helm-diagrammet til GitLab, hatt fordel.
Konklusjon
Etter overføringen av hver tjeneste har vi gledet oss over fordelene ved å bruke Kubernetes i produksjon: raskere og sikrere distribusjon av applikasjoner, skalerbarhet og mer effektiv ressursfordeling. Fordelene ved migrering går nemlig utover GitLab.com-tjenesten. Brukerne av den offisielle Helm-diagrammet drar også nytte av hver forbedring.
Jeg håper du likte historien om våre eventyr med migrering til Kubernetes. Vi fortsetter å flytte flere tjenester inn i klyngen. Ytterligere informasjon kan finnes i følgende publikasjoner:
- «»;
- «»;
- .
P.S. from the translator
Also read in our blog:
- «»;
- «»;
- «»;
- «».
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish