

I dag blir det ingen kompliserte saker eller innviklede algoritmer i SQL. Alt blir veldig enkelt, på nivå med Kaptein Åpenbaring — vi gjør visningen av hendelsesregisteret sortert etter tid.
Det vil si, vi har en tabell i databasen events, og den har feltet ts — akkurat det tidspunktet vi vil vise disse postene i rekkefølge:
CREATE TABLE events(
  id
    serial
      PRIMARY KEY
, ts
    timestamp
, data
    json
);

CREATE INDEX ON events(ts DESC);
Det er klart at vi ikke bare har ti poster, så vi trenger på en eller annen måte paginering.
#0. «Я у мамы погроммист»
cur.execute("SELECT * FROM events;")
rows = cur.fetchall();
rows.sort(key=lambda row: row.ts, reverse=True);
limit = 26
print(rows[offset:offset+limit]);
Det er nesten ikke en spøk — sjeldent, men det skjer i naturen. Noen ganger kan det være vanskelig å omstille seg fra ORM til "direkte" arbeid med SQL.
Men la oss gå videre til mer vanlige og mindre åpenbare problemer.
#1. OFFSET
SELECT
  ...
FROM
  events
ORDER BY
  ts DESC
LIMIT 26 OFFSET $1; -- 26 - poster på siden, $1 - start på siden
Hvor kom dette tallet 26 fra? Det er et omtrentlig antall poster for å fylle én skjerm. Nærmere bestemt, 25 synlige poster, pluss 1 som indikerer at det er flere poster i utvalget og det er fornuftig å gå videre.
Selvfølgelig kan dette tallet ikke "hardkodes" i spørringen, men sendes som et parameter. Men i dette tilfellet vil PostgreSQL-planleggeren ikke kunne stole på bekjentskapet av at det burde være relativt få poster, og dermed velge en ineffektiv plan.
Og mens visningen av hendelsesregisteret i applikasjonsgrensesnittet er implementert som veksling mellom visuelle "sider", vil ingen legge merke til noe mistenkelig lenge. Fram til øyeblikket når man i kampen for UI/UX-behag beslutter å redesigne grensesnittet til «uendelig scrolling» — dvs. at alle postene i registeret vises som én liste som brukeren kan skrolle opp og ned.
Og ved neste testing vil dere bli tatt på duplisering av poster i registeret. Hvorfor, for det er det et normalt indeks på tabellen (ts), som forespørselen deres er avhengig av?
Fordi dere ikke har tatt høyde for at ts ikke er en unik nøkkel i denne tabellen. Egentlig er heller ikke verdiene unike, som for enhver «tid» i virkelige forhold — derfor kan den samme posten i to naboforekomster lett «hoppe» fra side til side på grunn av en annen endelig rekkefølge innen sorteringen av den samme verdien av nøkkelen.
Egentlig skjuler det seg også et annet problem her, som er mye vanskeligere å legge merke til — noen poster vil ikke bli vist i det hele tatt! For «dupliserte» poster har tatt plassen til noen. En detaljert forklaring med fine bilder kan .
Utvid indeksen
Den kloke utvikleren forstår — man må gjøre nøkkelen til indeksen unik, og den enkleste måten — er å utvide den med et beviselig unikt felt som PK passer utmerket til:
CREATE UNIQUE INDEX ON events(ts DESC, id DESC);Og spørringen muterer:
SELECT
  ...
ORDER BY
  ts DESC, id DESC
LIMIT 26 OFFSET $1;
#2. Переход на «курсоры»
Noe tid senere kommer DBA-en til deg og «gleder» deg med at spørringene dine , og generelt, det er på tide å gå over til navigasjon fra den sist viste verdien. Spørringen din muterer igjen:
SELECT
  ...
WHERE
  (ts, id) < ($1, $2) -- de siste verdiene mottatt i forrige trinn
ORDER BY
  ts DESC, id DESC
LIMIT 26;
Du pustet lettet ut, inntil det skjedde…
#3. Чистка индексов
Fordi en dag leste DBA-en din og forsto at et «ikke-sist» tidsstempel — er ikke bra. Og igjen kom han til deg — nå med tanken om at den indeksen burde egentlig bli tilbake til (ts DESC).
Men hva skal man gjøre med det opprinnelige problemet med «hopping» av poster mellom sider?.. Alt er enkelt — man må velge blokker med et ikke-fast antall poster!
Generelt, hvem forbyr oss å lese ikke «nøyaktig 26», men «minst 26»? For eksempel slik at neste blokk inneholder poster med beviselig andre verdier ts — da vil det jo ikke være problemer med «hopping» av poster mellom blokkene!
Slik kan dette oppnås:
SELECT
  ...
WHERE
  ts = coalesce((
    SELECT
      ts
    FROM
      events
    WHERE
      ts < $1
    ORDER BY
      ts DESC
    LIMIT 1 OFFSET 25
  ), '-infinity')
ORDER BY
  ts DESC;
Hva skjer egentlig her?
- Vi går ned 25 poster og får «grenseverdien»
ts. - Hvis det ikke er noe der lenger, erstatter vi NULL-verdien med
-infinity. - Vi trekker hele segmentet av verdier mellom den oppnådde verdien
tsog parameteren $1 (den forrige «siste» viste verdien) som ble sendt fra grensesnittet. - Hvis blokken har færre enn 26 poster, er den den siste.
Eller det samme med bilde:
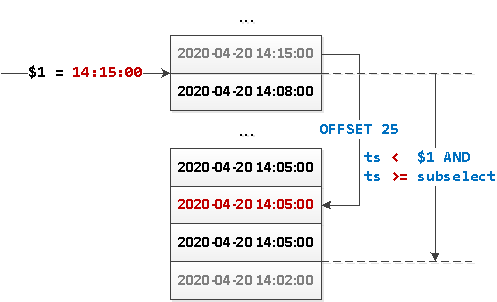
Siden vi nå har utvalget har ikke noe bestemt «begynnelse», så er det ingenting som hindrer oss i å «utvide» denne forespørselen bakover og implementere dynamisk innlasting av datablokker fra «referansepunktet» i begge retninger – både nedover og oppover.
Kommentar
- Ja, i så fall henvender vi oss til indeksen to ganger, men alt er «rent per indeks». Derfor vil et innebygd spørsmål føre til bare en ekstra Index Only Scan.
- Det er ganske tydelig at denne metoden bare kan brukes når du har verdier
tskan bare krysse hverandre tilfeldig, og de er få. Hvis din typiske situasjon er «en million poster på 00:00:00.000», bør du unngå å gjøre det. Jeg mener, du bør ikke tillate en slik situasjon. Men hvis det allerede har skjedd, bruk alternativet med utvidet indeks.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish