

Tidsseriedatabasen (TSDB, time series database) i Prometheus 2 er et glimrende eksempel på en ingeniørløsning som tilbyr betydelige forbedringer sammenlignet med lagringen i v2 i Prometheus 1, når det gjelder hastighet på datainnsamling og forespørselsgjennomføring, samt ressursutnyttelse. Vi implementerte Prometheus 2 i Percona Monitoring and Management (PMM), og jeg fikk muligheten til å undersøke ytelsen til Prometheus 2 TSDB. I denne artikkelen vil jeg dele resultatene av disse observasjonene.
Gjennomsnittlig arbeidsbelastning for Prometheus
For de som er vant til å jobbe med hoveddatabaser, er den vanlige arbeidsbelastningen i Prometheus ganske interessant. Hastigheten på datainnsamlingen tenderer mot en stabil verdi: vanlige tjenester som du overvåker sender omtrent den samme mengden målinger, og infrastrukturen endres relativt sakte.
Informasjonsforespørslene kan komme fra forskjellige kilder. Noen av dem, som alarmer, tenderer også mot en stabil og forutsigbar verdi. Andre, som brukerforespørslene, kan forårsake topper, selv om dette ikke er karakteristisk for størstedelen av belastningen.
Belastningstest
Under testing fokuserte jeg på evnen til å samle inn data. Jeg rullet ut Prometheus 2.3.2, kompilert med Go 1.10.1 (som en del av PMM 1.14) på en Linode-tjeneste, ved hjelp av dette skriptet: . For å generere belastningen mest realistisk, ved hjelp av dette kjørte jeg flere MySQL-noder med realistisk belastning (Sysbench TPC-C Test), der hver av dem simulerte 10 Linux/MySQL-noder.
Alle de følgende testene ble utført på en Linode-server med åtte virtuelle kjerner og 32 GB minne, hvor 20 belastningssimuleringer overvåket to hundre MySQL-instansér. Eller, i termer av Prometheus, 800 mål, 440 innsamlinger per sekund, 380 000 registreringer per sekund og 1,7 millioner aktive tidsserier.
Design
Den vanlige tilnærmingen til tradisjonelle databaser, inkludert den som ble brukt i Prometheus 1.x, er . Hvis den ikke er tilstrekkelig til å håndtere belastningen, vil du oppleve store forsinkelser, og noen forespørslene vil ikke bli utført. Minnebruken i Prometheus 2 konfigureres via nøkkelen storage.tsdb.min-block-duration, som definerer hvor lenge opptegnelser vil bli lagret i minnet før de blir tømt til disk (standard er 2 timer). Mengden nødvendig minne vil avhenge av antall tidsserier, etiketter (labels) og intensiteten av datainnsamlingen (scrapes) pluss den rene inndataflyten. Når det gjelder diskplass, streber Prometheus etter å bruke 3 byte per opptegnelse (sample). På den annen side er minnekravene mye høyere.
Selv om det er mulighet for å konfigurere blokkstørrelsen, anbefales det ikke å justere den manuelt, så du er nødt til å gi Prometheus så mye minne som det ber om for belastningen din.
Hvis det ikke er nok minne til å opprettholde den innkommende strømmen av metrikker, vil Prometheus krasje med out of memory, eller OOM killer vil nå det.
Å legge til swap for å utsette krasj når Prometheus går tom for minne hjelper ikke mye, fordi bruken av denne funksjonen fører til eksplosiv minneforbruk. Jeg tror det har å gjøre med Go, garbage collector, og hvordan det fungerer med swap.
En annen interessant tilnærming ser ut til å være å konfigurere tømming av head block til disk på bestemte tidspunkter, i stedet for å telletiden fra prosessens oppstart.
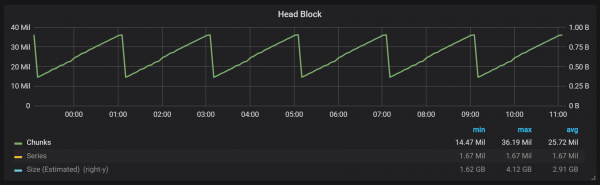
Som du kan se fra diagrammet, skjer tømningene på disk hver annen time. Hvis du endrer parameteren min-block-duration til en time, vil disse tømningene skje hver time, begynner etter en halvtime.
Hvis du ønsker å bruke dette og andre diagrammer i din Prometheus-installasjon, kan du bruke denne . Den ble utviklet for PMM, men med noen små justeringer passer den til enhver Prometheus-installasjon.
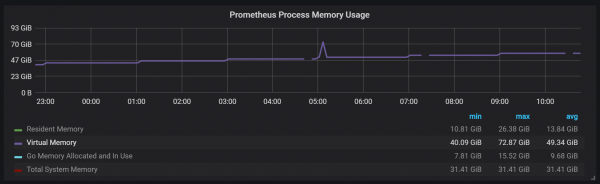
Vi har et aktivt blokk, kalt head block, som lagres i minnet; blokkene med eldre data er tilgjengelige gjennom mmap(). Dette fjerner behovet for å konfigurere hurtigbufret separat, men betyr også at du må la nok plass være tilgjengelig for OS-hurtigbufferet hvis du vil gjøre forespørsel om data eldre enn det head block kan håndtere.
Og dette betyr også at Prometheus sitt forbruk av virtuell minne vil se ganske høyt ut, noe som ikke bør bekymre deg.
En annen interessant designaspekt er bruken av WAL (write ahead log). Som beskrevet i lagringsdokumentasjonen, bruker Prometheus WAL for å unngå datatap ved krasj. De spesifikke mekanismene for dataintegritet er dessverre ikke tilstrekkelig dokumentert. Versjon 2.3.2 av Prometheus skriver WAL til disk hvert 10. sekund, og dette kan ikke konfigureres av brukeren.
Kompaksjoner (Compactions)
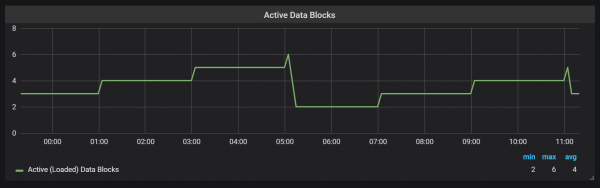
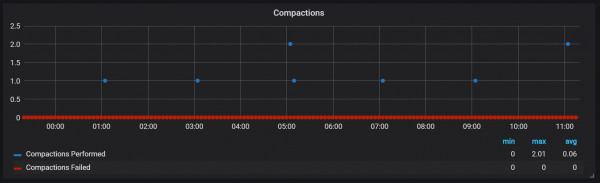
Prometheus TSDB er designet etter modellen til LSM-lagring (Log Structured Merge): head block skrives periodisk til disk, samtidig som kompresjonsmekanismen kombinerer flere blokker for å unngå skanning av for mange blokker under forespørslene. Her kan man se antall blokker som jeg har observert på testsystemet etter et døgns belastning.
Hvis du ønsker å lære mer om lagringen, kan du utforske filen meta.json, som inneholder informasjon om de tilgjengelige blokkene og hvordan de ble opprettet.
{
       "ulid": "01CPZDPD1D9R019JS87TPV5MPE",
       "minTime": 1536472800000,
       "maxTime": 1536494400000,
       "stats": {
               "numSamples": 8292128378,
               "numSeries": 1673622,
               "numChunks": 69528220
       },
       "compaction": {
               "level": 2,
               "sources": [
                       "01CPYRY9MS465Y5ETM3SXFBV7X",
                       "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                       "01CPZ6NR4Q3PDP3E57HEH760XS"
               ],
               "parents": [
                       {
                               "ulid": "01CPYRY9MS465Y5ETM3SXFBV7X",
                               "minTime": 1536472800000,
                               "maxTime": 1536480000000
                       },
                       {
                               "ulid": "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                               "minTime": 1536480000000,
                               "maxTime": 1536487200000
                       },
                       {
                               "ulid": "01CPZ6NR4Q3PDP3E57HEH760XS",
                               "minTime": 1536487200000,
                               "maxTime": 1536494400000
                       }
               ]
       },
       "version": 1
}
Kompaksjoner i Prometheus er knyttet til tidspunktet for utskrift av head block til disk. På dette tidspunktet kan flere slike operasjoner foregå.
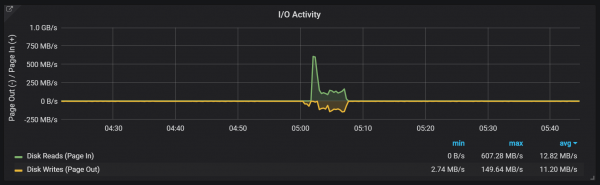
Det ser ut til at komprimeringen ikke er begrenset på noen måte og kan forårsake store svingninger i disk I/O under operasjon.
Svingninger i CPU-belastning
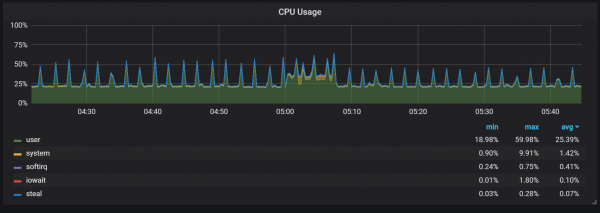
Selvfølgelig har dette ganske negative konsekvenser for systemets hastighet, og det er også en betydelig utfordring for LSM-lagre: hvordan komprimere for å opprettholde høy forespørselshastighet uten å forårsake for mye overhead?
Minnebruken under komprimeringsprosesser ser også ganske interessant ut.
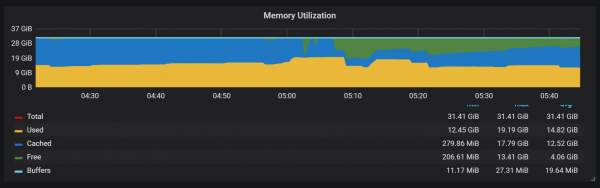
Vi kan se at etter komprimeringen skifter mesteparten av minnet fra Cached til Free: dette betyr at potensielt verdifull informasjon er blitt fjernet derfra. Det er interessant om det brukes en fadvice() eller en annen teknikk for minimering, eller om dette skyldes at cachen ble frigjort fra blokker som ble ødelagt under komprimeringen?
Gjenoppretting etter feil
Gjenoppretting etter feil tar tid, og det er berettiget. For en innkommende strøm på en million oppføringer per sekund måtte jeg vente i omtrent 25 minutter mens gjenopprettingen fant sted, med tanke på SSD-disk.
level=info ts=2018-09-13T13:38:14.09650965Z caller=main.go:222 msg="Starting Prometheus" version="(version=2.3.2, branch=v2.3.2, revision=71af5e29e815795e9dd14742ee7725682fa14b7b)"
level=info ts=2018-09-13T13:38:14.096599879Z caller=main.go:223 build_context="(go=go1.10.1, user=Jenkins, date=20180725-08:58:13OURCE)"
level=info ts=2018-09-13T13:38:14.096624109Z caller=main.go:224 host_details="(Linux 4.15.0-32-generic #35-Ubuntu SMP Fri Aug 10 17:58:07 UTC 2018 x86_64 1bee9e9b78cf (none))"
level=info ts=2018-09-13T13:38:14.096641396Z caller=main.go:225 fd_limits="(soft=1048576, hard=1048576)"
level=info ts=2018-09-13T13:38:14.097715256Z caller=web.go:415 component=web msg="Start listening for connections" address=:9090
level=info ts=2018-09-13T13:38:14.097400393Z caller=main.go:533 msg="Starting TSDB ..."
level=info ts=2018-09-13T13:38:14.098718401Z caller=repair.go:39 component=tsdb msg="found healthy block" mint=1536530400000 maxt=1536537600000 ulid=01CQ0FW3ME8Q5W2AN5F9CB7R0R
level=info ts=2018-09-13T13:38:14.100315658Z caller=web.go:467 component=web msg="router prefix" prefix=\/prometheus
level=info ts=2018-09-13T13:38:14.101793727Z caller=repair.go:39 component=tsdb msg="found healthy block" mint=1536732000000 maxt=1536753600000 ulid=01CQ78486TNX5QZTBF049PQHSM
level=info ts=2018-09-13T13:38:14.102267346Z caller=repair.go:39 component=tsdb msg="found healthy block" mint=1536537600000 maxt=1536732000000 ulid=01CQ78DE7HSQK0C0F5AZ46YGF0
level=info ts=2018-09-13T13:38:14.102660295Z caller=repair.go:39 component=tsdb msg="found healthy block" mint=1536775200000 maxt=1536782400000 ulid=01CQ7SAT4RM21Y0PT5GNSS146Q
level=info ts=2018-09-13T13:38:14.103075885Z caller=repair.go:39 component=tsdb msg="found healthy block" mint=1536753600000 maxt=1536775200000 ulid=01CQ7SV8WJ3C2W5S3RTAHC2GHB
level=error ts=2018-09-13T14:05:18.208469169Z caller=wal.go:275 component=tsdb msg="WAL corruption detected; truncating" err="unexpected CRC32 checksum d0465484, want 0" file=\/opt\/prometheus\/data\/.prom2-data\/wal\/007357 pos=15504363
level=info ts=2018-09-13T14:05:19.471459777Z caller=main.go:543 msg="TSDB started"
level=info ts=2018-09-13T14:05:19.471604598Z caller=main.go:603 msg="Loading configuration file" filename=\/etc\/prometheus.yml
level=info ts=2018-09-13T14:05:19.499156711Z caller=main.go:629 msg="Completed loading of configuration file" filename=\/etc\/prometheus.yml
level=info ts=2018-09-13T14:05:19.499228186Z caller=main.go:502 msg="Server is ready to receive web requests."
Hovedproblemet med gjenopprettingsprosessen er høy minneforbruk. Selv om serveren under normale forhold kan kjøre stabilt med det samme minnevolumet, kan den ved et krasj ikke starte opp igjen på grunn av OOM. Den eneste løsningen jeg har funnet, er å deaktivere datainnsamlingen, starte serveren, la den gjenopprette seg, og så starte den på nytt med datainnsamlingen aktivert.
Oppvarming
En annen atferd å huske på under oppvarmingsprosessen er forholdet mellom lav ytelse og høyt ressursforbruk rett etter oppstart. Under noen, men ikke alle oppstarter, har jeg observert alvorlig belastning på CPU og minne.
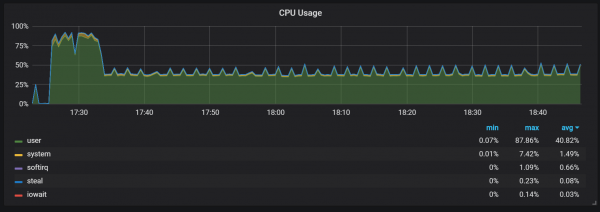
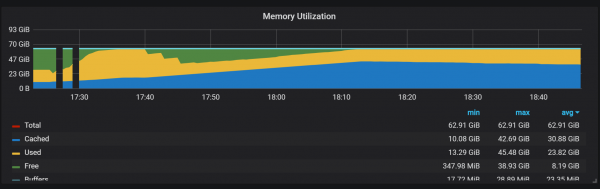
Hull i minnebruken tyder på at Prometheus ikke kan konfigurere alle innsamlinger fra starten av, og at noe informasjon går tapt.
Eg har ikkje finna dei nøyaktige årsakene til høg belastning på prosessor og minne. Eg mistenker at dette har med å lage nye tidsseriar i head-blokkar med høg frekvens å gjere.
Svingingar i CPU-belastning
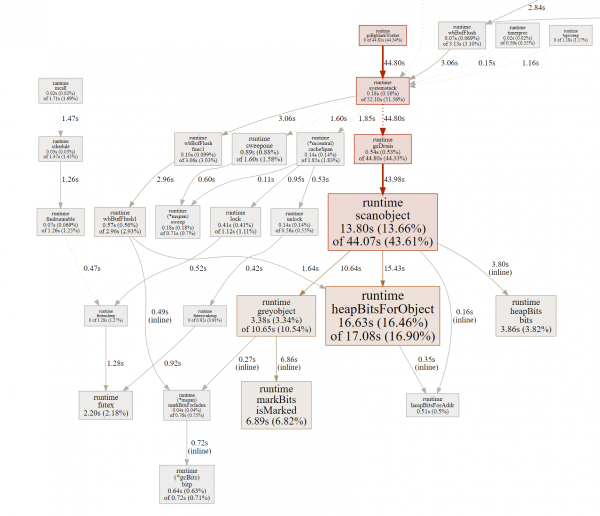
I tillegg til kompresjonane som skaper ganske høg I/O-belastning, har eg lagt merke til alvorlege svingingar i prosessorbelastninga kvart andre minutt. Utslag vart lengre ved høg innstrømming, og det ser ut til at dei er forårsaka av Go sitt søppeloppsamlarprogram, sjølv om nokre kjerner er heilt belastade.
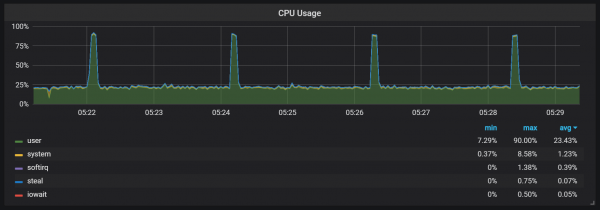
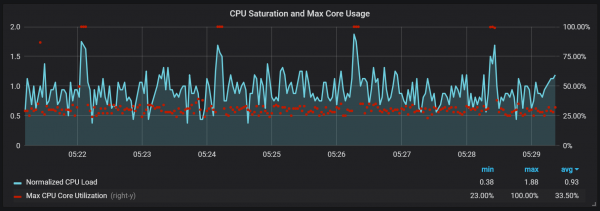
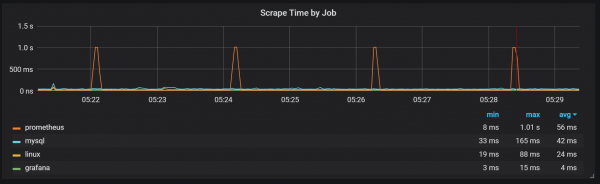
Desse svingingane er ikkje heilt ubetydelige. Det ser ut til at når dei oppstår, blir den interne inngangspunktet og Prometheus-metrikkane utilgjengelege, noko som fører til datamiss i desse tidsromma.
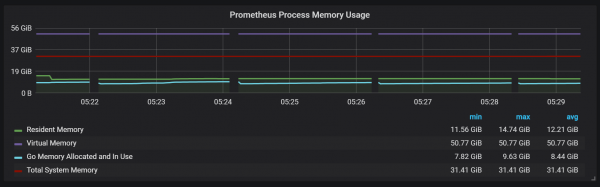
Det kan også observerast at Prometheus-eksportøren stopper i eit sekund.
Vi kan sjå korrelasjoner med søppeloppsamling (GC).
Konklusjon
TSDB i Prometheus 2 fungerer raskt, og er i stand til å handtere millionar av tidsseriar samtidig som det blir gjort tusenvis av skriv per sekund, med ganske beskjeden maskinvare. CPU- og disk I/O-bruken er også imponerande. Mitt eksempel viste opptil 200 000 metrikker per sekund på ein brukt kjerne.
For å planlegge ekspansjon må ein huske på tilstrekkeleg mengde minne, og dette bør vera faktisk minne. Mengda brukt minne som eg observerte, var om lag 5 GB for 100 000 skriv per sekund i innstrømming, noko som i kombinasjon med operativsystemsbufferen gav om lag 8 GB brukt minne.
Det er sjølvsagt mykje arbeid att for å temme svingningane i CPU og disk I/O, og det er ikkje overraskande, gitt korpass ung TSDB Prometheus 2 enno er samanlikna med InnoDB, TokuDB, RocksDB, WiredTiger, men alle desse hadde lignande problem i starten av livssyklusen.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish