

Hei, jeg er Dmitrij Logvineko – Data Engineer i analytikkavdelingen til konsernet «Vezot».
Jeg vil fortelle deg om et fantastisk verktøy for utvikling av ETL-prosesser – Apache Airflow. Men Airflow er så allsidig og mangfoldig at du bør vurdere det selv om du ikke jobber med dataflyt, men har behov for å kjøre visse prosesser med jevne mellomrom og overvåke deres utførelse.
Og ja, jeg vil ikke bare fortelle, men også vise: programmet inneholder mye kode, skjermbilder og anbefalinger.
Hva ser du vanligvis når du googler ordet Airflow / Wikimedia Commons
Innholdsfortegnelse
Innledning
Apache Airflow – det er akkurat som Django:
- skrevet i Python,
- har et utmerket administrasjonspanel,
- utvides uendelig,
– bare bedre, og laget for helt andre formål, nemlig (som skrevet før kat):
- kjøring og overvåking av oppgaver på et ubegrenset antall maskiner (så mange som Celery/Kubernetes og din samvittighet tillater)
- med dynamisk generering av arbeidsflyter fra ekstremt lettfattelig og skrivbar Python-kode
- og muligheten til å knytte sammen både databaser og API-er med hjelp av både ferdige komponenter og egendefinerte plugins (som er ekstremt enkelt å lage).
Vi bruker Apache Airflow slik:
- samler data fra ulike kilder (mange forekomster av SQL Server og PostgreSQL, forskjellige API-er med applikasjonsmetrikker, til og med 1C) i DWH og ODS (i vårt tilfelle Vertica og Clickhouse).
- som en avansert
cron, som kjører prosessene for datakonsolidering på ODS, samt overvåker deres vedlikehold.
Tidligere ble våre behov dekket av én liten server med 32 kjerner og 50 GB RAM. I Airflow fungerer derimot:
- over 200 DAG-er (de reelle arbeidsflytene hvor vi har fylt oppgaver),
- i hver av dem i gjennomsnitt 70 oppgaver,
- kjøres dette gode greiene (også i gjennomsnitt) en gang i timen.
Og om hvordan vi utvidet, vil jeg skrive nedenfor, men nå la oss definere über-oppgaven vi skal løse:
Det finnes tre SQL Servere, hver med 50 databaser – instanser av ett prosjekt, så de har nesten identisk struktur (for det meste, muahaha), og derfor har hver av dem en tabell kalt Orders (heldigvis kan du bruke en tabell med sånt navn i hvilken som helst virksomhet). Vi henter data og legger til hjelpefelt (kilde-server, kilde-database, ETL-oppgave-ID) og naivt kaster dem inn i, si, Vertica.
La oss gå!
Hoveddelen, praktisk (og litt teoretisk)
Hvorfor trenger vi det (og du også)
Da trærne var store og jeg var enkel SQL-er i en russisk detaljhandel, kjørte vi ETL-prosesser aka datastreams med hjelp av to verktøy vi hadde tilgjengelig:
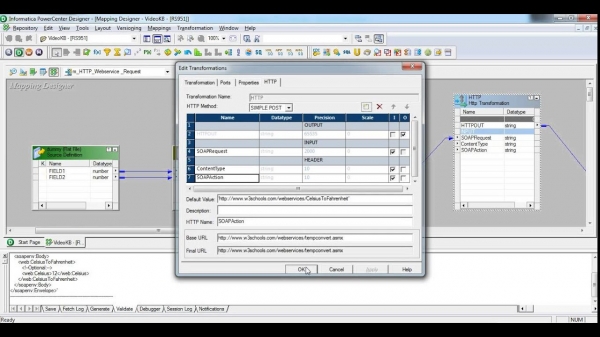
- Informatica Power Center — et ekstremt omfattende system, svært effektivt, med eget maskinvare og egen versjonering. Jeg brukte knapt 1% av dens muligheter. Hvorfor? Vel, for det første, dette grensesnittet er psykologisk anstrengende og føles som det er fra tidlig 2000-tallet. For det andre, denne tingen er laget for ekstremt komplekse prosesser, rasende gjenbruk av komponenter og andre viktige enterprise-funksjoner. Hva den koster? Den koster som en vinge av en Airbus A380 i året, men det sier vi ikke høyt.
Vær forsiktig, skjermbildet kan gjøre folk under 30 litt vondt.

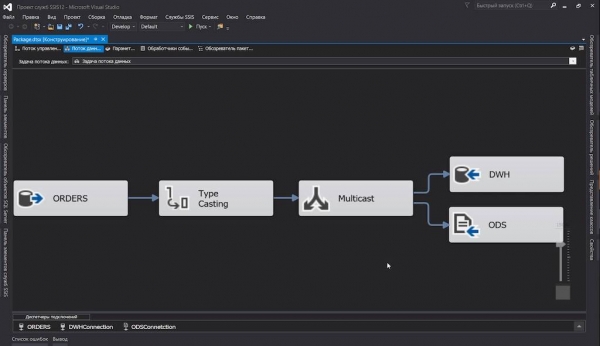
- SQL Server Integration Server — denne karen brukte vi i våre interne prosesser. For real: vi bruker allerede SQL Server, og å ikke bruke ETL-verktøyene deres ville vært uhensiktsmessig. Alt ved det er bra: grensesnittet er pent, og rapportene for utførelse… Men vi elsker ikke programvareprodukter for det, oh nei. Vi kan versjonere
dtsx(som er et XML-dokument med noder som blandes sammen ved lagring), men hva så? Å lage en oppgavepakke som kan flytte hundre tabeller fra én server til en annen? Hva med hundre, etter tjue stykker vil pekefingeren din falle av når du klikker på musen. Men det ser definitivt mer stilfullt ut:
Vi lette absolutt etter løsninger. Saken kom til og med så langt at vi laget en egen generator for SSIS-pakker… ingenting … og så fikk jeg ny jobb. Og her traff jeg Apache Airflow.
Da jeg fikk vite at beskrivelser av ETL-prosesser er enkel Python-kode, danset jeg nesten av glede. Slik ble datastreams versjonert og diffet, og å legge sammen tabeller med enhetlig struktur fra hundre databaser til ett mål ble til Python-kode på 13” skjermer.
Da eg fann ut at beskrivingar av ETL-prosessar er berre enkel Python-kode, dansa eg nærare glad. Slik vart datastreamar versjonert og diffast, og å samle tabellar med einingsstruktur frå hundre databasar til eitt mål er blitt eit spørsmål om Python-kode på 13" skjermar.
Samler en klynge
La oss ikke lage et barnehage, og ikke snakke om de helt åpenbare tingene, som installasjon av Airflow, den valgte databasen, Celery og andre saker beskrevet i dokumentene.
For at vi skal kunne begynne eksperimentene med det samme, har jeg skisset docker-compose.yml der:
- La oss heve selve Airflow: Scheduler, Webserver. Der vil også Flower kjøre for overvåkning av Celery-oppgaver (fordi den allerede er presset inn i
apache/airflow:1.10.10-python3.7, og vi har ikke noe imot det); - PostgreSQL, hvor Airflow vil skrive sin logg (planleggers data, ytelsesstatistikk osv.), mens Celery vil merke fullførte oppgaver;
- Redis, som vil fungere som oppgavebroker for Celery;
- Celery worker, som vil ta seg av selve utførelsen av oppgavene.
- I mappen
.\/dagsvil vi legge filene våre med beskrivelse av dags. De vil bli fanget opp automatisk, så det er ikke nødvendig å trekke hele stakken etter hver lille endring.
Noen steder er koden i eksemplene ikke fullstendig (for å unngå å overbelaste teksten), og noen ganger endres den i prosessen. Hele fungerende kodeeksempler kan ses i depotet. .
docker-compose.yml
version: '3.4'

x-airflow-config: &airflow-config
  AIRFLOW__CORE__DAGS_FOLDER: /dags
  AIRFLOW__CORE__EXECUTOR: CeleryExecutor
  AIRFLOW__CORE__FERNET_KEY: MJNz36Q8222VOQhBOmBROFrmeSxNOgTCMaVp2_HOtE0=
  AIRFLOW__CORE__HOSTNAME_CALLABLE: airflow.utils.net:get_host_ip_address
  AIRFLOW__CORE__SQL_ALCHEMY_CONN: postgres+psycopg2://airflow:airflow@airflow-db:5432/airflow

  AIRFLOW__CORE__PARALLELISM: 128
  AIRFLOW__CORE__DAG_CONCURRENCY: 16
  AIRFLOW__CORE__MAX_ACTIVE_RUNS_PER_DAG: 4
  AIRFLOW__CORE__LOAD_EXAMPLES: 'False'
  AIRFLOW__CORE__LOAD_DEFAULT_CONNECTIONS: 'False'

  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_RETRY: 'False'
  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_FAILURE: 'False'

  AIRFLOW__CELERY__BROKER_URL: redis://broker:6379/0
  AIRFLOW__CELERY__RESULT_BACKEND: db+postgresql://airflow:airflow@airflow-db/airflow

x-airflow-base: &airflow-base
  image: apache/airflow:1.10.10-python3.7
  entrypoint: /bin/bash
  restart: always
  volumes:
    - ./dags:/dags
    - ./requirements.txt:/requirements.txt

services:
  # Redis som en Celery broker
  broker:
    image: redis:6.0.5-alpine

  # Database for metadataen til Airflow
  airflow-db:
    image: postgres:10.13-alpine

    environment:
      - POSTGRES_USER=airflow
      - POSTGRES_PASSWORD=airflow
      - POSTGRES_DB=airflow

    volumes:
      - ./db:/var/lib/postgresql/data

  # Hovedbeholder med Airflow Webserver, Scheduler, Celery Flower
  airflow:
    <<: *airflow-base

    environment:
      <
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint initdb &&
          (/entrypoint webserver &) &&
          (/entrypoint flower &) &&
           /entrypoint scheduler"

    ports:
      # Celery Flower
      - 5555:5555
      # Airflow Webserver
      - 8080:8080

  # Celery worker, vil bli skalert med `--scale=n`
  worker:
    <<: *airflow-base

    environment:
      <
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint worker"

    depends_on:
      - airflow
      - airflow-db
      - broker
Merknader:
- I oppsettet av komposisjon har jeg i stor grad basert meg på det kjente bildet – sørg for å ta en titt. Kanskje du ikke trenger mer i livet.
- Alle Airflow-innstillinger er tilgjengelige ikke bare gjennom
airflow.cfg, men også via miljøvariabler (takk til utviklerne), noe jeg flittig har utnyttet. - Selvfølgelig er den ikke produksjonsklar: jeg har med vilje ikke satt opp hjerterytmer på beholderne, jeg har ikke tatt meg av sikkerheten. Men jeg har laget et minimum som passer for våre eksperimenter.
- Vær oppmerksom på at:
- Mappen med dags må være tilgjengelig både for planleggeren og arbeidsmennene.
- Det samme gjelder for alle tredjepartsbiblioteker — de må alle være installert på maskinene med planlegger og arbeidere.
Men nå er det enkelt:
$ docker-compose up --scale worker=3Når alt er oppe, kan man se på webgrensesnittene:
- Airflow:
- Flower:
Grunnleggende begreper
Hvis du ikke forstod noe av alle disse «dagene», her er en kort ordbok:
- Scheduler — den viktigste fyren i Airflow, som sørger for at robotene jobber, ikke menneskene: han overvåker tidsplanen, oppdaterer dager og kjører oppgaver.
Egentlig, i eldre versjoner, hadde han minneproblemer (nei, ikke amnesi, men minnelekkasjer) og i konfigurasjonene var det til og med en legacy-parameter
run_duration— intervallet for hans omstart. Men nå fungerer alt bra. - DAG (som også kalles «dag») — «rettet acyklisk graf», men en slik definisjon sier lite for de fleste, og det er i bunn og grunn en container for oppgaver som interagerer med hverandre (se under) eller en analog til Package i SSIS og Workflow i Informatica.
Foruten dager kan det også være subdager, men vi vil mest sannsynlig ikke komme oss dit.
- DAG Run — en initialisert dag, som har fått sin
execution_date. Dagrunninger av en dag kan godt kjøre samtidig (hvis du selvsagt har gjort oppgavene dine idempotente). - Operator — dette er biter av kode ansvarlig for å utføre en spesifikk handling. Det finnes tre typer operatører:
- action, som for eksempel vår favoritt
PythonOperator, som kan kjøre hvilken som helst (gyldig) Python-kode; - transfer, som frakter data fra ett sted til et annet, for eksempel,
MsSqlToHiveTransfer; - sensor vil tillate å reagere eller bremse videre utførelse av dagen inntil en bestemt hendelse inntreffer.
HttpSensorkan trekke fra den angitte endepunktet, og når den får det ønskede svaret, starte overføringenGoogleCloudStorageToS3Operator. Det nysgjerrige sinnet vil spørre: «hvorfor? For det er mulig å gjøre repetisjoner direkte i operatøren!» Men så, for ikke å tette opp oppgavepuljen med hengende operatører. Sensoren starter, sjekker, og dør til neste forsøk.
- action, som for eksempel vår favoritt
- Task — erklærte operatører uavhengig av type og knyttet til dagen oppgraderes til oppgave.
- Task instance — når generalplanleggeren beslutter at oppgavene bør sendes i kamp til utøverne-arbeidere (rett på stedet, hvis vi bruker
LocalExecutoreller til en ekstern node i tilfelle medCeleryExecutor), gir han dem en kontekst (dvs. et sett med variabler — kjøreparametere), utvikler kommando- eller forespørselsskabloner og plasserer dem i puljen.
Genererer oppgaver
Først vil vi definere den generelle planen for dagen, og deretter dykke mer og mer inn i detaljene, fordi vi anvender noen ikke-trivielle løsninger.
Så, i sin enkleste form vil en slik dag se slik ut:
fra datetime import timedelta, datetime

fra airflow import DAG
fra airflow.operators.python_operator import PythonOperator

fra commons.datasources import sql_server_ds

dag = DAG('orders',
          schedule_interval=timedelta(hours=6),
          start_date=datetime(2020, 7, 8, 0))

def workflow(**context):
    print(context)

for conn_id, schema in sql_server_ds:
    PythonOperator(
        task_id=schema,
        python_callable=workflow,
        provide_context=True,
        dag=dag)
La oss finne ut av dette:
- Først importerer vi de nødvendige biblioteken og noen andre ting;
sql_server_ds— erListe[namedtuple[str, str]]med navnene på tilkoblinger fra Airflow Connections og databasene vi skal hente tabellen vår fra;dager erklæringen av DAG-en vår, som må ligge iglobals(), ellers finner ikke Airflow den. Vi må også si til DAG-en:- at den heter
orders— dette navnet vil senere dukke opp i webgrensesnittet, - at den vil begynne å kjøre fra midnatt den 8. juli,
- og den bør kjøre omtrent hver sjette time (her kan de kule bruke
timedelta()til en strincron– for de mindre kule er det tillatt å bruke et uttrykk som0 0 0/6 ? * * *@dailyworkflow());
- at den heter
vil gjøre hovedarbeidet, men ikke nå. Nå skal vi bare logge konteksten vår.Og nå, litt magi med å opprette oppgaver:- vi går gjennom kildene våre;
- initializerer
- , som vil utføre vår tomme funksjon
PythonOperator. Husk å gi et unikt (innenfor DAG-en) navn på oppgaven og knytte selve DAG-en. Flaggetvil gjøre hovedarbeidet, men ikke nå. Nå skal vi bare logge konteksten vår.provide_contextvil i sin tur gi ekstra argumenter til funksjonen, som vi forsiktig samler med hjelp av**contextDet er alt for nå. Hva har vi fått:.
en ny DAG i webgrensesnittet,
- hundre og førtito oppgaver som vil bli kjørt parallelt (hvis Airflow, Celery og serverkraften tillater det).
- Vel, nesten fått det.
Hvem skal sette opp avhengighetene?
For å forenkle dette har jeg lagt inn
behandlingen docker-compose.yml på alle nodene. requirements.txt Nå setter vi i gang:
De grå firkantene er oppgaveinstanser behandlet av planleggeren.
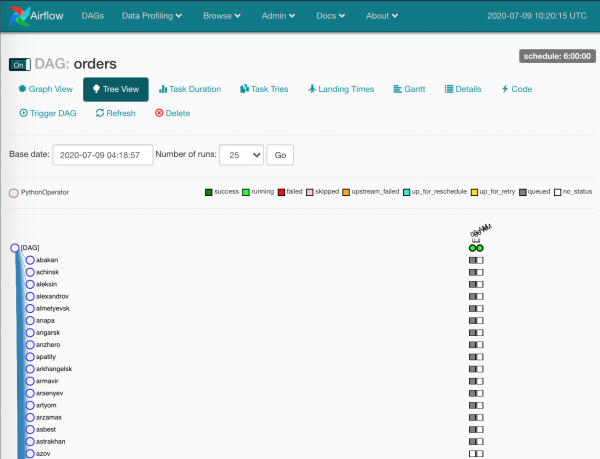
Vi venter litt, oppgavene blir plukket opp av arbeiderne:
De grønne, logisk nok, er de som har kjørt vellykket. De røde — ikke så vellykket.
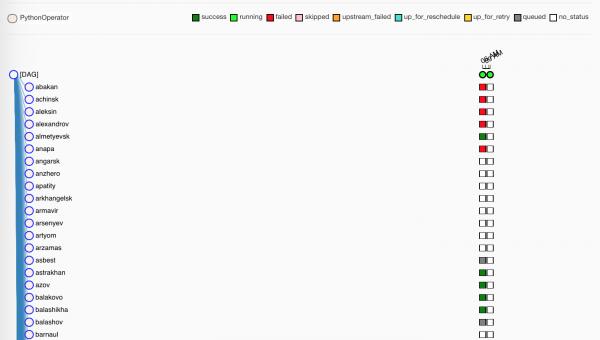
Forresten, på produksjonen vår finnes det ingen mappe
, som synkroniseres mellom maskinene — alle DAG-er ligger i
.\/dagspå vår Gitlab, og Gitlab CI distribuerer oppdateringene til maskinene ved sammenslåing igitMens arbeiderne jobber med oppgavene våre, la oss minnes et annet verktøy som kan gi oss noen innsikter — Flower.master.
Litt om Flower
Den aller første siden med oppsummerende informasjon om nodene-arbeidere:
Den mest innholdsrike siden med oppgavene som har blitt sendt til behandling:
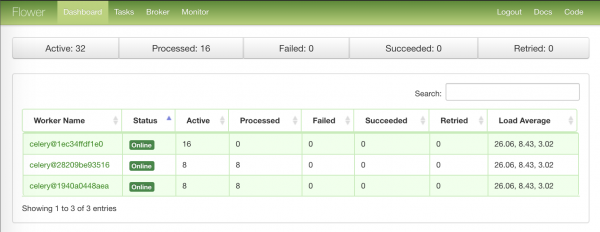
Den mest innhaldsrike sida med oppgåver som har sendt seg i arbeid:
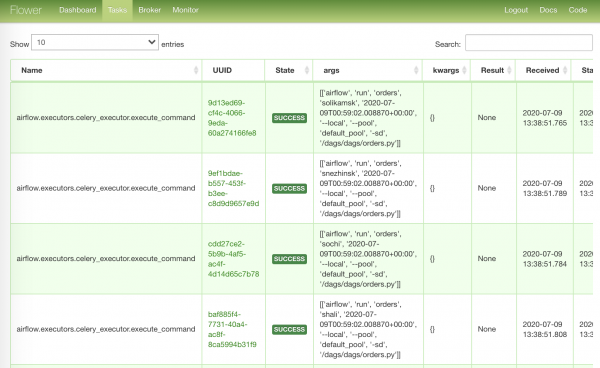
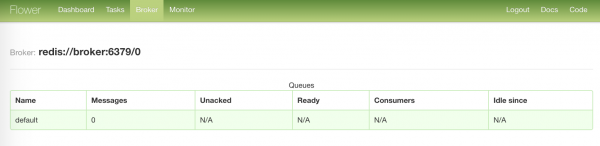
Den kjedeligste siden med status for megleren vår:
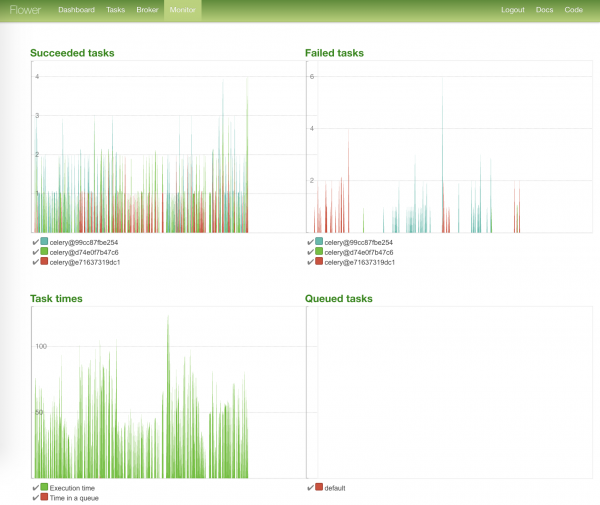
Den mest fargerike siden – med grafer over oppgave-status og deres utførelsestid:
Last opp det som ikke er lastet opp
Så, alle oppgavene har kjørt, vi kan ta med de skadde.
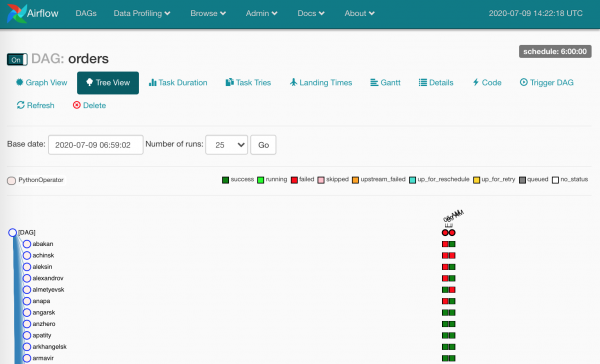
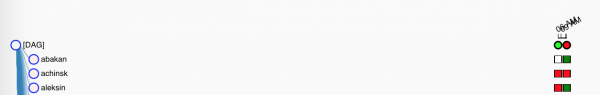
Det viste seg å være mange skadde – av ulike grunner. Ved korrekt bruk av Airflow indikerer disse firkantene at dataene absolutt ikke har nådd frem.
Vi må se på loggen og starte på nytt de mislykkede oppgave-instansene.
Ved å klikke på hvilken som helst firkant, vil vi se tilgjengelige handlinger for oss:
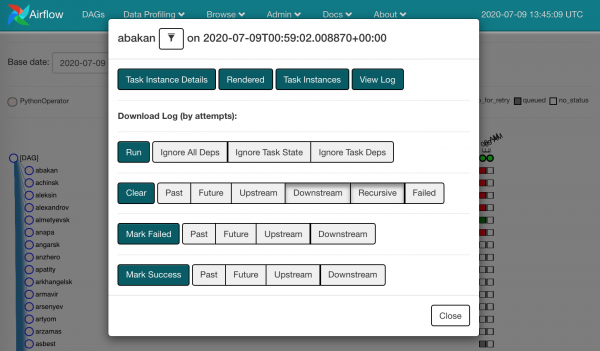
Vi kan ta og gjøre Clear på den mislykkede. Det vil si at vi glemmer at noe har strandet, og den samme oppgave-instansen vil gå til planleggeren.
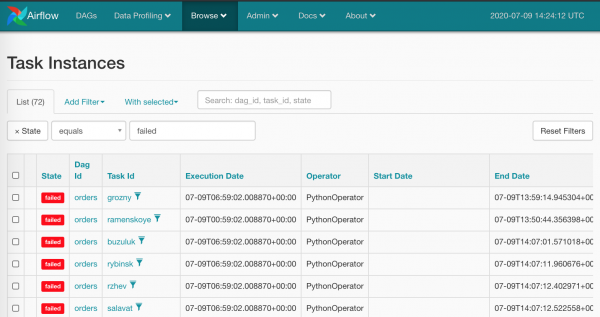
Det er klart at det ikke er særlig human å gjøre dette med musen på alle de røde firkantene – det er ikke det vi forventer fra Airflow. Selvfølgelig har vi et massedrapsvåpen: Browse/Task Instances
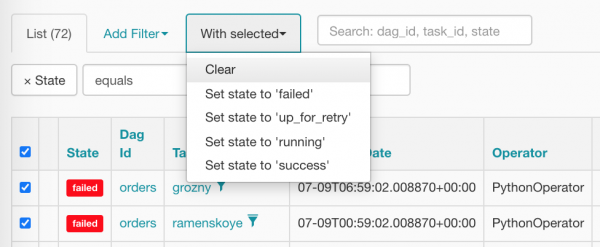
Vi velger alt på en gang og nullstiller ved å trykke på riktig punkt:
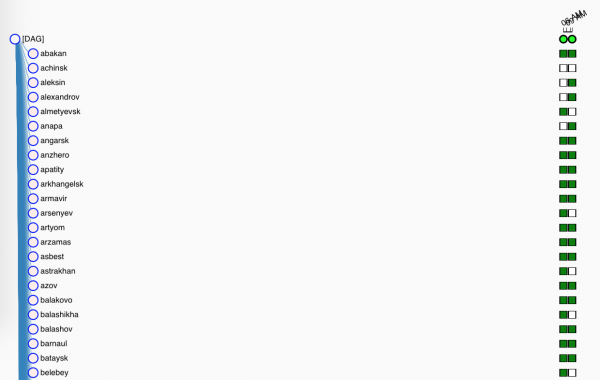
Etter opprydning ser våre oppgaver slik ut (de kan nesten ikke vente med å bli planlagt av scheduler):
Tilkoblinger, hooks og andre variabler
Det er på tide å se på den neste DAG-en, update_reports.py:
from collections import namedtuple
from datetime import datetime, timedelta
from textwrap import dedent

from airflow import DAG
from airflow.contrib.operators.vertica_operator import VerticaOperator
from airflow.operators.email_operator import EmailOperator
from airflow.utils.trigger_rule import TriggerRule

from commons.operators import TelegramBotSendMessage

dag = DAG('update_reports',
          start_date=datetime(2020, 6, 7, 6),
          schedule_interval=timedelta(days=1),
          default_args={'retries': 3, 'retry_delay': timedelta(seconds=10)})

Report = namedtuple('Report', 'source target')
reports = [Report(f'{table}_view', table) for table in [
    'reports.city_orders',
    'reports.client_calls',
    'reports.client_rates',
    'reports.daily_orders',
    'reports.order_duration']]

email = EmailOperator(
    task_id='email_success', dag=dag,
    to='{{ var.value.all_the_kings_men }}',
    subject='DWH Reports updated',
    html_content=dedent("""Kjære alle, rapportene er oppdatert"""),
    trigger_rule=TriggerRule.ALL_SUCCESS)

tg = TelegramBotSendMessage(
    task_id='telegram_fail', dag=dag,
    tg_bot_conn_id='tg_main',
    chat_id='{{ var.value.failures_chat }}',
    message=dedent("""
         Natasha, våkne, vi har krasjet {{ dag.dag_id }}
        """),
    trigger_rule=TriggerRule.ONE_FAILED)

for source, target in reports:
    queries = [f"TRUNCATE TABLE {target}",
               f"INSERT INTO {target} SELECT * FROM {source}"]

    report_update = VerticaOperator(
        task_id=target.replace('reports.', ''),
        sql=queries, vertica_conn_id='dwh',
        task_concurrency=1, dag=dag)

    report_update >> [email, tg]
Har ikke alle laget en rapportoppdatering en gang? Det er igjen: det er en liste over kilder for å hente data; det er en liste over hvor de skal plasseres; ikke glem å gi beskjed når alt skjer eller går i stykker (men det er ikke oss, nei).
La oss gå gjennom filen igjen og se på de nye uklare tingene:
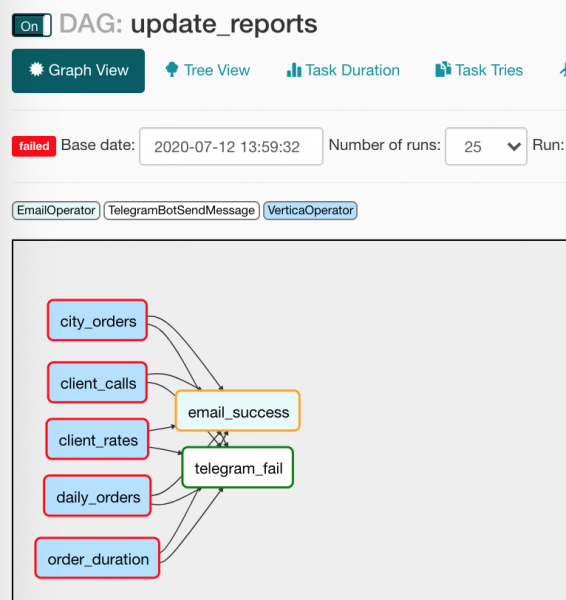
from commons.operators import TelegramBotSendMessage— ingenting hindrer oss i å lage våre egne operatorer, noe vi utnyttet ved å lage et lite wrapper for å sende meldinger i Unblocked. (Vi vil snakke mer om denne operatoren senere);default_args={}— DAG-en kan dele de samme argumentene til alle sine operatorer;to='{{ var.value.all_the_kings_men }}'— feltettovil ikke være hardkodet, men dynamisk generert ved hjelp av Jinja og en variabel med en liste over e-poster som jeg forsiktig har plassert iAdmin/Variables;trigger_rule=TriggerRule.ALL_SUCCESS— betingelsen for å aktivere operatoren. I vårt tilfelle vil e-posten bli sendt til sjefene bare hvis alle avhengigheter kjører succesfully;tg_bot_conn_id='tg_main'— argumenteneconn_idtar inn identifikatorene for tilkoblingene som vi oppretter iAdmin/Connections;trigger_rule=TriggerRule.ONE_FAILED— meldinger vil bare bli sendt til Telegram hvis det er mislykkede oppgaver;task_concurrency=1— forhindrer samtidig kjøring av flere task-instanser av én oppgave. Ellers vil vi få samtidige kjøringer av flereVerticaOperator(som ser på én tabell);report_update >> [email, tg]— alleVerticaOperatorvil samles om å sende e-post og meldinger, på denne måten:

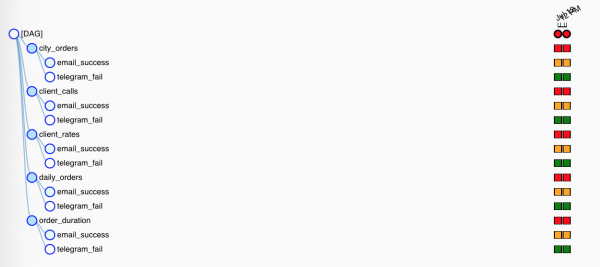
Men siden varsler-operatørene har forskjellige aktiveringsbetingelser, vil bare én fungere. I Tree View ser det noe mindre oversiktlig ut:

Jeg vil si et par ord om makroer og deres venner — variabler.
Makroer er Jinja-plassholdere som kan sette inn nyttig informasjon i argumentene til operatorene. For eksempel slik:
SELECT
    id,
    payment_dtm,
    payment_type,
    client_id
FROM orders.payments
WHERE
    payment_dtm::DATE = '{{ ds }}'::DATE
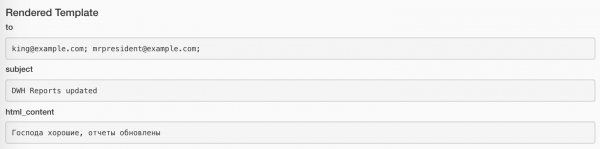
{{ ds }} vil utvides til innholdet i konteksten variabel execution_date i formatet YYYY-MM-DD: 2020-07-14. Det mest behagelige er at kontekstvariabler er knyttet til en bestemt oppgaveinstans (rutenett i Tree View), og ved omstart vil plassholderne utvides til de samme verdiene.
De tildelte verdiene kan ses ved hjelp av Rendered-knappen på hver oppgaveinstans. Slik ser det ut for oppgaven som sender e-post:
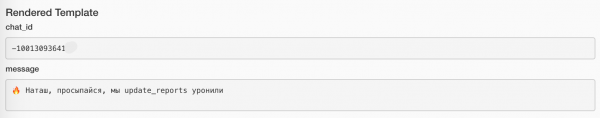
Og slik ser det ut for oppgaven med å sende meldinger:
Den fullstendige listen over innebygde makroer for den siste tilgjengelige versjonen finnes her:
Videre kan vi med hjelp av plugins erklære våre egne makroer, men det er en helt annen historie.
I tillegg til forhåndsdefinerte ting, kan vi sette inn verdier fra våre variabler (jeg har allerede brukt dette i koden ovenfor). La oss lage i Admin/Variables et par ting:
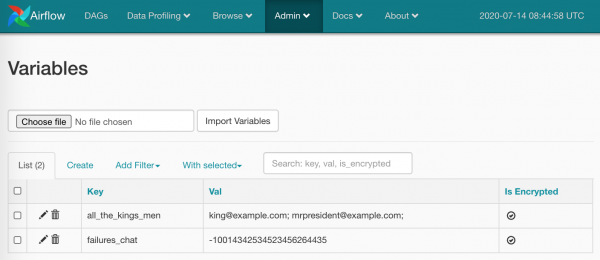
Det er alt, nå kan vi bruke det:
TelegramBotSendMessage(chat_id='{{ var.value.failures_chat }}')I verdien kan det være en skalar, eller det kan ligge en JSON. I tilfelle av JSON:
bot_config

{
    "bot": {
        "token": 881hskdfASDA16641,
        "name": "Verter"
    },
    "service": "TG"
}
bare bruk stien til den nødvendige nøkkelen: {{ var.json.bot_config.bot.token }}.
Jeg skal si ett ord og vise et skjermbilde om tilkoblinger. Her er alt elementært: på siden Admin/Connections oppretter vi en tilkobling, legger inn brukernavn/passordene våre og mer spesifikke parametere. Slikt:
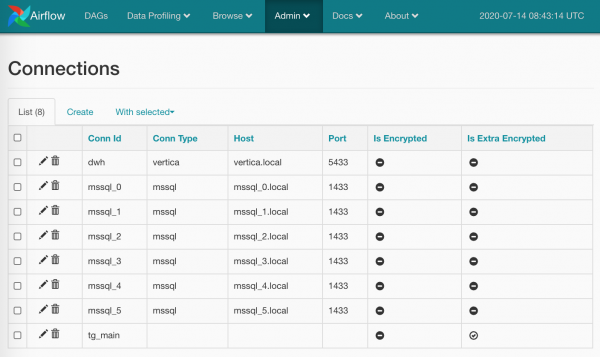
Passord kan krypteres (mer grundig enn i standardalternativet), eller man kan unngå å spesifisere tilkoblingstypen (som jeg gjorde for tg_main) — saken er at listen over typer er hardkodet i Airflow-modellene og kan ikke utvides uten å gå inn i kildekoden (hvis jeg tilfeldigvis har glemt noe — vennligst korriger meg), men å få kreditt enkelt ved navn er det ingenting som hindrer oss.
Og man kan også lage flere tilkoblinger med samme navn: i så fall vil metoden BaseHook.get_connection(), som henter tilkoblinger etter navn, returnere en tilfeldig ut av flere med samme navn (det ville vært mer logisk å gjøre Round Robin, men la oss la det være opp til utviklerne av Airflow).
Variabler og Tilkoblinger er absolutt flotte verktøy, men det er viktig å ikke miste balansen: hvilke deler av strømmen din lagrer du faktisk i koden, og hvilke deler gir du til Airflow for lagring. På den ene siden kan det være praktisk å raskt endre verdien, for eksempel e-postadressen på et nyhetsbrev, via UI. På den andre siden er det tross alt en tilbakevending til museklikk, som vi (jeg) ønsket å bli kvitt.
Arbeid med tilkoblinger er en av oppgavene hookene. Generelt er Airflow-hooks tilkoblingspunktene til dets eksterne tjenester og biblioteker. For eksempel, JiraHook vil åpne en klient for oss for å samhandle med Jira (vi kan flytte oppgaver frem og tilbake), og ved hjelp av SambaHook kan man laste opp en lokal fil til smb-punkt.
Analyzerer en tilpasset operator
Og vi har nå kommet nært til å se på hvordan TelegramBotSendMessage
Kode commons/operators.py ser ut med selve operatøren:
fra typing import Union

fra airflow.operators import BaseOperator

fra commons.hooks import TelegramBotHook, TelegramBot

class TelegramBotSendMessage(BaseOperator):
    """Send melding til chat_id ved hjelp av TelegramBotHook

    Eksempel:
        >>> TelegramBotSendMessage(
        ...     task_id='telegram_fail', dag=dag,
        ...     tg_bot_conn_id='tg_bot_default',
        ...     chat_id='{{ var.value.all_the_young_dudes_chat }}',
        ...     message='{{ dag.dag_id }} mislyktes :(',
        ...     trigger_rule=TriggerRule.ONE_FAILED)
    """
    template_fields = ['chat_id', 'message']

    def __init__(self,
                 chat_id: Union[int, str],
                 message: str,
                 tg_bot_conn_id: str = 'tg_bot_default',
                 *args, **kwargs):
        super().__init__(*args, **kwargs)

        self._hook = TelegramBotHook(tg_bot_conn_id)
        self.client: TelegramBot = self._hook.client
        self.chat_id = chat_id
        self.message = message

    def execute(self, context):
        print(f'Send "{self.message}" til chat {self.chat_id}')
        self.client.send_message(chat_id=self.chat_id,
                                 message=self.message)
Her, som med alt annet i Airflow, er alt ganske enkelt:
- Vi arvet fra
BaseOperator, som implementerer ganske mange Airflow-spesifikke greier (ta en titt på fritiden) - Vi deklarerte feltene
template_fields, der Jinja vil se etter makroer for behandling. - Vi organiserte riktige argumenter for
__init__(), satt opp standardverdier der det var nødvendig. - Vi glemte ikke å initialisere forelderens klasse.
- Vi åpnet den tilsvarende hooken
TelegramBotHook, og fikk klientobjektet fra den. - Vi overstyrte metoden
BaseOperator.execute(), som Airflow vil kalle når det er på tide å kjøre operatoren — i den implementerer vi hovedhandlingen, men glemmer ikke å logge. (Vi logger oss faktisk inn istdoutogstderr— Airflow vil fange alt, pakke det pent inn, og fordele det til riktig sted.)
La oss se hva vi har i commons/hooks.py. Den første delen av filen, med selve hooken:
fra typing import Union

fra airflow.hooks.base_hook import BaseHook
fra requests_toolbelt.sessions import BaseUrlSession

class TelegramBotHook(BaseHook):
    """Telegram Bot API hook

    Merknad: legg til en tilkobling med tom Conn Type og glem ikke
    å fylle ut Extra:

        {"bot_token": "YOuRAwEsomeBOtToKen"}
    """
    def __init__(self,
                 tg_bot_conn_id='tg_bot_default'):
        super().__init__(tg_bot_conn_id)

        self.tg_bot_conn_id = tg_bot_conn_id
        self.tg_bot_token = None
        self.client = None
        self.get_conn()

    def get_conn(self):
        extra = self.get_connection(self.tg_bot_conn_id).extra_dejson
        self.tg_bot_token = extra['bot_token']
        self.client = TelegramBot(self.tg_bot_token)
        return self.client
Jeg vet ikke engang hva jeg skal forklare her, bare merk deg de viktige punktene:
- Vi arver, tenker på argumentene — i de fleste tilfeller vil det være ett:
conn_id; - Vi overstyrer standardmetodene: jeg begrenset meg til
get_conn(), der jeg får tilkoblingsparametrene etter navn og bare henter seksjonenextra(dette felt er for JSON), der jeg (etter mine egne instruksjoner!) la Telegram-bot-tokenet:{"bot_token": "YOuRAwEsomeBOtToKen"}. - Jeg oppretter et eksempel av vår
TelegramBot, og gir den allerede et spesifikt token.
Det er alt. Du kan få klienten fra haken med hjelp av TelegramBotHook().client eller TelegramBotHook().get_conn().
Og den andre delen av filen, der jeg laget en mikroinnpakning for Telegram REST API, for ikke å måtte ta med den samme for bare én metode sendMessage.
class TelegramBot:
    """Telegram Bot API-wrapper

    Eksempler:
        >>> TelegramBot('YOuRAwEsomeBOtToKen', '@myprettydebugchat').send_message('Hei, kjære')
        >>> TelegramBot('YOuRAwEsomeBOtToKen').send_message('Hei, kjære', chat_id=-1762374628374)
    """
    API_ENDPOINT = 'https://api.telegram.org/bot{}/'

    def __init__(self, tg_bot_token: str, chat_id: Union[int, str] = None):
        self._base_url = TelegramBot.API_ENDPOINT.format(tg_bot_token)
        self.session = BaseUrlSession(self._base_url)
        self.chat_id = chat_id

    def send_message(self, message: str, chat_id: Union[int, str] = None):
        method = 'sendMessage'

        payload = {'chat_id': chat_id or self.chat_id,
                   'text': message,
                   'parse_mode': 'MarkdownV2'}

        response = self.session.post(method, data=payload).json()
        if not response.get('ok'):
            raise TelegramBotException(response)

class TelegramBotException(Exception):
    def __init__(self, *args, **kwargs):
        super().__init__((args, kwargs))
Den riktige veien er å samle alt dette:
TelegramBotSendMessage,TelegramBotHook,TelegramBot— i et plugin, legge det i et offentlig repo, og gi det ut som Open Source.
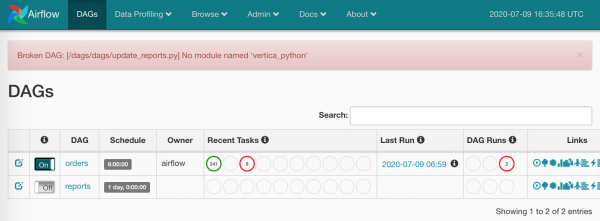
Mens vi studerte alt dette, klarte oppdateringene våre å gjøre en feilmelding og sende meg en melding i kanalen. Jeg skal sjekke hva som igjen er galt…
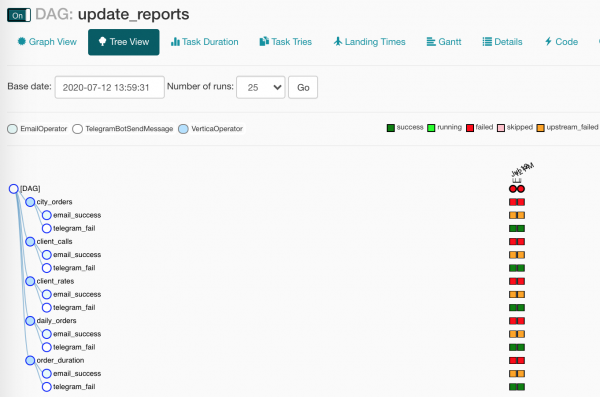
Noe har gått galt i dagene våre! Var ikke det hva vi ventet på? Nettopp!
Skal du helle noe?
Føler du at jeg har gått glipp av noe? Jeg lovet visst å overføre data fra SQL Server til Vertica, og så skled jeg unna temaet, skurk!
Gjerningen var med vilje, jeg måtte bare forklare deg noe terminologi. Nå kan vi fortsette.
Planen vår var slik:
- Lag en dag
- Generere oppgaver
- Se hvordan alt ser pent ut
- Tilordne sesjonsnumre til opplastninger
- Hent data fra SQL Server
- Legg dataene i Vertica
- Samle statistikk
Så, for å sette i gang dette, har jeg laget et lite tillegg til vår docker-compose.yml:
docker-compose.db.yml
versjon: '3.4'

x-mssql-base: &mssql-base
  image: mcr.microsoft.com/mssql/server:2017-CU21-ubuntu-16.04
  restart: alltid
  environment:
    ACCEPT_EULA: Y
    MSSQL_PID: Express
    SA_PASSWORD: SayThanksToSatiaAt2020
    MSSQL_MEMORY_LIMIT_MB: 1024

tjenester:
  dwh:
    image: jbfavre/vertica:9.2.0-7_ubuntu-16.04

  mssql_0:
    <<: *mssql-base

  mssql_1:
    <<: *mssql-base

  mssql_2:
    <<: *mssql-base

  mssql_init:
    image: mio101/py3-sql-db-client-base
    command: python3 ./mssql_init.py
    depends_on:
      - mssql_0
      - mssql_1
      - mssql_2
    environment:
      SA_PASSWORD: SayThanksToSatiaAt2020
    volumes:
      - ./mssql_init.py:/mssql_init.py
      - ./dags/commons/datasources.py:/commons/datasources.py
Der hever vi opp:
- Vertica som vert
dwhmed de mest standardinnstillingene, - tre instanser av SQL Server,
- fyller databasene med noen siste data (ikke se i
mssql_init.py!)
Vi starter opp alt med en litt mer kompleks kommando enn sist:
$ docker-compose -f docker-compose.yml -f docker-compose.db.yml up --scale worker=3Det som ble generert av vår mirakelslaver, kan man bruke ved å gå til Data Profiling/Ad Hoc Query:
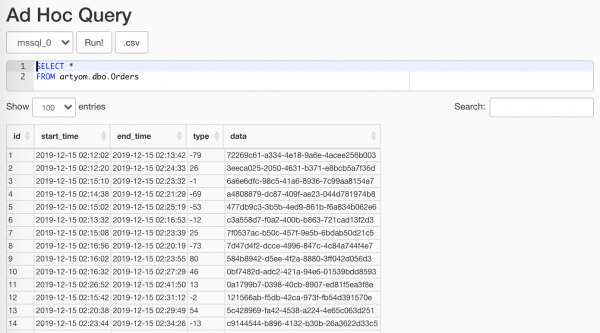
Det viktigste er å ikke vise dette til analystene
Jeg vil ikke gå nærmere inn på ETL-øktene der, alt er trivielt: vi lager databasen, i den en tabell, pakker alt i en kontekstbehandler, og så gjør vi slik:
with Session(task_name) as session:
    print('Load', session.id, 'started')

    # Last workflow
    ...

    session.successful = True
    session.loaded_rows = 15
session.py
fra sys import stderr

class Session:
    """ETL arbeidsflytøktjon

    Eksempel:
        med Session(task_name) som session:
            print(session.id)
            session.successful = True
            session.loaded_rows = 15
            session.comment = 'Godt jobbet'
    """

    def __init__(self, connection, task_name):
        self.connection = connection
        self.connection.autocommit = True

        self._task_name = task_name
        self._id = None

        self.loaded_rows = None
        self.successful = None
        self.comment = None

    def __enter__(self):
        return self.open()

    def __exit__(self, exc_type, exc_val, exc_tb):
        if any(exc_type, exc_val, exc_tb):
            self.successful = False
            self.comment = f'{exc_type}: {exc_val}n{exc_tb}'
            print(exc_type, exc_val, exc_tb, file=stderr)
        self.close()

    def __repr__(self):
        return (f'<{self.__class__.__name__} '
                f'id={self.id} '
                f'task_name="{self.task_name}">')

    @property
    def task_name(self):
        return self._task_name

    @property
    def id(self):
        return self._id

    def _execute(self, query, *args):
        with self.connection.cursor() som cursor:
            cursor.execute(query, args)
            return cursor.fetchone()[0]

    def _create(self):
        query = """
            OPPRETT TABLE IF NOT EXISTS sessions (
                id          SERIAL       NOT NULL PRIMARY KEY,
                task_name   VARCHAR(200) NOT NULL,

                started     TIMESTAMPTZ  NOT NULL DEFAULT current_timestamp,
                finished    TIMESTAMPTZ           DEFAULT current_timestamp,
                successful  BOOL,

                loaded_rows INT,
                comment     VARCHAR(500)
            );
            """
        self._execute(query)

    def open(self):
        query = """
            INSERT INTO sessions (task_name, finished)
            VALUES (%s, NULL)
            RETURNING id;
            """
        self._id = self._execute(query, self.task_name)
        print(self, 'åpnet')
        return self

    def close(self):
        if not self._id:
            raise SessionClosedError('Økten er ikke åpen')
        query = """
            UPDATE sessions
            SET
                finished    = DEFAULT,
                successful  = %s,
                loaded_rows = %s,
                comment     = %s
            WHERE
                id = %s
            RETURNING id;
            """
        self._execute(query, self.successful, self.loaded_rows,
                      self.comment, self.id)
        print(self, 'lukket',
              ', vellykket: ', self.successful,
              ', Lastet: ', self.loaded_rows,
              ', kommentar:', self.comment)

class SessionError(Exception):
    pass

class SessionClosedError(SessionError):
    pass
Tiden er inne å hente våre data fra våre hundre og femti bord. La oss gjøre det med noen enkle linjer:
source_conn = MsSqlHook(mssql_conn_id=src_conn_id, schema=src_schema).get_conn()

query = f"""
    SELECT
        id, start_time, end_time, type, data
    FROM dbo.Orders
    WHERE
        CONVERT(DATE, start_time) = '{dt}'
    """

df = pd.read_sql_query(query, source_conn)- Ved hjelp av hooken vil vi få fra Airflow
pymssql-tilkobling - Vi skal legge en databegrensning i forespørselen – den vil bli lagt inn av templateringsverktøyet.
- Vi mater forespørselen vår
pandas, som skaffer ossDataFrame— det vil bli nyttig for oss senere.
Jeg bruker substitusjon
{dt}i stedet for forespørselparameter%sikke fordi jeg er en ond Pinokkio, men fordipandaskan ikke håndterepymssqlog putter det til den sisteparams: Liste, selv om han veldig gjerne viltuple.
Vær også oppmerksom på at utviklerenpymssqlhar besluttet å ikke støtte det lenger, og det er på høy tid å flytte tilpyodbc.
La oss se hva Airflow har fylt funksjonsargumentene våre med:
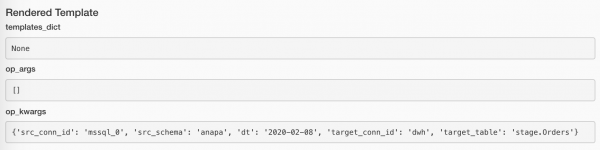
Hvis det ikke er noen data, gir det ikke mening å fortsette. Men det er heller merkelig å si at innlastingen var vellykket. Men dette er heller ikke en feil. Åh, hva skal vi gjøre?! Her er hva:
if df.empty:
    raise AirflowSkipException('Ingen rader å laste')
AirflowSkipException vil si at det ikke er noen feil, og at vi hopper over oppgaven. I grensesnittet vil det ikke være en grønn og ikke en rød firkant, men i stedet en rosa.
La oss gi dataene våre flere kolonner:
df['etl_source'] = src_schema
df['etl_id'] = session.id
df['hash_id'] = hash_pandas_object(df[['etl_source', 'id']])
Nemlig:
- DB-en som vi har hentet bestillingene fra,
- Identifikatoren for innlastingsøkten vår (den vil være forskjellig for hver oppgave),
- Hash fra kilden og bestillingsidentifikatoren — slik at vi i den endelige databasen (hvor alt samlet i én tabell) har en unik bestillingsidentifikator.
Det gjenstår ett skritt: laste alt inn i Vertica. Ironisk nok er en av de mest effektive måtene å gjøre dette på — via CSV!
# Export data to CSV buffer
buffer = StringIO()
df.to_csv(buffer,
          index=False, sep='|', na_rep='NUL', quoting=csv.QUOTE_MINIMAL,
          header=False, float_format='%.8f', doublequote=False, escapechar='\')
buffer.seek(0)

# Push CSV
target_conn = VerticaHook(vertica_conn_id=target_conn_id).get_conn()

copy_stmt = f"""
    COPY {target_table}({df.columns.to_list()})
    FROM STDIN
    DELIMITER '|'
    ENCLOSED '"'
    ABORT ON ERROR
    NULL 'NUL'
    """

cursor = target_conn.cursor()
cursor.copy(copy_stmt, buffer)- Vi lager en spesialmottaker
StringIO. pandasvil vennligst samle vårDataFramesomCSV-linjer.- Vi åpner forbindelsen til vår kjære Vertica ved hjelp av et hook.
- Og nå ved hjelp av
copy()sender vi dataene våre direkte til Vertica!
Vi henter hvor mange linjer som ble lastet opp fra driveren, og forteller sesjonslederen at alt er OK:
session.loaded_rows = cursor.rowcount
session.successful = True
Det var det.
I produksjon oppretter vi måltabellen manuelt. Her har jeg tillatt meg en liten automasjon:
create_schema_query = f'CREATE SCHEMA IF NOT EXISTS {target_schema};'
create_table_query = f"""
    CREATE TABLE IF NOT EXISTS {target_schema}.{target_table} (
         id         INT,
         start_time TIMESTAMP,
         end_time   TIMESTAMP,
         type       INT,
         data       VARCHAR(32),
         etl_source VARCHAR(200),
         etl_id     INT,
         hash_id    INT PRIMARY KEY
     );"""

create_table = VerticaOperator(
    task_id='create_target',
    sql=[create_schema_query,
         create_table_query],
    vertica_conn_id=target_conn_id,
    task_concurrency=1,
    dag=dag)
Jeg bruker
VerticaOperator()til å opprette databasen og tabellen (hvis de ikke allerede finnes, selvfølgelig). Det viktigste er å plassere avhengighetene riktig:
for conn_id, schema in sql_server_ds:
    load = PythonOperator(
        task_id=schema,
        python_callable=workflow,
        op_kwargs={
            'src_conn_id': conn_id,
            'src_schema': schema,
            'dt': '{{ ds }}',
            'target_conn_id': target_conn_id,
            'target_table': f'{target_schema}.{target_table}'},
        dag=dag)

    create_table >> load
Oppsummering
— Vel, — sa musen, — er det ikke sant, nå
Har du funnet ut at jeg er det mest skremmende dyret i skogen?
Julia Donaldson, «Gruffalo»
Jeg tror at hvis jeg og kollegene mine hadde arrangert en konkurranse: hvem som raskest kan sette opp og kjøre en ETL-prosess fra bunnen av: de med sine SSIS og mus, og jeg med Airflow… Og så sammenlignet vi lettheten av vedlikehold… Jeg tror du vil være enig i at jeg ville overgått dem på alle fronter!
Hvis vi skal bli litt mer seriøse, så har Apache Airflow — takket være beskrivelsen av prosessene som programkode — gjort jobben min mye enklere og mer behagelig.
Den ubegrensede utvidbarheten: både når det gjelder plugins og som en predisposisjon for skalerbarhet — gir deg muligheten til å bruke Airflow nesten overalt: enten i den komplette syklusen av innsamling, forberedelse og behandling av data, eller til og med til å skyte opp raketter (til Mars, selvfølgelig).
Avsluttende del, informativ
Fallgruvene vi har samlet for deg
start_date. Ja, dette er allerede et lokalt meme. Gjennom hovedargumentet til dagstart_dategår alle. Kort fortalt, hvis du angir istart_dateden nåværende datoen, og ischedule_interval— én dag, vil DAG bli kjørt i morgen tidligst.start_date = datetime(2020, 7, 7, 0, 1, 2)Og så flere problemer.
Det er også knyttet til en annen feil under kjøring:
Task is missing the start_date parameter, som oftest indikerer at du har glemt å knytte til operatøren i dag.- Alt på én maskin. Ja, både databasen (til Airflow selv og vår innpakning), webserveren, planleggeren, og arbeidere. Og det fungerte faktisk. Men etter hvert som antallet oppgaver i tjenestene økte, og når PostgreSQL begynte å levere svar med indeksen på 20 ms i stedet for 5 ms, tok vi det og fjernet det.
- LocalExecutor. Ja, vi bruker det fremdeles, og vi har allerede nådd kanten av avgrunnen. LocalExecutor har vært tilstrekkelig for oss, men nå er det på høy tid å utvide med minst én arbeider, og vi må gjøre en innsats for å flytte til CeleryExecutor. Og ettersom det kan brukes selv på én maskin, er det ingenting som hindrer bruken av Celery selv ikke på serveren, som «selvfølgelig aldri kommer til å gå i produksjon, jeg lover!»
- Ikke bruk innebygde verktøy:
- Connections for å lagre legitimasjon for tjenester,
- SLA Misses for å håndtere oppgaver som ikke har fullført i tide,
- XCom for å utveksle metadata (jeg sa metadata!) mellom oppgavene i dag.
- Misbruk av e-post. Hva skal man si? Det ble satt opp varsler for alle gjentakelser av nedlagte oppgaver. Nå har jeg over 90k e-poster fra Airflow i min arbeids-Gmail, og nettgrensesnittet til e-posten nekter å ta imot og slette mer enn 100 om gangen.
Flere fallgruver:
Verktøy for enda større automatisering
For at vi skal kunne jobbe mer med hodet enn med hendene, har Airflow forberedt dette for oss:
- — det har fortsatt status som eksperimentelt, noe som ikke hindrer det i å fungere. Med det kan man ikke bare hente informasjon om DAGer og oppgaver, men også stoppe/starte en DAG, lage en DAG-kjøring eller en pulje.
- — mange verktøy er tilgjengelige via kommandolinjen, som ikke bare er upraktiske å bruke gjennom WebUI, men ikke eksisterer i det hele tatt. For eksempel:
backfillsom er nødvendig for å kjøre oppgavene på nytt.
For eksempel, analytikerne kom, og sier: «Åh, du har tull i dataene fra 1. til 13. januar! Fiks det, fiks det, fiks det!». Og du sier:airflow backfill -s '2020-01-01' -e '2020-01-13' orders- Vedlikehold av databasen:
initdb,resetdb,upgradedb,checkdb. run, som lar deg kjøre en enkelt instans av oppgaven, uten å ta hensyn til alle avhengigheter. Dessuten kan den kjøres gjennomLocalExecutor, selv om du har et Celery-klynge.- Det gjør omtrent det samme som
test, bare at den ikke skriver noe i databasen. connectionslar deg massivt opprette tilkoblinger fra shell.
- – en ganske hardcore måte å interagere på, som er ment for plugins, og ikke for å rote med det manuelt. Men hvem kan hindre oss i å gå til
/home/airflow/dags, kjøreipythonog begynne å eksperimentere? Man kan for eksempel eksportere alle tilkoblinger med koden:from airflow import settings from airflow.models import Connection fields = 'conn_id conn_type host port schema login password extra'.split() session = settings.Session() for conn in session.query(Connection).order_by(Connection.conn_id): d = {field: getattr(conn, field) for field in fields} print(conn.conn_id, '=', d) - Tilkobling til Airflows metadata-database. Jeg anbefaler ikke å skrive til den, men å hente tilstanden på oppgaver for forskjellige spesifikke metrikker er mye raskere og enklere enn gjennom noen av APIene.
La oss si, ikke alle oppgavene våre er idempotente, og de kan av og til feile, og det er greit. Men flere feil er mistenkelig, og det bør sjekkes.
Forsiktig, SQL!
MED sist_execution AS (
SELECT
    task_id,
    dag_id,
    execution_date,
    state,
        row_number()
        OVER (
            PARTITION BY task_id, dag_id
            ORDER BY execution_date DESC) AS rn
FROM public.task_instance
WHERE
    execution_date > now() - INTERVAL '2' DAGAR
),
failure AS (
    SELECT
        task_id,
        dag_id,
        execution_date,
        state,
        CASE WHEN rn = row_number() OVER (
            PARTITION BY task_id, dag_id
            ORDER BY execution_date DESC)
                 THEN TRUE END AS last_fail_seq
    FROM sist_execution
    WHERE
        state IN ('failed', 'up_for_retry')
)
SELECT
    task_id,
    dag_id,
    count(last_fail_seq)                       AS unsuccessful,
    count(CASE WHEN last_fail_seq
        AND state = 'failed' THEN 1 END)       AS failed,
    count(CASE WHEN last_fail_seq
        AND state = 'up_for_retry' THEN 1 END) AS up_for_retry
FROM failure
GROUP BY
    task_id,
    dag_id
HAVING
    count(last_fail_seq) > 0
Lenker
Og selvfølgelig de første ti lenkene fra Googles søkeresultat – innholdet i mappen Airflow fra bokmerkene mine.
- — selvsagt må man begynne med den offisielle dokumentasjonen, men hvem leser bruksanvisninger?
- — men du bør i det minste lese anbefalingene fra skaperne.
- — begynnelsen: brukergrensesnittet med bilder
- — grunnleggende begreper er godt beskrevet, hvis (mot alle odds!) du ikke forsto noe av det jeg sa.
- — en kort guide for å sette opp en Airflow-klynge.
- — omtrent en like interessant artikkel, bare mer formalitet og færre eksempler.
- — om samarbeidet med Celery.
- — om idempotens av oppgaver, lasting etter ID i stedet for dato, transformasjoner, filstruktur og andre interessante ting.
- — avhengigheter mellom oppgaver og Trigger Rule, som jeg bare nevnte i forbifarten.
- — hvordan man overkommer noen «fungerer som planlagt» med planleggeren, laste tapt data og prioritere oppgaver.
- — nyttige SQL-spørringer til Airflows metadata.
- — det er en nyttig seksjon om å lage egendefinert sensor.
- — en kort interessant notis om å bygge infrastruktur på AWS for Data Science.
- — vanlige feil (når noen faktisk ikke leser instruksjoner).
- — smil, se hvordan folk krangler med passordlagring, når man bare kan bruke Connections.
- — implisitt DAG-omdirigering, kontekstoverføring i funksjoner, igjen om avhengigheter, og dessuten om å hoppe over kjøringer av oppgaver.
- — om bruken av
standardargumenterogparamsi malene, samt om Variabler og Tilkoblinger. - — en fortelling om hvordan planleggeren er gjort klar for Airflow 2.0.
- — en litt utdatert artikkel om distribusjon av vår klynge i
docker-compose. - — dynamiske oppgaver ved hjelp av maler og kontekstoverføring.
- — standard- og tilpassede varsler via e-post og Slack.
- — Forgrening av oppgaver, makroer og XCom.
Og lenkene som brukes i artikkelen:
- — tilgjengelige for bruk i malene.
- — Vanlige feil ved opprettelse av DAG-er.
- —
docker-composefor eksperimentering, feilsøking og mer. - — Python-wrapper for Telegram REST API.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish