

Det er kanskje ingen hemmelighet at fjoråret for Apache Hadoop var preget av store endringer. I fjor ble Cloudera og Hortonworks fusjonert (i hovedsak oppkjøp av det andre), og Mapr, på grunn av alvorlige økonomiske problemer, ble solgt til Hewlett Packard. Og hvis man for noen år siden måtte velge mellom Cloudera og Hortonworks for on-premises installasjoner, så er ikke dette valget lenger tilgjengelig i dag. Et overraskende aspekt var også det faktum at Cloudera fra februar i år annonserte at de vil slutte å gi ut binære bygninger av distribusjonen sin i det offentlige lageret, og at de nå kun er tilgjengelige via betalt abonnement. Selvfølgelig er muligheten for å laste ned de siste versjonene av CDH og HDP, utgitt før slutten av 2019, fortsatt tilgjengelig, og støtte for disse forventes i løpet av ett til to år. Men hva skal man gjøre videre? For de som tidligere betalte for abonnementet, har ingenting endret seg. Og for de som ikke ønsker å bytte til den betalte versjonen av distribusjonen, men som ønsker å ha muligheten til å motta oppdaterte versjoner av klyngens komponenter, samt feilrettinger og andre oppdateringer, har vi forberedt denne artikkelen. Her vil vi se på mulige løsninger på den nåværende situasjonen.
Artiklen er mer oversiktspreget. Den vil ikke inneholde sammenligninger av distribusjoner eller detaljerte analyser, og det vil heller ikke være oppskrifter for installasjon og konfigurasjon. Hva vil det så være? Vi vil kort omtale en distribusjon som Arenadata Hadoop, som fortjener vår oppmerksomhet på grunn av sin tilgjengelighet, noe som i dag er en sjeldenhet. Deretter vil vi snakke om Vanilla Hadoop, hovedsakelig om hvordan man kan "tilberede" det ved hjelp av Apache Bigtop. Klar for å begynne? Velkommen til artikkelen.
Arenadata Hadoop
Dette er en helt ny og foreløpig lite kjent distribusjon av innenlandsk utvikling. Dessverre finnes det for øyeblikket bare lite informasjon om den på Habr. .
Mer informasjon kan finnes på den officielle prosjektsiden. De siste versjonene av distribusjonen er basert på Hadoop 3.1.2 for versjon 3 og 2.8.5 for versjon 2.
Informasjon om veikartet kan finnes .
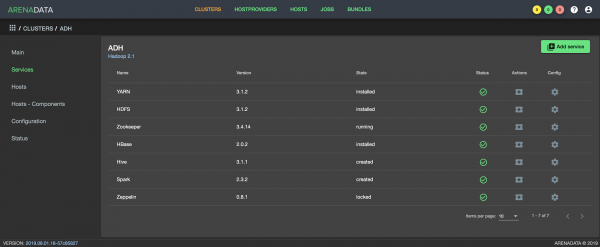
Grensesnittet til Arenadata Cluster Manager
Hovedproduktet til Arenadata er , som brukes til å installere, konfigurere og overvåke ulike programvareløsninger fra selskapet. ADCM distribueres gratis, og funksjonaliteten utvides ved å legge til bunter, som er en samling av ansible-playbooks. Buntende deles opp i to typer: enterprise og community. De sistnevnte er tilgjengelige for gratis nedlasting fra Arenadata sin nettside. Det er også mulighet for å utvikle sin egen bunke og koble den til ADCM.
For distribusjon og styring av Hadoop 3 tilbys en community-versjon av bunte i kombinasjon med ADCM, mens det for Hadoop 2 kun finnes som alternativ. Når det gjelder pakke-repositorier, er de åpne for offentlig tilgang, og de kan lastes ned og installeres på den vanlige måten for alle komponentene i klyngen. Generelt sett virker distribusjonen svært interessant. Jeg er sikker på at det finnes de som er vant til løsninger som Cloudera Manager og Ambari, og som vil sette pris på ADCM. For noen vil det være et stort pluss at distribusjonen for importutskifting.
Når det kommer til ulempene, så vil de være de samme som for alle andre Hadoop-distribusjoner. Nemlig:
- Den såkalte «vendor lock-in». På eksempelet til Cloudera og Hortonworks har vi allerede forstått at det alltid er en risiko for endring i selskapets politikk.
- Betydelig etterslep fra upstream Apache.
Vanilla Hadoop
Som du vet, er Hadoop ikke et monolittisk produkt, men i hovedsak en hel rekke tjenester rundt sitt distribuerte filsystem HDFS. Få vil være fornøyde med bare en filklynge. Noen trenger Hive, andre Presto, og det finnes også HBase og Phoenix, og Spark brukes stadig oftere. For orkestrering og opplasting av data dukker Oozie, Sqoop og Flume opp. Og når spørsmålet om sikkerhet reises, tenker man straks på Kerberos i kombinasjon med Ranger.
Binære versjoner av Hadoop-komponenter er tilgjengelige på nettstedet til hvert av økosystemprosjektene i form av tarballs. Du kan laste dem ned og begynne installasjonen, men med ett forbehold: i tillegg til å måtte bygge pakker fra "rå" binære filer, noe du sannsynligvis vil ønske å gjøre, vil du ikke ha noen garanti for at de lastede versjonene av komponentene er kompatible med hverandre. Et mer ønskelig alternativ er å bygge med Apache Bigtop. Bigtop lar deg bygge fra Apache-maven-repositorier, kjøre tester og samle pakker. Men det som er svært viktig for oss, er at Bigtop samler de versjonene av komponentene som vil være kompatible med hverandre. Dette vil vi gå mer i detalj om senere.
Apache Bigtop
Apache Bigtop er et verktøy for bygging, pakking og testing av en rekke
åpen kildekode-prosjekter, som for eksempel Hadoop og Greenplum. Bigtop har mange
utgivelser. På tidspunktet for skrivingen av artikkelen var den siste stabile utgivelsen versjon 1.4,
mens master inneholdt 1.5. I forskjellige versjoner av utgivelsene brukes ulike versjoner
av komponentene. For eksempel, for 1.4 har kjernekomponentene Hadoop versjon 2.8.5, mens i master
har den 2.10.0. Også sammensetningen av støttede komponenter endres. Noe utdatert og
ikke-oppdatert forsvinner, mens noe nytt, mer etterspurt kommer inn, og
det er ikke nødvendigvis noe fra Apache-familien.
I tillegg har Bigtop mange .
Da vi begynte å bli kjent med Bigtop, ble vi først og fremst overrasket over dens beskjedne, sammenlignet med andre Apache-prosjekter, spredning og kjennskap, samt det ganske lille fellesskapet. Dette betyr at informasjonen om produktet er minimum, og å søke etter løsninger på oppståtte problemer i fora og utsendelser kan i det hele tatt ikke gi noe. I begynnelsen viste det seg å være en utfordrende oppgave for oss å fullføre byggingen av distribusjonen på grunn av instrumentets egenskaper, men dette skal vi snakke litt mer om senere.
Som en teaser — for de som en gang likte slike prosjekter fra Linux-universet som Gentoo og LFS, kan det være nostalgisk og gledelig å jobbe med dette verktøyet og huske de "mytiske" tidene da vi selv lette etter (og til og med skrev) ebuilds og regelmessig bygde med nye patcher for Mozilla.
En stor fordel med Bigtop er åpenheten og allsidigheten til verktøyene det er bygget på. Grunnlaget består av Gradle og Apache Maven. Gradle er godt kjent som et verktøy Google bruker til å kompilere Android. Det er fleksibelt, og som man sier, "prøvd i kamp". Maven er det innebygde verktøyet for bygging av prosjekter i Apache, og ettersom de fleste produktene deres utgis nettopp via Maven, er det ikke til å unngå. Det er viktig å merke seg POM (project object model) – den "fundamentale" xml-filen som beskriver alt som trengs for at Maven skal fungere med prosjektet ditt, som all arbeidet bygges rundt. Det er nettopp i
delen av Maven at enkelte hindringer oppstår, som vanligvis møter de som tar fatt på Bigtop for første gang.
Praksis
Så, hva bør vi starte med? Gå til nedlastingssiden og last ned den nyeste stabile versjonen i form av et arkiv. Der kan man også finne binære artefakter bygget av Bigtop. For øvrig støttes populære pakkehåndterere som YUM og APT.
En alternativ metode er å laste ned den nyeste stabile utgaven direkte fra
github:
$ git clone --branch branch-1.4 https://github.com/apache/bigtop.gitKloner til «bigtop»…
remote: Enumerating objects: 46, done.
remote: Counting objects: 100% (46/46), done.
remote: Compressing objects: 100% (41/41), done.
remote: Total 40217 (delta 14), reused 10 (delta 1), pack-reused 40171
Henter objektene: 100% (40217/40217), 43.54 MiB | 1.05 MiB/s, ferdig.
Bestemmer endringer: 100% (20503/20503), ferdig.
Oppdaterer filer: 100% (1998/1998), ferdig.
Den resulterende katalogen ./$bigtop ser omtrent slik ut:
./bigtop-bigpetstore — demonstrasjonsapplikasjoner, syntetiske eksempler
./bigtop-ci — CI-verktøy, jenkins
./bigtop-data-generators — datagenerering, syntetikk, for røyktester osv.
./bigtop-deploy — verktøy for distribusjon
./bigtop-packages — konfigurasjoner, skript, patcher for bygging, hoveddelen av verktøyet
./bigtop-test-framework — testrammeverket
./bigtop-tests — selve testene, belastningstester og røyktester
./bigtop_toolchain — byggemiljøet, preparering av miljøet for verktøyets drift
./build — arbeidskatalog for bygging
./dl — katalog for nedlastede kildefiler
./docker — bygging av docker-bilder, testing
./gradle — gradle-konfigurasjon
./output – katalogen hvor byggartefaktene blir plassert
./provisioner — provisioning
Det mest interessante på dette stadiet for oss er hovedkonfigurasjonen ./bigtop/bigtop.bom, der vi ser alle støttede komponenter med versjoner. Her kan vi spesifisere en annen produktversjon (hvis vi vil prøve å bygge den) eller byggeversjonen (hvis vi for eksempel har lagt til en betydelig patch).
Også underkatalogen ./bigtop/bigtop-packages, som har direkte relevans for prosessen med å bygge komponenter og pakkene med dem.
Så, vi har lastet ned arkivet, pakket det ut eller laget en klon fra github, kan vi begynne å bygge?
Nei, først må vi forberede miljøet.
Forberedelse av miljøet
Her trengs det en liten avstikker. For å bygge nesten hvilket som helst mer eller mindre komplekst produkt, er det nødvendig med et bestemt miljø - i vårt tilfelle er dette JDK, de delte biblioteker, header filer osv., verktøy som ant, ivy2 og mye mer. En av måtene å få det nødvendige Bigtop-miljøet på, er å installere de nødvendige komponentene på byggverten. Jeg kan ta feil i kronologien, men det ser ut til at med versjon 1.0 kom det også et alternativ for å bygge i forhåndskonfigurerte og tilgjengelige docker-bilder, som kan sees her.
Når det gjelder forberedelse av miljøet, så er det en assistent - Puppet.
Du kan bruke følgende kommandoer, kjøringen skjer fra rotkatalogen
verktøyet, ./bigtop:
./gradlew toolchain
./gradlew toolchain-devtools
./gradlew toolchain-puppetmodules
Eller direkte via puppet:
puppet apply --modulepath= -e "include bigtop_toolchain::installer"
puppet apply --modulepath= -e "include bigtop_toolchain::deployment-tools"
puppet apply --modulepath= -e "include bigtop_toolchain::development-tools"
Dessverre kan det allerede oppstå problemer på dette stadiet. Generelt råd her – bruk en støttet distribusjon, oppdatert på byggverten eller prøv docker-ruten.
Montering
Hva kan vi prøve å bygge? Svaret på dette spørsmålet vil gis av utskriften av kommandoen
./gradlew tasks I delen Package tasks er det en rekke produkter som er sluttartefakter av Bigtop.
De kan identifiseres ved suffikset -rpm eller -pkg-ind (i tilfelle bygging
i docker). I vårt tilfelle er det mest interessante Hadoop.
La oss prøve å utføre bygging i miljøet til vår build-server:
./gradlew hadoop-rpmBigtop vil selv laste ned de nødvendige kildene som er nødvendige for den spesifikke komponenten og begynne byggingen. Dermed er verktøyet bundet til Maven-repositories og andre kilder, det vil si at det trenger tilgang til Internett.
Under normal operation, a standard output is generated. Sometimes it is possible to understand what went wrong from it and error messages. However, additional information may be required. In this case, it is worth adding arguments. --info eller --debug, and it can also be helpful –stacktrace. There is a convenient way to create a dataset for further reference in mailing lists, key --scan.
With its help, bigtop will collect all the information and place it in gradle, after which it will provide a link,
by following which a competent person will be able to understand why the build failed.
It should be noted that this option may expose information you may not want to be public, such as usernames, nodes, environment variables, etc., so be cautious.
Often, errors occur due to the inability to obtain any components necessary for the build. Typically, the problem can be fixed by creating a patch to address something in the sources, for example, an address in pom.xml in the root directory of the sources. This is done by creating it and placing it in the appropriate directory .\/bigtop\/bigtop-packages\/src\/common\/oozie\/ of the patch, for example, in the form of patch2-fix.diff.
--- a\/pom.xml
+++ b\/pom.xml
@@ -136,7 +136,7 @@


central
- http:\/\/repo1.maven.org\/maven2
+ https:\/\/repo1.maven.org\/maven2

false
Most likely, by the time you read this article, you will not have to make the mentioned fix yourself.
When implementing any patches and corrections in the build mechanism, it may be necessary to ‘reset’ the build using the clean command:
.\/gradlew hadoop-clean
> Task :hadoop_vardefines
> Task :hadoop-clean
BUILD SUCCESSFUL in 5s
2 actionable tasks: 2 executed
This operation will roll back all changes to the build of this component, after which the build will be executed again. This time we will try to build the project in a docker image:
./gradlew -POS=centos-7 -Pprefix=1.2.1 hadoop-pkg-ind
> Task :hadoop-pkg-ind
Building 1.2.1 hadoop-pkg on centos-7 in Docker...
+++ dirname ./bigtop-ci/build.sh
++ cd ./bigtop-ci/..
++ pwd
+ BIGTOP_HOME=/tmp/bigtop
+ '[' 6 -eq 0 ']'
+ [[ 6 -gt 0 ]]
+ key=--prefix
+ case $key in
+ PREFIX=1.2.1
+ shift
+ shift
+ [[ 4 -gt 0 ]]
+ key=--os
+ case $key in
+ OS=centos-7
+ shift
+ shift
+ [[ 2 -gt 0 ]]
+ key=--target
+ case $key in
+ TARGET=hadoop-pkg
+ shift
+ shift
+ [[ 0 -gt 0 ]]
+ '[' -z x ']'
+ '[' -z x ']'
+ '[' '' == true ']'
+ IMAGE_NAME=bigtop/slaves:1.2.1-centos-7
++ uname -m
+ ARCH=x86_64
+ '[' x86_64 '!=' x86_64 ']'
++ docker run -d bigtop/slaves:1.2.1-centos-7 /sbin/init
+
CONTAINER_ID=0ce5ac5ca955b822a3e6c5eb3f477f0a152cd27d5487680f77e33fbe66b5bed8
+ trap 'docker rm -f
0ce5ac5ca955b822a3e6c5eb3f477f0a152cd27d5487680f77e33fbe66b5bed8' EXIT
....
mye output
....
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-yarn-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-mapreduce-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-namenode-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-secondarynamenode-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-zkfc-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-journalnode-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-datanode-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-httpfs-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-yarn-resourcemanager-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-yarn-nodemanager-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-yarn-proxyserver-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-yarn-timelineserver-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-mapreduce-historyserver-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-client-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-conf-pseudo-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-doc-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-libhdfs-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-libhdfs-devel-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-fuse-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-debuginfo-2.8.5-1.el7.x86_64.rpm
+ umask 022
+ cd /bigtop/build/hadoop/rpm//BUILD
+ cd hadoop-2.8.5-src
+ /usr/bin/rm -rf /bigtop/build/hadoop/rpm/BUILDROOT/hadoop-2.8.5-1.el7.x86_64
Executing(%clean): /bin/sh -e /var/tmp/rpm-tmp.uQ2FCn
+ exit 0
+ umask 022
Executing(--clean): /bin/sh -e /var/tmp/rpm-tmp.CwDb22
+ cd /bigtop/build/hadoop/rpm//BUILD
+ rm -rf hadoop-2.8.5-src
+ exit 0
[ant:touch] Creating /bigtop/build/hadoop/.rpm
:hadoop-rpm (Thread[Task worker for ':',5,main]) completed. Took 38 mins 1.151 secs.
:hadoop-pkg (Thread[Task worker for ':',5,main]) started.
> Task :hadoop-pkg
Task ':hadoop-pkg' is not up-to-date because:
Task has not declared any outputs despite executing actions.
:hadoop-pkg (Thread[Task worker for ':',5,main]) completed. Took 0.0 secs.
BUILD SUCCESSFUL in 40m 37s
6 actionable tasks: 6 executed
+ RESULT=0
+ mkdir -p output
+ docker cp
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb:/bigtop/build .
+ docker cp
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb:/bigtop/output .
+ docker rm -f ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
+ '[' 0 -ne 0 ']'
+ docker rm -f ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
Error: No such container:
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
BUILD SUCCESSFUL in 41m 24s
1 actionable task: 1 executed
Bygningen er utført med CentOS, men kan også utføres med Ubuntu:
.\/gradlew -POS=ubuntu-16.04 -Pprefix=1.2.1 hadoop-pkg-indI tillegg til å bygge pakker for forskjellige Linux-distribusjoner, kan verktøyet opprette et arkiv med de byggede pakkene, for eksempel:
.\/gradlew yumMan kan også huske på smoke-tester og distribusjon i docker.
Opprett en klynge med tre noder:
.\/gradlew -Pnum_instances=3 docker-provisionerKjør smoke-testene i en klynge med tre noder:
.\/gradlew -Pnum_instances=3 -Prun_smoke_tests docker-provisionerSlett klyngen:
.\/gradlew docker-provisioner-destroyFå kommandoer for å koble til inn i docker-containere:
.\/gradlew docker-provisioner-sshVis status:
.\/gradlew docker-provisioner-statusMan kan lese mer om distribusjonsoppgaver i dokumentasjonen.
Når det gjelder tester, er det et betydelig antall, hovedsakelig smoke- og integrasjonstester. Analysen deres faller utenfor rammen av denne artikkelen. Jeg vil bare si at bygging av distribusjonen ikke er så komplisert som det kan virke ved første øyekast. Alle komponentene vi bruker i produksjon har blitt samlet og testet, og vi har heller ikke hatt problemer med distribusjon og utføring av grunnleggende operasjoner i testmiljøet.
I tillegg til eksisterende komponenter i Bigtop, er det mulig å legge til noe mer, til og med egen programvareutvikling. Alt dette kan automatiseres godt og passer inn i CI/CD-konseptet.
Konklusjon
Det er åpenbart at et slik bygget distribusjon ikke skal sendes direkte til produksjon. Man må forstå at hvis det er et reelt behov for bygging og vedlikehold av sitt eget distribusjon, så må man investere både finansielt og tidsmessig.
Likevel, med riktig tilnærming og et profesjonelt team, er det helt mulig å klare seg uten kommersielle løsninger.
Det er viktig å merke seg at selve Bigtop-prosjektet trenger utvikling, og det ser ut til at det for tiden ikke skjer aktiv utvikling. Fremtiden for å inkludere Hadoop 3 i det er også usikker. For øvrig, hvis du har et reelt behov for å bygge Hadoop 3, kan du se på fra Arenadata, der det i tillegg til standard
komponentene også er en rekke ekstra (Ranger, Knox, NiFi).
Når det gjelder Rostelecom, er Bigtop et av alternativene vi vurderer for øyeblikket. Om vi velger det eller ikke, vil tiden vise.
Appendix
For å legge til en ny komponent i bygget, må du legge til beskrivelsen i bigtop.bom og ./bigtop-packages. Du kan prøve å gjøre dette ved å følge analogi med de eksisterende komponentene. Prøv å sette deg inn i det. Det er ikke så vanskelig som det ser ut ved første øyekast.
Hva mener du? Vi ser frem til å høre din mening i kommentarene, og takk for oppmerksomheten!
Artikkelen er forfattet av datastyringsteamet i 'Rostelecom'
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish