

Jeg har alltid vært interessert i hvordan jeg bedre kan organisere bøkene mine i det digitale biblioteket. Til slutt kom jeg til en løsning med automatisk telling av antall sider og andre nyttige funksjoner. Alle interesserte bes om å lese videre.
Del 1. Dropbox
Alle bøkene mine ligger på Dropbox. Jeg har delt dem opp i 4 kategorier: Lærebok, Oppslagsverk, Skjønnlitteratur, Faglitteratur. Men jeg legger ikke oppslagsverk inn i tabellen.
Størstedelen av bøkene er .epub, resten er .pdf. Så den endelige løsningen må dekke begge formatene.
Stiene til bøkene mine ser omtrent slik ut:
/Книги/Нехудожественное/Новое/Дизайн/Юрий Гордон/Книга про буквы от А до Я.epub Hvis boken er skjønnlitteratur, fjernes kategorien (det vil si 'Design' i dette tilfellet).
Jeg har bestemt meg for ikke å bruke Dropbox-API-et, heldigvis har jeg applikasjonen deres som synkroniserer mappen. Planen er derfor slik: vi henter bøker fra mappen, teller ord i hver bok og legger dem til i Notion.
Del 2. Legger til en rad
Tabellen skal se omtrent slik ut. MERK: kolonnenavnene er best å lage med latinske bokstaver.
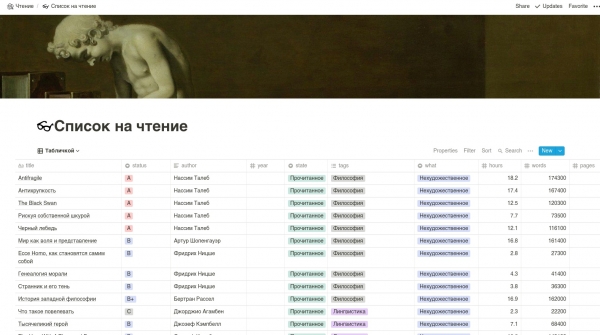
Vi skal bruke det uoffisielle API-et til Notion, fordi det offisielle ikke er tilgjengelig ennå.

Vi går til Notion, trykker Ctrl + Shift + J, går til Application -> Cookies, kopierer token_v2 og kaller det TOKEN. Deretter går vi til den nødvendige siden med bibliotektabellen og kopierer lenken. Kaller det NOTION.
Deretter skriver vi koden for å koble til Notion.
database = client.get_collection_view(NOTION)
current_rows = database.default_query().execute()
Videre skal vi skrive en funksjon for å legge til en rad i tabellen.
def add_row(path, file, words_count, pages_count, hours):
    row = database.collection.add_row()
    row.title = file

    tags = path.split("/")

    if len(tags) >= 1:
        row.what = tags[0]

    if len(tags) >= 2:
        row.state = tags[1]

    if len(tags) >= 3:
        if tags[0] == "Skjønnlitteratur":
            row.author = tags[2]

        elif tags[0] == "Faglitteratur":
            row.tags = tags[2]

        elif tags[0] == "Lærebøker":
            row.tags = tags[2]

    if len(tags) >= 4:
        row.author = tags[3]

    row.hours = hours
    row.pages = pages_count
    row.words = words_count
Hva skjer her. Vi tar og legger til en ny rad til tabellen i den første raden. Deretter splitter vi stien vår på '/' og får taggene. Taggene er i form av 'Skjønnlitteratur', 'Design', forfatter osv. Så setter vi alle nødvendige felter i tabellen.
Del 3. Teller ord, timer og andre detaljer
Dette er en litt mer komplisert oppgave. Som vi husker, har vi to formater: epub og pdf. Hvis det gjelder epub, så er det sannsynligvis ord der, men når det gjelder pdf er det ikke så entydig: det kan bestå av bare sammenkoblte bilder.
Så funksjonen for å telle ord i pdf vil se slik ut: vi tar antall sider og multipliserer med en bestemt konstant (gjennomsnittlig antall ord per side).
Her er den:
def get_words_count(pages_number):
    return pages_number * WORDS_PER_PAGE
Det mest WORDS_PER_PAGE for A4-sider er omtrent 300.
Nå la oss skrive en funksjon for å telle sidene. Vi vil bruke .
def get_pdf_pages_number(path, filename):
    pdf = PdfFileReader(open(os.path.join(path, filename), 'rb'))
    return pdf.getNumPages()
Deretter skriver vi et stykke for å telle sidene i epub. Vi bruker . Her tar vi boken, konverterer til linjer, og teller ord for hver linje.
def get_epub_pages_number(path, filename):
    book = open_book(os.path.join(path, filename))
    lines = convert_epub_to_lines(book)
    words_count = 0

    for line in lines:
        words_count += len(line.split(" "))

    return round(words_count / WORDS_PER_PAGE)
Nå skal vi beregne tiden. Vi tar vårt favorittantall ord og deler det på lesehastigheten din.
def get_reading_time(words_count):
    return round(((words_count / WORDS_PER_MINUTE) / 60) * 10) / 10
Del 4. Sammenkobler alle deler
Vi må gå gjennom alle mulige stier i mappen vår med bøker. Sjekk om boken allerede er i Notion: hvis den er der - trenger vi ikke å opprette en rad.
Deretter må vi bestemme filtypen, og basert på dette telle antall ord. Til slutt legge til boken.
Her er koden vi får:
for root, subdirs, files in os.walk(BOOKS_DIR):
    if len(files) > 0 and check_for_excusion(root):
        for file in files:
            array = file.split(".")
            filetype = file.split(".")[len(array) - 1]
            filename = file.replace("." + filetype, "")
            local_root = root.replace(BOOKS_DIR, "")

            print("Dir: {}, file: {}".format(local_root, file))

            if not check_for_existence(filename):
                print("Dir: {}, file: {}".format(local_root, file))

                if filetype == "pdf":
                    count = get_pdf_pages_number(root, file)

                else:
                    count = get_epub_pages_number(root, file)

                words_count = get_words_count(count)
                hours = get_reading_time(words_count)
                print("Pages: {}, Words: {}, Hours: {}".format(count, words_count, hours))
                add_row(local_root, filename, words_count, count, hours)
Og funksjonen for å sjekke om boken er lagt til, ser slik ut:
def check_for_existence(filename):
    for row in current_rows:
        if row.title in filename:
            return True

        elif filename in row.title:
            return True

    return False
Konklusjon
Takk til alle som leste denne artikkelen. Jeg håper den hjelper deg med å lese mer 🙂
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish