

Hei alle sammen! Jeg heter Pavel Agaletksy. Jeg jobber som teamleder i gruppen som utvikler Lamoda's leveringssystem. I 2018 deltok jeg på konferansen HighLoad++, og i dag ønsker jeg å presentere transkripsjonen av mitt foredrag.
Temaet mitt handler om erfaringene våre med å distribuere systemer og tjenester til ulike miljøer. Fra de første tidene våre, da vi distribuerte alle systemene til vanlige virtuelle servere, til den gradvise overgangen fra Nomad til distribusjon i Kubernetes. Jeg vil fortelle om hvorfor vi gjorde det og hvilke problemer vi møtte underveis.

Distribusjon av applikasjoner på VM
La oss begynne med at for 3 år siden ble alle systemene og tjenestene i selskapet distribuert på vanlige virtuelle servere. Teknisk sett var det lagt til rette slik at all koden for systemene våre ble plassert og bygget ved hjelp av automatisert bygging, med jenkins. Gjennom Ansible ble det rullet ut fra vårt versjonskontrollsystem til de virtuelle serverne. Hver av systemene i selskapet ble distribuerte minst på to servere: den ene på head, den andre på tail. Disse to systemene var helt identiske når det gjaldt alle innstillinger, kapasitet, konfigurasjon og så videre. Forskjellen mellom dem var bare at head-mottok brukertrafikk, mens tail aldri fikk brukertrafikk.
Hva var hensikten med dette?
Når vi distribuerte nye versjoner av applikasjonen vår, ønsket vi å sikre sømløs utrulling, det vil si uten merkbare konsekvenser for brukerne. Dette ble oppnådd ved at den nyeste bygde versjonen ble rullet ut til tail ved hjelp av Ansible. Der kunne folk som jobbet med distribusjonen sjekke og forsikre seg om at alt fungerte: alle målinger, seksjoner og applikasjoner var operative; nødvendige skript ble kjørt. Først etter at de forsikret seg om at alt var i orden, ble trafikken omdirigert. Den begynte å gå til den serveren som tidligere var tail. Og serveren som tidligere var head, forble uten brukertrafikk, men med den eksisterende eldre versjonen av applikasjonen vår.
Dermed var det sømløst for brukerne. Fordi overgangen er øyeblikkelig, ettersom det bare er en bytte av lastbalansereren. Det er veldig enkelt å rulle tilbake til forrige versjon ved å bare bytte lastbalansereren tilbake. Vi kunne også bekrefte applikasjonens evne til produksjon før brukertrafikken kom inn, noe som var ganske praktisk.
Hva så vi som fordeler med alt dette?
- Først og fremst er det enkelthen som fungerer. Alle forstår hvordan en slik distribusjonsordning fungerer, fordi de fleste har deployert på vanlige virtuelle servere.
- Det er relativtsikkert, ettersom distribusjonsteknologien er enkel og har blitt testet av tusenvis av selskaper. Millioner av servere distribueres på denne måten. Det er vanskelig å bryte noe.
- Og til slutt kunne vi få atomære distribusjoner.Distribusjoner som skjer øyeblikkelig for brukere, uten merkbare mellomtrinn mellom den gamle versjonen og den nye.
Men i alt dette så vi også noen ulemper:
- I tillegg til produksjonsmiljøet og utviklingsmiljøet, finnes det også andre miljøer. For eksempel QA og preproduksjon. På den tiden hadde vi mange servere og rundt 60 tjenester. Derfor måtte vi oppdatere den gjeldende versjonen av den virtuelle maskinen for hver tjeneste. Og hvis du vil oppdatere biblioteker eller installere nye avhengigheter, må du gjøre det i alle miljøene. Det var også nødvendig å synkronisere tidspunktet du planlegger å distribuere den nye versjonen av applikasjonen din med tidspunktet devops-teamet ville utføre de nødvendige miljøinnstillingene. I slike tilfeller er det lett å havne i en situasjon der miljøet vårt varierer noe mellom alle miljøene. For eksempel kan det være én versjon av bibliotekene i QA-miljøet, mens det er en annen i produksjon, noe som vil føre til problemer.
- Vanskeligheten med å oppdatere avhengighetene til applikasjonen din. Dette avhenger ikke av deg, men av et annet team. Nemlig devops-teamet som vedlikeholder serverne. Du må gi dem en passende oppgave og beskrive hva du ønsker å oppnå.
- På den tiden ønsket vi også å dele de store monolittene våre opp i separate små tjenester, ettersom vi forsto at antallet bare ville øke. På det tidspunktet hadde vi allerede over 100 av dem. Det var nødvendig å opprette en ny virtuell maskin for hver ny tjeneste, som også måtte vedlikeholdes og distribueres. I tillegg trengte vi ikke bare én maskin, men minst to. På toppen av det hele måtte vi også ha et QA-miljø. Dette skaper problemer og gjør opprettelsen og lanseringen av nye systemer mer komplisert, kostbart og tidkrevende.
Derfor besluttet vi at det ville være mer praktisk å gå fra å distribuere vanlige virtuelle maskiner til å distribuere appene våre i en Docker-container. Med Docker trenger man et system som kan kjøre applikasjonen i et klynge, siden man ikke bare kan løfte en container. Man vil vanligvis overvåke hvor mange containere som er oppe, for at de skal starte automatisk. Av den grunn måtte vi velge et administrasjonssystem.
Vi har tenkt mye over hvilke vi kan bruke. Saken er at på det tidspunktet var deploy-stacken for vanlige virtuelle servere litt utdatert, siden det var ikke de nyeste versjonene av operativsystemene. På et tidspunkt hadde vi til og med FreeBSD, som var litt upraktisk å vedlikeholde. Vi forsto at vi måtte migrere til Docker så raskt som mulig. Våre DevOps så på sin eksisterende erfaring med forskjellige løsninger og valgte et system som Nomad.
Overgangen til Nomad
Nomad er et produkt fra selskapet “HashiCorp”. De er også kjent for sine andre løsninger:
«Consul» — et verktøy for tjenesteregistrering.
«Terraform» — et system for serveradministrasjon som lar deg konfigurere dem via kode, såkalt infrastruktur-som-kode.
«Vagrant» lar deg distribuere virtuelle maskiner lokalt eller i skyen ved hjelp av spesifikke konfigurasjonsfiler.
Nomad virket på den tiden som en ganske enkel løsning som man raskt kunne gå over til uten å endre hele infrastrukturen. I tillegg er det lett å lære. Derfor valgte vi det som vårt system for filtrering av containere.
Hva trenger man for egentlig å distribuere systemet ditt i Nomad?
- Først og fremst trenger man docker image din applikasjonen. Det er nødvendig å bygge den og plassere den i et docker-bilde-lager. I vårt tilfelle er dette artifactory — et system som lar deg laste opp ulike artefakter av forskjellige typer. Det kan lagre arkiver, docker-bilder, composer-pakker for PHP, NPM-pakker og så videre.
- Det er også nødvendig konfigurasjonsfilen, som vil fortelle Nomad hva, hvor og i hvilken mengde du ønsker å deployere.
Når vi snakker om Nomad, bruker det HCL-språket i som format for informasjonsfilen, som står for HashiCorp Configuration Language. Dette er et oversett sett over Yaml som lar deg beskrive tjenestene dine i termer av Nomad.
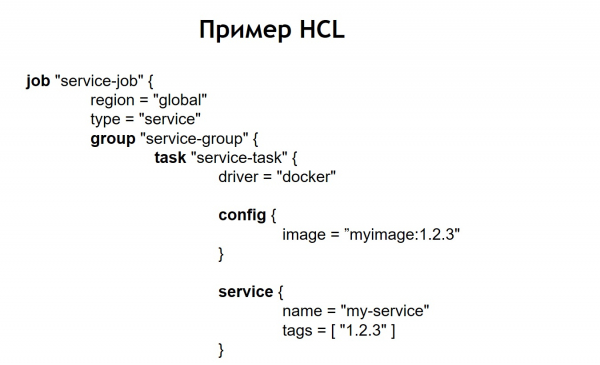
Det lar deg angi hvor mange containere du ønsker å deployere, fra hvilke bilder og hvilke forskjellige parametere du vil sende til dem under deployeringen. På denne måten gir du denne filen til Nomad, og den starter containerne i produksjon i samsvar med den.
I vårt tilfelle har vi innsett at det ikke ville være veldig praktisk å skrive helt identiske HCL-filer for hver tjeneste, fordi det er mange tjenester, og det kan noen ganger være nødvendig å oppdatere dem. Det hender at en tjeneste ikke er deployert i ett enkelt eksemplar, men i mange forskjellige. For eksempel har ett av systemene våre i produksjon mer enn 100 instanser i produksjon. De kjører fra samme bilder, men har forskjellige konfigurasjonsinnstillinger og konfigurasjonsfiler.
Derfor bestemte vi oss for at det ville være praktisk å lagre alle konfigurasjonsfilene våre for deployering i et felles repository. På denne måten ble de mer oversiktlige: de var enkle å vedlikeholde, og man kunne se hvilke systemer vi hadde. Ved behov kunne man også enkelt oppdatere eller endre noe. Å legge til et nytt system ville heller ikke være vanskelig — det er nok å opprette en konfigurasjonsfil innenfor en ny mappe. Inne i den ligger filene: service.hcl, som inneholder beskrivelsen av tjenesten vår, og noen env-filer som lar deg konfigurere denne tjenesten når den er deployert i produksjon.
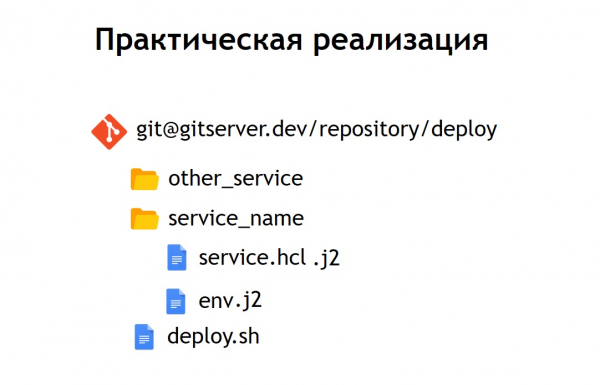
Imidlertid er noen av systemene våre deployert i produksjon ikke i ett enkelt eksemplar, men i flere samtidig. Derfor bestemte vi oss for at det ville være mer praktisk å lagre ikke konfigurasjonene i ren form, men i en malform. Som malingsspråk valgte vi jinja 2. I denne formen lagrer vi både konfigurasjoner for tjenesten og env-filer som den trenger.
I tillegg har vi plassert et felles deploy-script for alle prosjekter i depotet, som lar deg starte og deployere tjenesten din i produksjon, til ønsket miljø og mål. Når vi konverterte vår HCL-konfigurasjon til en mal, begynte HCL-filen som tidligere var en vanlig Nomad-konfigurasjon å se litt annerledes ut.
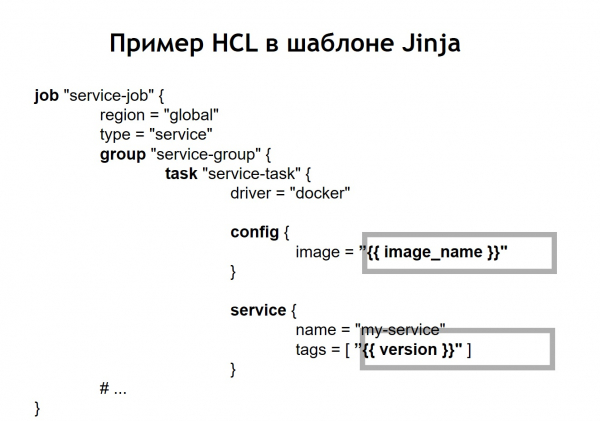
Det vil si at vi har erstattet noen variable plasser i konfigurasjonen med innsettinger for variabler som hentes fra env-filer eller andre kilder. I tillegg har vi fått muligheten til å generere HCL-filer dynamisk, slik at vi kan bruke ikke bare vanlige variable innsettinger. Siden jinja støtter sløyfer og betingelser, kan vi også lage konfigurasjonsfiler som endres avhengig av hvor du faktisk deployerer applikasjonene dine.
For eksempel, hvis du ønsker å deployere tjenesten din til preproduksjon og produksjon. La oss si at i preproduksjonen ønsker du ikke å kjøre cron-skript, men bare ser tjenesten på et eget domene for å forsikre deg om at den fungerer. For alle som deployerer en tjeneste, ser prosessen veldig enkel og gjennomsiktig ut. Det er bare å kjøre filen deploy.sh, angi hvilken tjeneste du ønsker å deployere og til hvilket mål. For eksempel, hvis du vil deployere et system til Russland, Hviterussland eller Kasakhstan. Da er det bare å endre ett av parameterne, så blir riktig konfigurasjonsfil generert.
Når Nomad-tjenesten allerede er deployert i klyngen din, ser den slik ut.
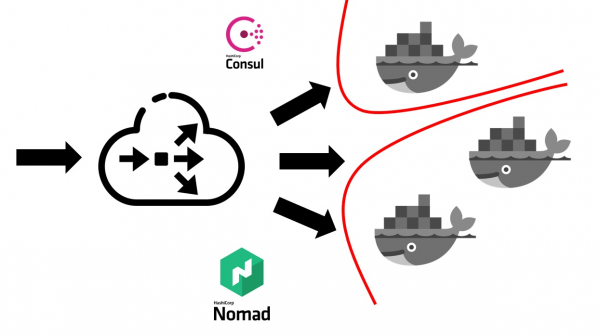
For det første trenger du en balancerer utenfor, som vil ta imot all brukertrafikken. Den vil jobbe sammen med Consul og spørre hvor, på hvilken node, hvilken IP-adresse spesifikk tjeneste som samsvarer med det eller det domenenavnet ligger. Tjenester i Consul kommer fra Nomad selv. Siden de er produkter fra samme selskap, er de godt knyttet sammen. Man kan si at Nomad som standard kan registrere alle tjenester som kjøres i den i Consul.
Når den eksterne balanseføreren har funnet ut hvilken tjeneste den skal sende trafikken til, omdirigerer den trafikken til den aktuelle beholderen eller flere beholdere som er relatert til applikasjonen din. Det er selvsagt nødvendig å tenke på sikkerheten også. Selv om alle tjenester kjører på de samme virtuelle maskinene i beholdere, er det vanligvis nødvendig å forby fri tilgang fra en tjeneste til en annen. Dette oppnådde vi gjennom segmentering. Hver tjeneste ble kjørt i sitt eget virtuelle nettverk, hvor routingsregler og regler for tilgangsforbud/ -tillatelse til andre systemer og tjenester var spesifisert. De kunne være både innenfor og utenfor denne klyngen. For eksempel, hvis du vil forby en tjeneste å koble seg til en bestemt database, kan dette gjøres ved å segmentere på nettverksnivå. Det vil si at du selv ved en feil ikke kan koble deg fra testmiljøet til produksjonsdatabasen din.
Hva kostet overgangen oss i menneskelige ressurser?
Overgangen av hele selskapet til Nomad tok omtrent 5-6 måneder. Vi gjorde det tjenestevis, men i et tilstrekkelig raskt tempo. Hver gruppe måtte lage sine egne beholdere for tjenestene.
Vi har en tilnærming der hver gruppe er ansvarlig for docker-bildene til sine egne systemer. DevOps gir nødvendig felles infrastruktur for distribusjon, altså støtte for selve klyngen, støtte for CI-systemet og så videre. På det tidspunktet hadde over 60 systemer migrert til Nomad, noe som resulterte i omtrent 2000 beholdere.
DevOps er ansvarlige for den felles infrastrukturen for alt relatert til distribusjon og servere. Hver utviklingsteam er igjen ansvarlig for implementeringen av beholdere for sitt spesifikke system, siden det er teamet som vet hva de faktisk trenger i den eller den beholderen.
Årsaker til å forlate Nomad
Hvilke fordeler fikk vi ved å gå over til distribusjon ved hjelp av Nomad og Docker?
- Vi vi sikret like forhold for all environments. In development, QA environments, pre-production, and production, the same container images with the same dependencies are used. Consequently, you have almost no chance that what ends up in production is different from what you previously tested locally or in a test environment.
- We also found that it is quite easy to add a new service. Any new systems from a deployment perspective launch very simply. You just need to go to the repository storing the configs, add another config for your system there, and you are ready. You can deploy your system to production without any additional efforts from DevOps.
- Alle configuration files in a common repository turned out to be reviewable. At the moment we deployed our systems using virtuelle servere, we used Ansible, where the configs were stored in the same repository. However, it was somewhat more complicated for most developers to work with this. The amount of configs and code you need to add to deploy the service became much smaller. Plus, it is very easy for DevOps to fix or change it. In the case of transitions, for example, to a new version of Nomad, they can easily mass-update all operational files stored in the same place.
But we also encountered several drawbacks:
It turned out that we could not achieve seamless deployments in the case of Nomad. When rolling out containers from different conditions, it could happen that it was running, and Nomad recognized it as ready to accept traffic container. This happened even before the application inside it managed to start. For this reason, the system would start returning 500 errors for a short period because traffic began flowing to a container that was not yet ready to accept it.
We faced some bugs. Den mest betydelige buggen er at Nomad ikke håndterer store klynger spesielt godt, hvis du har mange systemer og containere. Når du ønsker å ta en av serverne som er inkludert i Nomad-klyngen ut av drift, er det en ganske stor sjanse for at klyngen vil reagere dårlig og bryte sammen. Noen av containerne kan for eksempel krasje og ikke komme opp igjen - noe som vil koste deg mye hvis alle systemene dine i produksjon befinner seg i klyngen som administreres av Nomad.
Derfor har vi bestemt oss for å tenke på hvor vi skal gå videre. På det tidspunktet hadde vi blitt mye mer bevisste på hva vi ønsket å oppnå. Nemlig: vi vil ha pålitelighet, litt flere funksjoner enn det Nomad tilbyr, og et mer modent, mer stabilt system.
I denne hensikten falt valget vårt på Kubernetes som den mest populære plattformen for å kjøre klynger. Spesielt gitt at størrelsen og antallet av containerne våre var ganske stort. For slike formål virket Kubernetes som det mest passende systemet av de vi kunne vurdere.
Overgangen til Kubernetes
La meg fortelle litt om hvilke grunnleggende begreper Kubernetes har og hvordan de skiller seg fra Nomad.
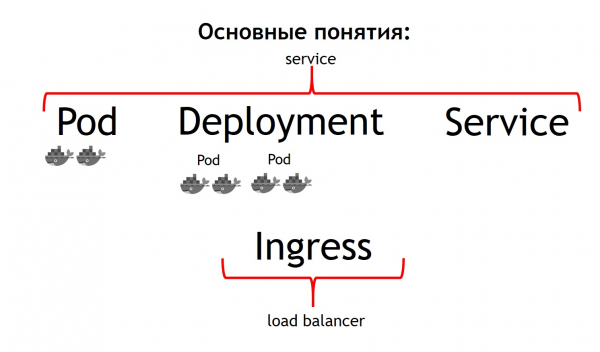
Det første og mest grunnleggende begrepet i Kubernetes er begrepet pod. Pod — det er en gruppe med én eller flere containere som alltid kjøres sammen. Og de fungerer som om de alltid er på en og samme virtuelle maskin. De er tilgjengelige for hverandre via IP-adressen 127.0.0.1 på forskjellige porter.
La oss anta at du har en PHP-applikasjon som består av nginx og php-fpm – en klassisk ordning. Sannsynligvis vil du at både nginx- og php-fpm-containerne alltid skal være sammen. Kubernetes gjør det mulig å oppnå dette ved å beskrive dem som en felles pod. Akkurat dette klarte vi ikke å oppnå med Nomad.
Det andre begrepet er deployment. Poenget er at en pod i seg selv er en flyktig ting, den startes og forsvinner. Ønsker du å først drepe alle dine tidligere containere, og så starte opp nye versjoner med en gang, eller ønsker du å rulle dem ut gradvis – nettopp denne prosessen er det begrepet deployment ansvarlig for. Det beskriver hvordan du distribuerer dine pods, i hvilken mengde og hvordan du oppdaterer dem.
Det tredje begrepet er tjeneste. Tjenesten din er faktisk systemet ditt, som mottar en viss trafikk, og deretter sender den til en eller flere pod-er som tilsvarer tjenesten din. Dette betyr at den lar deg spesifisere at all innkommende trafikk til en bestemt tjeneste med et bestemt navn må sendes til nettopp disse pod-ene. I tillegg gir den deg trafikkbalansering. Dette betyr at du kan starte to pod-er av applikasjonen din, og all innkommende trafikk vil bli jevnt balansert mellom de pod-ene som er tilknyttet denne tjenesten.
Og det fjerde hovedbegrepet — Ingress. Dette er en tjeneste som kjører i et Kubernetes-kluster. Den fungerer som en ekstern belastningsbalanserer som håndterer alle forespørslene. Gjennom Kubernetes API kan Ingress bestemme hvor disse forespørslene skal sendes. Dessuten gjør den dette veldig fleksibelt. Du kan si at alle forespørslene til denne vertsnavnet og den spesifikke URL-en skal sendes til denne tjenesten. Og de forespørslene som kommer til dette vertsnavnet og en annen URL sendes til en annen tjeneste.
Det mest fantastiske for utvikleren av applikasjonen er at du kan administrere alt dette selv. Ved å sette opp Ingress-konfigurasjonen kan du sende all trafikk som kommer til en viss API til separate containere, for eksempel skrevet i Go. Og denne trafikken som kommer til samme domene, men til en annen URL, kan sendes til containere skrevet i PHP, hvor det er mye logikk, men de er ikke veldig raske.
Hvis vi sammenligner alle disse begrepene med Nomad, kan vi si at de tre første begrepene utgjør en samlet Tjeneste. Det siste begrepet finnes ikke i selve Nomad. Vi brukte en ekstern belastningsbalanserer som kan være haproxy, nginx, nginx+ og så videre. I tilfelle med Kubernetes trenger du ikke å introdusere dette ekstra begrepet separat. Men hvis du ser på Ingress, kan det være enten nginx, haproxy eller traefik, men integrert i Kubernetes.
Alle de begrepene jeg har beskrevet er i bunn og grunn ressurser som eksisterer innenfor et Kubernetes-kluster. For deres beskrivelse i Kubernetes brukes yaml-formatet, som er mer lesbart og kjent enn HCL-filer i tilfelle med Nomad. Men strukturelt beskriver de i eksempelvis en pod det samme. De sier – jeg vil distribuere disse pod-ene dit, med disse bildene, i dette antallet.
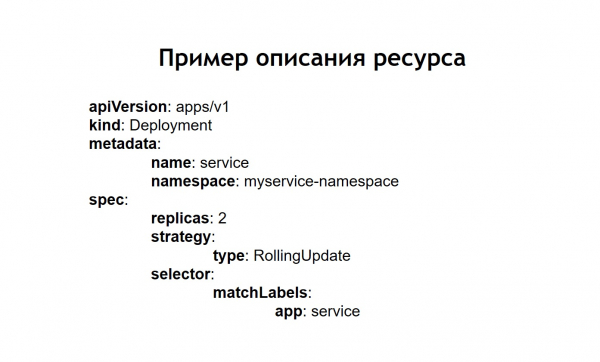
I tillegg forsto vi at vi ikke ønsket å opprette hver enkelt ressurs manuelt: deployment, tjenester, Ingress og så videre. I stedet ønsket vi å beskrive hvert system vi har ved distribusjon i termer av Kubernetes, slik at vi ikke måtte rekonstruere alle nødvendige avhengigheter i riktig rekkefølge for hånd. For et slikt system ble Helm valgt.
Grunnleggende konsepter i Helm
Helm er en pakkehåndterer pakkeadministrator for Kubernetes. Det ligner veldig på hvordan pakkehåndterere fungerer i programmeringsspråk. De lar deg lagre tjenester, for eksempel en nginx deployment, en php-fpm deployment, konfigurasjon for Ingress, configmaps (som er en enhet som lar deg angi miljøvariabler og andre parametere for systemet ditt) i såkalte charts. Helm opererer over Kubernetes. Det vil si at det ikke er et system som står på siden, men bare en annen tjeneste som kjører inne i klyngen. Du kommuniserer med det via API-et gjennom kommandolinjen. Den største fordelen er at selv om helm krasjer eller du fjerner det fra klyngen, så forsvinner ikke tjenestene dine, siden helm i bunn og grunn bare brukes til å starte systemet. Funksjonalitet og tilstand til tjenestene videre anses av Kubernetes selv.
Vi forsto også at malbasert programmering, som vi tidligere var nødt til å gjøre selv ved å implementere jinja i konfigurasjonene våre, er en av de viktigste funksjonene til helm. Alle konfigurasjoner du lager for systemene dine lagres i helm som maler, som ligner litt på jinja, men faktisk bruker Go-språkets malbaserte system, som helm er skrevet på, akkurat som Kubernetes.
Helm gir oss også flere andre konsepter.
Chart er en beskrivelse av tjenesten din. I andre pakkehåndterere ville det bli kalt en pakke, et bundt eller noe lignende. Her kalles det chart.
Values er variablene du ønsker å bruke for å bygge konfigurasjonene dine fra malene.
ReleaseHver gang en tjeneste som deployeres med helm, får en inkrementell versjon av utgivelsen. Helm husker hvordan tjenesten var konfigurert ved forrige, forrige forrige utgivelse, og så videre. Derfor, hvis du må rulle tilbake, er det bare å utføre kommandoen helm callback, og spesifisere forrige versjon av utgivelsen. Selv om den tilsvarende konfigurasjonen ikke er tilgjengelig i ditt depot ved tidspunktet for tilbakeføringen, husker helm fortsatt hvordan den var, og vil tilbakeføre systemet ditt til tilstanden det var i ved den forrige utgivelsen.
Når vi bruker helm, blir vanlige konfigurasjoner for Kubernetes også til maler der det er mulig å bruke variabler, funksjoner og anvende betingede operatorer. På denne måten kan du bygge konfigurasjonen av tjenesten din avhengig av miljøet.
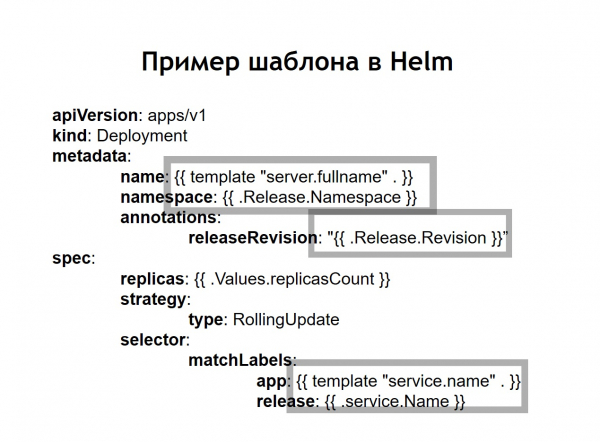
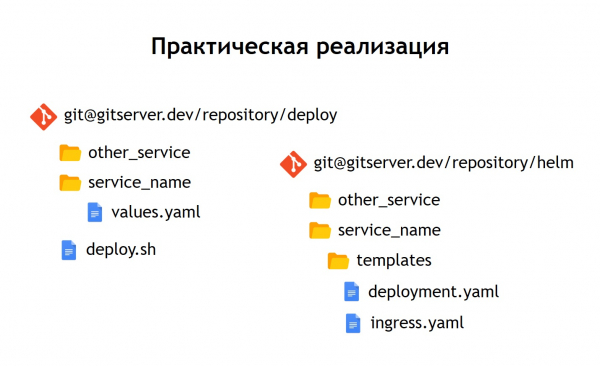
I praksis har vi besluttet å gjøre det litt annerledes enn vi gjorde med Nomad. Hvis i Nomad ble konfigurasjoner for deployering og n-variabler som er nødvendige for å deployere tjenesten vår lagret i ett depot, så har vi her valgt å dele dem opp i to separate depoter. I depoten 'deploy' lagres kun n-variabler som er nødvendige for deployering, mens i depoten 'helm' lagres konfigurasjoner eller diagrammer.
Hva fikk vi ut av dette?
Selv om vi ikke oppbevarer noen virkelig sensitive data i selve konfigurasjonsfilene, for eksempel passord til databaser, som lagres som secrets i Kubernetes, er det fortsatt separate ting som vi ikke vil gi tilgang til alle. Derfor er tilgangen til depoten 'deploy' mer begrenset, mens depoten 'helm' bare inneholder en beskrivelse av tjenesten. Av denne grunn kan tilgang gis til et større antall personer på en sikker måte.
Siden vi har ikke bare produksjon, men også andre miljøer, kan vi takket være denne oppdelingen gjenbruke helm-diagrammene våre for å deployere tjenester ikke bare i produksjon, men også for eksempel i QA-miljøet. Selv for å kjøre dem lokalt ved å bruke Minikube — det er en slik ting for lokal kjøring av Kubernetes.
Inni hvert repositorium har vi gjort en inndeling i separate mapper for hver tjeneste. Det vil si at innvendig hver mappe finnes maler som er relatert til den aktuelle charten og beskriver de ressursene som må distribueres for å starte systemet vårt. I repositoriet «deploy» har vi kun inkludert env-filer. I dette tilfellet har vi ikke brukt templatisering med jinja, fordi helm selv gir templatisering «out of the box» – dette er en av kjernene funksjonene.
Vi har inkludert et skript for distribusjon – deploy.sh, som forenkler og standardiserer oppstarten for distribusjon ved hjelp av helm. Dermed ser distribusjonsgrensesnittet akkurat det samme ut for alle som vil distribuere, som i tilfellet med distribusjon via Nomad. Samme deploy.sh, navnet på tjenesten din, og hvor du ønsker å distribuere den. Dette fører til at helm startes internt. Det samler konfigurasjonene fra malene, setter inn de nødvendige values-filene, og distribuerer dem så inn i Kubernetes.
Konklusjoner
Kubernetes-tjenesten ser mer kompleks ut enn Nomad.
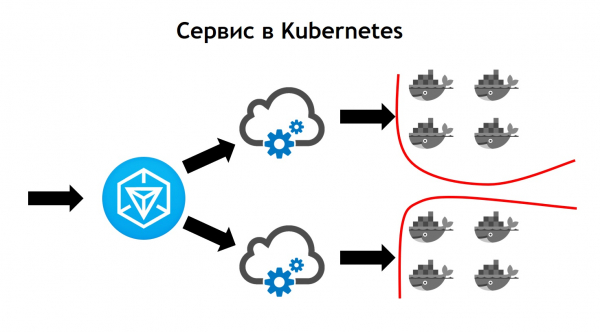
Her kommer den utgående trafikken inn i Ingress. Dette er nettopp frontend-kontrolleren som tar imot alle forespørslene og deretter sender dem til de aktuelle tjenestene basert på forespørselen. Den bestemmer dem basert på konfigurasjoner som er en del av beskrivelsen av applikasjonen din i helm og som utviklerne angi selv. Tjenesten sender forespørslene til sine pods, det vil si spesifikke containere, og balanserer den innkommende trafikken mellom alle containerne som tilhører denne tjenesten. Og selvfølgelig bør vi ikke glemme at vi ikke kan forlate sikkerheten på nettverksnivå. Derfor fungerer segmenteringen i Kubernetes-klyngen basert på merking. Alle tjenester har bestemte merker, som er knyttet til rettighetene til tjenestene til ulike eksterne/intern ressurser inne i eller utenfor klyngen.
Når vi gjorde overgangen, så vi at Kubernetes hadde alle funksjonene til Nomad, som vi hadde brukt tidligere, og flere nye tillegg. Det kan utvides via plugins, og faktisk ved hjelp av egendefinerte ressurs typer. Det vil si at du har mulighet til ikke bare å bruke det som følger med Kubernetes, men også til å lage din egen ressurs og tjeneste som kan lese denne ressursen. Dette gir ekstra muligheter for å utvide systemet ditt uten å måtte reinstallere Kubernetes og uten å måtte endre noe.
Et eksempel på slik bruk er Prometheus, som kjører i klyngen vår av Kubernetes. For at det skal begynne å samle inn målinger fra en bestemt tjeneste, må vi legge til en ekstra ressurs type i tjenestebeskrivelsen, kalt en tjenestemonitor. Takket være at Prometheus kan lese egendefinerte ressurs typer når det kjøres i Kubernetes, begynner det automatisk å samle inn målinger fra det nye systemet. Dette er ganske praktisk.
Den første deployeringen vi gjorde i Kubernetes var i mars 2018. Og i løpet av denne tiden har vi aldri opplevd noen problemer med det. Det fungerer ganske stabilt uten betydelige feil. I tillegg kan vi utvide det videre. I dag er vi fornøyd med de mulighetene som finnes, og vi liker utviklingstakten til Kubernetes. For tiden er det over 3000 containere i Kubernetes. Klyngen består av flere noder. Den er selvbetjent, stabil og svært kontrollerbar.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish