

Innledning
Informasjonssystemet blir godt definert sett fra brukerens perspektiv i GOST RV 51987 – «et automatisert system, hvor resultatet av driften er presentasjon av utdata for videre bruk». Hvis vi ser på den interne strukturen, så er i prinsippet ethvert IS et system av sammenkoblede algoritmer realisert i kode. I en bredere forståelse av Turing-Church-teoremet, utfører algoritmen (og dermed IS) en transformasjon av mange inngangsdata til mange utgangsdata.
Man kan til og med si at meningen med en informasjonssystems eksistens ligger i transformasjonen av inngangsdata. Dermed defineres verdien av IS og hele komplekset av IS gjennom verdien av inngangs- og utgangsdata.
Basert på dette bør designprosessen starte med å ta utgangspunkt i dataene, og tilpasse arkitekturen og metodene til strukturen og betydningen av disse dataene.
Lagrende data
En nøkkelkomponent i forberedelsene til design er å skaffe egenskaper for alle datamengder planlagt for behandling og lagring. Disse egenskapene inkluderer:
— Datamengde;
— Informasjon om datalivssyklusen (vekst av nye data, levetid, behandling av foreldede data);
— Klassifisering av data ut fra deres påvirkning på selskapets kjernevirksomhet (i forhold til konfidensialitet, integritet, tilgjengelighet) sammen med finansielle indikatorer (f.eks. kostnadene ved datatap det siste timen);
— Geografi for behandlingen av data (fysisk plassering av behandlingssystemer);
— Reguleringers krav for hver dataklasse (f.eks. FZ-152, PCI DSS).
Informasjonssystemer
Data lagres ikke bare, men behandles (transformeres) også av informasjonssystemer. Neste trinn etter å ha innhentet datakarakteristikker er en så fullstendig oversikt som mulig over informasjonssystemene, deres arkitektoniske særegenheter, gjensidig avhengighet og krav til infrastruktur i vilkårlige enheter for de fire ressurskategoriene:
— Prosessorberegningskraft;
— Mengde RAM;
— Krav til volum og ytelse av lagringssystemet;
— Krav til datanettverket (eksterne kanaler, kanaler mellom komponentene i IS).
Kravene må være til stede for hver tjeneste/mikrotjeneste i informasjonssystemet.
Det er viktig å påpeke at det er nødvendig med data om innvirkningen av informasjonssystemet på selskapets hovedvirksomhet i form av kostnaden av driftsstopper for informasjonssystemet (rubler per time).
Trusselmodell
Det må på plass en formell trusselmodell som beskriver hvilke trusler data/tjenester skal beskyttes mot. Denne modellen omfatter ikke bare aspekter av konfidensialitet, men også integritet og tilgjengelighet. Det vil si for eksempel:
— Feil på fysisk server;
— Feil på top-of-the-rack switch;
— Brudd på optisk samband mellom datasentre;
— Feil på aktiv lagringsløsning totalt.
I noen tilfeller skrives trusselmodeller ikke bare for infrastrukturelle komponenter, men også for spesifikke informasjonssystemer eller deres komponenter, som for eksempel svikt i databasesystemet med logisk ødeleggelse av databasens struktur.
Alle beslutninger innen prosjektet for å beskytte mot ubeskrevne trusler er overflødige.
Regulatoriske krav
Hvis de behandlede dataene faller under spesielle regler fastsatt av regulatorer, er det obligatorisk å ha informasjon om datasett og regler for behandling/lagring.
Målverdier for RPO/RTO
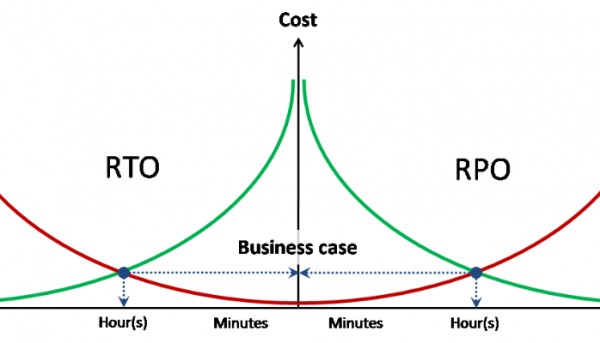
Prosjektering av enhver form for beskyttelse krever tilstedeværelse av målverdier for tap av data og målverdier for gjenopprettingstid av tjeneste for hver av de beskrevne truslene.
Ideelt sett bør RPO og RTO ha tilknyttede kostnader for datatap og driftsstans per enhet tid.
Oppdeling i ressurspooler
Etter å ha samlet all innledende informasjonsinnhold, er det første steget å gruppere datasett og informasjonssystemer i pooler, basert på trusselmodeller og regulatoriske krav. Det bestemmes hvilken type inndeling av forskjellige pooler som benyttes – programmatisk på systemnivå eller fysisk.
Eksempler:
— Konturene som behandler personopplysninger er helt fysisk adskilt fra andre systemer;
— Sikkerhetskopier lagres på separate lagringsløsninger.
Poolene kan også ha ufullstendig uavhengighet, for eksempel kan det defineres to pooler for databehandlingsressurser (prosessorkraft + RAM), som bruker et felles lagringsområde og et felles datakommunikasjonsressursområde.
Prossessorbasert kapasitet
De abstrakte behov for prosessorstørrelse i en virtualisert datasenter måles i antall virtuelle prosessorer (vCPU) og konsolideringsfaktoren deres på fysiske prosessorer (pCPU). I dette spesifikke tilfellet er 1 pCPU = 1 fysisk prosessorkjerne (uten hensyn til Hyper-Threading). Antallet vCPU summeres over alle definerte ressursbassenger (hver av dem kan ha sin egen konsolideringsfaktor).
Konsolideringsfaktoren for belastede systemer oppnås empirisk, basert på den eksisterende infrastrukturen eller ved pilotinstallasjon og belastningstesting. For ubearbeidede systemer brukes «beste praksis». Spesifikt angir VMware en gjennomsnittlig konsolideringsfaktor på 8:1.
RAM
Den totale behovet for arbeidsminne oppnås ved enkel summering. Bruk av overbookede minne anbefales ikke.
Lagringsressurser
Kravene til lagringsressurser fås ved enkel summering av alle bassenger etter volum og ytelse.
Ytelseskravene uttrykkes i IOPS kombinert med det gjennomsnittlige forholdet mellom lesing/skriving og ved behov maksimal responstid.
Krav til tjenestekvalitet (QoS) må spesifiseres separat for bestemte bassenger eller systemer.
Nettverksressurser
Kravene til nettverkskapasitet oppnås ved enkel summering av alle bassenger.
Krav til tjenestekvalitet (QoS) og forsinkelser (RTT) må spesifiseres separat for bestemte bassenger eller systemer.
Innenfor kravene til nettverksressurser må også krav til isolasjon og/eller kryptering av nettverkstrafikk og foretrukne mekanismer (802.1q, IPSec osv.) angis.
Valg av arkitektur
I denne veiledningen vurderes det ikke noe annet valg enn x86-arkitektur og 100% servervirtualisering. Derfor reduseres valget av databehandlingssubsystemets arkitektur til valget av servervirtualiseringsplattform, serverformfaktor og generelle krav til serverkonfigurasjon.
Nøkkelpunktene i valget er avklarte valg mellom den klassiske tilnærmingen som skiller funksjonene for behandling, lagring og overføring av data eller konvergerende.
Klassisk arkitektur inneber å bruke intelligente eksterne lagrings- og datatransfer systemer, mens serverne bare tilfører den fysiske ressursbeholdningen prosessorkraft og RAM. I ytterste fall blir serverne helt anonyme og har ikke bare egne disker, men heller ikke et systemidentifikator. I slike tilfeller brukes det å starte OS eller hypervisor fra innebygde flash-minner eller fra et eksternt lagringssystem (boot from SAN).
Innen klassisk arkitektur gjøres valget mellom blad (blade) og rack-servere først og fremst ut fra følgende prinsipper:
— Kostnadseffektivitet (rack-servere er i gjennomsnitt billigere);
— Beregningsdybde (blader har høyere tetthet);
— Strømforbruk og varmedannelse (blader har høyere spesifikk forbruk per enhet);
— Skalerbarhet og håndterbarhet (blader krever generelt mindre innsats ved store installasjoner);
— Bruk av utvidelseskort (det er et svært begrenset utvalg for blader).
Konvergent arkitektur (også kjent som hyperkonvergent) innebærer en fusjon av data behandlings- og lagringsfunksjoner, noe som fører til bruken av lokal disker i serverne og dermed oppgivelsen av formfaktoren til klassiske blader. For konvergerte systemer brukes enten rack-servere eller klyngesystemer som kombinerer flere bladere servere og lokale disker i et enkelt kabinett.
CPU / Minne
For å beregne konfigurasjonen riktig må man forstå typen belastning for miljøet eller hver av de uavhengige klyngene.
CPU bound – et miljø som er begrenset av prosesseringskraften til CPU. Tillegget av mer RAM vil ikke endre noe med hensyn til ytelsen (antall VM på serveren).
Memory bound – et miljø som er begrenset av RAM. Mer RAM på serveren lar deg kjøre flere VM-er.
GB / MHz (GB / pCPU) – det gjennomsnittlige forholdet mellom RAM-forbruket til denne spesifikke belastningen og prosessorkraften. Kan brukes til å beregne nødvendig minnevolum ved angitt ytelse og omvendt.
Beregning av serverkonfigurasjon
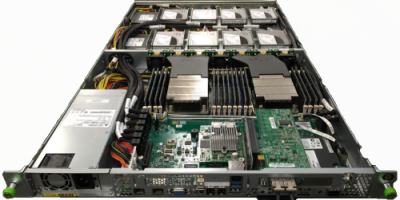
Først må vi identifisere alle typer belastning og ta en beslutning om å kombinere eller skille forskjellige beregningspuljer i ulike klynger.
Deretter bestemmes forholdet GB / MHz for hver av de definerte klustrene med en kjent belastning. Hvis belastningen ikke er kjent på forhånd, men det er en omtrentlig forståelse av prosessorens belastningsnivå, kan man bruke standardforholdene vCPU:pCPU for å oversette kravene fra puljene til fysisk.
For hver klynge deler vi summen av vCPU-kravene på forholdet:
vCPU_summ / vCPU:pCPU = pCPU_summ – nødvendig antall fysiske kjerner
pCPU_summ / 1.25 = pCPU_ht – antall kjerner med justering for Hyper-Threading
La oss anta at vi må gjøre beregninger for en klynge med 190 kjerner / 3.5 TB RAM. Her tar vi en målet belastning på 50% av prosessorkraften og 75% for RAM.
pCPU
190
CPU-util
50%
Minne
3500
Minne-util
75%
Socket
Kjerne
Srv / CPU
Srv Minne
Srv / Minne
2
6
25,3
128
36,5
2
8
19,0
192
24,3
2
10
15,2
256
18,2
2
14
10,9
384
12,2
2
18
8,4
512
9,1
I dette tilfellet bruker vi alltid avrunding til nærmeste hele oppover (=ROUNDUP(A1;0)).
Fra tabellen blir det tydelig at flere konfigurasjoner av servere er balanserte etter målverdiene:
— 26 servere 2*6c / 192 GB
— 19 servere 2*10c / 256 GB
— 10 servere 2*18c / 512 GB
Valget mellom disse konfigurasjonene må baseres på tilleggsskader som varmeutvikling og tilgjengelig kjøling, allerede eksisterende servere, eller kostnad.
Egenskaper ved valg av serverkonfigurasjon
Bred VM. Når det er behov for å plassere brede VM (sammenlignbare med 1 NUMA-nod og mer), anbefales det å velge en serverkonfigurasjon som tillater slike VM å forbli innenfor NUMA-noden. Når vi har mange brede VM, oppstår det en risiko for fragmentering av klyngeressursene, og i slike tilfeller velges servere som muliggjør en tettere plassering av brede VM.
Størrelsen på domenet for enkeltfeil.
Valget av serverstørrelse styres også av prinsippet om å minimere domenet for enkeltfeil. For eksempel ved valg mellom:
— 3 x 4*10c / 512 GB
— 6 x 2*10c / 256 GB
Ved ellers like betingelser må man velge det andre alternativet, ettersom når en server svikter (eller er under vedlikehold) går ikke 33% av klynge ressursene tapt, men 17%. På samme måte reduseres antallet VM-er og IS-er som ble berørt av hendelsen med det halve.
Beregning av klassisk lagringsytelse
Klassisk lagringsytelse beregnes alltid ut fra worst case scenario, uten å ta hensyn til innvirkningen av hurtigminnekontroller og optimering av operasjoner.
Som grunnleggende ytelsesparametre tar vi hensyn til den mekaniske ytelsen fra disken (IOPSdisk):
— 7.2k – 75 IOPS
— 10k – 125 IOPS
— 15k – 175 IOPS
Deretter beregnes antall disker i diskpoolen etter følgende formel: = TotalIOPS * ( RW + (1 –RW) * RAIDPen) / IOPSdisk. Hvor:
— TotalIOPS – samlet nødvendig ytelse i IOPS fra diskpoolen
— RW – prosentandel av leseoperasjoner
— RAIDpen – RAID-straff for valgt RAID-nivå
Mer om RAID-enhet og RAID-straff finnes her — og og
Basert på det beregnede antallet disker, beregnes mulige alternativer som tilfredsstiller lagringskapasitetskravene, inkludert alternativer med flertrinnslagring.
Beregning av systemer med SSD som lagringsnivå vurderes separat.
Egenskaper ved beregning av systemer med Flash Cache
Flash Cache – det generelle navnet for alle merkespesifikke teknologier som bruker flash-minne som et sekundært cache. Ved bruk av flash-cache beregnes lagringsytelsen vanligvis for å imøtekomme stabil belastning fra magnetiske disker, mens toppbelastningen dekkes av cachen.
Det er nødvendig å forstå lastprofilen og graden av lokalisering av forespørslene til volumene. Flash-cache er en teknologi for belastninger med høy lokalisering av forespørslene, og er praktisk talt ikke anvendbar for jevnt belastede volumer (som for eksempel for analysesystemer).
Beregning av hybrid systemer low-end / mid-range
Hybrid systemer av lav og middels klasse bruker flertrinnslagring med dataoverføring mellom nivåene etter en tidsplan. I denne sammenheng har beste modeller et lagringsblokkstørrelse på 256 MB. Disse egenskapene lar oss ikke betrakte flertrinnslagringsteknologien som en ytelsesøkningsmetode, som mange feilaktig antar. Flertrinnslagring i systemer av lav og middels klasse er en kostnadsoptimeringsteknologi for lagringssystemer med tydelig ujevn belastning.
For multi-tiered storage, performance at the upper tier is primarily calculated, while the lower storage tier is considered only as a supplementary source of storage capacity. For a hybrid multi-tiered system, the use of flash cache technology in the multi-tier pool is essential to compensate for performance drops for suddenly heated data from the lower tier.
Using SSD in a multi-tier disk pool
The use of SSD in a multi-tier disk pool varies depending on the specific implementation of flash cache algorithms by the manufacturer.
The general practice for storage policy for a disk pool with SSD level is SSD first.
Read Only Flash Cache. For read-only flash cache, the storage level on SSD appears with significant localization of write operations regardless of the cache.
Read / Write Flash Cache. In the case of write flash cache, the maximum cache size is set first, and the storage level on SSD appears only when the cache size is insufficient to handle the entire localized load.
The performance of SSD and cache is calculated each time based on the manufacturer's recommendations, but always for the worst-case scenario.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish