

Basert på diskusjonen i chatten
Det har pågått ekte kamper i det siste om definisjonen av begrepene DevOps og SRE.
Selv om diskusjonene om dette emnet har blitt gjentatt mange ganger, inkludert av meg selv, bestemte jeg meg for å ta opp temaet i Habr-samfunnet og dele mine synspunkter. De som er interesserte, er velkomne under katte. Og la oss starte alt på nytt!
Bakgrunn
Så, i gamle dager var det en separat gruppe programvareutviklere og serveradministratorer. De første skrev koden, mens de andre, med ulike varme og kjærlige ord til de første, satte opp servere, og kom innom utviklerne på periodisk basis for å få det uttømmende svaret 'det fungerer på maskinen min'. Virksomheten ventet på programvaren, alt sto stille, oppstod problemer, og alle var nervøse. Spesielt den som betalte for alt dette rotet. Den gode gamle tiden. Vel, dere vet jo hvor DevOps stammer fra.
Fødsel av DevOps praksiser
Så kom seriøse karer og sa — dette er ikke industrien, slik kan vi ikke jobbe. Og de dro frem livssyklusmodeller. For eksempel V-modellen.
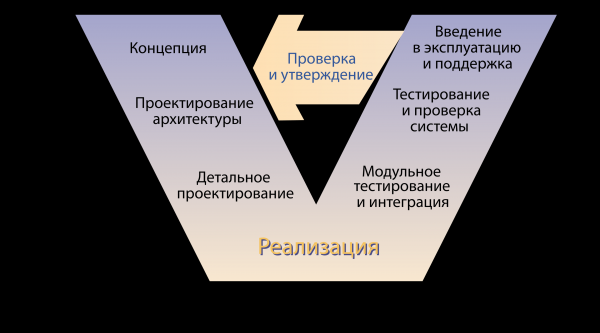
Så, hva ser vi? Virksomheten kommer med en konsept, arkitektene designer løsninger, utviklerne skriver koden, og så — en kollaps. Noen tester produktet på en eller annen måte, noen leverer det til sluttbrukeren, og et sted på utgangen av denne mirakuløse modellen sitter en ensom forretningsbestiller og venter på det lovede av havet. Det ble konkludert med at det trengs metoder som kan organisere denne prosessen. De bestemte seg for å opprette praksiser for å realisere dette.
Litt om hva jeg mener med praksis
Med praksis forstår jeg en kombinasjon av teknologi og disiplin. Et eksempel — praksisen av å beskrive infrastruktur med kode i terraform. Disiplin er måten koden beskriver infrastrukturen, det ligger i hodet på utvikleren, mens teknologien er selve terraform.
De bestemte seg for å kalle dem DevOps-praksiser — jeg antar de mente fra utvikling til drift. De fant på forskjellige intrikate konsepter — CI/CD-praksiser, praksiser basert på IaC-prinsippet, tusenvis av dem. Og det begynte, utviklerne skriver kode, DevOps-ingeniørene transformerer systembeskrivelsen i kode til fungerende systemer (ja, koden er dessverre bare en beskrivelse og ikke selve systemet), leveringen ruller, og så videre. Tidligere administratorer, som mestret de nye praksisene, skiftet stolt til DevOps-ingeniører, og alt begynte. Og det var kveld, og det var morgen… beklager, ikke derfra.
Alt er ikke bra igjen
Bare ting hadde lagt seg, og forskjellige smarte «metodologer» begynte å skrive tjukke bøker om DevOps-praksiser, og debattene blusset stille opp om hvem den beryktede DevOps-ingeniøren egentlig er, og at DevOps er en produksjonskultur, og misnøyen begynte å boble opp. Det ble plutselig oppdaget at programvarelevering er en helt ikke-triviell oppgave. Hver utviklingsinfrastruktur har sin egen teknologistack, noen steder må man samle, noen steder må man rulle ut miljøet, her trenger man tomcat, her er det behov for en mer komplisert måte å starte — så hodet spinner. Og så var faktisk problemet, merke det eller ei, først og fremst organiseringen av prosessene — denne leveringsfunksjonen, som en flaskehals, begynte å blokkere prosessene. I tillegg ble drift (Operations) ikke avskaffet. Den er ikke synlig i V-modellen, men der er hele livssyklusen til høyre. Til slutt må man også opprettholde infrastrukturen, overvåke, håndtere hendelser, og samtidig jobbe med leveranser. Det vil si, sitte med ett bein i utvikling og ett bein i drift — og plutselig fikk man en slik Development & Operations. Og så kom det et stort hype for mikroservere. Og med dem begynte utviklingen fra lokale maskiner å flytte til skyen — prøv å debuggere noe lokalt når det er titalls og hundrevis av mikroservere, her blir kontinuerlig leveranse et middel for å overleve. For en «liten beskjeden bedrift» er det klart at det går an, men hva med Google?
SRE fra Google
Så kom Google, spiste de største kaktusene og bestemte at de ikke trengte det. De trengte pålitelighet. Og pålitelighet må administreres. De bestemte seg for at de trengte spesialister som skulle håndtere påliteligheten. De kalte dem SR-ingeniører og sa: her har dere alt, gjør det som vanlig, bra. Her har dere SLI, her har dere SLO, her er overvåkningen. Og pekte nesen deres mot driftsavdelingen. Og kalte sitt «pålitelige DevOps» SRE. Det så bra ut, men det er en skitten hack som Google kunne tillate seg — at på SR-ingeniørstillingen ansetter folk som hadde kvalifikasjoner som utviklere og som i tillegg hadde litt erfaring med driften av virksomme systemer. Og Google har problemer med å ansette slike folk — hovedsakelig fordi de konkurrerer med seg selv — noen må jo også beskrive forretningslogikken. De delte opp leveransen på release-ingeniørene, SR-ingeniører styrer påliteligheten (selvfølgelig ikke direkte, men ved å påvirke infrastrukturen, endre arkitekturen, overvåke endringer og indikatorer, og håndtere hendelser). Det er pent, kan man si . Men hva gjør man hvis man ikke er Google, men pålitelighet likevel bekymrer en?
Utvikling av DevOps ideer
Her kommer Docker inn, utviklet fra lxc, samt ulike orkestreringssystemer som Docker Swarm og Kubernetes, og DevOps-ingeniørene pustet lettet ut — standardisering av praksiser forenklet leveransen. Det ble forenklet til det punktet at det til og med ble mulig å gi leveransen til utviklerne — hva er vel deployment.yaml. Containerisering løser problemet. Dessuten er modenheten til CI/CD-systemene på nivået der man bare må skrive én fil og så bærer det av sted — utviklerne klarer seg selv. Og her begynner vi å snakke om hvordan vi lager vårt eget SRE, med… ja, hvem som helst.
SRE ikke i Google
Javel, vi har gitt fra oss leveringen, ser ut som vi kan puste ut, komme tilbake til de gode gamle tider, hvor administratorene så på prosessorlasten, perfeksjonerte systemene og stille nippte fra kopper med noe udefinerbart i stillhet og ro... Vent. Vi gjorde ikke dette for å slappe av (dessverre!). Plutselig viser det seg at i Googles tilnærming kan vi helt klart ta i bruk gode praksiser — det er ikke prosessorlasten som er viktig, og ikke hvor ofte vi bytter ut diskene, eller hvor mye vi optimaliserer kostnadene i skyen, men forretningsmetrikker — alle de berømte SLx-ene. Og administrasjon av infrastrukturen er fortsatt på agendaen, og vi må håndtere hendelser, og periodisk være på vakt, og generelt ha oversikt over forretningsprosessene. Og gutter, begynne å programmere på et høyt nivå, Google har ventet på dere.
For å oppsummere. Plutselig, men du er allerede sliten av å lese og kan ikke vente med å kaste deg over og skrive til forfatteren i kommentarfeltet. DevOps som leveringspraksis har vært, er og vil alltid være der. Og den forsvinner ikke noe sted. SRE som et sett med driftspraksiser gjør denne leveringen vellykket.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish