

Hei, Habr-folk. Vi fortsetter tradisjonen med å dele interessant materiell i forkant av starten av nye kurs. I dag har vi spesialtilpasset en artikkel om Google Cloud Spanner, tilknyttet lanseringen av kurset. .
Opprinnelig publisert i .
Som et selskap som tilbyr en rekke skybaserte POS-løsninger for detaljhandel, restauranter og nettbutikker over hele verden, bruker Lightspeed flere forskjellige typer databaser for mange transaksjons-, analyse- og søkesaker. Hver av disse databaseplattformene har sine egne styrker og svakheter. Derfor, når Google introduserte Cloud Spanner på markedet — lovende funksjoner aldri sett før innen relasjonsdatabaser, som praktisk talt ubegrenset horisontal skalerbarhet og 99,999% tjenestenivåavtale (SLA) — kunne vi ikke gå glipp av sjansen til å få tak i det!
For å gi en omfattende oversikt over vår erfaring med Cloud Spanner, samt vurderingskriteriene vi brukte, vil vi se på følgende emner:
- Våre vurderingskriterier
- Cloud Spanner i korte trekk
- Vår vurdering
- Våre konklusjoner
1. Våre vurderingskriterier
Før vi dykker inn i funksjonene til Cloud Spanner, dens likheter og forskjeller med andre løsninger på markedet, la oss først snakke om de grunnleggende bruksområdene vi hadde i tankene da vi vurderte hvor vi skulle implementere Cloud Spanner i vår infrastruktur:
- Som en erstatning for (dominerende) tradisjonelle SQL-database løsninger
- Som en OLTP-løsning med OLAP-støtte
Merk: For enkelhets skyld sammenligner denne artikkelen Cloud Spanner med MySQL-varianter fra GCP Cloud SQL-familien og Amazon AWS RDS.
Bruk av Cloud Spanner som en erstatning for tradisjonelle SQL-database løsninger
I et miljø av tradisjonelle databaser, når responstiden for spørringer til databasen nærmer seg eller til og med overskrider forhåndsdefinerte terskler for applikasjonen (hovedsakelig på grunn av økt antall brukere og/eller forespørseler), finnes det flere måter å redusere responstiden til akseptable nivåer. Imidlertid innebærer de fleste av disse løsningene manuell inngripen.
For example, the first step to take is to look at the various database parameters related to performance and configure them to best match application usage patterns. If this is insufficient, one can opt for vertical or horizontal database scaling.
Vertical scaling of an application involves upgrading the server instance, typically by adding more processors/cores, more RAM, faster storage, etc. Adding more hardware resources results in increased database performance, primarily measured in transactions per second and transaction latency for OLTP systems. Relational database systems (which use a multithreaded approach), like MySQL, scale well vertically.
This approach has several drawbacks, but the most obvious one is the maximum server size on the market. Once the limit of the largest server instance is reached, there is only one way left: horizontal scaling.
Horizontal scaling is an approach where more servers are added to the cluster, ideally linearly increasing performance with the addition of more servers. Most av tradisjonelle database systems scale poorly horizontally or do not scale at all. For example, MySQL can horizontally scale for read operations by adding slave readers, but it cannot horizontally scale for write operations.
On the other hand, due to its nature, Cloud Spanner can easily scale horizontally with minimal intervention.
Full-fledged DBMS as a service should be evaluated from different angles. As a basis, we took the most popular cloud DBMS — Google's GCP Cloud SQL and Amazon's AWS RDS. In our evaluation, we focused on the following categories:
- Feature comparisons: SQL extent, DDL, DML; connection libraries/connectors, transaction support, and so on.
- Development support: ease of development and testing.
- Administrasjonsstøtte: håndtering av instanser — for eksempel opp- og nedskaleringshåndtering og oppgradering av instanser; SLA, sikkerhetskopiering og gjenoppretting; sikkerhet/tilgangskontroll.
Bruk av Cloud Spanner som en OLTP-løsning med OLAP-støtte.
Selv om Google ikke eksplisitt sier at Cloud Spanner er laget for analytisk behandling, deler det noen attributter med andre motorer som Apache Impala & Kudu og YugaByte, som er laget for OLAP-arbeidsbelastninger.
Selv om det kun ville vært en liten sjanse for at Cloud Spanner inkluderte en konsistent horisontalt skalerbar HTAP-motor (hybrid transaksjons/analytisk prosessering) med (mer eller mindre) et brukbart sett med OLAP-funksjoner, mener vi at det ville fortjent vår oppmerksomhet.
Med dette i tankene, har vi vurdert følgende kategorier:
- Datainntak, indekser og støtte for partisjonering.
- Spørringsytelse og DML.
2. Cloud Spanner på en setning.
Google Spanner er et klyngebasert system for administrasjon av relasjonsdatabaser (RDBMS) som Google bruker for flere av sine egne tjenester. Google gjorde det tilgjengelig for brukere av Google Cloud Platform tidlig i 2017.
Her er noen av attributtene til Cloud Spanner:
- Svært konsistent skalerbar RDBMS-klynge: bruker maskinvare-tidsynkronisering for å sikre datakonsistens.
- Støtte for tverr-tabelltransaksjoner: transaksjoner kan dekke flere tabeller — ikke nødvendigvis begrenset til én tabel (i motsetning til Apache HBase eller Apache Kudu).
- Tabeller basert på primærnøkkel: alle tabeller må ha en deklarert primærnøkkel (PK), som kan bestå av flere kolonner i tabellen. Tabelldata lagres i PK-rekkefølge, noe som gjør dem svært effektive og raske å søke etter på PK. Som andre systemer basert på PK, må implementeringen være modellert med tanke på nøye gjennomtenkte bruksområder for å oppnå .
- Vekslende tabeller: tabeller kan ha fysiske avhengigheter til hverandre. Rader i underliggende tabeller kan knyttes til rader i overordnede tabeller. Denne tilnærmingen akselererer søket etter relasjoner, som kan defineres i datamodelleringsfasen, for eksempel når kunder og deres fakturaer plasseres sammen.
- Indekser: Cloud Spanner støtter sekundære indekser. En indeks består av indekserte kolonner og alle kolonnene i primærnøkkelen. Indeksen kan også inneholde andre ikke-indekserte kolonner. Indeksen kan vekslende sammen med den overordnede tabellen for å akselerere forespørslene. Det gjelder flere restriksjoner for indekser, for eksempel maksimalt antall ekstra kolonner som lagres i indekser. Forespørslene via indekser kan også være mindre direkte enn i andre RDBMS.
«Cloud Spanner velger automatisk indekser kun i sjeldne tilfeller. Spesielt velger Cloud Spanner ikke sekundære indekser automatisk hvis forespørselen ber om noen kolonner som ikke er lagret i ».
- Service Level Agreement (SLA): distribusjon i én region med SLA på 99,99%; multiregionale distribusjoner med 99,999% SLA. Selv om selve SLA-en bare er en avtale og ingen garanti, tror jeg at Google-ansatte virkelig har noen nøyaktige data for å gjøre en så alvorlig uttalelse. (Til referanse betyr 99,999% 26,3 sekunder uverdig tilgjengelighet per måned.)
- Mer:
Merk: Apache Tephra-prosjektet legger til utvidet støtte for transaksjoner i Apache HBase (nå også implementert i Apache Phoenix i beta).
3. Vår vurdering
Så vi har alle lest Googles påstander om fordelene med Cloud Spanner — praktisk talt ubegrenset horisontal skalerbarhet med høy konsistens og svært høy SLA. Selv om det er ekstremt vanskelig å oppnå disse kravene, var vår hensikt ikke å motbevise dem. I stedet skal vi fokusere på andre ting som bekymrer de fleste databasebrukere: klarhet og brukervennlighet.
Vi vurderte Cloud Spanner som en erstatning for Sharded MySQL
Google Cloud SQL og Amazon AWS RDS, to av de mest populære OLTP-databasene på skymarkedet, har et omfattende sett med funksjoner. Imidlertid, for å skalere disse databasene utover størrelsen på en enkelt node, må du implementere applikasjonsdeltakelse. Denne tilnærmingen skaper ekstra kompleksitet både for applikasjonene og for administrasjonen. Vi har sett på hvordan Spanner passer inn i scenariet for å kombinere flere segmenter til én instans, og hvilke funksjoner (hvis noen) som kanskje må ofres.
Støtte for SQL, DML og DDL, samt koblinger og biblioteker?
For det første, når du arbeider med en database, må du lage en datamodell. Hvis du tror at du kan koble JDBC Spanner til ditt favoritt SQL-verktøy, vil du oppdage at du kan bruke det til å forespørre dataene dine, men ikke for å opprette tabeller eller endre (DDL) eller utføre noen innsettings-/oppdaterings-/slettingsoperasjoner (DML). Googles offisielle JDBC støtter verken det ene eller det andre.
«For tiden støtter ikke driverne DML- eller DDL-operasjoner».
Spanner-dokumentasjon
Situasjonen med GCP-konsollen er ikke bedre — du kan kun sende SELECT-spørsmål. Heldigvis finnes det en JDBC-driver med støtte for DML og DDL fra fellesskapet, inkludert transaksjoner. . Selv om denne driveren er ekstremt nyttig, er det overraskende at Google ikke har en egen JDBC-driver. Heldigvis tilbyr Google ganske omfattende støtte for klientbiblioteker (basert på gRPC): C#, Go, Java, node.js, PHP, Python og Ruby.
Det praktisk talt obligatoriske bruken av tilpassede API-grensesnitt for Cloud Spanner (på grunn av mangel på DDL og DML i JDBC) fører til visse begrensninger for relaterte kodeområder, som tilkoblingspuljer eller databindingsrammeverk (for eksempel Spring MVC). Generelt, når du bruker JDBC, kan du fritt velge favoritt tilkoblingspuljen (f.eks. HikariCP, DBCP, C3PO osv.) som er testet og fungerer bra. Når det gjelder tilpassede Spanner-API-er, må vi stole på rammeverk/puljer for binding/økter som vi har utviklet selv.
Konstruksjonen som er orientert mot primærnøkkelen (PK), gjør at Cloud Spanner er svært rask når det gjelder datatilgang gjennom PK, men det fører også til visse problemer med spørringer.
- Du kan ikke oppdatere verdien av primærnøkkelen; du må først slette posten med den originale PK-en og sette inn en ny med den nye verdien. (Dette ligner på andre PK-orienterte databaser/lagringsmekanismer.)
- Alle UPDATE- og DELETE-operatører må spesifisere PK i WHERE, og derfor kan det ikke være tomme DELETE all-operatører — det må alltid være en underforespørsel, for eksempel: UPDATE xxx WHERE id IN (SELECT id FROM table1)
- Mangelen på en autoinkrementalternativ eller noe lignende som setter sekvensen for PK-feltet. For at dette skal fungere, må den aktuelle verdien opprettes på applikasjonssiden.
Sekundære indekser?
Google Cloud Spanner har innebygd støtte for sekundære indekser. Dette er en veldig fin funksjon som ikke alltid er tilgjengelig i andre teknologier. Apache Kudu støtter for øyeblikket ikke sekundære indekser i det hele tatt, mens Apache HBase ikke støtter indekser direkte, men kan legge dem til via Apache Phoenix.
Indekser i Kudu og HBase kan modelleres som en egen tabell med forskjellige primærnøkkelkombinasjoner, men atomisiteten til operasjonene som utføres på foreldretabellen og de relaterte indekstabellene må håndteres på applikasjonsnivå og er ikke trivielt i en riktig implementering.
Som nevnt i gjennomgangen av Cloud Spanner, kan dets indekser skille seg fra indekser i MySQL. Derfor må man være spesielt forsiktig når man bygger spørringer og profilerer for å sikre riktig bruk av indeksen der den er nødvendig.
Visninger?
Et veldig populært og nyttig objekt i databasen er visninger. De kan være nyttige for mange bruksområder; mine to favoritter er logisk abstraksjon og sikkerhetsnivå. Dessverre støtter Cloud Spanner IKKE visninger. Men dette begrenser oss bare delvis, da det ikke er detaljering på kolonnenivå for tilgangstillatelser der visninger kan være en akseptabel løsning.
I dokumentasjonen for Cloud Spanner, i delen som detaljerer kvoter og begrensninger (), er det spesielt én som kan være problematisk for noen applikasjoner: Cloud Spanner har som standard en begrensning på maksimalt 100 databaser per instans. Dette kan tydeligvis utgjøre en alvorlig hindring for en database som er ment for skalering utover 100 databaser. Heldigvis, etter å ha snakket med vår tekniske representant hos Google, fant vi ut at denne grensen kan økes nærmest til hvilket som helst tall gjennom Googles kundestøtte.
Støtte for utvikling?
Cloud Spanner tilbyr ganske god støtte for programmeringsspråk som jobber med API-et. Offisielt støttede biblioteker finnes for C#, Go, Java, node.js, PHP, Python og Ruby. Dokumentasjonen er relativt detaljert, men som med andre banebrytende teknologier er fellesskapet ganske lite sammenlignet med de mest populære databasteknologiene, noe som kan føre til økt tid brukt på å løse mindre vanlige bruksområder eller problemer.
Så hva med støtte for lokal utvikling?
Vi fant ingen måte å opprette en Cloud Spanner-instans i et lokalt miljø. Det nærmeste vi kom var et Docker-bilde, , som i prinsippet ligner, men i praksis er ganske forskjellig. For eksempel kan CockroachDB bruke PostgreSQL JDBC. Ettersom utviklingsmiljøet bør være så nært som mulig det produktive miljøet, er Cloud Spanner ikke ideelt, da man må stole på en full instans av Spanner. For å spare kostnader kan du velge en instans for én region.
Støtte for administrasjon?
Å opprette en Cloud Spanner-instans er veldig enkelt. Du må bare velge mellom å opprette en multiregional eller en instans for én region, angi region(er) og antall noder. Mindre enn ett minutt senere vil instansen være oppe og klar til bruk.
Flere grunnleggende målinger er direkte tilgjengelige på Spanner-siden i Google Console. Mer detaljerte visninger er tilgjengelige via Stackdriver, hvor du også kan sette opp terskelverdier for målinger og varsler.
Tilgang til ressurser?
MySQL tilbyr omfattende og svært detaljerte innstillinger for tillatelser/bruksroller for brukere. Det er enkelt å konfigurere tilgang til en bestemt tabell eller til og med bare til en undergruppe av kolonnene. Cloud Spanner bruker Google Identity & Access Management (IAM), som lar deg sette politikker og tillatelser på et svært høyt nivå. Det mest detaljerte alternativet er database-nivå tillatelse, som ikke passer inn i de fleste produksjons-scenarier. Denne begrensningen tvinger deg til å legge til ekstra sikkerhetstiltak i koden din, infrastrukturen din, eller begge deler for å forhindre uautorisert tilgang til Spanner-ressursene.
Sikkerhetskopier?
Kort sagt, sikkerhetskopier finnes ikke i Cloud Spanner. Selv om de høye kravene fra Googles SLA kan garantere at du ikke mister data på grunn av maskinvare- eller databasefeil, kan menneskelige feil, programvarefeil osv. skje. Vi vet alle regelen: høy tilgjengelighet erstatter ikke en fornuftig sikkerhetskopistrategi. Per nå er den eneste måten å sikkerhetskopiere data på, å strømme dem programmatisk fra databasen til et separat lagringsmiljø.
Spørringsytelse?
For å laste opp data og teste spørringer brukte vi Yahoo! Cloud Serving Benchmark. Tabellen nedenfor viser arbeidsbelastningen B YCSB med et lese-forhold på 95 % og skriving på 5 %.
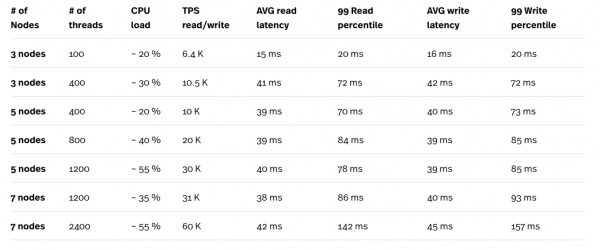
* Belastningstesten ble utført på databehandlingsmotoren (CE) n1-standard-32 (32 vCPU, 120 GB RAM), og testinstansen var aldri flaskehalsen i testene.
** Maksimalt antall tråder i én YCSB-instans er 400. Det var nødvendig å kjøre seks parallelle YCSB-testinstanser for å oppnå totalt 2400 tråder.
Når vi ser på testresultatene, spesielt kombinasjonen av prosessorbelastning og TPS, ser vi tydelig at Cloud Spanner skalerer ganske bra. Den høye belastningen fra mange tråder kompenseres av det store antallet noder i Cloud Spanner-klyngen. Selv om forsinkelsen ser ganske høy ut, spesielt med 2400 tråder, kan det være nødvendig med ny testing med 6 mindre instanser av databehandlingsmotoren for å få mer nøyaktige tall. Hver instans vil kjøre en YCSB-test i stedet for en stor CE-instans med 6 parallelle tester. Dermed blir det lettere å skille mellom forsinkelsene i Cloud Spanner-forespørslene og forsinkelsene lagt til av nettverksforbindelsen mellom Cloud Spanner og CE-instansen der testen kjører.
Hvordan presterer Cloud Spanner som OLAP?
Partisjonering?
Å dele opp data i fysiske og/eller logisk uavhengige segmenter kalt partitioner er et veldig populært konsept som finnes i de fleste OLAP-motorer. Partisjoner kan betydelig forbedre ytelsen til forespørslene og vedlikeholdbarheten av databasen. En videregående undersøkelse av partisjoner ville ført til en egen artikkel(e), så la oss bare nevne viktigheten av å ha en partisjonerings- og sub-partisjoneringsskjema. Muligheten til å dele opp data i partisjoner og enda videre i sub-partisjoner er nøkkelen til ytelsen til analytiske forespørsel.
Cloud Spanner støtter ikke partisjoner som sådan. Den deler data internt i såkalte split-er basert på rekkevidden av primære nøkler. Delingen skjer automatisk for å balansere lasten i Cloud Spanner-klyngen. En svært nyttig funksjon ved Cloud Spanner er delingen av den grunnleggende lasten fra foreldertabellen (tabellen som ikke vekselvirker med en annen). Spanner bestemmer automatisk om den inneholder split data som leses oftere enn data i andre split-er, og kan ta beslutning om videre deling. Dermed kan flere noder bli involvert i forespørselen, noe som også effektivt øker båndbredden.
Datainnhenting?
Cloud Spanner-metoden for store datamengder er den samme som ved vanlig opplasting. For å oppnå maksimal ytelse må du følge noen anbefalinger, inkludert:
- Sorter dataene dine etter primærnøkkel.
- Del dem i 10*antall noder separate seksjoner.
- Opprett et sett med arbeidsoppgaver som laster data parallelt.
Når dataene lastes inn på denne måten, brukes alle nodene i Cloud Spanner.
Vi brukte arbeidsbelastningen A YCSB for å generere et datasett med 10 millioner rader.
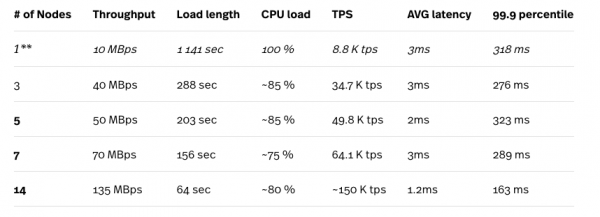
* Belastningstesten ble utført på beregningsmotoren n1-standard-32 (32 vCPU, 120 GB minne), og testinstansen var aldri en flaskehals i testene.
** En- noders oppsett anbefales ikke for noen produksjonsbelastning.
Som nevnt tidligere håndterer Cloud Spanner automatisk oppsplitting avhengig av belastningen, så resultatene forbedres etter flere påfølgende testgjentakelser. Resultatene som presenteres her, er de beste resultatene vi oppnådde. Ser vi på tallene ovenfor, kan vi se hvordan Cloud Spanner (godt) skaleres med økt antall noder i klyngen. Tallene som skiller seg ut, representerer ekstremt lave gjennomsnittlige forsinkelser som står i kontrast til resultatene fra blandede arbeidsbelastninger (95% for lesing og 5% for skriving), som beskrevet i avsnittet ovenfor.
Skalering?
Øke og redusere antall noder i Cloud Spanner er en oppgave som gjøres med ett klikk. Hvis du ønsker å laste opp data raskt, kan du vurdere å maksimere instansen (i vårt tilfelle var dette 25 noder i regionen US-EAST), og deretter redusere antallet noder til et passende antall for din vanlige belastning etter at alle dataene er lagt inn i databasen, med tanke på grensen på 2 TB/nod.
Vi ble minnet på denne grensen selv med en mye mindre database. Etter flere kjøringer av belastningstestene hadde databasen vår en størrelse på ca. 155 GB, og ved å redusere til en en-nodes instans fikk vi følgende feil:
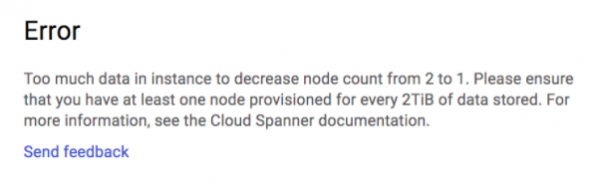
Vi klarte å redusere skalaen fra 25 til 2 instanser, men vi satt fast på to noder.
Automatisering av økning og reduksjon av antall noder i Cloud Spanner-klyngen kan oppnås via REST API. Dette kan være spesielt nyttig for å redusere økt belastning på systemet i travle perioder.
Ytelsen til OLAP-spørsmål?
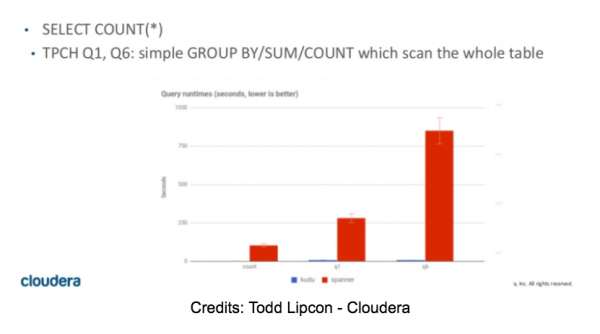
Vi planla opprinnelig å bruke betydelig tid på vår evaluering av Spanner for denne delen. Etter flere SELECT COUNT forsto vi umiddelbart at testing ville bli kortvarig, og at Spanner IKKE ville være egnet som OLAP-motor. Uansett antall noder i klyngen tok en enkel henting av antall rader i tabellen med 10M rader mellom 55 og 60 sekunder. Dessuten førte enhver forespørsel som krevde mer minne til å lagre mellomliggende resultater til OOM-feil.
SELECT COUNT(DISTINCT(field0)) FROM usertable; — (10M distinkt verdier)-> SpoolingHashAggregateIterator gikk tom for minne under ny rad.
Noen tall for TPC-H-spørsmål kan finnes i artikkelen til Todd Lipkon , lysbilder 42 og 43. Disse tallene stemmer overens med våre egne resultater (dessverre).
4. Våre funn
Gitt den nåværende tilstanden til funksjonene i Cloud Spanner, er det vanskelig å se for seg at det kan erstatte eksisterende OLTP-løsninger, spesielt når behovene dine vokser utover det. Det ville kreve betydelig tid å bygge en løsning med hensyn til svakhetene i Cloud Spanner.
Da vi begynte vurderingen av Cloud Spanner, forventet vi at administrasjonsfunksjonene ville være på nivå eller i det minste ikke så langt unna andre Google SQL-løsninger. Men vi var overrasket over det totale fraværet av sikkerhetskopier og veldig begrenset tilgangskontroll til ressurser. For ikke å nevne mangel på visninger, fravær av lokal utviklingsmiljø, ikke-underbygde sekvenser, JDBC uten støtte for DML og DDL og så videre.
Så, hvor skal man henvende sig, hvis man skal skalere en transaktionsdatabase? Det ser ud til, at der på markedet ikke er en enkelt løsning, der passer til alle brugsområder. Der findes mange løsninger med både lukket og åbent kildekode (nogle af dem nævnes i denne artikel), hver med sine styrker og svagheder, men ingen af dem tilbyder en SaaS med en SLA på 99,999% og høj grad af konsistens. Hvis en høj SLA er dit primære mål, og du ikke har lyst til at bygge din egen løsning til flere cloud-miljøer, kan Cloud Spanner være den løsning, du leder efter. Men du skal være opmærksom på alle dens begrænsninger.
Retfærdigvis skal det nævnes, at Cloud Spanner først blev frigivet til offentligheden i foråret 2017, så det er rimeligt at forvente, at nogle af dens nuværende mangler måske i sidste ende forsvinder (forhåbentlig), og når det sker, kan det ændre spillet. I sidste ende er Cloud Spanner ikke bare et projekt fra Google. Google bruger det som grundlag for andre produkter. Og da Google for nylig udskiftede Megastore i Google Cloud Storage med Cloud Spanner, gjorde det, at Google Cloud Storage blev strengt konsistent for objektlister på verdensplan (som stadig ikke gælder for ).
Så der er stadig håb… vi håber.
Det var alt. Ligesom forfatteren af artiklen fortsætter vi også med at håbe, hvad mener du om dette? Skriv din mening i kommentarerne
Vi inviterer alle interesserede til at deltage i vores hvor vi grundigt vil tale om kurset fra OTUS.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish