

Hei alle sammen, jeg heter Sergey Emelyanchik. Jeg er leder av selskapet Audit-Telecom, hovedutvikler og forfatter av systemet Veliam. Jeg bestemte meg for å skrive en artikkel om hvordan jeg og en venn opprettet et outsourcing-selskap, utviklet programvare for oss selv, og senere begynte å distribusere det til alle som ønsket det via SaaS-systemet. Om hvordan jeg absolutt ikke trodde det var mulig. Artikkelen vil ikke bare være en fortelling, men også tekniske detaljer om hvordan produktet Veliam ble laget. Inkludert noen deler av kildekoden. Jeg vil fortelle om hvilke feil vi gjorde og hvordan vi senere rettet dem opp. Jeg hadde betenkeligheter med å publisere en slik artikkel. Men jeg tenkte at det er bedre å gjøre det, få tilbakemeldinger og forbedre seg, enn å ikke publisere artikkelen og tenke på hva som kunne vært ...
Bakgrunn
Jeg jobbet som IT-ansatt i et stort selskap med en omfattende nettverksstruktur. Jeg vil ikke gå inn på mine arbeidsoppgaver, men jeg kan si at utvikling ikke var en del av dem.
Vi hadde overvåkning, men av akademisk interesse ønsket jeg å prøve å skrive min egen enkle versjon. Ideen var slik: jeg ønsket at det skulle være på nettet, slik at man enkelt kunne logge inn og se hva som skjer med nettverket fra enhver enhet, inkludert mobile enheter via Wi-Fi, og jeg ønsket også raskt å forstå hvilket rom utstyret som 'hadde problemer' befant seg i, da det fantes ganske strenge krav til responstid for slike problemer. Til slutt kom jeg på en plan for å skrive en enkel webside, der bakgrunnen var et JPEG-bilde av nettverkskartet, kutte ut enhetene med deres IP-adresser fra dette bildet, og vise dynamisk innhold over bildet i de riktige koordinatene, enten som grønn IP-adresse eller blinkende rød. Oppgaven er satt, la oss begynne.
Tidligere har jeg jobbet med programmering i Delphi, PHP, JS og veldig overfladisk C++. Jeg har ganske god kunnskap om nettverk. VLAN, Routing (OSPF, EIGRP, BGP), NAT. Dette var tilstrekkelig til å skrive en prototype av primitiv overvåkning på egenhånd.
Jeg skrev det jeg hadde i tankene i PHP. Apache-serveren og PHP-koden gikk på Windows, siden Linux på den tiden virket veldig vanskelig og ukjent for meg. Som det viste seg senere, tok jeg grundig feil; i mange tilfeller er Linux mye enklere enn Windows. Men det er et eget tema, og vi vet alle hvor mye diskusjon det er om dette. Windows Oppgavebehandling kalte PHP-skriptet med jevne mellomrom (jeg husker ikke eksakt, men noe sånt som en gang hvert tredje sekund), som sjekket alle objekter med en enkel ping og lagret tilstanden i en fil.
system(“ping -n 3 -w 100 {$ip_address}“);
Ja, ja, arbeid med databaser var også ukjent for meg på den tiden. Jeg visste ikke at man kunne parallellisere prosesser, så gjennomgangen av alle nodene i nettverket tok lang tid, ettersom det skjedde i én tråd. Spesielt oppstod det problemer når flere noder var utilgjengelige, da hver av dem forsinket skriptet med 300 ms. På klientsiden var det en enkel løkke som med noen sekunders intervaller lastet ned oppdatert informasjon fra serveren via en Ajax-forespørsel og oppdaterte grensesnittet. Etter tre mislykkede pings på rad, hvis det var en åpen nettleserside med overvåking, spilte en glad melodi.
Når alt var klart, ble jeg veldig inspirert av resultatet og tenkte at jeg kunne legge til mer (innenfor mine kunnskaper og muligheter). Men jeg har alltid mislikt systemer med millioner av grafer, som jeg da trodde, og som jeg fortsatt mener, ofte er unødvendige. Jeg ønsket kun å implementere det som virkelig ville hjelpe meg i arbeidet. Dette prinsippet gjelder fremdeles som det grunnleggende i utviklingen av Veliam. Deretter innså jeg at det ville vært utrolig bra om jeg ikke måtte ha overvåkingen åpen og vite om problemer, men når et problem skjer, kunne åpne siden og se hvor dette problematiske nettverkspunktet var, og hva jeg skulle gjøre med det. Jeg leste ikke noe e-post på den tiden, jeg brukte det rett og slett ikke. Jeg kom over informasjon på nettet om at det fantes SMS-gateways, som kunne motta GET- eller POST-forespørsel, og som ville sende meg en SMS med teksten jeg skrev til mobiltelefonen min. Jeg forsto straks at jeg ønsket dette veldig. Og begynte å studere dokumentasjonen. Etter en tid klarte jeg det, og nå mottok jeg SMS om problemer i nettverket på mobilen med navnet på den "nedlagte objektet". Selv om systemet var primitivt, var det skrevet av meg selv, og det som motiverte meg til utviklingen var at det var et program som faktisk hjalp meg i arbeidet.
Og dagen kom da en av internettkanalene på jobben falt ut, og overvåkingen min ga meg ingen indikasjon om dette. Siden Googles DNS fortsatt ble pinget utmerket. Det var på tide å tenke på hvordan man kunne overvåke om kommunikasjonskanalen fungerte. Det var ulike ideer om hvordan dette kunne gjøres. Jeg hadde ikke tilgang til alt utstyr. Jeg måtte finne ut hvordan man kunne forstå hvilken av kanalene som var aktiv, uten å ha mulighet til å sjekke det på nettverksutstyret. Da foreslo en kollega ideen om at rutetracing til offentlige servere kan variere avhengig av hvilken kommunikasjonkanal som brukes for å få tilgang til internett. Jeg sjekket, og det stemte. Det var forskjellige ruter ved rutetracing.
system(“tracert -d -w 500 8.8.8.8”);
Slik ble enda et skript til, og mer presist ble sporingen av en eller annen grunn lagt til slutten av det samme skriptet som pinget alle enheter i nettverket. Dette var enda en langvarig prosess som ble utført i samme tråd og bremset hele skriptet. Men den gangen var det ikke så åpenbart. Men uansett, det gjorde jobben sin, det var hardkodet i koden hvilken sporing hver av kanalene skulle ha. Slik begynte systemet å fungere, som allerede overvåket (om man kan kalle det overvåkning, siden det ikke ble samlet inn noen metrikker, kun ping) nettverksenheter (rutere, svitsjer, Wi-Fi osv.) og kommunikasjonslinjer med omverdenen. SMS-er kom jevnlig, og det var alltid godt synlig på diagrammet hvor problemet lå.
Deretter, i det daglige arbeidet, ble jeg nødt til å håndtere krysskobling. Og hver gang måtte jeg logge inn på Cisco-svitsjene for å se hvilket grensesnitt jeg skulle bruke, noe som ble kjedelig. Tenk hvor kult det ville vært å kunne klikke på overvåkningen av objektet og se en liste over grensesnittene med beskrivelser. Dette ville spart meg tid. Og i dette oppsettet trengte jeg ikke å starte Putty eller SecureCRT, skrive inn brukernavn og kommandoer. Bare klikket på overvåkningen, så hva jeg trengte, og gikk videre med arbeidet mitt. Jeg begynte å lete etter hvordan jeg kunne samhandle med svitsjene. På et blunk dukket det opp to alternativer: SNMP eller logge inn på svitsjen via SSH, skrive inn de nødvendige kommandoene og analysere resultatet. Jeg forkastet SNMP på grunn av implementeringsvansker; jeg var utålmodig etter å få resultater. Med SNMP måtte jeg grave dypt i MIB for å kunne danne data om grensesnittene. Det finnes en fantastisk kommando i CISCO.
show interface statusDet viser akkurat det jeg trenger for krysskontroller. Hvorfor plage meg med SNMP når jeg bare vil se utdataene fra denne kommandoen, tenkte jeg. Etter en stund implementerte jeg denne funksjonaliteten. Jeg klikket på objektet på nettsiden. En hendelse ble utløst, hvorpå AJAX-kunden kontaktet serveren, som deretter koblet til den aktuelle svitsjen via SSH (legitimasjonen var hardkodet, det var ikke noe ønske om å forbedre det, lage egne menyer for å endre legitimasjon fra grensesnittet, jeg trengte resultatet raskere) og skrev inn den nevnte kommandoen og sendte det tilbake til nettleseren. Så jeg begynte å se informasjon om grensesnittene med ett museklikk. Det var ekstremt praktisk, spesielt når jeg måtte se denne informasjonen på forskjellige svitsjer samtidig.
Overvåking av kanaler basert på sporing viste seg til slutt ikke å være den beste ideen, da det noen ganger ble utført arbeid på nettverket, og sporing kunne endres, noe som fikk overvåkingen til å skrike til meg om at det var problemer med kanalen. Men etter å ha brukt masse tid på analyse, innså jeg at alle kanalene fungerte, mens overvåkingen løy for meg. Til slutt ba jeg kolleger som administrerte de kanalopprettende svitsjene om å sende meg syslog hver gang tilstandene til naboene (neighbor) endret seg. Dette var langt enklere, raskere, og mer pålitelig enn sporing. Når det kom en hendelse av typen neighbor lost, gjorde jeg umiddelbart varslingen om kanalnedfall.
Videre kom det utdata ved klikk på objektet for flere kommandoer, og SNMP ble lagt til for innsamling av enkelte målinger, og på dette punktet var det egentlig alt. Systemet utviklet seg ikke ytterligere. Det gjorde alt jeg trengte, det var et godt verktøy. Mange lesere vil sikkert si til meg at det allerede finnes masse programvare på internett for å løse disse oppgavene. Men i virkeligheten fant jeg ikke slike gratisprodukter den gangen og jeg ønsket veldig å utvikle programmeringsferdighetene mine, og hva kan være bedre motivasjon enn en reell anvendelsesmåte. Dette avsluttet den første versjonen av overvåkingen, som ikke ble modifisert ytterligere.
Opprettelse av selskapet Audit-Telecom
Tiden gikk, og jeg begynte å ta ekstrajobber hos andre selskaper, takket være at arbeidstiden tillot meg å gjøre det. Når man jobber i forskjellige selskaper, vokser ferdighetene raskt innen ulike områder, og man utvikler et godt perspektiv. Det finnes selskaper hvor, som det er vanlig å si, du er både skredder, høstmann og spiller på fløyte. På den ene siden er dette utfordrende, men på den annen side, hvis man ikke er lat, blir man en allsidig spesialist, og dette gjør at man kan løse oppgaver raskere og mer effektivt fordi man vet hvordan nærliggende områder fungerer.
Vennen min Pavel (også IT-mann) forsøkte hele tiden å oppmuntre meg til å starte egen virksomhet. Det var utallige ideer med forskjellige varianter av egne prosjekter. Dette ble diskutert i mange år. Og tilslutt skulle det ikke føre noe sted fordi jeg er en skeptiker, mens Pavel er en drømmer. Hver gang han foreslo en ny idé, trodde jeg aldri på den og avslo å delta. Men vi ønsket så gjerne å starte vår egen virksomhet.
Endelig klarte vi å finne en løsning som passet for oss begge og begynne med det vi kunne. I 2016 bestemte vi oss for å opprette et IT-selskap som skulle hjelpe virksomheter med å løse IT-oppgaver. Dette innebar implementering av IT-systemer (1C, terminalserver, e-postserver osv.), deres vedlikehold, klassisk HelpDesk for brukere og administrasjon av nettverket.
Ærlig talt, da jeg startet selskapet, trodde jeg ikke på det i omtrent 99,9 %. Men på en eller annen måte fikk Pavel meg til å prøve, og for å forkorte historien, han hadde rett. Pavel og jeg bidro hver 300 000 rubler, registrerte det nye selskapet "Audit-Telecom", leide et lite kontor, laget kule visittkort, med andre ord, akkurat som de fleste uerfarne, nybegynnende forretningsfolk, og begynte å lete etter kunder. Kunder, det er et helt annet kapittel. Kanskje skriver vi en egen artikkel for bedriftsbloggen, hvis noen er interessert. Kalde samtaler, flygeblader og så videre. Dette ga ingen resultater. Som jeg nå leser i mange forretningeshistorier, avhenger mye av flaks. Vi var heldige. Og bokstavelig talt et par uker etter oppstart henvendte min bror Vladimir seg til oss, som brakte den første kunden til oss. Jeg skal ikke overvelde med detaljer om arbeidet med kunder, artikkelen handler ikke om det, jeg skal bare si at vi dro på revisjon, identifiserte kritiske områder, og disse områdene brøt sammen mens beslutningen om å samarbeide med oss på permanent basis som outsourcere ble tatt. Etter dette ble det umiddelbart tatt en positiv avgjørelse.
Deretter, mest gjennom mun-to-munn reklame fra bekjente, begynte flere selskaper å bli med i vår portefølje. Helpdesk var i ett system. Tilkoblinger til nettverksutstyr og servere var i et annet, eller rettere sagt, avhengig av kunden. Noen lagret snarveier, andre brukte RDP-adressebøker. Overvåkning var et annet separat system. Å jobbe i forskjellige systemer er svært upraktisk for teamet. Viktig informasjon går tapt. For eksempel, hvis terminalserveren til en kunde blir utilgjengelig, kommer det straks inn forespørsel fra brukerne av denne kunden. Supportspesialisten oppretter en forespørsel (den kom inn på telefon). Hadde hendelser og forespørsel blitt registrert i ett system, ville supportspesialisten umiddelbart sett hva problemet var for brukeren og informert dem om det, mens han allerede koblet til den aktuelle enheten for å håndtere situasjonen. Alle er oppdatert på den taktiske situasjonen og jobber sammen. Vi fant ikke et slikt system der alt dette var samlet. Det ble klart at det var på tide å lage vårt eget produkt.
Fortsatt arbeid med vårt eget overvåkingssystem
Det var klart at det systemet som tidligere var skrevet, absolutt ikke passet til de nåværende oppgavene. Verken når det gjaldt funksjonalitet eller kvalitet. Beslutningen ble tatt om å skrive systemet fra bunnen av. Grafisk sett burde det nå se helt annerledes ut. Det skulle være et hierarkisk system, slik at man raskt og enkelt kunne åpne de nødvendige objektene for den aktuelle kunden. Oppsettet fra den første versjonen var i dette tilfellet helt uholdbart, da kundene var forskjellige, og det spilte ingen rolle i hvilke rom utstyret var plassert. Dette ble allerede overført til dokumentasjonen.
Så, oppgavene:
- Hierarkisk struktur;
- Noe serverdel som kan plasseres hos kunden i form av en virtuell maskin for innsamling av nødvendige målinger og sending til en sentral server, som vil oppsummere alt dette og vise oss;
- Varsler. Av den typen som ikke kunne bli oversett, da det på den tiden ikke var mulighet for noen å bare sitte og se på skjermen;
- Sakssystem. Kunder begynte å dukke opp, som vi servet ikke bare server- og nettverksutstyr, men også arbeidsstasjoner;
- Mulighet for rask tilkobling til servere og utstyr fra systemet;
Oppgavene er satt, vi begynner å skrive. Samtidig håndterer vi forespørslene fra kundene. På det tidspunktet var vi allerede fire personer. Vi begynte å skrive begge deler samtidig, både den sentrale serveren og serveren for installasjon hos kundene. På dette tidspunktet var Linux allerede kjent for oss, og det ble tatt en beslutning om at de virtuelle maskinene som skulle være hos kundene, ville være på Debian. Det ville ikke være noen installasjonsprogrammer, vi ville bare gjøre prosjektet til serverdelen på én spesifikk virtuell maskin, og deretter bare klone den til den aktuelle kunden. Dette var en ny feil. Det ble senere klart at i et slikt oppsett var oppdateringsmekanismen absolutt ikke utarbeidet. Det vil si, vi la til en ny funksjon, og deretter var det et stort problem å spre den til alle kundenes servere, men vi kommer tilbake til dette senere, alt i sin tid.
Vi laget den første prototypen. Den kunne pinge de nødvendige nettverksenhetene til kundene og serverne våre og sende disse dataene til vår sentrale server. Og den oppdaterte i sin tur disse dataene i det samlede systemet på den sentrale serveren. Jeg vil her ikke bare skrive historien om hva vi fikk til, men også hvilke amatørfeil som ble gjort og hvordan vi senere måtte betale med tid for dem. Så, hele objektdekket ble lagret i én enkelt fil som en serialisert objekt. Da vi koblet til systemet noen kunder, var alt mer eller mindre normalt, selv om det noen ganger var merkelige artefakter som var helt uforståelige. Men da vi koblet til systemet et dusin servere, begynte miraklene å skje. Noen ganger, uten noen åpenbar grunn, forsvant alle objektene i systemet. Her er det viktig å merke seg at serverne som var hos kundene sendte data til den sentrale serveren hvert par sekunder via POST-forespørsel. Den observante leseren og erfarne programmereren har allerede gjettet at det oppstod problemer med samtidig tilgang til den samme filen hvor det serialiserte objektet ble lagret fra forskjellige tråder samtidig. Og akkurat når dette skjedde, dukket miraklene med forsvinningen av objekter opp. Fila ble rett og slett tom. Men dette ble ikke oppdaget med en gang, men først i løpet av driften med flere servere. I løpet av denne tiden ble det lagt til funksjonalitet for portskanning (serverne sendte ikke bare informasjon om tilgjengeligheten til enhetene til den sentrale, men også om åpne porter). Dette ble gjort ved å kalle kommandoen:
$connection = @fsockopen($ip, $port, $errno, $errstr, 0.5);
Resultatene var ofte feil og skanningen tok veldig lang tid. Jeg glemte helt bort pingingen, som ble utført via fping:
system("fping -r 3 -t 100 {$this->ip}");
Dette var heller ikke parallelisert, og derfor var prosessen veldig tidkrevende. Senere ble hele listen over IP-adresser som skulle sjekkes sendt til fping, og vi fikk tilbake en klar liste over de som svarte. I motsetning til oss, kunne fping parallellisere prosessene.
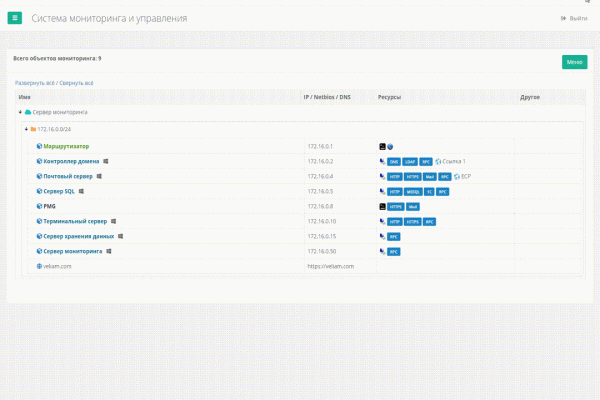
En annen vanlig rutineoppgave var å sette opp ulike tjenester via WEB. For eksempel ECP fra MS Exchange. I utgangspunktet er det bare en lenke. Vi bestemte oss for å gi oss muligheten til å legge til slike lenker direkte i systemet, slik at vi ikke måtte lete i dokumentasjonen eller i bokmerkene for å finne ut hvordan man logger inn på ECP for en spesifikk kunde. Slik oppstod ideen om ressurslenker for systemet, og funksjonaliteten er fortsatt tilgjengelig den dag i dag og har ikke gjennomgått endringer, vel nesten.
Funksjonen til ressurslenker i Veliam
Fjernforbindelser
Slik ser det ut i praksis i den nåværende versjonen av Veliam
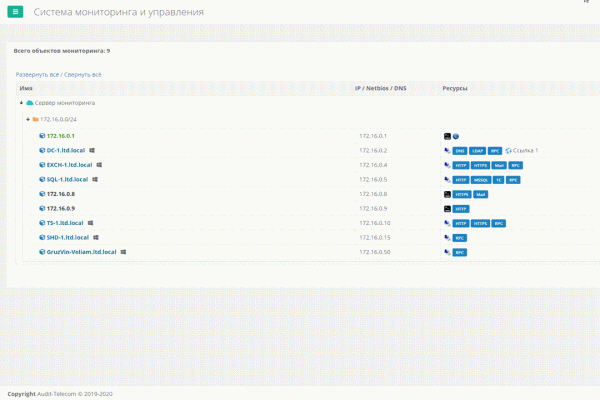
En av oppgavene var rask og enkel tilkobling til serverne, som nå hadde blitt mange (over hundre), og å bla gjennom millioner av forhåndslagrede RDP-genveier var ekstremt upraktisk. Vi trengte et verktøy. Det finnes programvare på internett som ligner på en adressebok for slike RDP-tilkoblinger, men de er ikke integrert med overvåkningssystemet, og brukerkontoene kan ikke lagres. Å hele tiden måtte skrive inn kontoene for forskjellige kunder er en sann plage, når du kobler deg til flere ganger om dagen på ulike servere. Med SSH er situasjonen litt bedre; det finnes mye bra programvare hvor man kan organisere slike tilkoblinger i mapper og huske kontoene. Men det er to problemer. Det første er at vi ikke fant et enkelt program for RDP- og SSH-tilkoblinger. Det andre er at hvis jeg ikke er ved datamaskinen min og trenger å koble meg raskt til, eller jeg nettopp har reinstallert systemet, må jeg lete i dokumentasjonen for å finne ut kontoen til den kunden. Det er upraktisk og en bortkastet tid.
Den nødvendige hierarkiske strukturen for kundenes servere fantes allerede i vårt interne produkt. Det var bare nødvendig å finne ut hvordan vi skulle knytte raske tilkoblinger til det nødvendige utstyret. For det første, i hvert fall innen sitt eget nettverk.
Gitt at nettleseren var kunden i systemet vårt, som ikke hadde tilgang til lokale ressurser på datamaskinen, for å enkelt kjøre det nødvendige programmet med en kommando, ble det bestemt å gjøre alt gjennom “Windows custom url scheme”. Dermed kom det til syne et slags “plugin” i systemet vårt, som bare inkluderte Putty og Remote Desktop Plus, og ved installasjon registrerte det bare URI-skjemaet i Windows. Nå, når vi ville koble til et objekt via RDP eller SSH, trykket vi på denne handlingen i systemet vårt, og Custom URI fungerte. Den standard msdstc.exe som er innebygd i Windows eller putty, som var en del av “pluginet”, ble startet. Jeg bruker ordet plugin i anførselstegn, fordi det ikke er et nettleserplugin i klassisk forstand.
Det var i det minste noe. En praktisk adressebok. Spesielt med Putty, alt fungerte veldig bra; du kunne gi både IP-adressen og innloggingsnavnet og passordet som inngangsparametere. Det vil si at vi allerede kunne koble til Linux-servere i nettverket vårt med ett klikk uten å måtte skrive inn passord. Men med RDP var det ikke så enkelt. Du kunne ikke gi brukernavn og passord som parametere til standard msdstc. Remote Desktop Plus kom til unnsetning. Det tillot dette. Nå klarer vi oss uten det, men det var en trofast hjelper i systemet vårt i lang tid. For HTTP(S) nettsteder er det enkelt, slike objekter åpnes bare i nettleseren, og det er alt. Praktisk og effektivt. Men dette var kun en lykke innenfor det interne nettverket.
Siden vi mesteparten av problemene løste eksternt fra kontoret, var det enkleste å lage VPN-er til kundene. Og da kunne vi koble oss til dem fra systemet vårt. Men det var fortsatt litt upraktisk. For hver kunde måtte vi ha mange lagrede forbindelser på hver datamaskin, og før tilkoblingen til en av dem måtte vi aktivere den aktuelle VPN-en. Vi brukte denne løsningen en god stund. Men antall kunder økte, antall VPN-er også, og alt dette begynte å bli belastende, og vi måtte gjøre noe med det. Spesielt ble tårer presset frem etter reinstallasjonen av systemet, når vi måtte skrive inn dusinvis av VPN-tilkoblinger på nytt i den nye Windows-profilen. Jeg fikk nok av dette, sa jeg, og begynte å tenke på hva vi kunne gjøre med det. VPN tilkoblinger, og før jeg koblet til noe, måtte jeg aktivere den aktuelle VPNen. Vi brukte denne løsningen i ganske lang tid. Men antallet kunder øker, antall VPN-er også, og alt dette begynte å bli belastende, så det måtte gjøres noe med det. Spesielt ble det tårevått etter reinstalleringen av systemet, hvor jeg måtte skrive inn dusinvis av VPN-tilkoblinger på nytt i den nye Windows-profilen. Nok er nok, tenkte jeg, og begynte å vurdere hvilke løsninger som kunne være tilgjengelige.
Det er blitt vanlig at alle kunder har rutere fra det velkjente merket Mikrotik. De er veldig funksjonelle og praktiske for å utføre nesten alle oppgaver. Ulempen er at de blir 'stjålet'. Vi løste dette problemet enkelt ved å stenge all ekstern tilgang. Men vi måtte på en eller annen måte ha tilgang til dem uten å måtte dra til kunden, siden det tar tid. Vi opprettet bare tunneler til hver av disse Mikrotik-enhetene og delte dem i en egen pulje, uten noen form for ruting, for å unngå at vårt nettverk ble kombinert med kundenes nettverk og nettverkene deres imellom.
Ideen dukket opp om å gjøre det slik at når jeg klikker på et objekt i systemet, ville sentral overvåkningsserver, som kjente påloggingsinformasjonen for SSH til alle kundenes Mikrotik-enheter, koble til den aktuelle, opprette et videresendingsregler til den nødvendige verten med den ønskede porten. Her er det flere punkter. Løsningen er ikke universell — den vil kun fungere for Mikrotik, ettersom syntaksen for kommandoer for alle rutere er forskjellig. I tillegg måtte disse videresendingene også på en eller annen måte fjernes, men serverdelen av systemet vårt kunne i praksis ikke overvåke om jeg hadde avsluttet økten min etter RDP. Og en slik videresending er et sikkerhetshull for kunden. Vi var ikke ute etter universelle løsninger, ettersom produktet kun ble brukt internt i selskapet vårt, og vi hadde ikke engang vurdert å gjøre det offentlig.
Hver av problemene ble løst på sin egen måte. Når en regel ble opprettet, var denne videresendingen tilgjengelig kun for én bestemt ekstern IP-adresse (fra hvilken tilkoblingen ble initiert). Dermed klarte vi å unngå sikkerhetshull. Men ved hver slik tilkobling ble det lagt til en regel i Mikrotik på NAT-siden, og disse ble ikke fjernet. Alle vet at jo flere regler det er der, desto mer belastes prosessoren til ruteren. Og generelt kunne jeg ikke akseptere tanken på at jeg en dag skulle gå inn på en Mikrotik, og der var hundrevis av døde, unyttige regler.
Siden vårt server ikke kan spore tilkoblingsstatusen, la Mikrotik spore dem selv. Jeg skrev et skript som konstant overvåket alle portregler med en bestemt beskrivelse (description) og sjekket om det var en passende TCP-tilkobling. Hvis det ikke var en i løpet av en viss tid, var det sannsynligvis at tilkoblingen var avsluttet, og portregel kan slettes. Alt fungerte, skriptet jobbet bra.
Forresten, her er det:
global atmonrulecounter {"dontDelete"="dontDelete"}
:foreach i in=[/ip firewall nat find comment~"atmon_script_main"] do={
	local dstport [/ip firewall nat get value-name="dst-port" $i]
	local dstaddress [/ip firewall nat get value-name="dst-address" $i]
	local dstaddrport "$dstaddress:$dstport"
	#log warning message=$dstaddrport
	local thereIsCon [/ip firewall connection find dst-address~"$dstaddrport"]
	if ($thereIsCon = "") do={
		set ($atmonrulecounter->dstport) ($atmonrulecounter->dstport + 1)
		#:log warning message=($atmonrulecounter->dstport)
		if (($atmonrulecounter->dstport) > 5) do={
			#log warning message="Fjerner nat-regler lagt til automatisk av atmon_script"
			/ip firewall nat remove [/ip firewall nat find comment~"atmon_script_main_$dstport"]
			/ip firewall nat remove [/ip firewall nat find comment~"atmon_script_sub_$dstport"]
			set ($atmonrulecounter->dstport) 0
		}
	} else {
		set ($atmonrulecounter->dstport) 0
	}
}
Det kunne sikkert vært gjort mer elegant, raskere osv., men det fungerte, belastet ikke mikrotikene og gjorde jobben utmerket. Vi klarte endelig å koble til serverne og nettverksutstyret til kundene med bare ett klikk. Uten å heve VPN og uten å skrive inn passord. Systemet ble virkelig mye mer brukervennlig. Tiden for vedlikehold ble redusert, og vi brukte tid på arbeidet vårt, ikke på å koble til de nødvendige objektene.
Mikrotik Backup
Vi hadde satt opp sikkerhetskopiering av alle mikrotikerne til FTP. Og for det meste var alt bra. Men når vi måtte hente backupen, måtte vi åpne den FTP og lete etter den der. Systemet der alle rutere er registrert, har vi, og vi kan kommunisere med enhetene over SSH. Hva om vi lager det slik at systemet selv daglig henter backupene fra alle mikrotikerne, tenkte jeg. Og begynte å implementere det. Vi koblet til, tok backup og hentet den til lagringen.
PHP-skriptet for å ta backup fra Mikrotik:
<?php

	$IP = '0.0.0.0';
	$LOGIN = 'admin';
	$PASSWORD = '';
	$BACKUP_NAME = 'test';

    $connection = ssh2_connect($IP, 22);

    if (!ssh2_auth_password($connection, $LOGIN, $PASSWORD)) exit;

    ssh2_exec($connection, '/system backup save name="atmon" password="atmon"');
    stream_get_contents($connection);
    ssh2_exec($connection, '/export file="atmon.rsc"');
    stream_get_contents($connection);
    sleep(40); // Waiting bakup makes

    $sftp = ssh2_sftp($connection);

    // Download backup file
    $size = filesize("ssh2.sftp://$sftp/atmon.backup");
    $stream = fopen("ssh2.sftp://$sftp/atmon.backup", 'r');
    $contents = '';
    $read = 0;
    $len = $size;
    while ($read < $len && ($buf = fread($stream, $len - $read))) {
        $read += strlen($buf);
        $contents .= $buf;
    }
    file_put_contents ($BACKUP_NAME . '.backup',$contents);
    @fclose($stream);

    sleep(3);
    // Download RSC file
    $size = filesize("ssh2.sftp://$sftp/atmon.rsc");
    $stream = fopen("ssh2.sftp://$sftp/atmon.rsc", 'r');
    $contents = '';
    $read = 0;
    $len = $size;
    while ($read
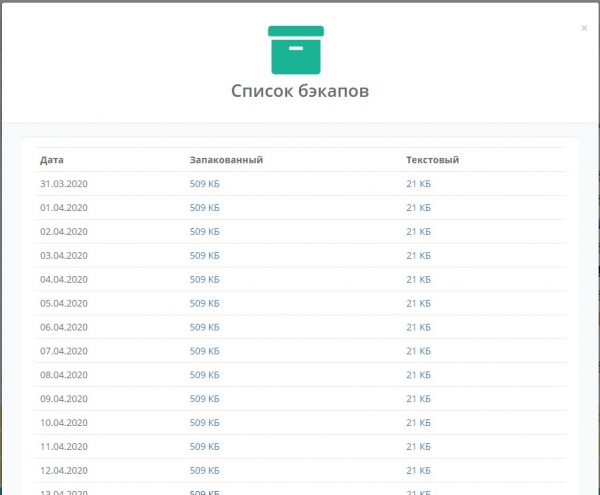
Backup is created in two formats — binary and text configuration. The binary format helps to quickly restore the necessary configuration, while the text format allows understanding what to do if there is a forced equipment replacement and the binary cannot be uploaded. In the end, we gained another convenient feature in the system. Moreover, when adding new MikroTik devices, there was no need for any configuration; simply added the object to the system and assigned an SSH account for it. The system then handled the backup captures automatically. This functionality is currently not available in the SaaS Veliam version, but we will port it soon.
Screenshots of how it looked in the internal system
Transition to normal storage in the database
Tidligere har jeg nevnt at det oppsto artefakter. Noen ganger forsvant hele listen over objekter i systemet, og noen ganger, når jeg redigerte et objekt, ble ikke informasjonen lagret, og jeg måtte omdøpe objektet tre ganger. Dette irriterte alle voldsomt. Forsvinning av objekter skjedde sjelden og kunne lett gjenopprettes ved å gjenopprette den aktuelle filen, men feil ved redigering av objekter skjedde ganske ofte. Jeg gjorde sannsynligvis ikke dette gjennom databasen fra starten av fordi jeg ikke klarte å forstå hvordan man kunne holde et tre med alle relasjonene i en flat tabell. Den er flat, mens et tre er hierarkisk. Men et godt løsninger for samtidig tilgang, og senere (når systemet ble mer komplisert) transaksjonell tilgang – er DBMS. Jeg er nok ikke den første som har støtt på dette problemet. Jeg begynte å google. Det viste seg at alt allerede var funnet opp før meg, og det finnes flere algoritmer som bygger et tre fra en flat tabell. Etter å ha sett på hver av dem, implementerte jeg en av dem. Men dette var allerede en ny versjon av systemet, da jeg måtte skrive om en del av det. Resultatet var forventet, problemene med systemets tilfeldige oppførsel forsvant. Noen kan si at feilene var ganske amateuraktige (enkelttrådede skripter, lagring av informasjon med samtidige flere tilgang fra forskjellige tråder i en fil, osv.) innen programvareutvikling. Kanskje det er riktig, men hovedjobben min var administrasjon, mens programmering var en hobby for sjelen, og jeg hadde rett og slett ikke erfaring med å jobbe i et team av programmerere, hvor slike elementære ting ville blitt påpekt av eldre kolleger. Derfor gikk jeg gjennom disse erfaringene alene, men lærte materialet veldig godt. Og dessuten, mitt arbeid innebærer møter med kunder, handlinger som er rettet mot å prøve å markedsføre firmaet, en haug med administrative spørsmål inne i selskapet, og mye, mye mer. Men uansett, det som var, var etterspurt. Guttene og jeg selv brukte produktet i vårt daglige arbeid. Det var også åpenbart mislykkede ideer, og løsninger som tok tid, og som til slutt viste seg å være fungerende verktøy som ingen brukte, og som ikke kom inn i Veliam.
Kundestøtte — HelpDesk
Det vil ikke være overflødig å nevne hvordan HelpDesk ble utviklet. Dette er faktisk en egen historie, for hos Veliam er dette allerede den tredje helt nye versjonen, som skiller seg fra alle de tidligere. Nå er det et enkelt system, intuitivt og uten unødvendige detaljer, med mulighet for integrasjon med domenet, samt mulighet for å få tilgang til samme brukerprofil fra hvor som helst via en link i en e-post. Og det viktigste av alt er muligheten til å koble seg til søkeren direkte fra søknaden via VNC uten VPN eller portviderekobling, uansett hvor man er (hjemme eller på kontoret). Jeg vil fortelle hvordan vi kom dit, hva som var før, og hvilke forferdelige løsninger som eksisterte.
Vi koblet til brukerne gjennom det velkjente TeamViewer. På alle PC-er til brukerne vi betjener var det installert TV. Det første vi gjorde feil, og som vi senere fjernet, var å knytte hver kunde HWID til maskinvaren. Hvordan logger en bruker inn i HW-systemet for å sende inn en forespørsel? På alle datamaskiner, i tillegg til TV, var det installert et spesialverktøy skrevet i Lazarus (her vil mange heve øyenbrynene, og kanskje til og med søke opp hva dette er, men av de kompilérbare språkene visste jeg best om Delphi, og Lazarus er nesten det samme, bare gratis). I utgangspunktet startet brukeren et spesialbatteri som startet dette verktøyet, som deretter leste systemets HWID, og deretter ble nettleseren åpnet og autentisering fant sted. Hvorfor ble dette gjort? I noen selskaper blir antall betjente brukere talt individuelt, og kostnaden for service hver måned beregnes ut fra antall personer. Dette er forståelig, sier du, men hvorfor knytning til maskinvaren? Veldig enkelt, enkelte individer kom hjem og sendte inn en forespørsel fra sin bærbare datamaskin i stil med "gjør dette fint for meg her". I tillegg til å lese systemets HWID, hentet verktøyet gjeldende TeamViewer-ID fra registret og sendte den også til oss. TeamViewer har et API for integrasjon. Og vi gjennomførte denne integrasjonen. Men det var en hake. Gjennom dette API-en kan man ikke koble seg til brukerens datamaskin med mindre de eksplisitt initiere denne sesjonen, og etter å ha prøvd å koble til, må de også trykke "bekreft". På den tiden virket det logisk for oss at uten brukerens samtykke burde ingen koble seg til, og ettersom det var en person ved datamaskinen, da ville de initiere sesjonen og svare bekreftende på forespørselen om ekstern tilkobling. Alt var ikke så enkelt. Søkerne glemte å initiere sesjonen, og de måtte få dette forklart i telefonen. Dette tok tid og irriterte begge parter i prosessen. Videre, slike situasjoner var ikke uvanlige, hvor en person sender inn en forespørsel, men gir tilgang til tilkobling først når de går på lunsj. Siden problemet ikke er kritisk, vil de ikke ha arbeidsprosessen sin forstyrret. Dermed vil de ikke trykke på noen knapper for å gi tillatelse til å koble seg til. Og slik oppstod en ekstra funksjonalitet ved autentisering i HelpDesk – lesing av TeamViewer-ID. Vi visste det faste passordet som ble brukt under installasjonen av TeamViewer. Mer presist visste bare systemet det, da det var innebygd i installasjonsprogrammet, og i vårt system. Dermed var det en tilkoblingsknapp fra forespørselen som ved et trykk på, ikke trengte å vente på noe, og TeamViewer åpnet umiddelbart og koblingen ble gjort. Til slutt ble det to typer mulige tilkoblinger. Gjennom TeamViewer sitt offisielle API og vårt egenutviklede. Til min overraskelse ble det første nesten umiddelbart ikke brukt, selv om det var pålagt å bruke det kun i spesielle tilfeller og når brukeren samtykket til det. Sikkerhet ble nå prioritert. Men det viste seg at søkerne ikke ønsket dette. De var absolutt ikke imot å bli koblet til uten bekreftelsesknapp. Og siden det var slik, ble også funksjonaliteten for tilkobling via API fjernet som unødvendig.
Overgang til flertrådet behandling i Linux
Spørsmålet om å akselerere nettverksskannerens gjennomgang for å sjekke åpenheten av en forhåndsdefinert liste over porter har lenge vært på sin plass, sammen med en enkel ping av nettverksobjektene. Det første forslaget som kommer til tankene er flertrådet behandling. Siden hovedtiden brukt på ping er ventetiden på tilbakemelding av pakken, kan ikke neste ping starte før den forrige pakken er returnert. I selskaper med mer enn 20 servere og nettverksutstyr fungerte dette allerede ganske tregt. Poenget er at en pakke kan gå tapt, og man ønsker ikke å varsle systemadministratoren om dette med en gang. Han vil neppe ta slikt spam alvorlig over tid. Det betyr at man må pinge hvert objekt flere ganger før man konkluderer med utilgjengelighet. Uten å gå altfor mye i detaljer, må man parallellisere, fordi hvis dette ikke gjøres, vil systemadministratoren mest sannsynlig få høre om problemet fra kunden og ikke fra overvåkningssystemet.
PHP i seg selv har ikke støtte for flertrådet behandling som standard. Det støtter flerprosessering, man kan gjøre forking. Men jeg hadde allerede i prinsippet skrevet en spørringsmekanisme og ønsket å gjøre det slik at jeg først leste alle nødvendige noder fra databasen, pinget alle samtidig, ventet på svar fra hver av dem, og først deretter skrev dataene. Dette sparer på antallet leseforespørsel. Denne ideen innarbeidet seg perfekt med flertrådet behandling. Det finnes en PThreads-modul for PHP, som tillater ekte flertrådet behandling, selv om det krevde en del arbeid for å konfigurere dette på PHP 7.2, men det ble gjort. Portskanning og pinging ble raske. I stedet for for eksempel 15 sekunder per runde tidligere, tok denne prosessen nå 2 sekunder. Det var et godt resultat.
Raske revisjoner av nye selskaper
Hvordan oppstod funksjonen for innsamling av ulike målinger og spesifikasjoner for maskinvare? Det er enkelt. Vi får noen ganger forespørsel om en enkel vurdering av den nåværende IT-infrastrukturen. Det samme er nødvendig for å fremskynde vurderingen av en ny kunde. Vi trengte noe som gjør at vi kan besøke middels store eller store selskaper og raskt forstå hva de faktisk har. Pinging i det interne nettverket blir ifølge min mening kun blokkert av de som ønsker å komplisere livet sitt, og etter vår erfaring er det ikke mange. Men noen finnes. Dermed kan man raskt skanne nettverket for enheter med en enkel ping. Videre kan disse legges til og skannes for åpne porter som er av interesse for oss. I utgangspunktet var denne funksjonaliteten allerede til stede, det var bare nødvendig å legge til en kommando fra den sentrale serveren til den underordnede, slik at den kunne skanne de angitte nettverkene og legge til alt den finner i listen. Jeg glemte å nevne at det ble antatt at vi allerede hadde et klart bilde med et konfigurert system (den underordnede overvåkingsserveren) som vi kunne distribuere til kunden under vurderingen og koble den til vår sky.
Men resultatet av revisjonen inkluderer vanligvis en rekke ulike opplysninger, og en av dem er hva slags enheter som finnes i nettverket. Først og fremst var vi interessert i Windows-servere og Windows-arbeidsstasjoner innen domenet. I middels store og store selskaper er det antagelig unntaket fra regelen at domenet mangler. For å snakke et felles språk, vil jeg si at en gjennomsnittlig bedrift er over 100 ansatte. Vi måtte finne ut hvordan vi skulle samle inn data fra alle Windows-maskinene og serverne, med kjennskap til deres IP-adresser og kontoer for domeneadministratoren, uten å måtte installere programvare på hver enkelt av dem. Her kommer WMI-grensesnittet inn. Windows Management Instrumentation (WMI) er bokstavelig talt Windows-administrasjonsverktøyet. WMI er en av de grunnleggende teknologiene for sentralisert styring og overvåking av ulike deler av datainfrastrukturen som kjører på Windows-plattformen. Hentet fra wiki. Deretter måtte jeg igjen bruke tid på å samle wmic (dette er WMI-klienten) for Debian. Når alt var klart, var det enkelt å forespørre de nødvendige nodene via wmic for ønsket informasjon. Via WMI kan man hente nesten hvilken som helst informasjon fra Windows-datamaskinen, og mer enn det, man kan også kontrollere maskinen, for eksempel ved å sende den til omstart. Slik ble innsamlingen av informasjon om Windows-stasjoner og servere en del av systemet vårt. I tillegg samlet vi inn nåværende informasjon om systemets belastningsindikatorer. Disse forespør vi oftere, mens informasjon om maskinvaren hentes sjeldnere. Etter dette ble det litt mer behagelig å gjennomføre revisjonen.
Beslutningen om distribusjon av programvare
Vi bruker selv systemet daglig, og det er alltid åpent for hver teknisk medarbeider. Vi tenkte at vi også kunne dele det vi allerede har med andre. Systemet var imidlertid ikke i stand til å bli distribuert ennå. Det var nødvendig å omarbeide mye for at den lokale versjonen skulle bli til SaaS. Dette inkluderte endringer i ulike tekniske aspekter ved systemets funksjon (fjerntilkoblinger, kundeservice), samt analyse av moduler for lisensiering, sharding av kundedatabaser, skalering av hver av tjenestene, og utvikling av automatiske oppdateringssystemer for alle deler. Men dette vil bli dekket i del to av artikkelen.
Update
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish