

Hei alle sammen. I denne artikkelen vil jeg forklare hvorfor vi hos Avito for ni måneder siden valgte Kafka, og hva det er. Jeg vil dele en av bruksområdene – meldingsmegler. Til slutt vil vi diskutere hvilke fordeler vi har fått fra å bruke tilnærmingen Kafka as a Service.
Problemet
Først litt kontekst. For en tid siden begynte vi å bevege oss bort fra monolittisk arkitektur, og nå har Avito flere hundre forskjellige tjenester. De har sine egne lagringsløsninger, sin teknologistack og er ansvarlige for sin del av forretningslogikken.
Et av problemene med et stort antall tjenester er kommunikasjonen. Tjeneste A vil ofte vite informasjonen som tjeneste B har. I dette tilfellet kontakter tjeneste A tjeneste B via et synkront API. Tjeneste C ønsker å vite hva som skjer med tjenester D og E, og de er igjen interesserte i tjenester A og B. Når det blir mange «nysgjerrige» tjenester, blir forbindelsene mellom dem til en komplisert sammenfiltring.
I tillegg kan tjeneste A når som helst bli utilgjengelig. Hva skal tjeneste B og alle andre avhengige tjenester gjøre i så fall? Og hvis en forretningsoperasjon krever at man utfører en kjede av sekvensielle synkrone anrop, øker sannsynligheten for at hele operasjonen mislykkes enda mer (og den er desto høyere jo lengre denne kjeden er).
Valg av teknologi
Greit, problemene er klare. De kan løses ved å lage et sentralisert meldingssystem mellom tjenestene. Nå trenger hver tjeneste bare å vite om dette meldingssystemet. I tillegg bør selve systemet være feilresistent og horisontalt skalerbart, samt i tilfelle av brudd lagre forespørslene for senere behandling.
La oss nå velge teknologien som skal implementere meldingsleveransen. For dette må vi først forstå hva vi forventer fra den:
- meldinger mellom tjenester må ikke gå tapt;
- meldinger kan dupliseres;
- meldinger kan lagres og leses i flere dager (persistent buffer);
- tjenester kan abonnere på data de er interessert i;
- flere tjenester kan lese de samme dataene;
- meldinger kan inneholde detaljert, omfattende payload (event-carried state transfer);
- noen ganger er det behov for garantert rekkefølge av meldinger.
Det var også kritisk viktig for oss å velge et så skalerbart og pålitelig system som mulig med høy kapasitet (minst 100k meldinger på flere kilobyte per sekund).
På dette stadiet tok vi farvel med RabbitMQ (vanskelig å opprettholde stabilitet ved høye rps), PGQ fra SkyTools (ikke rask nok og dårlig skalerbar) og NSQ (ikke persisterende). Alle disse teknologiene brukes i selskapet vårt, men de passet ikke til oppgaven vi skulle løse.
Deretter begynte vi å se på nye teknologier for oss — Apache Kafka, Apache Pulsar og NATS Streaming.
Vi droppet Pulsar først. Vi mente at Kafka og Pulsar er ganske like løsninger. Og selv om Pulsar er testet av store selskaper, er nyere og teoretisk tilbyr lavere latency, bestemte vi oss for å beholde Kafka av disse to, som de facto-standard for slike oppgaver. Vi kommer sannsynligvis til å gå tilbake til Apache Pulsar i fremtiden.
Og vi hadde to kandidater igjen: NATS Streaming og Apache Kafka. Vi har studert begge løsninger ganske grundig, og begge passet oppgaven. Men til slutt var vi bekymret for den relative ungdommen til NATS Streaming (og at en av hovedutviklerne, Tyler Treat, bestemte seg for å forlate prosjektet og starte sitt eget — Liftbridge). I tillegg ga ikke Clustering-modusen til NATS Streaming muligheten for sterk horisontal skalerbarhet (muligens er dette ikke lenger et problem etter at partitioning-modusen ble lagt til i 2017).
Likevel er NATS Streaming en imponerende teknologi, skrevet i Go og har støtte fra Cloud Native Computing Foundation. I motsetning til Apache Kafka trenger den ikke Zookeeper for å fungere (kanskje, ), siden den innvendig implementerer RAFT. I tillegg er NATS Streaming enklere å administrere. Vi utelukker ikke at vi i fremtiden kanskje vil gå tilbake til denne teknologien.
Og likevel ble Apache Kafka vår vinner i dag. I testene våre viste den seg å være rask nok (over en million meldinger per sekund ved lesing og skriving med en meldingstørrelse på 1 kilobyte), tilstrekkelig pålitelig, godt skalerbar og bevist i produksjon av store selskaper. I tillegg støtter Kafka minst flere store kommersielle selskaper (vi bruker for eksempel Confluent-versjonen), samt at Kafka har et utviklet økosystem.
Oversikt over Kafka
Før du begynner, vil jeg umiddelbart anbefale en utmerket bok — «Kafka: The Definitive Guide» (finnes også i norsk oversettelse, men begrepene kan være litt forvirrende). Den inneholder informasjonen som er nødvendig for en grunnleggende forståelse av Kafka, og til og med litt mer. Selve dokumentasjonen fra Apache og bloggen fra Confluent er også godt skrevet og lett å lese.
La oss se på hvordan Kafka er strukturert fra et fugleperspektiv. Den grunnleggende topologien til Kafka består av producer, consumer, broker og zookeeper.
Broker
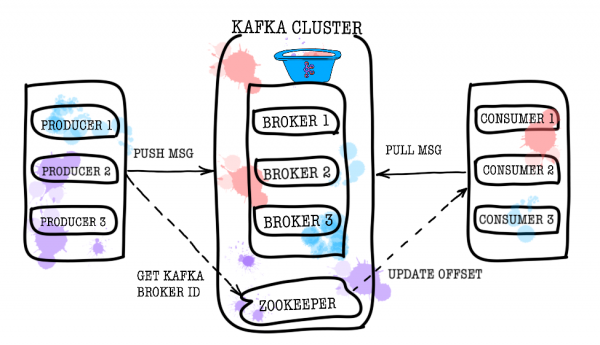
Brokeren (broker) er ansvarlig for lagringen av dataene dine. All informasjon lagres i binært format, og brokeren vet lite om hva de representerer og hva som er strukturen deres.
Hver logisk type hendelse befinner seg vanligvis i sin egen separate topic. For eksempel kan en hendelse for opprettelse av et annonseinnlegg havne i topicen item.created, mens en hendelse for endringen av den havner i item.changed. Topics kan betraktes som klassifikatorer av hendelser. På topic-nivå kan slike konfigurasjonsparametre settes som:
- volumet av lagrede data og/eller deres alder (retention.bytes, retention.ms);
- replikasjonsfaktor (replication factor);
- maksimal størrelse på en melding (max.message.bytes);
- minimum antall bekreftede kopier, for at data kan skrives til topicen (min.insync.replicas);
- muligheten for å gjennomføre failover til en usynkronisert, forsinket kopi med potensiell dataforlust (unclean.leader.election.enable);
- og mange andre ().
Hver topic deles igjen opp i en eller flere partitioner. Det er i partitionene hendelsene havner til slutt. Hvis det er mer enn én broker i klyngen, vil partitionene bli fordelt jevnt over alle brokerne (så langt det er mulig), noe som gjør det mulig å skalere både skriving og lesing i en topic til flere brokere samtidig.
Dataene for hver partition lagres på disken i form av segmentfiler, som som standard er én gigabyte store (kontrollert via log.segment.bytes). En viktig detalj er at fjerning av data fra partitionene (når retention utløses) skjer i segmenter (man kan ikke slette én hendelse fra en partition, man kan bare slette ett helt segment, og kun inaktivt).
Zookeeper
Zookeeper fungerer som lager for metadata og koordinator. Det er det som kan si om brokerne er aktive (man kan se på dette med zookeeper via zookeeper-shell kommandoen ls /brokers/ids), hvilken av brokerne som er kontroller (get /controller), er partisjonene i synkron tilstand med sine replikater (get /brokers/topics/topic_name/partitions/partition_number/state). Det er også til zookeeper at produsent og konsument først går for å finne ut hvilken broker som lagrer hvilke emner og partitioner. I tilfeller der emnet har en replikasjonsfaktor større enn 1, vil zookeeper indikere hvilke partitioner som er ledere (der skriving vil skje og fra dem vil lesing også foregå). Ved et broker-nedbrudd vil informasjon om nye leder-partitioner bli registrert i zookeeper (siden versjon 1.1.0 asynkront, ).
I eldre versjoner av Kafka var zookeeper også ansvarlig for å lagre offsets, men nå lagres de i et spesialemne __consumer_offsets på brokeren (selv om du fortsatt kan bruke zookeeper for disse formålene).
Den enkleste måten å gjøre dataene dine om til gresskar på er nettopp å miste informasjonen fra zookeeper. I et slikt scenario vil det være svært vanskelig å forstå hva og hvorfra man må lese.
Produsent
Produsent — er oftest en tjeneste som utfører den direkte skrivingen av data til Apache Kafka. Produsenten velger emnet der temaene skal lagres, og begynner å skrive informasjon inn i det. For eksempel kan en annonsetjeneste fungere som produsent. I så fall vil den sende hendelser som «annonse opprettet», «annonse oppdatert», «annonse slettet» osv. til de tematiske emnene. Hver hendelse representerer et nøkkel-verdi-par.
Som standard fordeles alle hendelser jevnt over partitionene i emnet med round-robin, med mindre en nøkkel er angitt (og mister rekkefølge), og ved hjelp av MurmurHash (nøkkel) hvis en nøkkel er til stede (rekkefølge innen en partition).
Her bør det bemerkes at Kafka garanterer rekkefølge av hendelser bare innen en partition. Men i virkeligheten er dette ofte ikke et problem. For eksempel kan man garantert legge til alle endringer av den samme annonsen i én partition (og dermed opprettholde rekkefølgen på disse endringene innenfor annonsen). Det er også mulig å sende rekkefølgenummeret i et av feltene i hendelsen.
Konsument
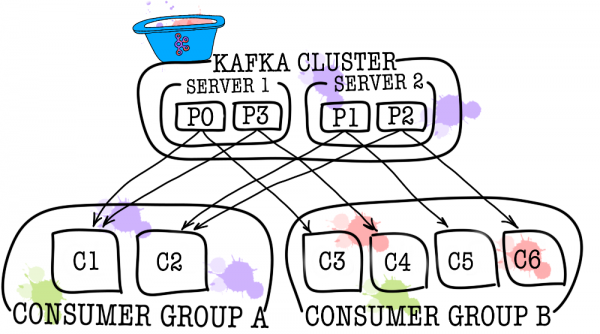
Consumeren er ansvarlig for å hente data fra Apache Kafka. Hvis vi går tilbake til eksemplet ovenfor, kan consumeren være en modereringstjeneste. Denne tjenesten vil abonnere på emnet til annonsetjenesten, og ved publisering av en ny annonse vil den motta og analysere den for å se om den samsvarer med bestemte policyer.
Apache Kafka husker hvilke siste hendelser consumeren har mottatt (for dette brukes kontrolltoppikket __consumer__offsets), og dermed garanterer at når en consumer leser vellykket, ikke vil motta den samme meldingen to ganger. Imidlertid, hvis man bruker alternativet enable.auto.commit = true og overlater ansvaret for å spore consumerens posisjon i emnet til Kafka, kan man . I produksjonskode kontrolleres som oftest posisjonen til consumeren manuelt (utvikleren styrer tidspunktet for når commit av den leste hendelsen nødvendigvis må skje).
I tilfeller hvor én consumer ikke er nok (for eksempel når strømmen av nye hendelser er veldig stor), kan man legge til flere consumere og knytte dem sammen i en consumergruppe. Consumergruppen representerer logisk akkurat den samme consumeren, men med fordeling av data mellom gruppemedlemmene. Dette gjør at hver deltaker kan ta sin andel av meldingene, og dermed skalere lesefarten.
Testresultater
Her vil jeg ikke skrive mye forklarende tekst, bare dele de innsamlede resultatene. Testingen ble utført på 3 fysiske maskiner (12 CPU, 384 GB RAM, 15k SAS DISK, 10 GBit/s nett), og brokerne samt zookeeper ble rullet ut i lxc.
Ytelsestesting
Under testingen ble følgende resultater oppnådd.
- Skrivehastigheten for meldinger på 1 KB med 9 produsenter samtidig — 1,300,000 hendelser per sekund.
- Lesehastigheten for meldinger på 1 KB med 9 consumere samtidig — 1,500,000 hendelser per sekund.
Testing av feiltoleranse
Under testingen ble følgende resultater oppnådd (3 brokere, 3 zookeeper).
- En uventet avslutning av en av brokerne fører ikke til stopp eller utilgjengelighet av klyngen. Arbeidet fortsetter som normalt, men de gjenværende brokerne må håndtere en større belastning.
- Uventet opphør av to meglere i et kluster med tre meglere og min.isr = 2 fører til at klusteret ikke er tilgjengelig for skriving, men er tilgjengelig for lesing. I tilfelle min.isr = 1, vil klusteret forbli tilgjengelig for både lesing og skriving. Denne tilnærmingen strider imidlertid mot kravet til høy dataintegritet.
- Uventet opphør av en av Zookeeper-serverne fører ikke til at klusteret stopper eller blir utilgjengelig. Driften fortsetter som normalt.
- Uventet opphør av to Zookeeper-servere fører til at klusteret blir utilgjengelig til minst én av Zookeeper-serverne blir gjenopprettet. Denne påstanden er sann for et Zookeeper-kluster med 3 servere. Som et resultat av undersøkelser har det blitt besluttet å øke Zookeeper-klusteret til 5 servere for å forbedre feilmotstand.
Kafka som en tjeneste
Vi har bekreftet at Kafka er en utmerket teknologi som gjør det mulig å løse oppgaven vi hadde (implementering av en meldingsmegler). Likevel bestemte vi oss for å forby tjenestene å kontakte Kafka direkte, og lukket den bak en databus. Hvorfor gjorde vi dette? Det er faktisk flere grunner.
Databussen har tatt ansvar for alle oppgavene knyttet til integrering med Kafka (implementering og konfigurasjon av forbrukere og produsenter, overvåking, varsling, logging, skalerbarhet osv.). Dermed skjer integrasjonen med meldingsmegleren på en så enkel måte som mulig.
Databussen har gjort det mulig å abstrahere fra spesifikke språk eller biblioteker for å jobbe med Kafka.
Databussen har gjort det mulig for andre tjenester å abstrahere fra lagringslaget. Kanskje, på et tidspunkt, vil vi bytte Kafka med Pulsar, og ingen vil merke noe (alle tjenester kjenner bare API-en til databussen).
Databussen har påtatt seg validering av hendelsesskjemaer.
Ved hjelp av databussen er autentisering implementert.
Under dekke av databussen kan vi oppdatere versjoner av Kafka uten nedetid, anonymt, sentralt administrere konfigurasjoner av produsenter, forbrukere, meglere osv.
Databussen har gjort det mulig å legge til nødvendige funksjoner som ikke finnes i Kafka (som auditing av emner, overvåking av anomalier i klusteret, oppretting av DLQ osv.).
Databussen gjør det mulig å implementere failover sentralt for alle tjenester.
For now, to start sending events to the message broker, it's enough to connect a small library to your service's code. That's all. You gain the ability to write, read, and scale with just a line of code. All implementation details are hidden from you; only a few parameters like batch size are exposed. Under the hood, the data-bus service spins up the necessary number of producer and consumer instances in Kubernetes and provides them with the required configuration, but all of this is transparent to your service.
Of course, there is no silver bullet, and this approach has its limitations.
- Data-bus needs to be maintained on your own, unlike third-party libraries.
- Data-bus increases the number of interactions between services and the message broker, which leads to reduced performance compared to raw Kafka.
- Not everything can be so easily hidden from services; duplicating KSQL or Kafka Streams functionality in data-bus is not what we want, so sometimes we have to allow services to access it directly.
In our case, the advantages outweighed the disadvantages, and the decision to shield the message broker with a separate service proved to be justified. In a year of operation, we have not encountered any serious outages or issues.
P.S. Thanks to my girlfriend, Ekaterina Obalayeva, for the cool illustrations for this article. If you liked them, there will be even more illustrations.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish